30 秒看懂
Theo Browne 评测 Grok 4.7,将 Elon Musk 先前对效率的预测,与基准测试中的成本及 Michael Truell 关于生产使用的另一项统计进行比较。他在 T3 Code 上做的小规模代码库调查得到细致而有用的建议,但他对模型成本、部分前端示例和生成的游戏不满意。这些结果只反映当时的特定测试、配置和价格,并非普遍排名,也不能证明任何人的意图。
- 1效率说法Theo 将 Musk 的预测与一项显示 4.7 消耗更多 Token 的基准测试对比;这一比较不能证明有人有意误导。
- 2统计单位不同Michael Truell 报告的是生产环境中每次请求的 Token 用量,Theo 考察的是每项基准任务的成本,二者不能直接互换。
- 3一次个人代码库测试Theo 用模型评分的实验将 Grok 的 T3 Code 改进建议排在接近 Astra 的位置,但评分和可比性存在局限。
- 4游戏演示在这次测试中,Grok 生成鱼类游戏耗时很长,成品的移动和视觉表现都有问题。
要点建议
- 每百万 Token 的价格、每次请求消耗的 Token 和完成任务的总成本是不同的衡量方式。
- 生产环境的中位数和基准测试的平均值可能因工作负载与统计单位不同而存在差异。
- Theo 的代码库调查显示 Grok 4.7 能做细致的检查,但实验规模小,且由模型评分。
- 基准测试和单次游戏生成展示了不同方面的表现,不能视作全面证据。
- 订阅是否划算取决于当时的额度、价格、使用方式及条款。
按章节阅读整理后的全文
预期与效率
Theo 将发布结果与先前预测比较,区分 Token 单价和任务总成本,并质疑一项生产环境统计是否适用于他的基准比较。
Grok 4.7 终于发布了。此前 Elon Musk 提高了大家的期待,称它会超越现有模型。一些基准测试的结果却低于 Grok 4.6;与此同时,我自己使用时也有喜欢的地方。这种反差让我想看看单个分数之外的情况。
发布公告称,4.7 在编程和知识工作方面更强,检查自身工作的过程也更仔细,标称价格和速度与 4.6 相同。此前 Musk 还预测它的 Token 效率会更高。我的批评是,我看到的任务级比较并不支持这一宽泛预期。
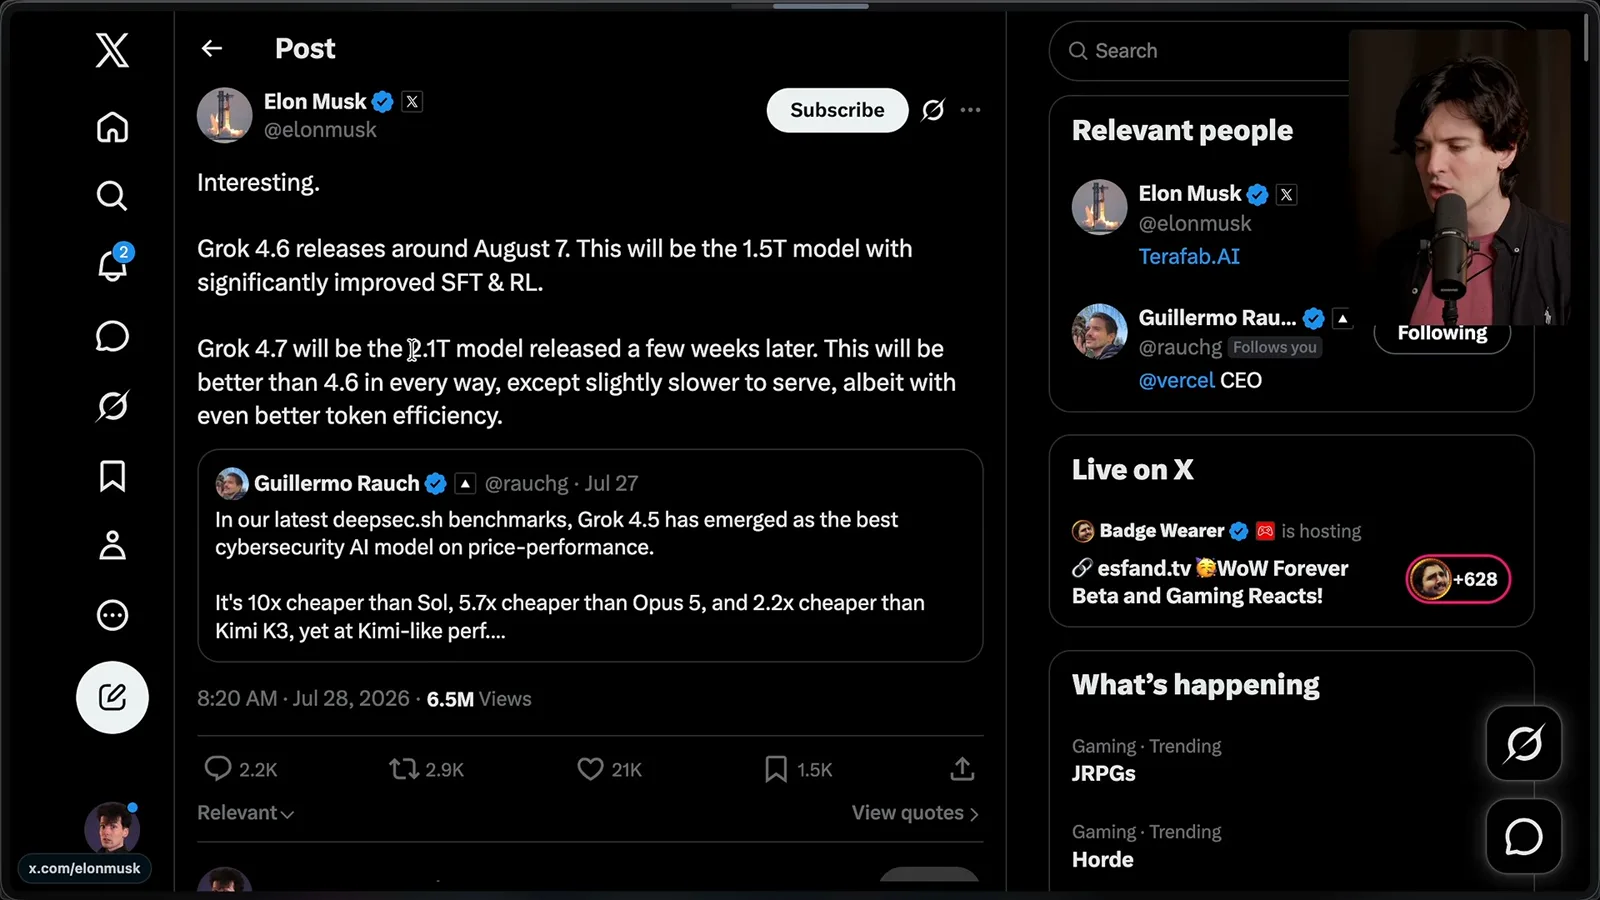
在我讨论的 Artificial Analysis 对比中,Grok 4.6 x-high 每项任务输出约 38,000 个 Token,4.7 约为 81,000 个。我引用的该指数每任务成本分别约为 1.86 美元和 3.74 美元。这些数字对应特定基准配置,不能证明所有场景都有相同差距,更不能证明有人有意误导。
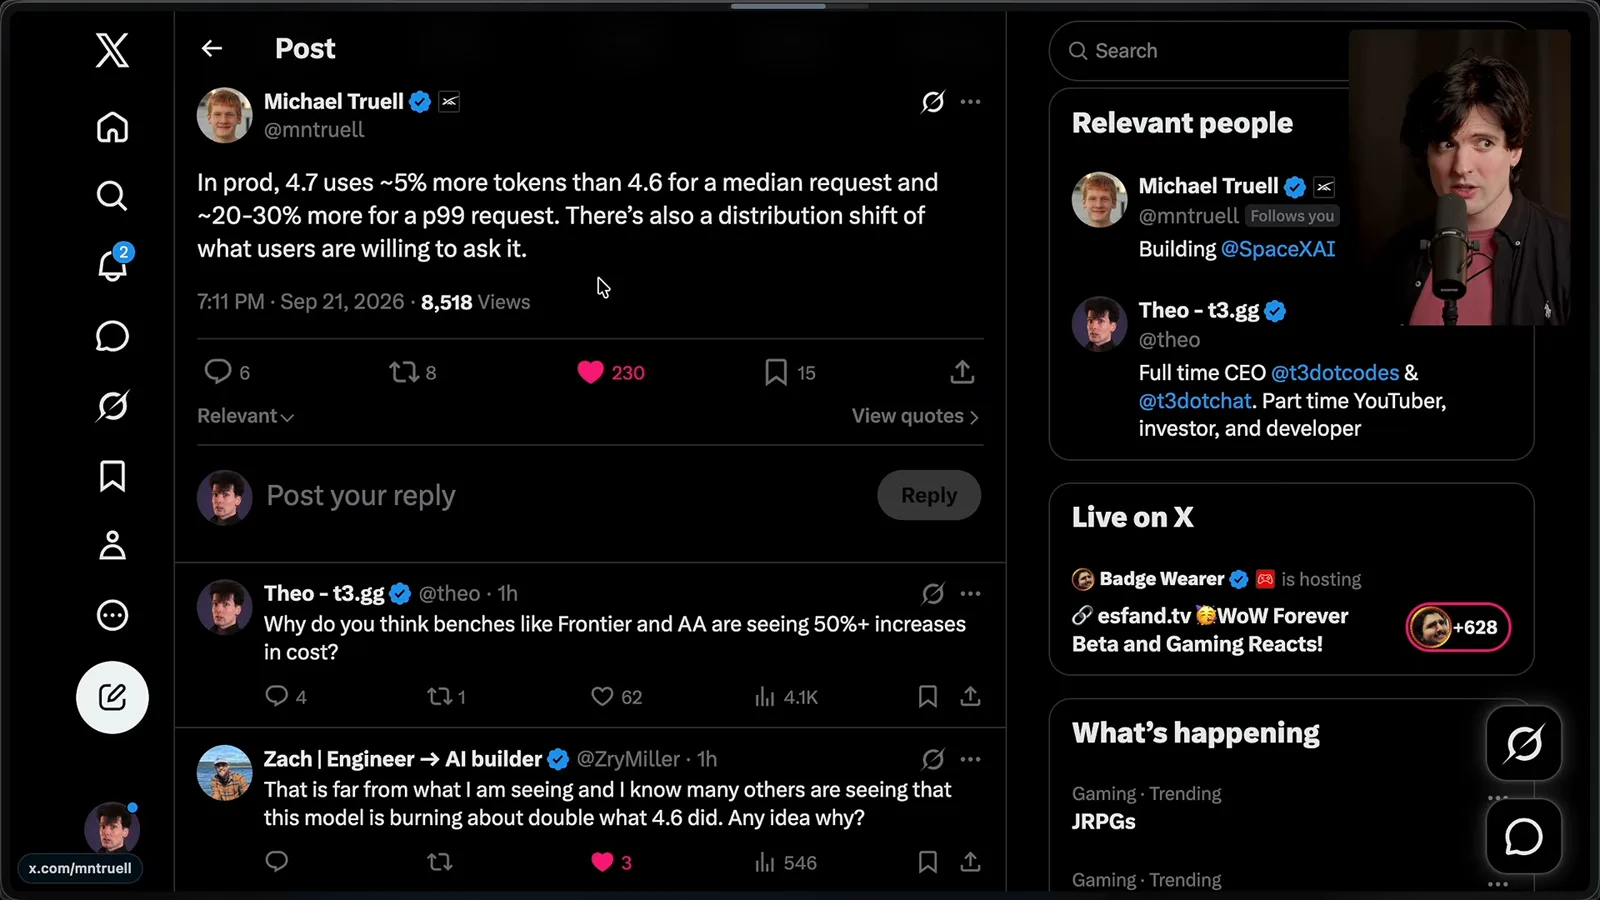
Michael Truell 回应时给出了另一种生产环境指标:每次请求的 Token 用量中位数约高 5%,第 99 百分位约高 20%–30%,同时用户请求本身也发生了变化。这是生产环境按请求统计的分布,而基准估算的是每项任务成本。如果不统一工作负载和定义,二者就不能直接互相反驳。
我最初推测,之前承诺的更大基础模型可能没有发布;随后我注意到官方公告称它确实使用了更大的基础模型。我先前对模型架构的推断是错的;光凭性能、价格和速度无法确定用了哪个基础模型。
一个任务可能只涉及一次 API 请求,也可能涉及多次,尤其是在智能体调用工具并继续发送请求时。我猜测,请求次数可能有助于解释每请求与每任务数字之间的差距,但视频没有证明这就是所比较数据集出现差异的实际原因。
在我的一次代码库测试中,最贵的 Grok 4.7 运行按 API 价格计算约需 20 美元,而其他多数运行低于 10 美元,其中一次 Astra 运行达到 11.44 美元。这些是我自己环境中的单次结果,并不是通用价格表。
基准、价格与额度
他查看部分编程及知识工作基准、推理强度和订阅使用报告;这些数据的任务和设置并不相同。
发布帖展示了 CursorBench 等评估。我提到此前某项基准存在训练数据重叠的疑虑,分数后来也被修订;眼前这张图仍只是其中一项评估。我还注意到图中的 CursorBench 对比没有 Astra,因此它无法展示与这一竞争模型的完整对比。
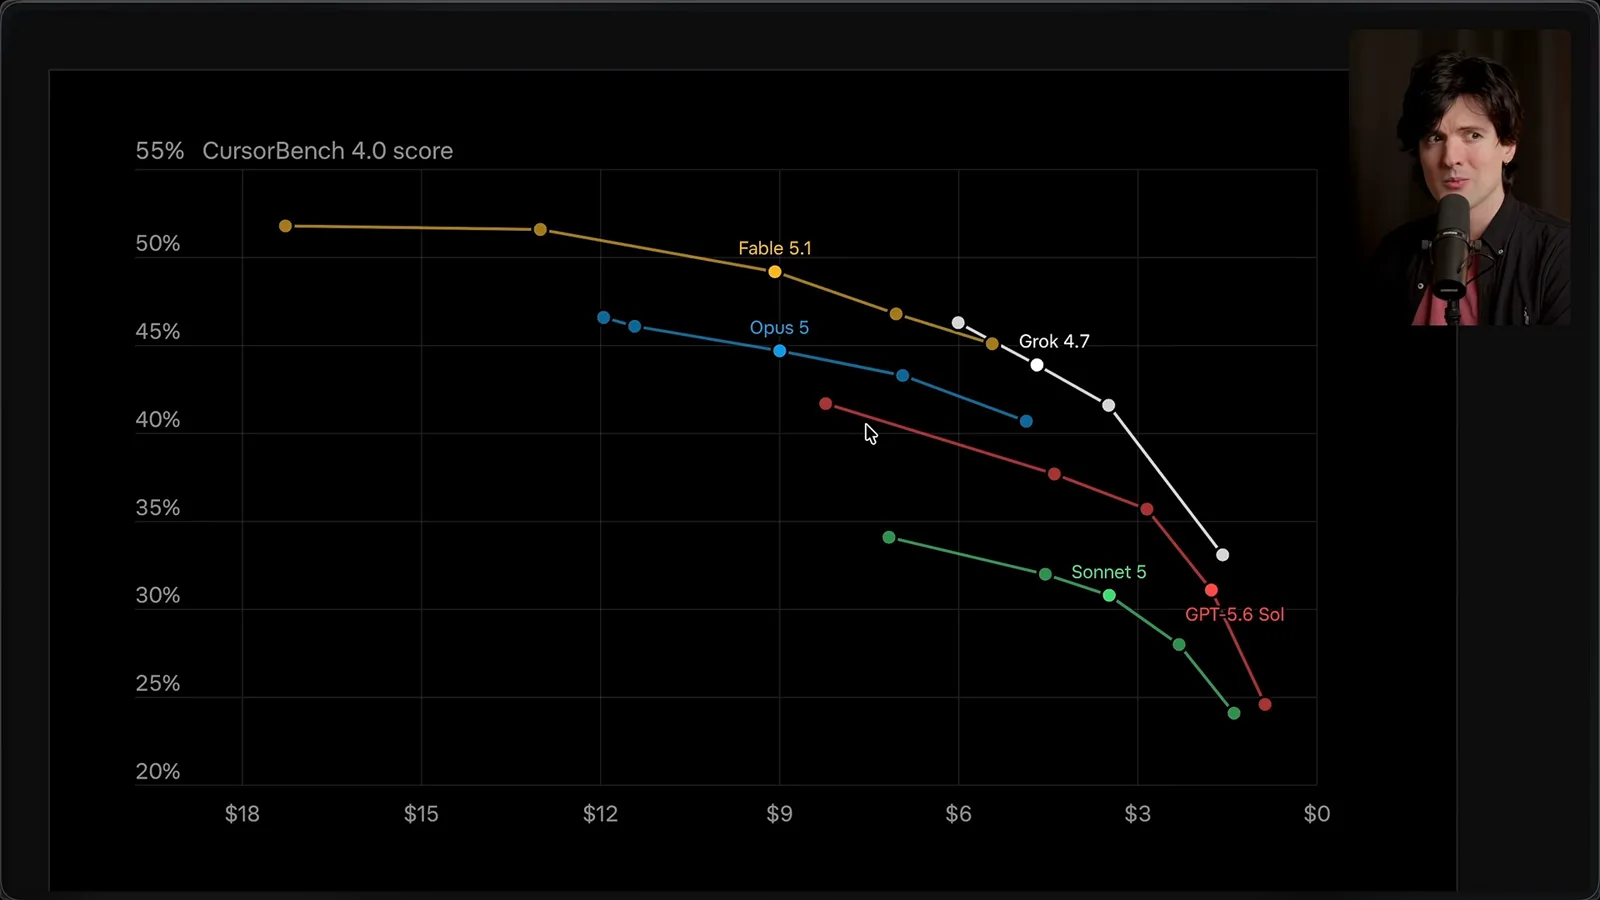
在图表上,Grok 在多个点位与 GPT-5.6 Sol 的对比表现不错;但在这个例子里,低推理强度的 Fable 得分可以略高于 Grok x-high,成本却更低。Token 效率取决于比较的是哪项得分、推理设置和工作负载。
公告还介绍了对 Grok Build 智能体运行框架的支持。我没有深入测试,不过认识的一些人喜欢它。模型在智能体框架中的行为是使用体验的一部分,单独的模型分数未必能反映出来。
发布材料包含软件工程、电气工程、法律工作和临床推理的结果。我质疑测试的选择以及其中一些测试对编程的代表性,同时也承认这些数字显示了模型在多项任务上的优势。只有方法和相关性清楚,多样化的基准才有用。
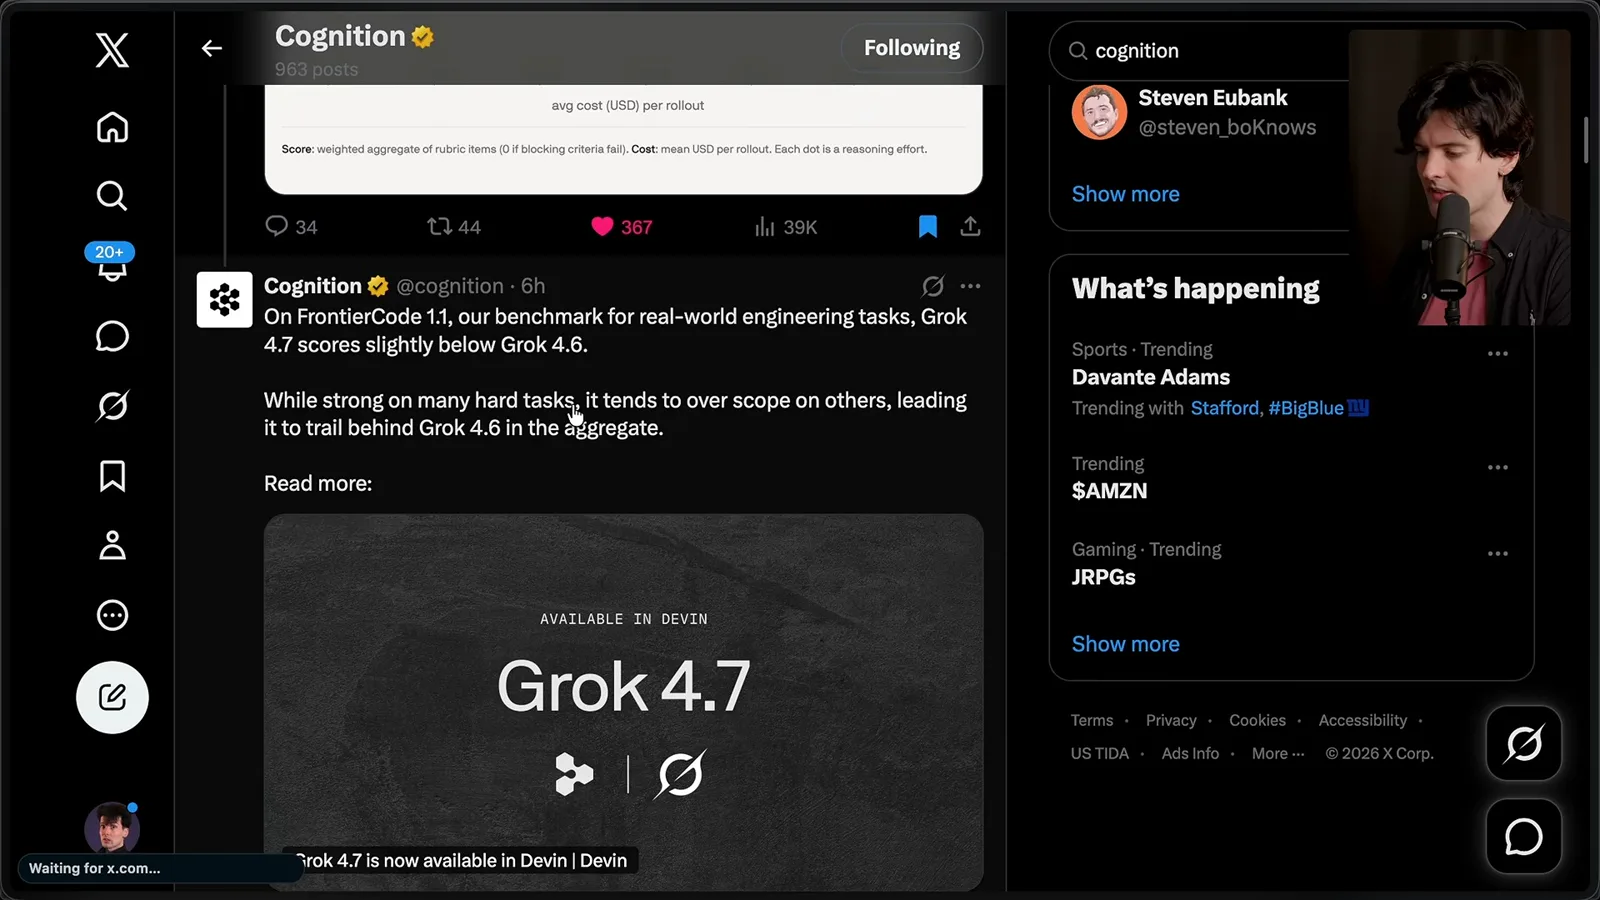
在 FrontierCode 上,Cognition 称 Grok 4.7 的综合表现落后于 4.6,尽管它在困难任务上表现不错,却可能把某些任务的范围扩大。这项评估关注改动是否符合真实拉取请求的标准,而不只是代码能否运行。我也发现这个基准在不同推理设置下的波动较大。
Artificial Analysis 的通用指数将 Grok 排在我目前偏好的模型之后,而其编程智能体指数显示的差距较小但仍然可见。我认为这部分与长时间工作中的稳定性有关。综合分数无法直接量化每位用户遇到失败的频率,因此这一解释还需要在真实任务中检验。
再看成本:在所引用指数的配置下,Grok 4.7 每任务约 3.74 美元,Astra 约 3.26 美元。有人提出缓存问题;我怀疑较高的 Token 用量是重要因素,但视频并未证明所有工作负载中各个原因分别造成了多少成本。
我的共同主持人 Ben 也报告说使用成本可能变高。他表示,上下文超过 200,000 个 Token 和使用快速模式时价格会上升;在他的 300 美元方案中,约 40 美元的用量消耗了每周额度的 8%。这是他在当时条款下的个人报告,不能保证现在仍有相同额度。
另一项评估 AA Briefcase 显示 Grok 4.7 有显著进步,成本也有竞争力,但评估者同时报告其演示文稿质量低于 4.6。这提醒我们,模型可能在一项指标上进步,却在另一项上退步。
设计与异常行为
他批评部分视觉示例,展示一则重复循环案例,并推测训练变化的影响,但没有直接因果证据。
我查看了一些前端示例,非常不喜欢其中几个生成的设计。这只是对少量样本的主观评价,不能证明换用提示词、示例或多轮迭代后模型仍无法做出合格界面。
Musk 曾谈到推迟发布,以解决模型过早放弃或检查工作不够充分的倾向。我推测,为了让它工作更久、更严谨而做的改动可能与 Token 用量增加有关。但仅凭这番公开评论,无法确定二者存在因果关系。
我展示了用户报告的一个文本生成重复循环案例,以及一个奇怪的翻译结果。这些例子展示了可能的失败方式,但不能说明失败发生的频率,也不能确定其确切原因。
代码库调查与游戏演示
他用模型评分的测试发现 Grok 的调查能力有用,但他认为一次游戏生成表现不佳,并将这些表现与成本一起衡量。
尽管有这些批评,我还是喜欢 Grok 能坚持完成任务、调查问题并深入细节。我见过它找出我认为其他模型漏掉的东西。为了观察这一行为,我让几个模型为 T3 Code 代码库提出改进建议。
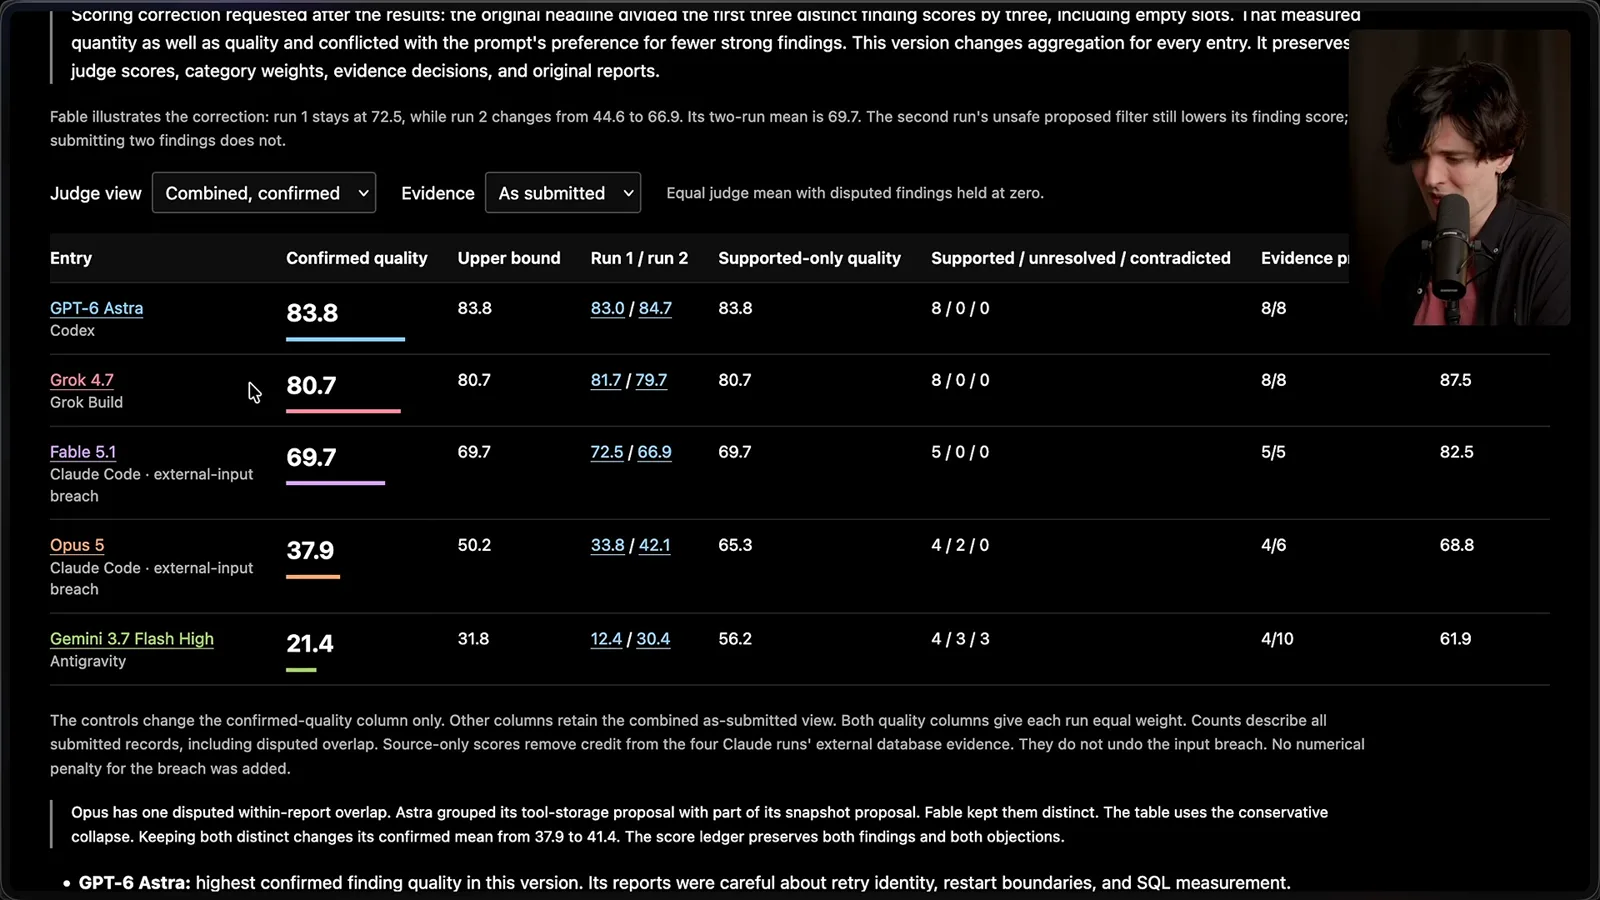
在我的小规模实验中,Astra 排名第一,Grok 第二;展示的表格里两者各有八条得到支持的建议,Fable 有五条。结果由模型评分,评分过程经过修订,表格还注明了对外部输入处理的差异。解读排名时需要考虑这些限制。
在我的测试中,Grok 的运行成本有时与 Astra 或 Fable 大致相当,最贵的一次则约为两倍。我怀疑它有时会花很多精力核实价值不高的细节。更深入的调查可能有用,但是否值得取决于额外发现能否抵消时间和成本。
在我的 Fish Slop 游戏提示词测试中,一次运行花了将近一个半小时。最初的结果把鱼和潜艇的动画方向做反了;我展示的版本鼠标跟随不自然,视觉效果在我看来也很差。这只是一次运行,并不是对游戏生成能力的全面测试。
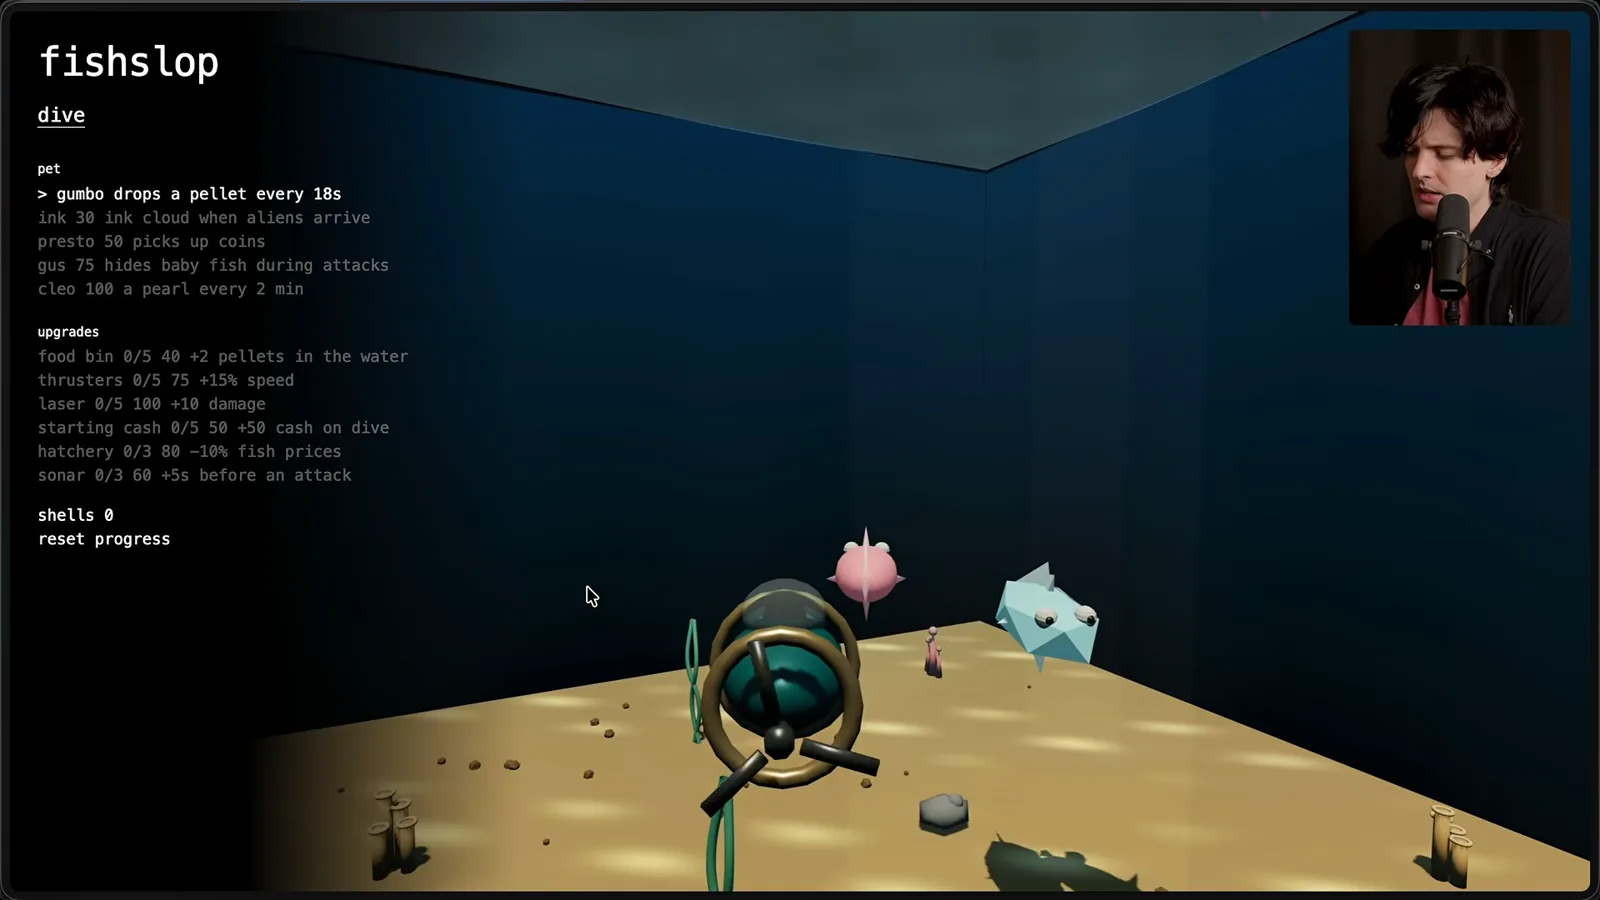
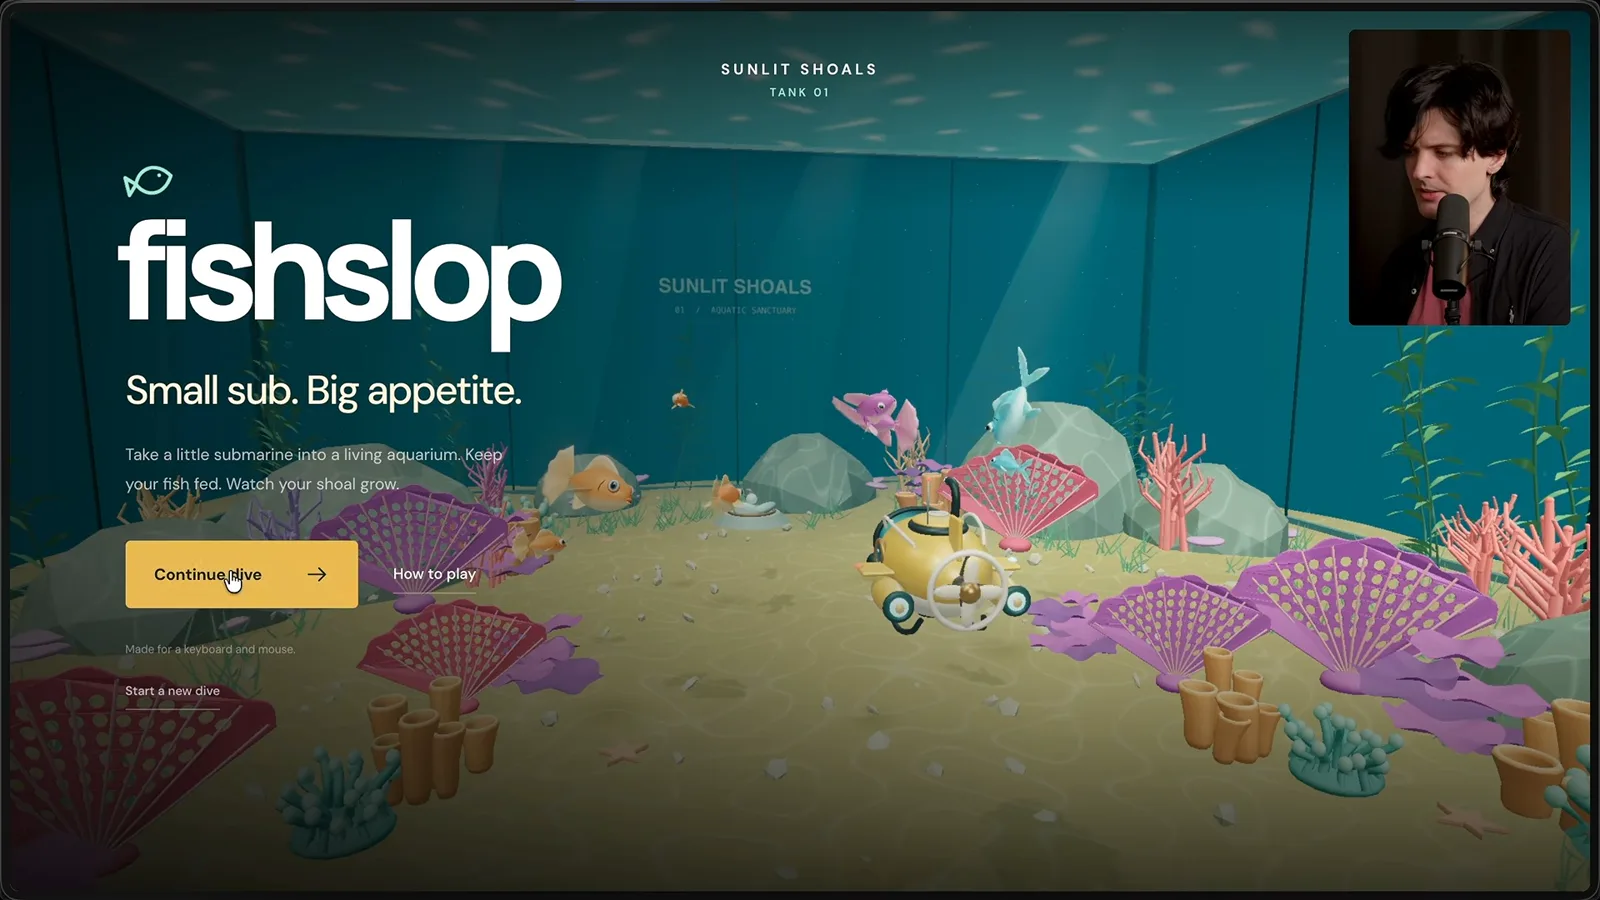
我把它与同一提示词和环境下 Astra 生成的游戏作比较,觉得后者可信得多。即使提示词相同,模型设置和生成过程的随机性仍限制了单组示例能支持的结论。
我的最终评价有好有坏。我喜欢 Grok 细致的调查能力,也觉得用它完成一些实际工作很愉快;但拍摄时遇到的成本和额度限制,让我难以推荐它作为自己的默认选择。其他人可能会更看重它的特长,而且价格和订阅方案也可能变化。
我把这一版本看作一个进展,希望未来版本能提高效率和性价比。目前,我建议在真正重要的任务上进行比较,把总成本和所需的人工审查也算进去,而不是只凭发布时的说法或单项基准选择模型。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。