30 秒看懂
如果微基准反复使用热缓存行和可预测分支,而生产环境并非如此,即使测试结果很快,也可能优化错了问题。Citadel Securities 工程师 Kris Jusiak 建议先做性能分析,再在真实和刻意设置的不利输入、分支及缓存分布下测量实际机器码区域。他演示了一个 perf 扩展,将符号路径探索与原生基准测试框架、硬件计数器结合。目标是比较延迟分布并询问条件变化时会怎样,而不是只相信一个平均值,或假定紧密循环等同于生产环境中的单次调用。
- 1采样可能错过重要的罕见事件性能分析器可能将大部分样本花在空闲循环上。Jusiak 比较采样、探针、插桩和处理器跟踪,它们的开销和细节各不相同。
- 2紧密基准循环可能测量的是吞吐量而非延迟处理器可以重叠执行重复工作,而生产路径可能关注单次操作。编译代码和运行条件也必须与问题相匹配。
- 3所提测试框架跨执行路径测试机器码Jusiak 结合符号路径探索、输入生成和原生执行,在不重写原始源代码的情况下改变条件。他指出路径爆炸是实际限制。
- 4分支历史和缓存位置会改变同一段代码的耗时他演示如何利用输入和缓存控制技术探索不同预测器及内存状态;例子依赖具体硬件。
- 5比较最佳、观测和不利情况,而不是一个数字生产输入可以帮助构建分布;额外场景用于测试条件变化时可能发生什么。经验分布图能显示尾部。
- 6问题不仅是今天发生了什么,还有可能发生什么在问答环节,Jusiak 解释说,测试框架使用原始机器码,配合合成数据和内存条件,进行隔离的假设情景测量。
要点建议
- 选择微基准之前,先分析工作负载并找到瓶颈。
- 区分单次操作延迟和重复循环吞吐量;它们回答不同问题。
- 测试接近生产环境的输入、分支和缓存分布,也测试合理的不利情况。
- 控制背景噪声并检查编译后的机器码,因为布局和编译器变化可能改变结果。
- 比较完整分布和尾部行为,不只看平均值;选择适合数据的统计检验。
- 用生产测量指导隔离实验,并在改动后重复性能分析和基准测试。
按章节阅读整理后的全文
为什么现代 CPU 上的测量很难
Jusiak 将演讲范围限定在 x86 和 Linux,并解释硬件复杂性如何让源代码层面的直觉不可靠。
Kris Jusiak 将性能测量视为工程问题:如果测量具有误导性,优化可能改变错误的指标,甚至让生产环境更慢。他的例子聚焦 CPU 行为、x86 和 Linux。
他提醒,性能涉及许多方面,没有单一通用解法。本次演讲将范围限定在 CPU,并使用带扩展的 Linux perf 及其他工具检查硬件和软件行为。
一些处理器细节是公开的,另一些则难以直接观察。Jusiak 认为公开手册、逆向工程和实验有助于理解微架构行为;测量结果仍取决于处理器和设置。
他说,时钟频率没有像晶体管数量那样持续扩展。现代处理器转而使用更大的缓存、分支预测和其他机制改善执行。这些机制提高了速度,也使人们更难仅从源代码推断性能。
他问观众,看似无害的变化——未执行的分支、未使用的函数、调试符号或不同用户——是否可能改变性能。这引出了他的“假如”方法:询问输入、布局或运行条件变化时结果如何变化。
对于依赖数据的系统,明天的输入分布可能不同于今天。Jusiak 希望工程师询问:如果分支更难预测、布局变化或云端抖动增加,会发生什么,而不是只依赖一次生产观察。
他提醒,AI 辅助优化同样依赖可靠测量。如果基准测量错了目标,智能体可能优化该指标,却仍然遗漏或加剧真正的生产问题。
处理器的性能监控单元提供许多硬件和软件事件。Jusiak 建议检查可用事件,并在选择硬件时考虑可观测性,因为理解瓶颈的能力会影响改善瓶颈的难易程度。
他将数据访问、分支预测和指令供给列为重要的 CPU 瓶颈。正确的调查方式取决于流水线的哪一部分受到限制;仅看算法源代码无法揭示所有相关硬件影响。
性能分析工具及其取舍
自顶向下分析、采样、探针、跟踪和模拟揭示工作负载的不同方面。每种方法都有局限或开销。
Jusiak 建议从自顶向下微架构分析开始。它将流水线活动分为指令完成、错误推测、前端受限和后端受限,再支持更深入调查,例如内存和缓存未命中。
自顶向下类别覆盖处理器流水线测量的槽位,提供结构化起点。例如,后端受限的结果可以引导人们进一步查看内存和缓存事件,而不是过早重写源代码。
采样和火焰图可以显示时间花在哪里,但采样分析器可能过度反映空闲循环,漏掉交易系统中罕见却重要的消息。合适工具取决于目标是常见路径还是尾部事件。
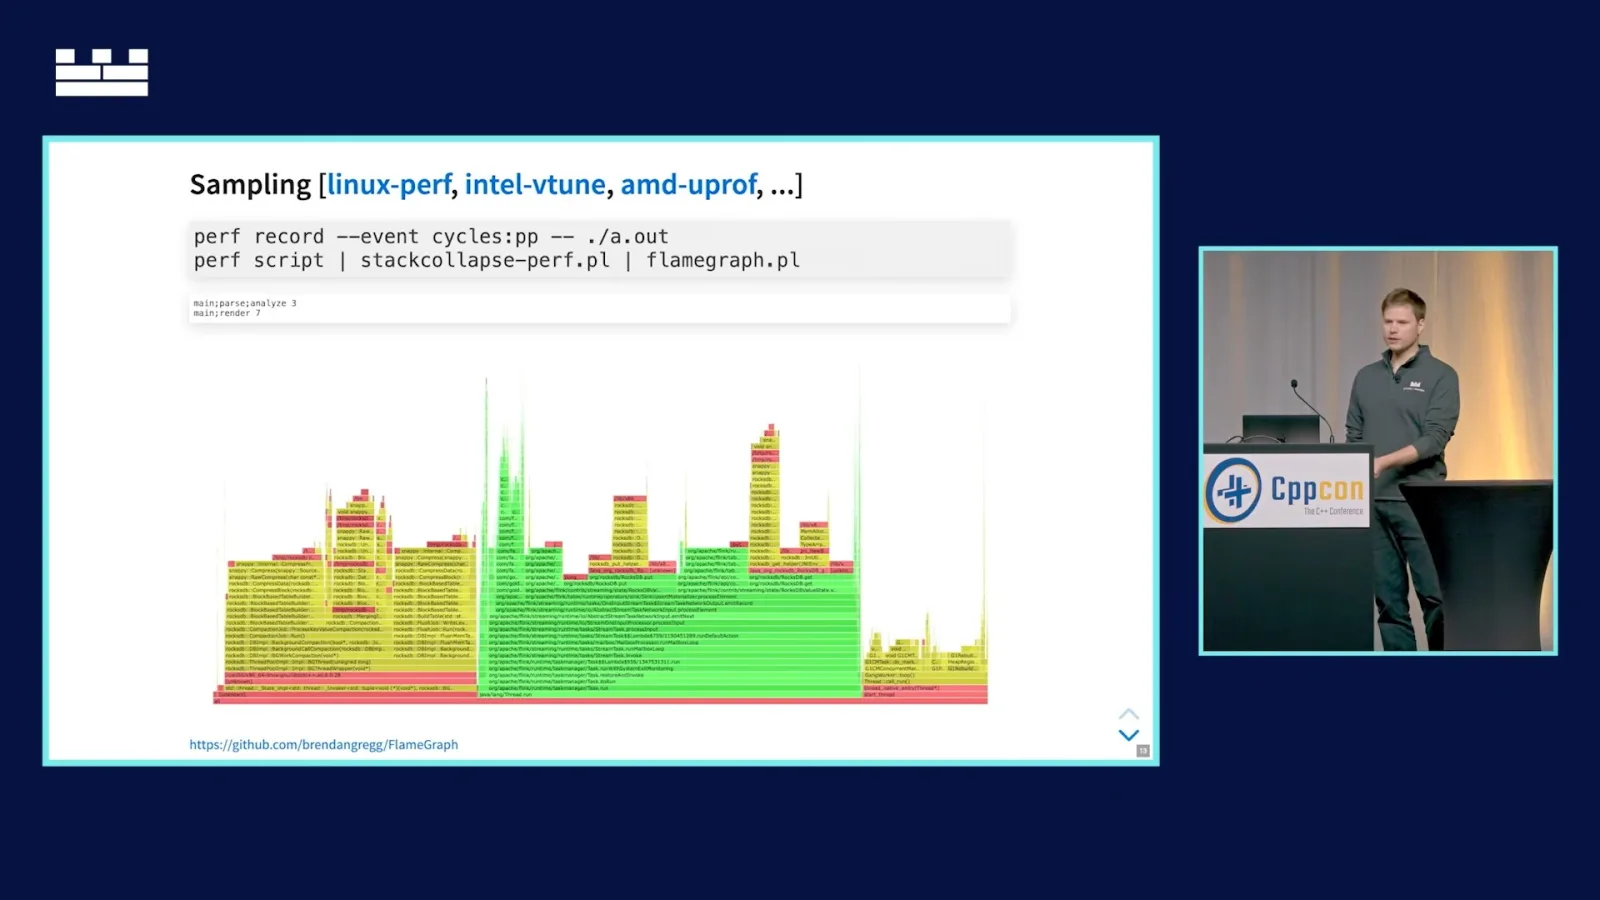
插桩和 eBPF 探针不一定要修改应用源代码,就能展示延迟分布和尾部行为,但仍有开销。Jusiak 指出,探针中断和状态切换可能影响测量结果。
他介绍编译器支持的 XRay 插桩作为另一种选择:可以修补入口和出口位置,启用选定的插桩。与让所有钩子始终处于激活状态相比,选择特定函数可能更适合定向观察。
硬件处理器跟踪可以不依赖普通统计采样来记录执行流。Jusiak 说,分支信息可用于重建调用和估算时间,尽管它可能产生大量数据,而且并非每条指令的计时都完全准确。
处理器跟踪记录足够的控制流信息来重建实际执行路径。Jusiak 说,这种视图有助于检查异常事件,但也指出数据量和计时精度的限制。
围绕选定事件进行跟踪,可以帮助解释延迟尖峰发生之前出现了什么。Jusiak 以基于快照的工具为例,认为跟踪在这类调查中使用不足。
LLVM 机器码分析使用与编译器调度相关的模型模拟执行,并可展示资源压力。他提醒,模拟会遗漏一些真实行为,包括前端影响,因此不应将其视为忠实的生产测量。
完整模拟工具可以为小段代码提供详细测量,但在模拟下运行整个应用很慢。只对某个区域插桩可以集中分析,但周围应用仍会受到模拟器开销影响。
这些工具回答不同问题:火焰图汇总采样频率,插桩观察选定位置,跟踪重建控制流。它们的开销和覆盖范围不同,因此没有一种视图能替代针对具体工作负载的问题。
为什么微基准可能优化错目标
紧密循环可能在不真实的有利分支和缓存条件下测量吞吐量。Jusiak 建议探索执行路径和硬件状态。
传统基准测试常常在循环中重复一项操作并计时。Jusiak 说,这可能测量的是吞吐量——CPU 重叠执行重复操作的速率——而不是实际应用中单次调用的延迟。
他区分了吞吐密集型工作负载与关注单次查找或操作延迟的路径。他还提醒,优化编译器可能转换或删除被测工作,因此检查生成的汇编代码至关重要。
如果基准测试将数据保持在 L1 缓存中并让分支可预测,它可能只测量生产环境很少遇到的最佳情况。如果工程师只优化这种情况,生产性能可能因他们并不理解的原因改善或退化。
相同源代码可能因缓存访问、分支预测、代码布局和对齐而表现不同。即使一个未使用的函数从未被调用,也可能让循环跨过指令缓存边界。
在 x86 上,指令长度可能变化,小幅布局变化就可能改变边界和指令供给。Jusiak 用这一点说明,看似无关的源代码改动为什么可能影响机器层面的执行环境。
Jusiak 用处理器图说明现代 CPU 的复杂性:指令变成微操作,经过缓冲区、队列和执行资源。操作系统活动也会引入噪声;研究细微差异时必须控制这些噪声。
他提出的方案是在多种条件下测试原始机器码区域。目标包括非侵入式分析生产二进制文件、探索相关路径、控制缓存和分支状态,以及进行有统计依据的比较。
他强调,性能是一种分布,而不是单个数字。统计比较需要适合测量数据的假设;他的演示力求控制分布,但正态性并不是所有有效统计方法的普遍前提。
从机器码到符号路径和输入
演示的方法分析机器码、求解路径约束并准备原生测试框架。分支预测器和缓存状态需要分别控制。
从机器码开始可以让分析不依赖编程语言。符号探索识别可能的路径、内存访问和约束;独立测试框架准备输入并测量原生执行,而不是只依赖模拟。
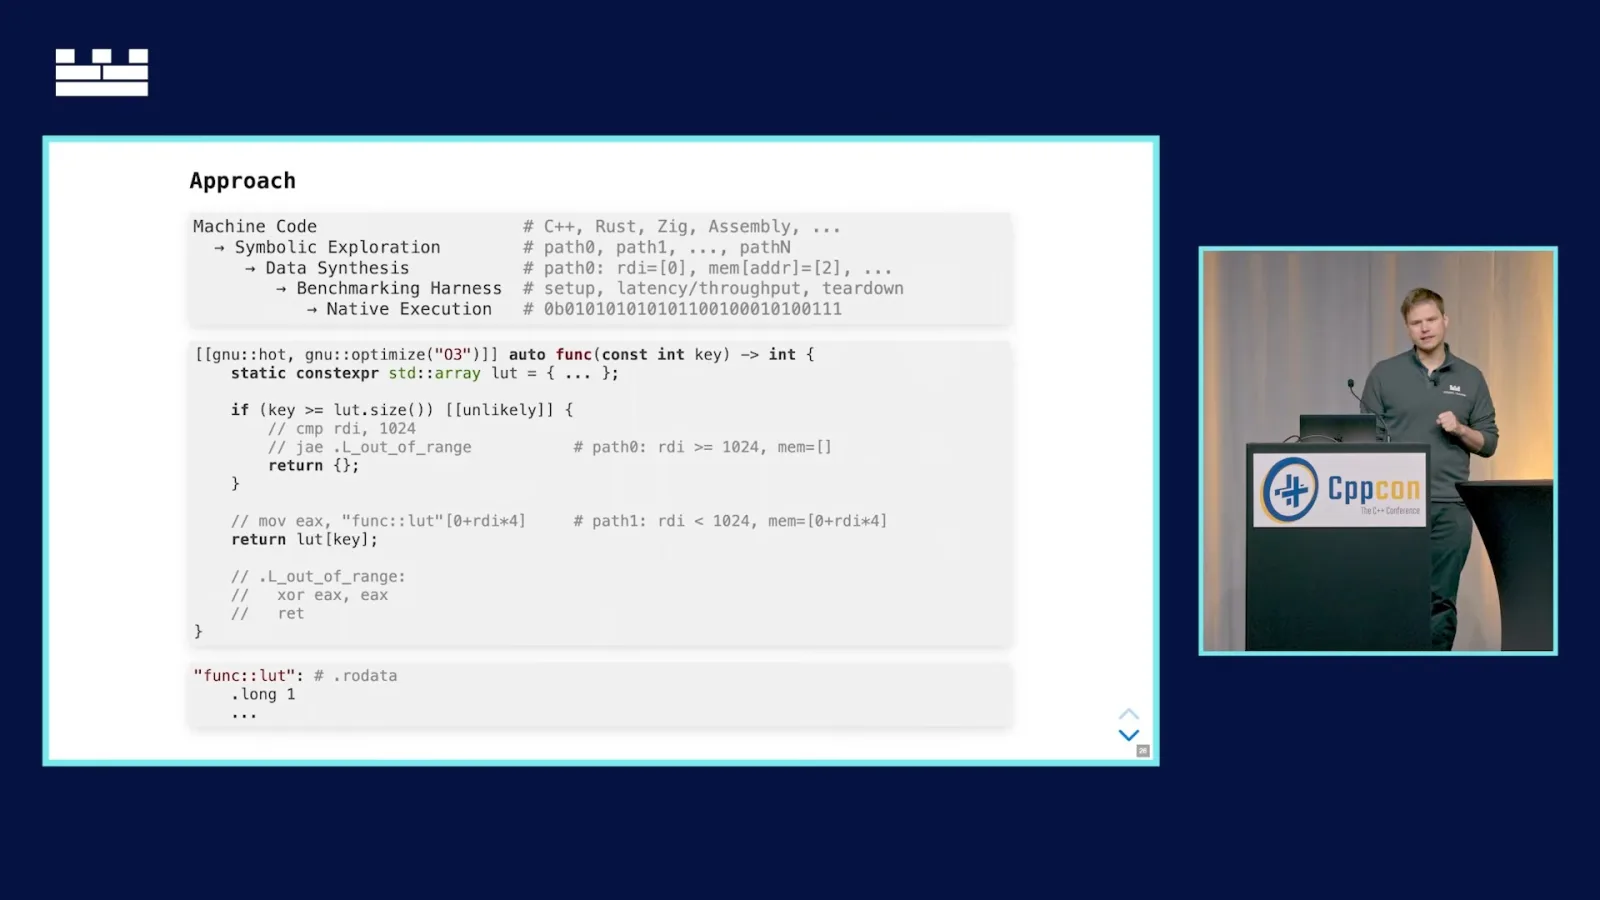
常量查找表说明了准备工作为什么困难:数据可能嵌在只读内存中,不同输入可能访问也可能不访问它。测试缓存行为时,框架需要知道代码实际访问了哪些地址。
示例中的一条路径可能使用查找表,另一条则不使用。基准测试需要同时考虑选择各路径的输入,以及使用查找表的路径读取的内存位置。
Jusiak 介绍了如何使用 VEX 中间表示、符号分析工具和 Unicorn 仿真来探索路径。他用一个含多个条件和全局值的 FizzBuzz 风格函数说明,源代码分支与生成的指令不一定一一对应。
探索从符号状态开始,寻找通往目标地址的路径。它记录寄存器和内存条件,以及无法继续的路径。他提醒,大型程序的状态数量可能爆炸,因此实际分析需要施加约束。
符号解包含指令位置、寄存器和内存约束。求解这些约束可以得到具体数值,用于在原生测量中驱动所需路径。
在示例中,分析找到多条路径,其中一条会读取内存。求解器随后产生满足路径约束的具体输入。这些输入可用于让基准测试经过特定路径,并识别缓存状态重要的内存位置。
分支预测器维护复杂的历史,因此很难设置精确的目标状态。Jusiak 的实用方法是输入合适的数值序列,让预测器遇到被测模式,再用测量验证效果。
他讨论了初始分支历史和分支目标缓冲区行为如何影响罕见路径。一个几乎从不执行的分支,最终执行时可能表现不同;这种情况对尾延迟可能有特别大的影响。
他指出,分支预测行为依赖历史,因此一个看似随机的输入并不等同于有代表性的序列。测试框架准备输入分布并测量相应行为。
利用符号输入,测试框架可以生成可预测或较难预测的分支模式。在一个特定处理器的例子中,Jusiak 展示了约 14 个周期的预测错误代价;这个数字不应推广到每个处理器或分支。
他推荐使用经验累积分布函数图,因为它能显示观测结果的百分位数和尾部。即使大多数测量看起来很好,单一平均值也可能掩盖罕见的慢路径。
下一个挑战是缓存位置。符号探索识别读写操作,但测量前测试框架必须在内存中安排相应数据,并影响哪些缓存级别持有各条缓存行。
对于 L1,加载数据可以预热缓存行;预取只是提示,可能需要等待稳定。Jusiak 强调,这些机制及其效果依赖硬件,必须测量,不能仅根据指令名称假定。
他介绍了如何刷新缓存行并使用预取提示来研究驻留在 L2 的情况。他的观察只涉及测试过的 CPU;预取指令并不能普遍保证缓存行进入某个特定级别。
对于一个 Intel 平台,他演示将 CLDEMOTE 用作 L3 准备的一部分,并通过刷新来探索数据驻留在内存的情况。他指出,在其他架构上控制 L3 更困难,因此未经验证不能直接移植这一方法。
测试框架可以按照选定的缓存命中分布准备一段地址范围,而不是一次只处理一条缓存行。Jusiak 说明,L1、L2、L3 和内存命中率的层级如何形成不同的热路径和冷路径。
示例缓存层级在各级使用条件命中率:某一级未命中就进入下一级。Jusiak 用它推导冷热访问的混合如何影响完整延迟分布。
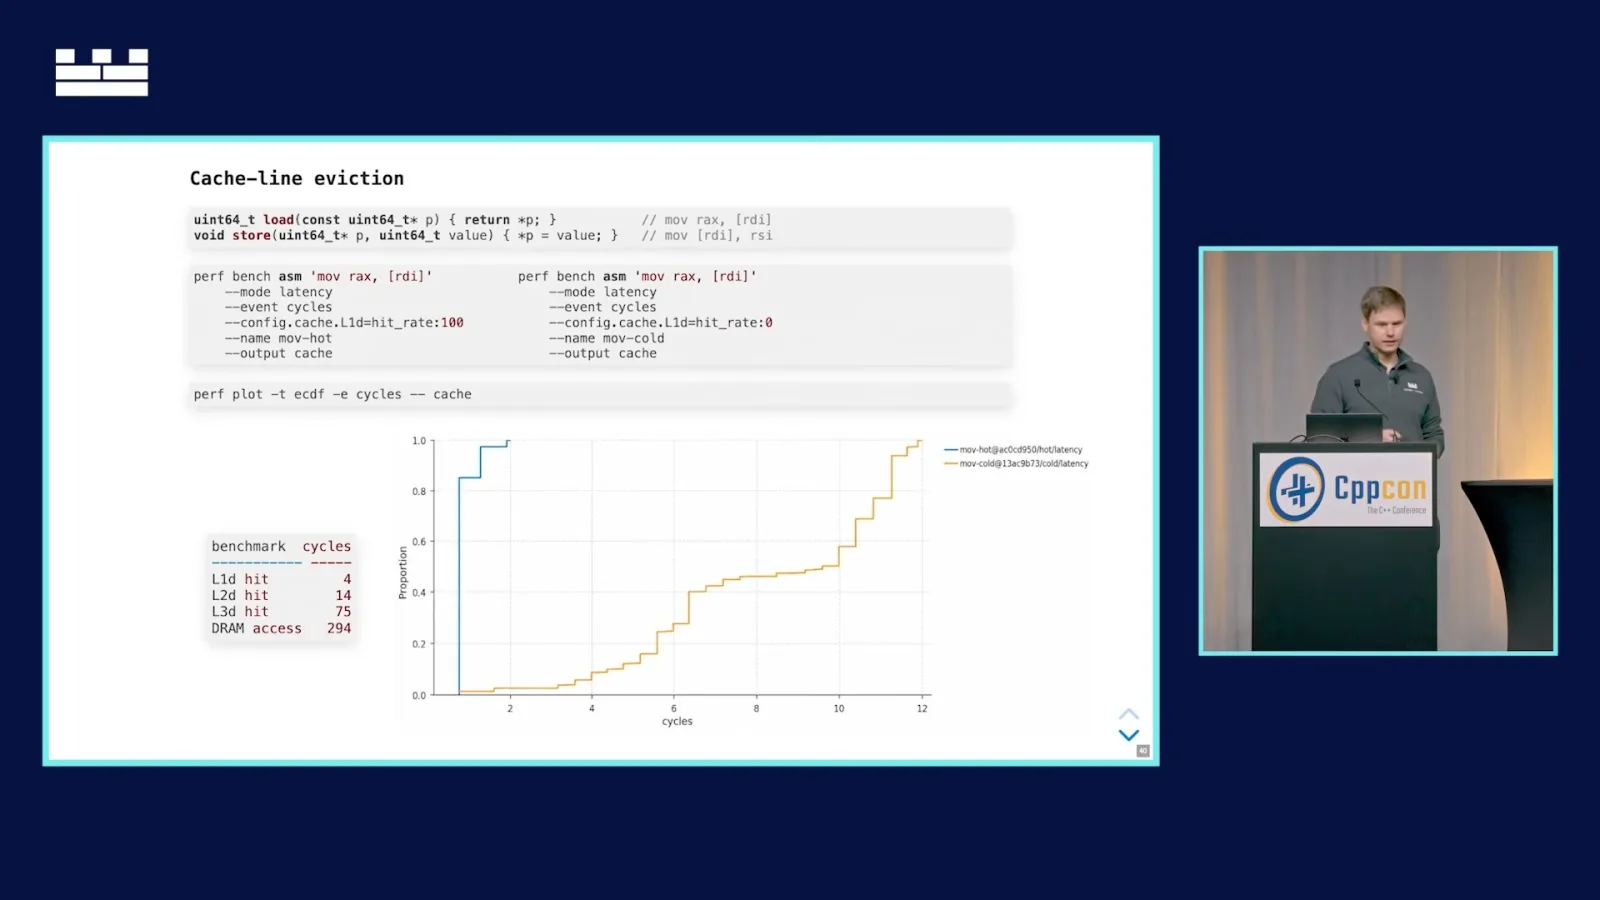
他比较不同缓存条件下的一次简单内存访问,显示即使 L1 与 L2 的差别也会改变分布。访问主内存可能产生更大影响。重点是测量与工作负载相关的状态,而不是假定所有访问都是热缓存。
原生执行和基准测试场景
Jusiak 讨论延迟与吞吐量、硬件设置、噪声,以及如何测量真实和不利分布。
缓存和分支状态并非全部设置:对齐、指令缓存、转译后备缓冲区、执行端口、CPU 亲和性和优先级也可能重要。测试所有组合可能代价高昂,因此工程师必须有意识地选择场景。
Jusiak 还提到,测试独立函数可能不同于测试被内联到多个调用方的代码。周围指令和编译器优化可能产生不同的机器码区域,需要分别考虑。
原生测量需要围绕选定二进制区域构建测试框架,并注意调用约定、状态和计数器。Jusiak 指出,内联会改变函数周围的机器码,因此独立基准可能不能代表每一种内联使用。
他再次讨论延迟和吞吐量。重复基准可能通过重叠执行表现出更好的每操作吞吐量,而单个有依赖关系的操作会暴露延迟。以每次操作耗时报告吞吐量的倒数有助于统一单位,但两者仍测量不同的行为。
对于很短的指令序列,他介绍了指令基准测试中的展开和相减方法。这种技术有包括控制流影响在内的约束,只有理解测试框架和假设时才有用。
基准测试前,应检查实际 CPU 拓扑、系列、型号和步进。编译器调度模型和已公开的指令测量可以提供有用的交叉检查,但目标机器仍是被测系统。
识别 CPU 有助于选择相关性能事件并解释结果。Jusiak 将拓扑工具和编译器调度描述作为背景信息来源,而不是测量实际工作负载的替代品。
Jusiak 主张控制测量噪声,而不是把它当作无法解释的属性接受。他建议先在经过调优的机器上检查计时分布,再有意识地引入与工作负载有关的干扰。
在相信更复杂的设置前,先将简单指令的测量与公认参考进行合理性检查。一致并不能证明后续所有结果都正确,但不一致可以暴露测量工具的问题。
他比较了热缓存和可预测分支的最佳情况、观测分布,以及对齐较差或访问主内存等不利情况。合适的最坏情况取决于应用;目的是在它发生之前理解可能范围。
为了近似实际行为,Jusiak 介绍使用探针和调试信息收集生产输入,并采样分支或缓存行为。这些观测可以指导基准分布,再补充生产样本尚未遇到的场景。
调试符号有助于恢复捕获的函数参数结构。所得输入样本描述的是已经观察到的情况;要询问尚未发生的条件,还需要额外选择分布。
该方法将发现的机器码路径和地址,与观测或选定的分布结合,然后原生运行基准。探索整个二进制文件可能成本过高,因此他建议将范围缩小到相关函数或区域。
分布、代码布局与测量循环
案例考察依赖输入的路径和对齐。Jusiak 建议反复进行性能分析、基准测试和统计比较,并回答有关生产数据的问题。
在一个简单例子中,不同输入值会经过不同指令路径。Jusiak 说,较大的误差条可能代表所选场景中分支行为的真实变化,而不只是测量噪声。
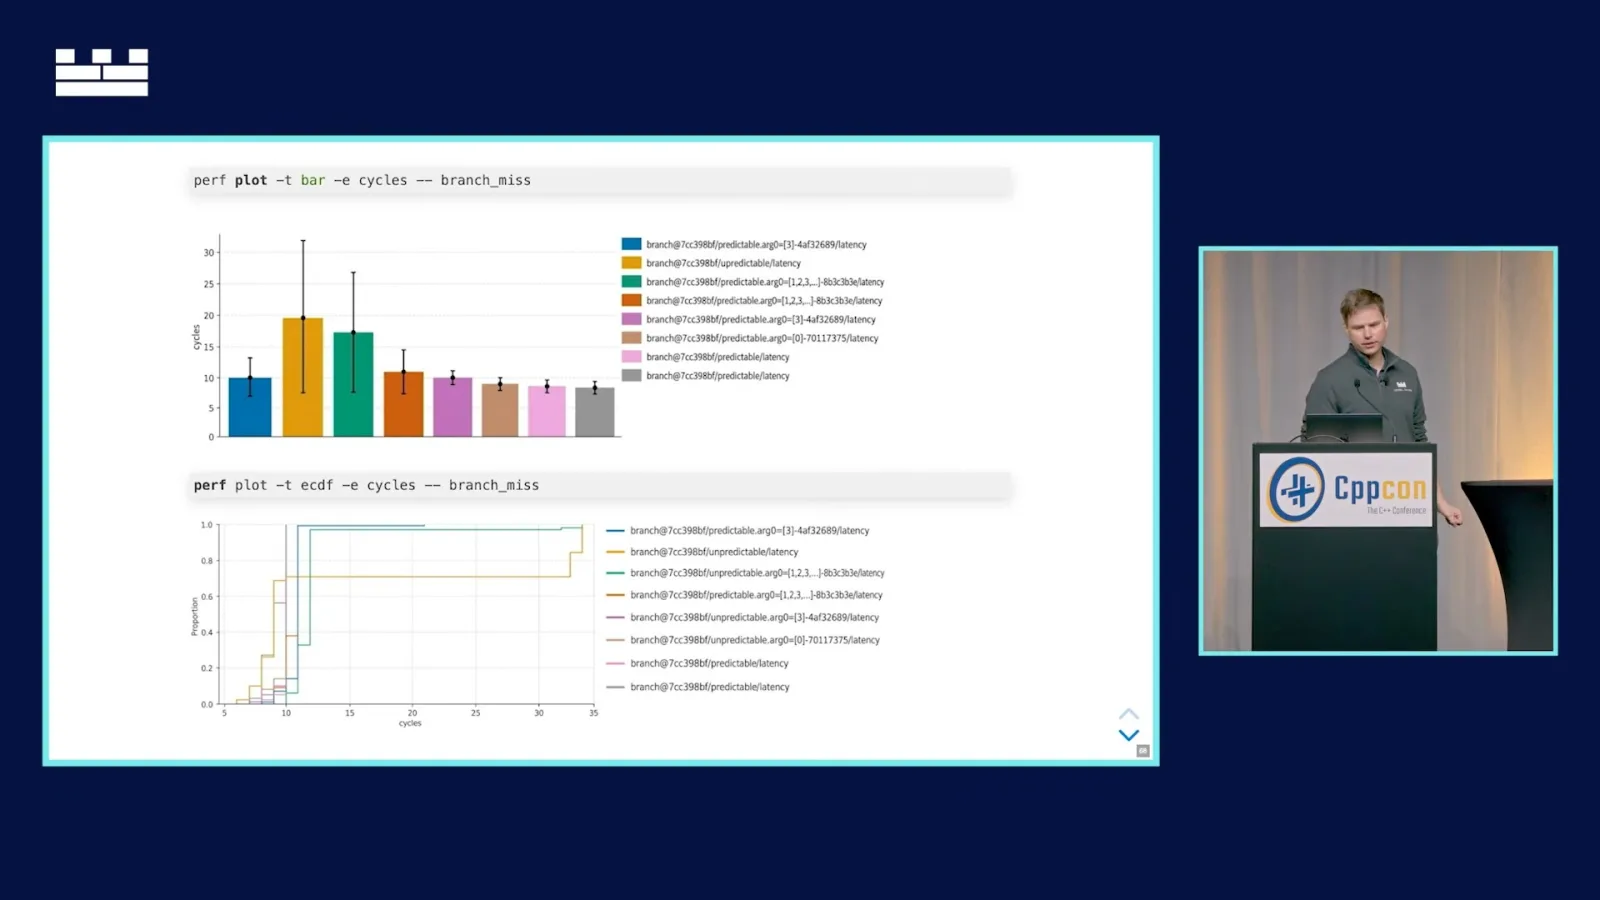
他建议比较经验分布,查看一个情况的尾部从哪里开始偏离另一个情况。工程师随后可以调查特定百分位,并使用适合数据和问题的统计分析。
在分支例子中,一种输入分布的预测模式和尾部与另一种不同。分布图比单一汇总值更容易显示这种差异。
代码对齐会带来另一种意外:增加或删除无关代码、更换编译器或改变布局,都可能让热点循环跨越边界。由于指令缓存效应,即使未使用的代码也可能间接改变性能。
他演示将同类受控基准用于库代码,改变缓存和分支条件。假定缓存行永远不会被驱逐的基准可能表现极佳,却会漏掉以后真正重要的条件。
反复进行的循环是性能分析、基准测试、分析和优化,然后再重复。Jusiak 主张绘制分布并进行统计比较,而不是因为某个显示数字更小就选择某个实现。
Jusiak 区分了视觉上好看的图表和两个实现确实可靠地不同的证据。他主张进行统计比较,同时明确测量假设和实验范围。
他提出,一旦测量和分析可靠,循环中更多步骤可能实现自动化,包括使用 AI。他将其作为依赖可信基准测试的未来工作流,而不是其替代品。
一位观众问该工具是否合成新程序。Jusiak 澄清,它在测试框架中分析并执行原始机器码,同时在周围合成输入以及缓存或驱逐条件。
另一位观众询问如何在不干扰生产环境的情况下测量。Jusiak 建议使用有限的生产指标,必要时进行定向跟踪或插桩,然后在隔离测试机器上调查观测到的和假设的条件。
同频道的其他文章
 1:01:02EN → 简体中文
 Citadel Securities· 2026年10月27日播客 · 3 人对谈Sequoia 的 Alfred Lin 和 Konstantine Buhler 谈 AI、投资与智能体经济嘉宾 Alfred Lin, Konstantine Buhler · 主持 Nohshad Shah两位合伙人在 Citadel Securities 2026 年大会上讨论投资流程、模型竞争、计算约束和未来机会。
 18:55EN → 简体中文Citadel Securities· 2026年10月26日播客 · 4 人对谈Jeff Maurone 谈 Citadel Securities 的市场分析与技术这位技术首席运营官介绍市场持仓、信用利差和客户问题的分析工具,以及支撑这些工具的研究基础设施。
 44:58EN → 简体中文Citadel Securities· 2026年10月26日播客 · 2 人对谈Mario Draghi:欧洲增长、能源与安全的选择嘉宾 Mario Draghi · 主持 Lisa Abramowicz在 2026 年 10 月与 Lisa Abramowicz 的对谈中,欧洲央行前行长讨论财政压力、AI、能源和欧洲一体化。
 45:34EN → 简体中文Citadel Securities· 2026年10月26日播客 · 2 人对谈Henry Paulson 谈 AI 风险、中美关系与危机领导力嘉宾 Henry M. Paulson, Jr. · 主持 Jim Esposito美国前财长讨论当前经济风险,以及从 2008 年金融危机中获得的经验。
 1:01:23ENCitadel Securities播客Jensen Huang on AI Factories, Digital Workers and Why the Build-Out Has Barely BegunNvidia's CEO tells a room of institutional investors how accelerated computing led to AI factories, and where agentic AI, robotics and sovereign AI go next.