30 秒看懂
Cline 创始工程师 Ara Khan 说,编程智能体可以根据失败案例测试修改,改进另一个模型周围的系统。他介绍了一个提高 Cline 框架在 Terminal-Bench 上成绩的自动循环,以及一个降低小型设备延迟的实验。他的职业建议是寻找能从模型进步中受益、却不会被下一次更新直接取代的工作,同时在多种任务上检验改进。
- 1一个智能体改进了另一个模型的运行框架Khan 介绍了一个循环:它检查基准测试的失败案例、修改 Cline 并再次评估。
- 2评估必须检验结果,而不是只听智能体声称完成他的例子使用隔离任务和独立检查,考察结果、成本、时间以及钻评分规则空子的行为。
- 3第二个循环可以修改运行智能体的系统一个智能体尝试任务,另一个观察反馈并对框架做更广泛的修改。
- 4物理设备可以提供优化循环Khan 将一个响应慢的设备连接到编程智能体,运行改变软件和固件的延迟实验。
- 5选择能受益于规模、却不会仅靠规模解决的项目Khan 建议选择在更强模型发布后仍能做出贡献的工作。
要点建议
- Khan 建议选择能从模型进步中受益、却不会仅靠规模扩大就解决的问题。
- 修改智能体框架前,使用独立测试并检查失败类别。
- 在多种任务上测试框架修改,以减少过度适应。
- 物理设备可以提供可测量的反馈,供软件和固件迭代使用。
按章节阅读整理后的全文
更快的模型为何改变职业选择
Khan 介绍了关于工作成果证明和 AI 收益分配的担忧。他认为选择什么问题是一个职业决定。
我是 Cline 的创始工程师 Ara。我想解释编程智能体的递归自我改进,以及快速进步的模型可能如何影响我们的职业。
过去能证明能力的个人项目,如今前沿编程智能体一次就可能完成。这带来了一个问题:我们如何展示自己的能力,并选择未来几年的工作?
有些人担心收益会集中在少数芯片和模型公司手中。这个话题存在恐慌渲染,但我认为,其他人如何发展的问题是真实的。
从基准差距到自我改进
Cline 的初始成绩促使团队改进运行框架。Khan 将这个实验与更广义的递归自我改进联系起来。
在 Cline,我们尝试自动改进编程智能体的运行框架,也就是为模型提供工具并运行模型的外围系统。Kimi K3 在 Terminal-Bench 2.1 上的初始成绩是 77.5%,低于模型发布论文报告的成绩。
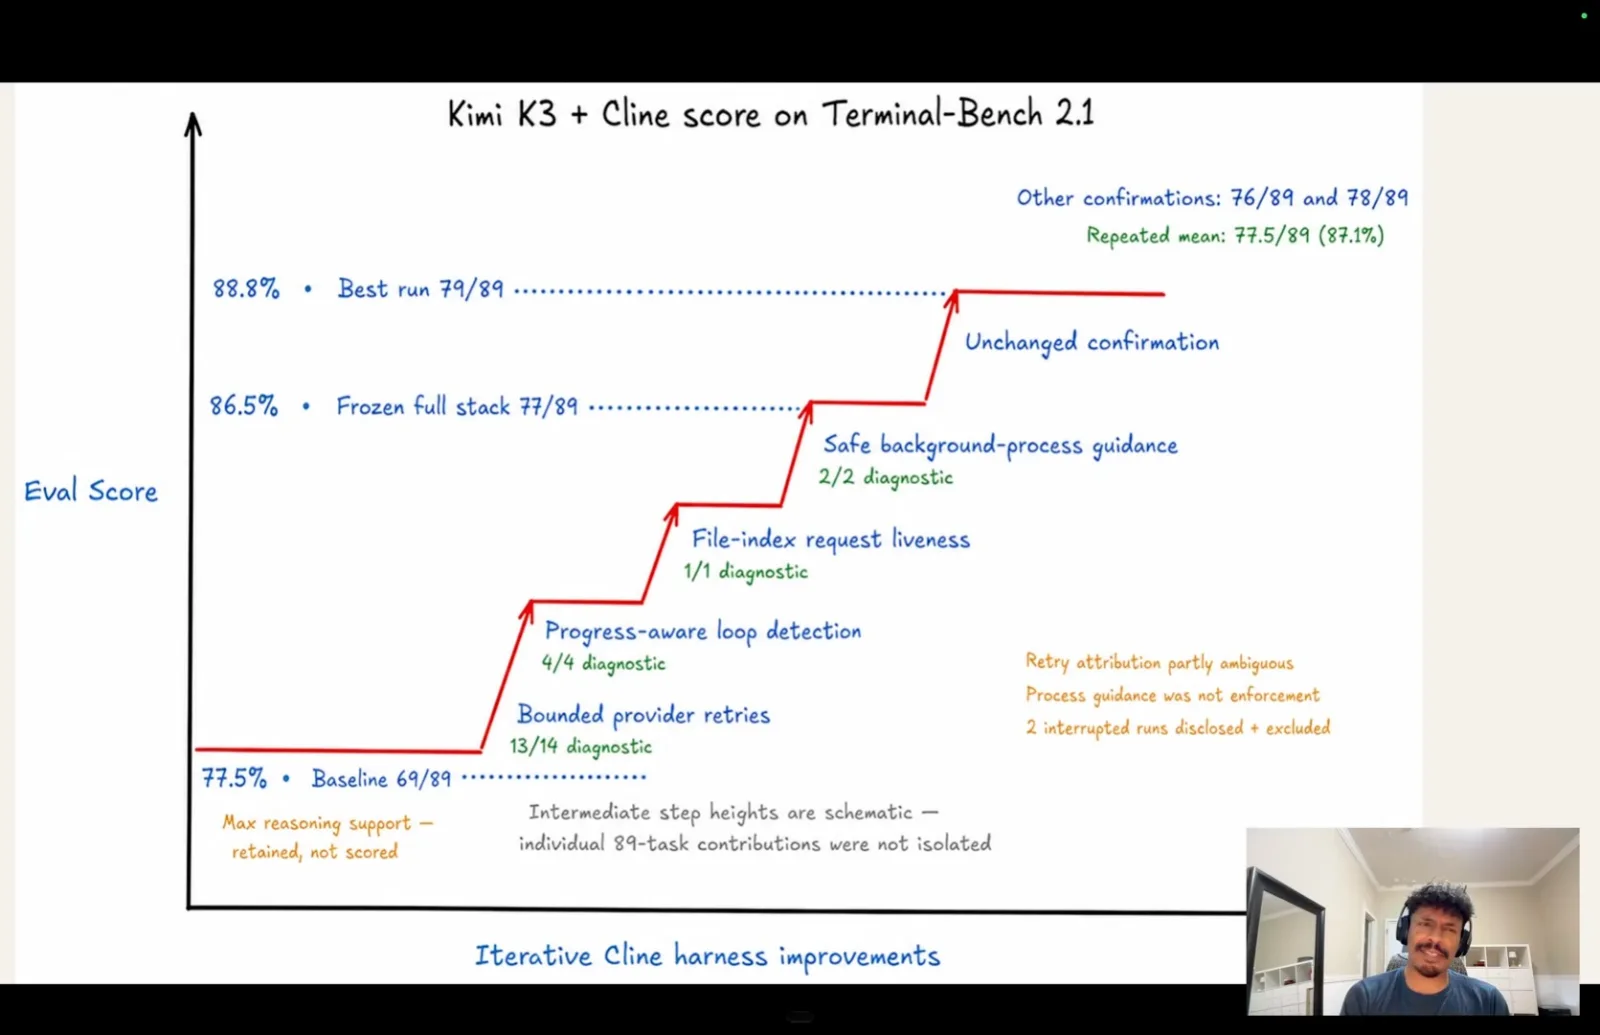
能够在同一组问题上不断改进的框架,展示了递归自我改进中的一个实际环节。更广义地说,这个想法是让 AI 系统帮助构建更强的后继系统,并重复这个过程。
我把这个想法的演变追溯到早期的对话式软件工程师愿景,经过 ChatGPT、函数调用、能读写文件的智能体和早期多智能体系统。早期方案往往不够稳定,而且很大程度上依赖预先编排。
接下来的问题是智能体能否变得更快、更便宜,进而能否改进自己。衡量这件事不能只靠提出一个问题并给答案打分。
用真实任务测试智能体
多步骤的智能体工作需要独立的结果检查。Terminal-Bench 在隔离环境中运行任务,暴露不同类别的失败。
例如,配置一个 MCP 服务器可能需要查文档、修改配置和文件并运行命令。测试必须确认智能体是否真正完成了请求,而不是只听它说完成了。
Terminal-Bench 在终端环境中评估智能体。我希望任务在沙箱中隔离运行,并由独立程序检查结果、耗时、令牌和工具调用,以及作弊或钻评分规则空子的迹象。
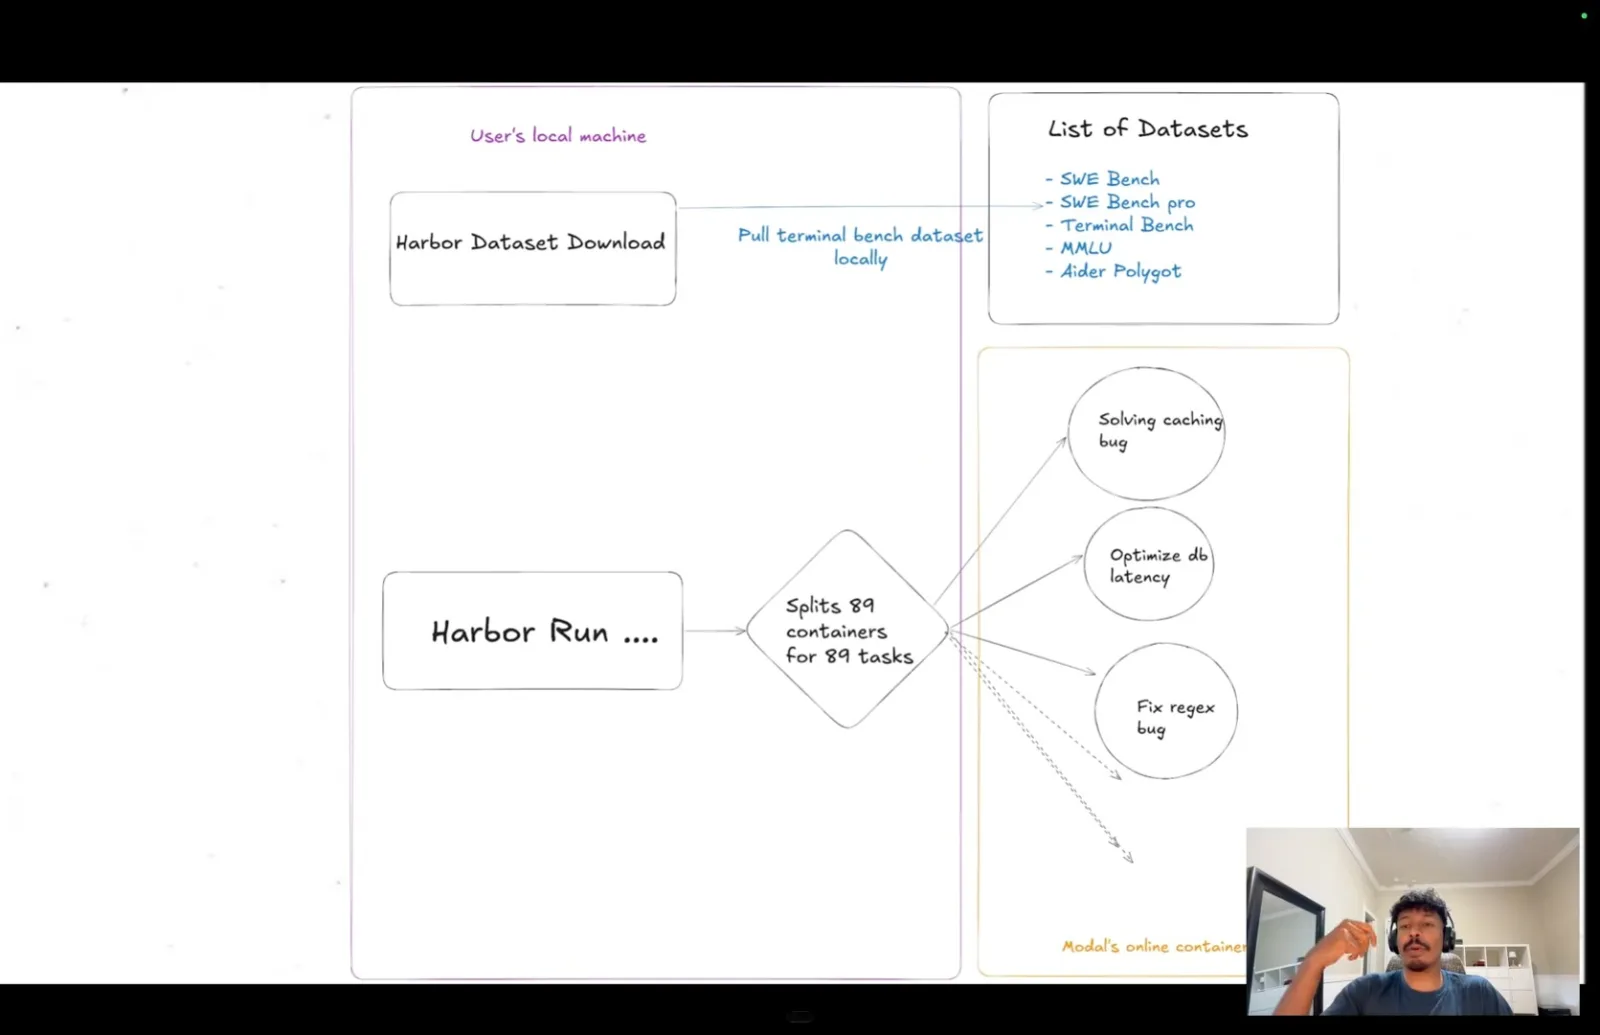
我介绍的版本包含 89 个任务。我们在并行容器中运行它们,汇总结果并对失败分类:读文件工具可能出错,推理可能停滞,任务也可能虽有进展却超时。
人工流程是检查这些失败类别、修改框架并重新评估。这个过程需要时间,但迭代能显示外围系统在哪些地方限制了模型的表现。
让改进循环自动运行
监督智能体检查失败并修改运行框架。Khan 提醒,这些修改应能推广到单一任务之外。
我们让一个长时间运行的 GPT 5.6 Sol 智能体负责检查 Kimi K3 的评估失败、修改 Cline 框架并重新测试。每次评估可能需要约一小时,还必须正确理解反馈,不能只是迎合评分。
运行期间,智能体发现了循环检测、后台进程和文件索引方面的问题,然后自行修改并重测。幻灯片显示基线为 77.5%,固定完整方案的结果为 86.5%,最佳一次为 88.8%;各中间步骤的独立贡献没有单独测量。
我把它看作两个循环:框架在环境中行动并接收反馈,另一个智能体观察结果并修改框架。我认为实时调整更难,因为它可能过度适应某一个问题。
因此,修改需要在更广泛的任务上得到验证。我认为,如果模型能够改进自己的运行框架,它们也能帮助改进系统的其他部分。
在软件和物理系统中改进
Khan 介绍了推理优化和硬件延迟实验。他认为,整个技术栈上的反馈循环可能成为更大循环的组成部分。
我引用了 OpenAI 报告的一个例子:模型优化生产环境中的计算内核,使端到端服务成本降低 20%,令牌生成效率提高 15%。我还提到一位内核竞赛获胜者称,其工作由智能体驱动,而非手写 GPU 算子。
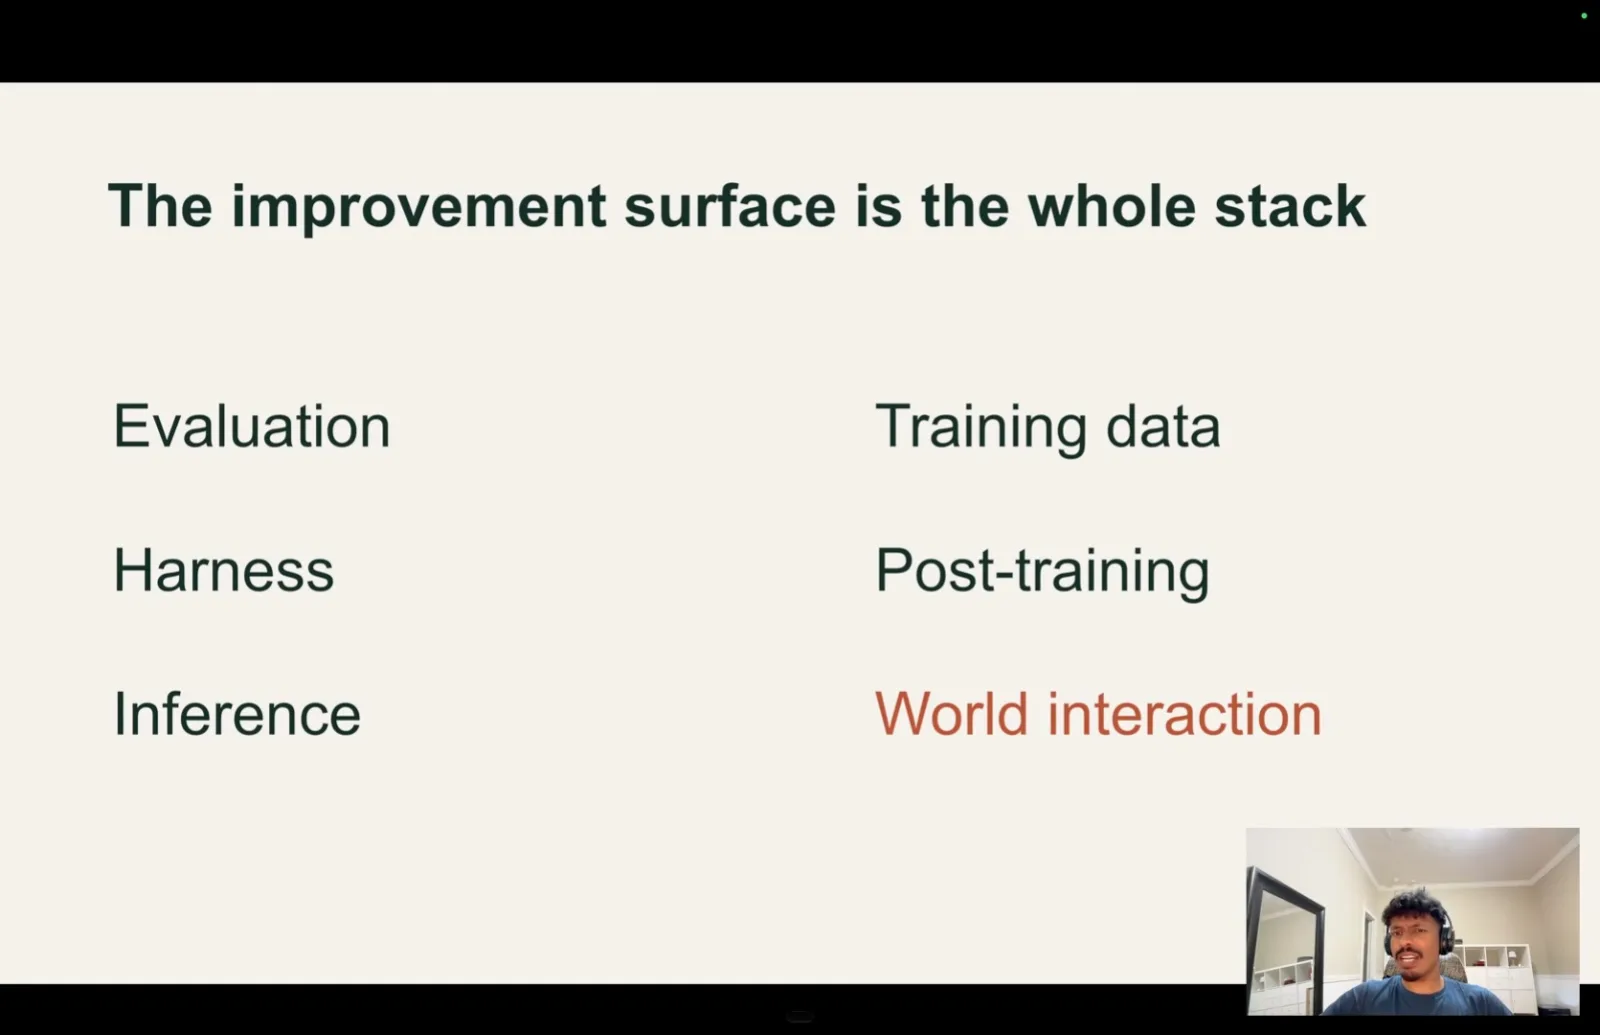
潜在的改进范围涵盖评估、运行框架、推理、训练数据、后训练和与现实世界的交互。推理成本下降可以让更多实验变得可负担。
当人纠正智能体时,例如为新增数据库列之后调整缓存,这种纠正标出了它的能力缺口。后训练可以利用困难、耗时的任务进一步拓展能力边界。
可验证的反馈循环不必局限于软件。我展示了一个打字的机器人,用来设想如果物理动作也能接受评估和改进会怎样。
我还用一个带摄像头、扬声器和麦克风的小设备做了更具体的硬件实验。它的智能体响应很慢,因此我把设备连接到电脑,让编程智能体对它运行测试。
智能体测量端到端延迟并调查响应慢的情况。我设置了通宵实验,让它们可以修改固件、工具调用以及推理和语音识别模型;我认为设备的响应因此得到了明显改善。
把这些循环连接起来,可能带来更便宜的推理、相同预算下更多的实验,以及更好的数据和模型。我认为这个循环的一些组成部分已经很接近了,但整个循环是否会走向奇点仍是开放问题。
选择能经受模型进步的工作
Khan 建议工程师寻找能受益于更好模型、却不会仅靠规模扩大就消失的宏大问题。他承认自己对时间线的判断存在不确定性。
我的职业建议是靠近自我改进循环。在我看来,某些狭窄的软件项目可能被一次模型更新超越;仅仅让模型完成日常任务,也可能让工程师自己的贡献空间变小。
这可能意味着投身推理、后训练、硬件、网络、物理交互或社区建设。重要的问题是:哪些工作既能从模型进步中受益,又能做出自己的贡献?
我引用了一张幻灯片:它建议开展有雄心、目标明确且快速的合作,并追问项目是否能在更强模型完成它之前做完。我会寻找能够受益于规模扩大、但不会仅靠规模扩大就解决的问题。
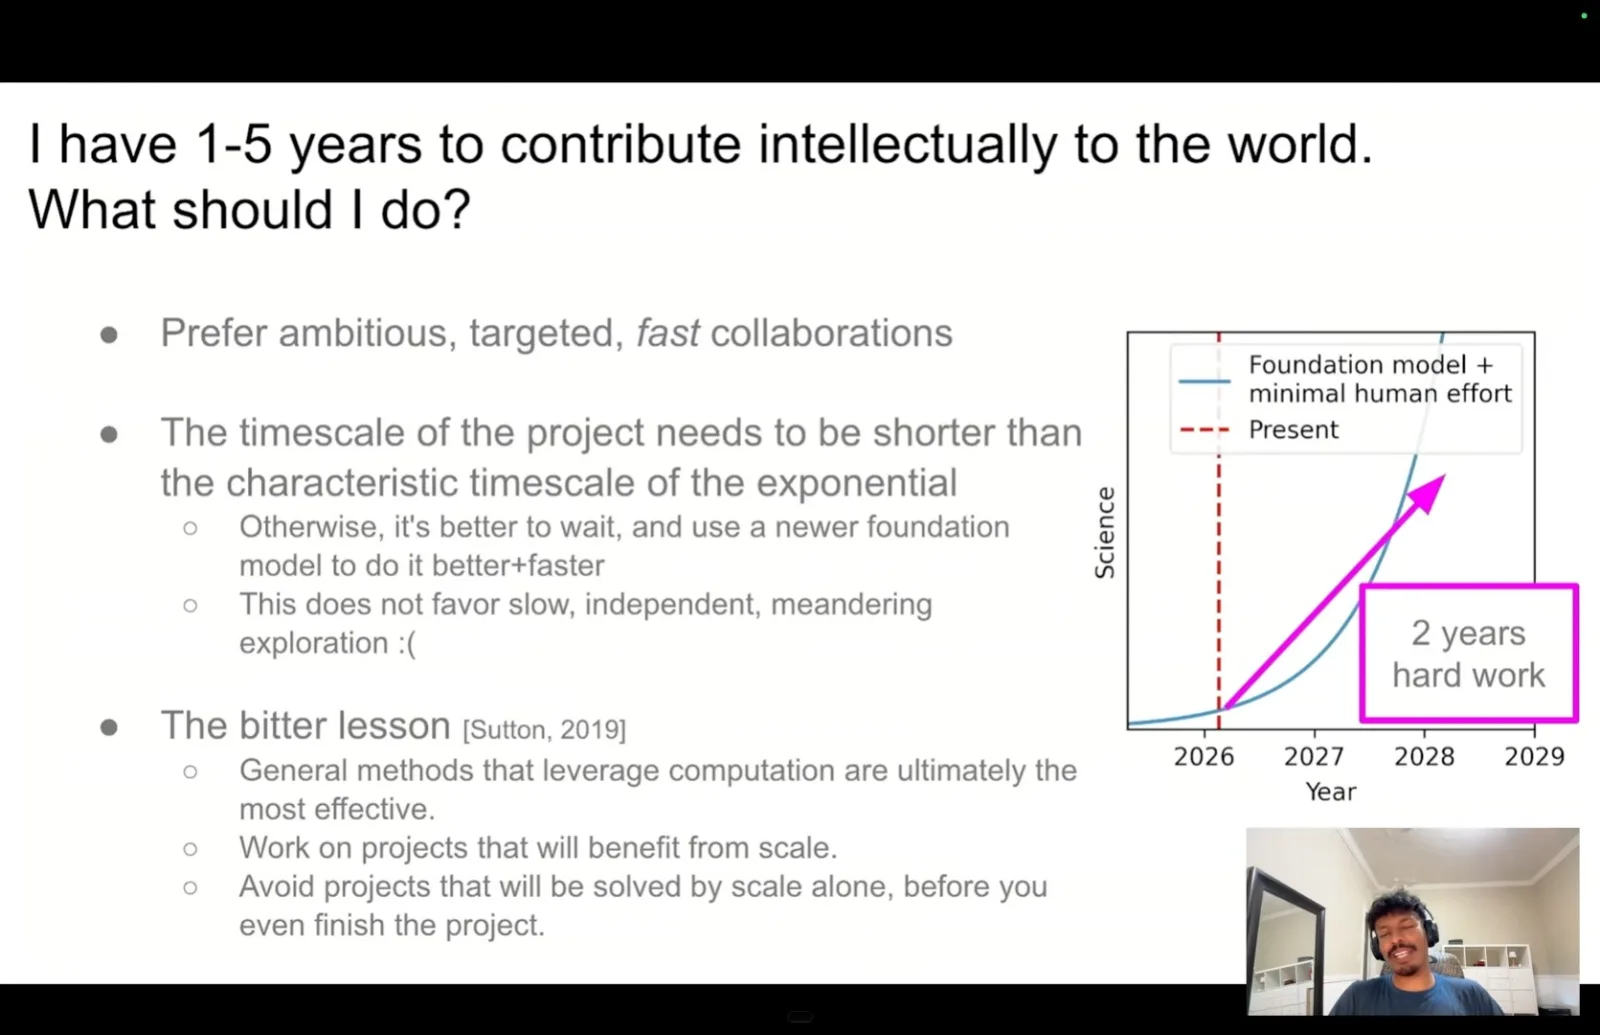
如果日常工作似乎变成了向模型转达任务,不妨退一步思考:你的判断和能力在哪里仍能发挥作用。我也承认自己对时间线的预期可能过于乐观或悲观,欢迎不同意见。
同频道的其他文章
 38:50EN → 简体中文
 AI Engineer· 2026年11月10日LinkedIn 的自我改进代理,先要修好评估裁判Ziwei Guo, Saloni Gandhi · LinkedIn一个提示词优化循环改进了职业代理,但团队首先需要通过人工校准提高评估器的可靠性。
 12:48EN → 简体中文AI Engineer· 2026年11月10日Brian Douglas:把智能体纠正记录变成可复用的审查知识Brian Douglas · Paper Compute这位 Paper Compute 开发者记录编程会话中的专家纠正,并测试如何在代码审查中复用。
 12:20EN → 简体中文AI Engineer· 2026年11月10日Ayush Bhardwaj:智能体的绕行做法就是命令行工具的反馈Ayush Bhardwaj · Allos AI对编程会话的审计显示,输出、错误和过时指令在哪些地方迫使智能体自行变通。
 12:57EN → 简体中文AI Engineer· 2026年11月10日Harvey 的代理扩张后,平台和合并队列接连遇阻Joey Wang · Harvey告警启动 900 个代理、一名工程师发出 950 个任务后,Harvey 增加了去重和公平调度。
 51:48EN → 简体中文AI Engineer· 2026年11月10日在调用生成模型之前,先组合小型决策Raymond Weitekamp · OpenProseRaymond Weitekamp 展示递归决策模型,并构想一个语音优先的电脑界面。
 23:00EN → 简体中文AI Engineer· 2026年11月10日PR 声称检查通过,需要关联到提交代码的证据Stephen Chin, Cassandra Chin · Neo4jStephen 与 Cassandra Chin 展示 Tracetoon 如何在起草可审查的拉取请求前关联智能体轨迹、代码修改与检查。