30 秒看懂
拉取请求可能声称测试通过,却没有证明测试覆盖了提交的修改。Cassandra 和 Stephen Chin 介绍了如何收集智能体会话轨迹,在起草之前用证据图关联命令、时间和修改。在他们自己的 PR Bench 比较中,较强的写作模型加上较便宜的定向审阅模型提高了描述质量,token 用量约减半;结果仅针对他们的评估。
- 1从不止当前会话重建分支历史Tracetoon 收集相关会话轨迹,而不是只依赖可能被压缩的当前上下文。
- 2记录的命令可能无法支持测试通过的说法示例说明命令顺序和代码版本为何重要。
- 3证据图关联修改、原因和检查Relate 为起草和审查组装带来源的证据包。
- 4他们的比较报告质量提高、token 用量降低这些结果来自讲者自己的 PR Bench 评估。
要点建议
- 将每项测试说法关联到实际检查的命令、时间和提交代码。
- 跨智能体会话保存决定及来源证据。
- 为撰写者和审阅者提供共享证据包。
- 用自己的修改同时评估质量与 token 成本。
按章节阅读整理后的全文
流畅的 PR 描述为何仍可能出错
讲者介绍 Tracetoon,以及反复重建分支历史的成本。
Cassandra Chin 开发 Tracetoon,目的是改善即使底层工作有价值、描述却可能不准确的拉取请求。她与 Stephen Chin 介绍了工具如何收集编程智能体上下文、审查说法,并可选生成漫画。
讲者用虚构的 token 工厂说明一个真实的审查问题:反复起草和审查可能消耗大量 token,但审阅者仍然看不到从代码修改到原因和检查的清晰证据链。
被要求撰写 PR 的编程智能体可能依赖当前会话,而会话上下文可能被压缩。Tracetoon 转而查看与分支相关的多个会话,重建其中的决定和工作。
Cassandra 将这一想法追溯到一个教育项目:项目需要了解提交程序背后的工作。她把同样的方法用于拉取请求,因为最终 diff 本身不能解释此前的决定或命令上下文。
通过检查的说法需要证据支持
原有起草和审查循环仍可能出错;命令顺序和提交代码版本都很重要。
最初的 Tracetoon 流程研究轨迹、起草描述,并请独立审阅者提出纠正。循环可以补充缺失上下文,但 Cassandra 说修订过程中仍可能引入错误。
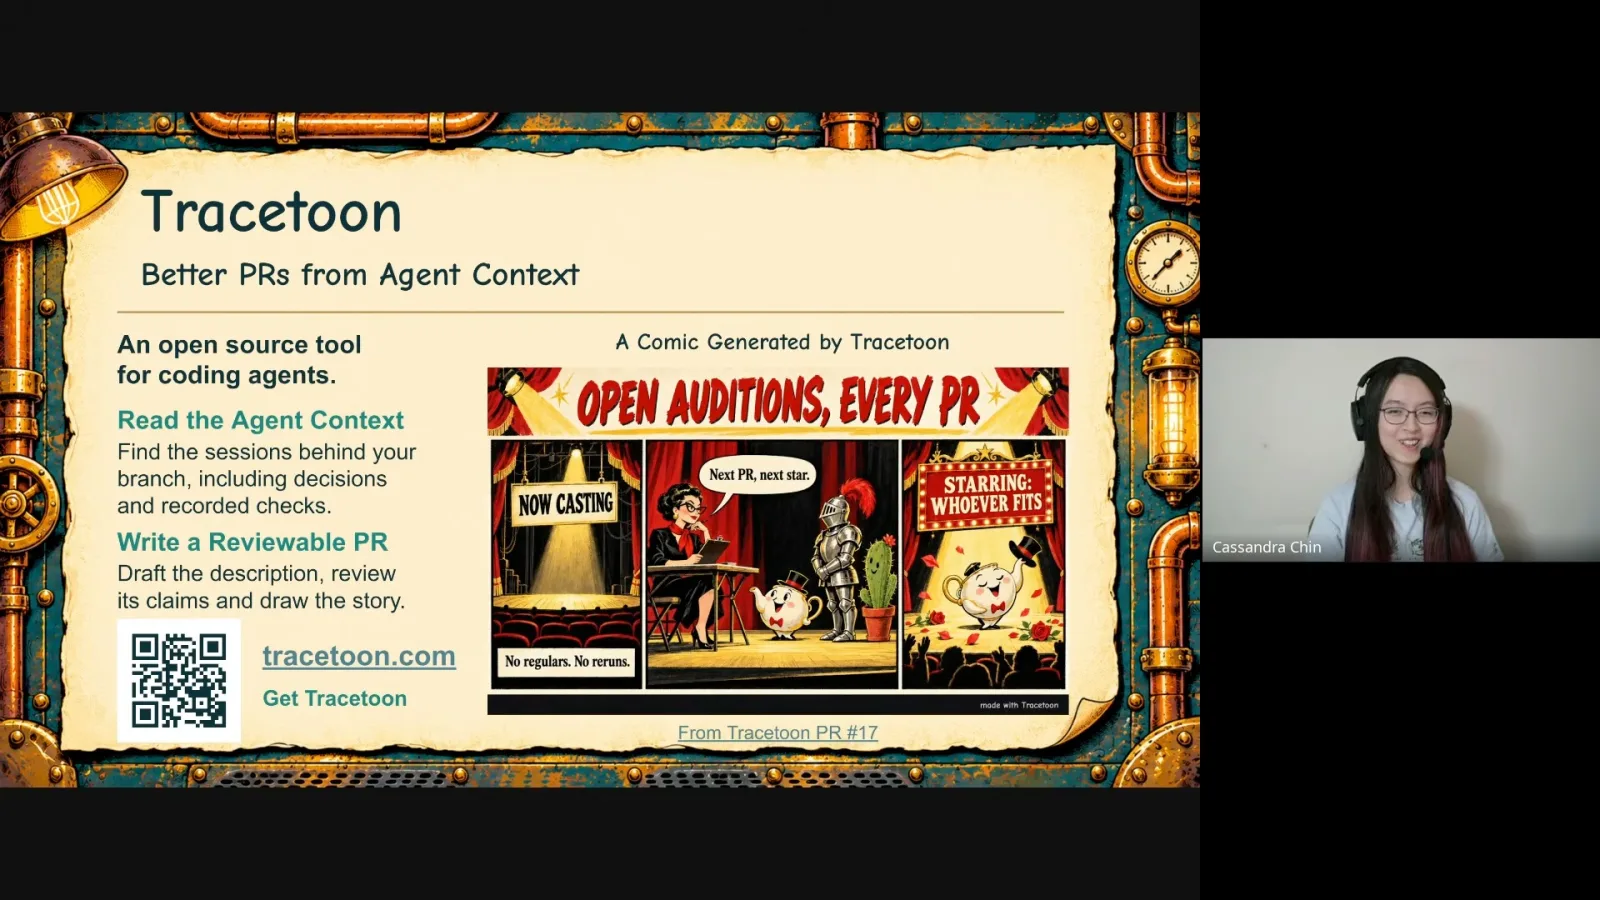
他们举例说,一次通过检查的说法没有得到记录顺序的支持:需要依次运行的命令似乎同时运行。流畅的 PR 描述不能证明提交的修改实际经过了测试。
在他们的测试中,仅仅换成更便宜的写作模型降低了质量。讲者因此保留能力更强的写作模型,转而寻找为写作和审查提供更好证据、同时避免反复昂贵搜索的方法。
写作前建立共享证据包
Relate 关联修改、原因和检查,定向审阅模型用证据包检查草稿。
他们介绍了用 Rust 编写的嵌入式图数据库 Relate。它保存修改、原因和检查之间的关系,使系统能够在智能体起草 PR 之前组装包含来源的关联证据包。
有了这份简报,审阅者可以用同一组证据检查具体说法。团队用较便宜的审阅模型处理更机械的交叉核对,同时保留较强模型负责写作。这是他们在自己任务中认为有效的组合。
生成的示例解释了为何记录工作目录、有哪些例外,以及哪些检查针对提交的内容运行。关键是让每项说法与相关版本的证据相连。
同时衡量质量和 token 成本
讲者报告 PR Bench 结果,并介绍其比较范围。
讲者介绍了使用自建 PR Bench 的比较,结合智能体轨迹、代码、模型评判和人工审查。他们报告质量有所提升,token 用量约减半;这些是该项目比较中的结果,并非普遍保证。
他们总结说,来源和关系应保存在单次模型对话之外。Tracetoon 与 Relate 被介绍为让撰写者和审阅者共享可检查 PR 依据的工具。
同频道的其他文章
 38:50EN → 简体中文
 AI Engineer· 2026年11月10日LinkedIn 的自我改进代理,先要修好评估裁判Ziwei Guo, Saloni Gandhi · LinkedIn一个提示词优化循环改进了职业代理,但团队首先需要通过人工校准提高评估器的可靠性。
 12:48EN → 简体中文AI Engineer· 2026年11月10日Brian Douglas:把智能体纠正记录变成可复用的审查知识Brian Douglas · Paper Compute这位 Paper Compute 开发者记录编程会话中的专家纠正,并测试如何在代码审查中复用。
 12:20EN → 简体中文AI Engineer· 2026年11月10日Ayush Bhardwaj:智能体的绕行做法就是命令行工具的反馈Ayush Bhardwaj · Allos AI对编程会话的审计显示,输出、错误和过时指令在哪些地方迫使智能体自行变通。
 12:57EN → 简体中文AI Engineer· 2026年11月10日Harvey 的代理扩张后,平台和合并队列接连遇阻Joey Wang · Harvey告警启动 900 个代理、一名工程师发出 950 个任务后,Harvey 增加了去重和公平调度。
 22:49EN → 简体中文AI Engineer· 2026年11月10日多个编程智能体共享代码库时,交付流程必须处理并发Patrick Debois · TesslPatrick Debois 解释共享规划、合并策略和按风险审查如何帮助团队协调智能体。
 15:41EN → 简体中文AI Engineer· 2026年11月10日Meta 的值班 AI 队友如何逐项获得自主权Chinmay Gandhi, Swaapnika Motapothula, Vlad Tsvang · Meta团队关联事故上下文与共享记忆,同时让关键决策和代码审查保留在人手中。