30 秒看懂
Raymond Weitekamp 探索,通常交给生成模型的任务是否可以组织成许多快速判断。他的递归决策模型把上下文放在模型外,让决策调用后续决策,并通过共享行动映射与大语言模型组合。例子包括分层搜索、游戏和受监督的音频原型;仲裁器则控制可能改变共享状态的竞争行动。
- 1决策模型不仅能充当工具,也能负责协调Weitekamp 探索以决策模型为根,并在需要时调用生成模型。
- 2分层搜索缩小大量选项的范围类别搜索选择分支,而不是一次加载全部类别。
- 3共享行动映射连接决策与生成命名选项把描述连接到可执行函数。
- 4并行决策改变状态之前需要关口仲裁器选择哪些提议的行动可以继续。
- 5小型音频模型学习何时快速响应Earshot 原型使用监督和独立的信任判断。
要点建议
- 决策模型在选项中选择,由代码执行行动。
- 递归调用可以逐步缩小搜索范围,无需一次呈现所有选项。
- 预定义选择不足时,生成模型可以扩展行动映射。
- 并行决策改变状态之前,仲裁器可以控制哪些行动通过。
按章节阅读整理后的全文
决策模型与递归
Weitekamp 解释决策优先的架构及其设计规则。
Raymond Weitekamp 介绍递归决策模型,以及他称为 Operating System One 的更广泛界面目标。他追问:哪些任务可以通过许多小决策完成,而不必持续生成文本?
他指出,系统一模型、决策模型和零样本分类器等名称仍有争议。在他的框架中,模型负责排序或判断选项,代码决定采取什么行动。
核心问题是:某些看似需要长时间推理的行为,是否可以组织成许多快速、范围有限的判断。
他的递归决策模型结合了递归语言模型和决策模型。他把扩展可能性的开放式生成,与在现有选项中选择作对比。
递归语言模型可以调用更小的实例,直到达到深度限制。Weitekamp 把类似树形结构用于决策调用,也考虑与普通智能体组合。
一种常见模式是把决策模型作为大语言模型的工具,例如路由请求或评估工具调用。他关注相反方向:由决策模型位于根部,并在需要时调用大语言模型。
他回顾一个 Doom 演示:一组决策负责即时移动,另一组负责地图探索,两者共同控制游戏智能体。
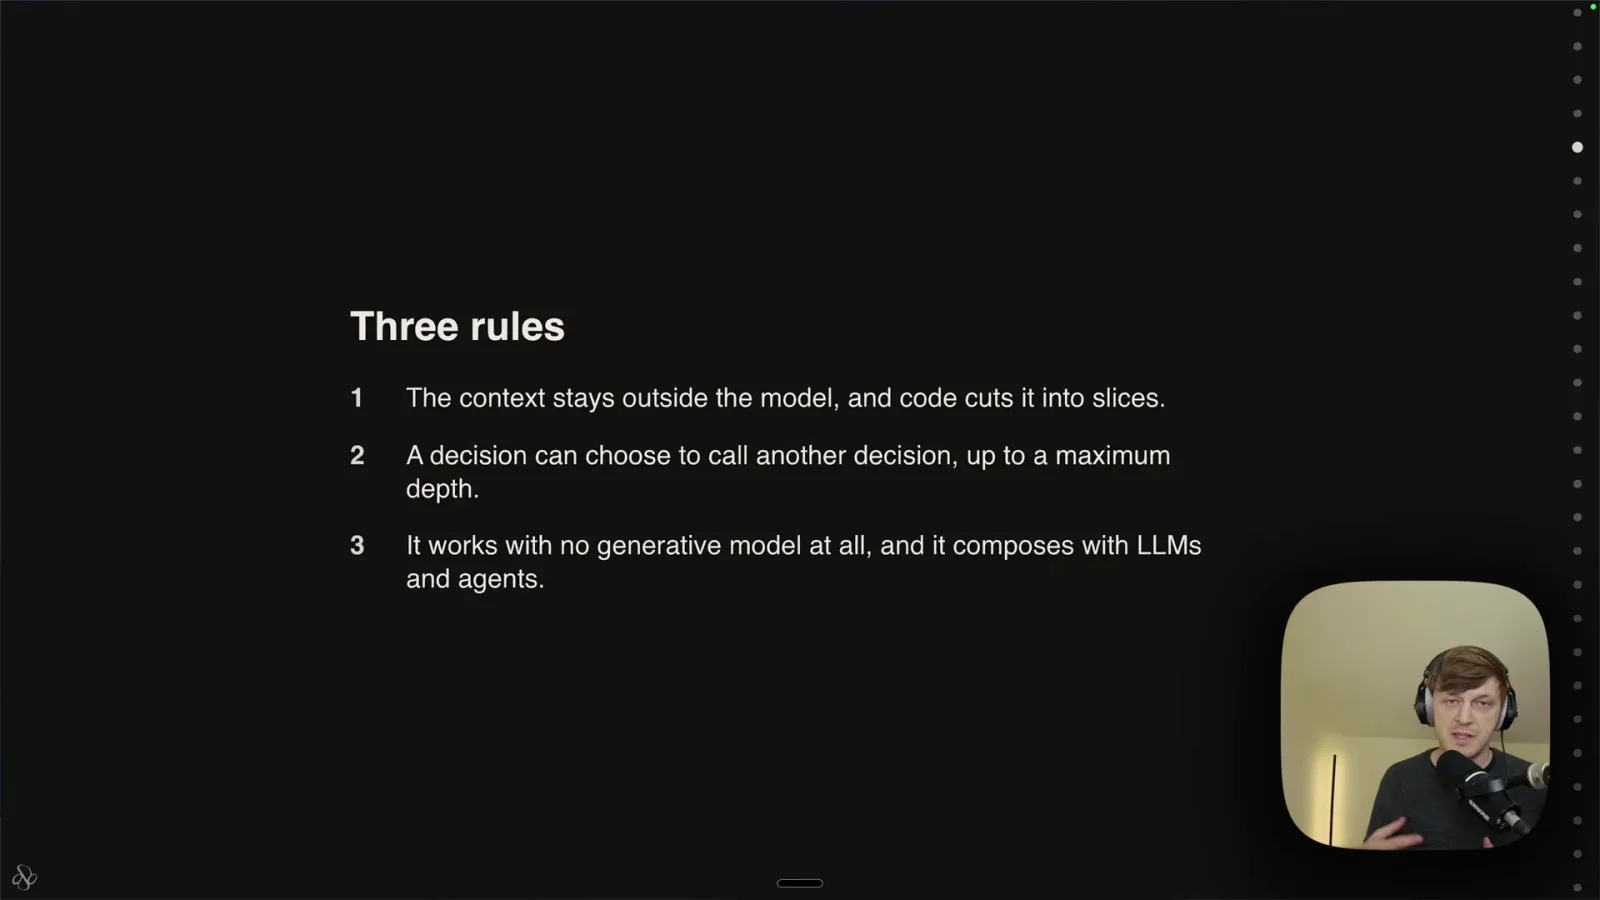
Weitekamp 提出三条设计规则:把上下文放在模型之外,供代码切片;允许决策调用后续决策;先让系统无需生成模型也能工作,同时允许组合生成组件。
搜索与游戏示例
玩具分类、产品搜索和游戏演示说明连续判断。
高尔顿板类比展示连续选择如何按属性给物品分类。他称其为玩具示例,并指出同样的简单任务可以通过一次分类调用完成。
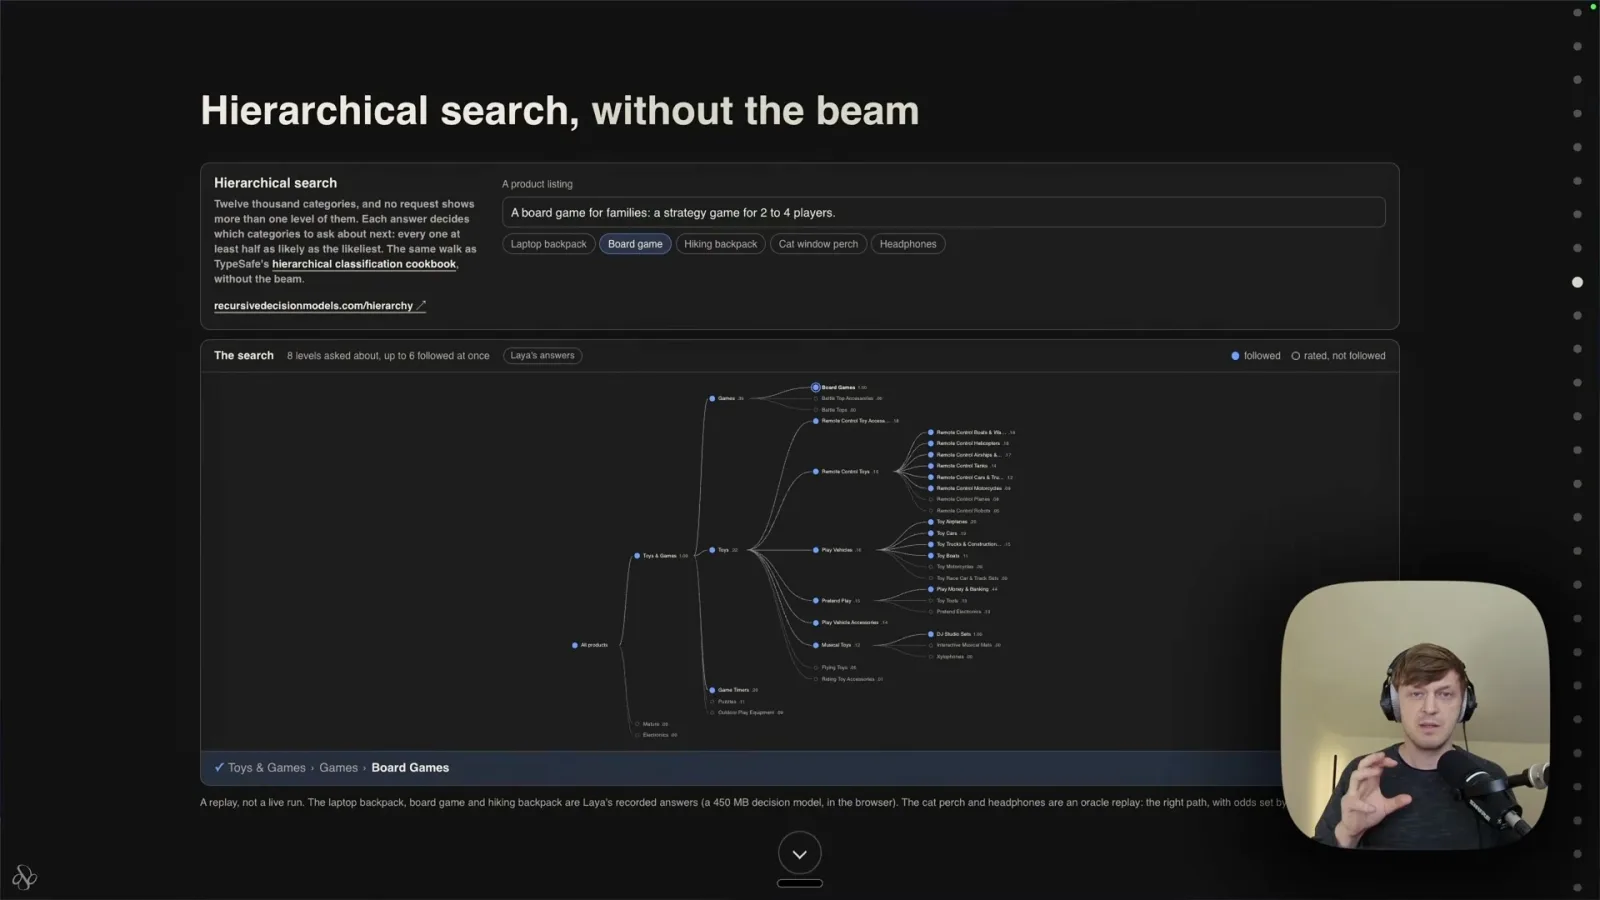
在分层产品搜索中,模型选择下一步探索大型类别树的哪条分支,而不必一次看到全部 1.2 万个类别。代码可以决定保留多少候选项。
他展示反复缩小图像区域的视觉搜索示例,同时承认能力较强的视觉模型可能一次就能解决其中一些例子。
在 Factorio 演示中,系统无需调用生成式语言模型,就通过决策找到有问题的生产线及待修复部件。他指出游戏中的行走路径并非最优。
将决策与生成结合
共享行动映射和仲裁器支持更灵活的协调行为。
纯决策系统有一个限制:应用、脚本或其他组件必须事先列出可用行动。它无法自行生成任意文本。
Weitekamp 认为,一些游戏、浏览器界面和计算机操作任务会暴露可枚举的行动,因此即使没有生成模型,决策树也可能有用。
生成模型可以创建或修改可用结构,从而补充固定决策树。他认为两类模型彼此互补,而不是可以互换。
智能家居示例把简单命令扩展为针对房间和设备的操作。决策系统负责选择行动,语言模型则处理需要生成的情况。
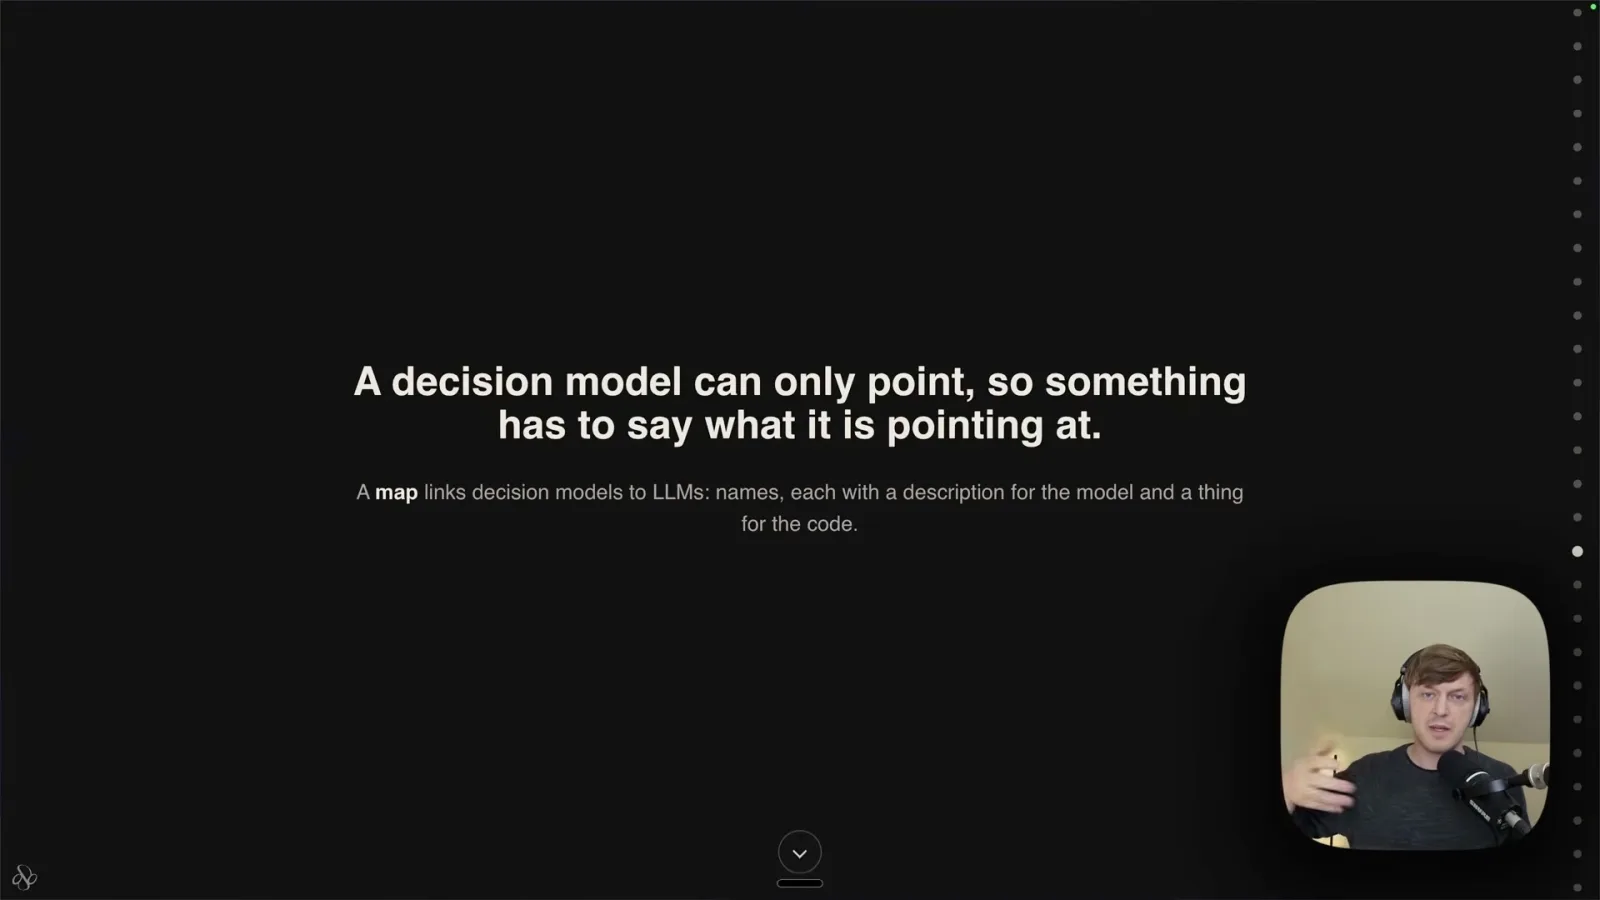
他把两者之间的共享接口称为 map:命名选项把描述连接到函数,语言模型则可以随着用户行为变化添加或修改条目。
仲裁器管理哪些提议的行动可以改变共享状态。当多个快速决策路径并行推测执行时,这能减少可能发生的冲突。
他以流式音频为例:多个路径可能在一句话结束前形成假设,仲裁器决定何时有足够信心采取行动。
最初的实现使用 DSPy;他还介绍了一个独立 Rust 包,供人实验这一方法。
走向语音优先界面
音乐实验和受监督音频原型启发了计划中的 OSO 项目。
Operating System One 是他减少操作电脑时身体负担的长期探索。他讲述了长期使用键盘和鼠标带来的不适。
他回顾音乐实验:笔记本传感器和普林斯顿笔记本乐团把手势与设备变成乐器。这也是他学习编程和机器学习的途径。
在 Earshot 原型中,一层转录音频并选择行动,同时一个小模型学习把短音频片段映射到同样的行动。
教师模型监督小模型,另一层决策负责判断预测何时足够可信。在他的演示中,响应随着学习逐渐变快。
他提到另一个本地视觉分类实验,说明小模型也能在音频之外支持响应迅速的界面。
他计划中的 OSO 电脑操作智能体从语音开始,采用决策优先的协调方式,也能把合适的任务交给普通编程智能体。他说项目尚未准备就绪。
更长期的想法是学习用户偏好,并在有足够证据信任较小、更快的模型时,把熟悉的决策转交给它们。
Weitekamp 邀请观众尝试递归决策模型的实现并关注 OSO 项目。
同频道的其他文章
 26:49EN → 简体中文
 AI Engineer· 2026年11月11日Ara Khan:选择能随 AI 进步而受益、又不会被取代的工作Ara Khan · ClineCline 的 Ara Khan 解释自动评估循环,并建议工程师选择能从模型进步中受益的问题。
 38:50EN → 简体中文AI Engineer· 2026年11月10日LinkedIn 的自我改进代理,先要修好评估裁判Ziwei Guo, Saloni Gandhi · LinkedIn一个提示词优化循环改进了职业代理,但团队首先需要通过人工校准提高评估器的可靠性。
 12:48EN → 简体中文AI Engineer· 2026年11月10日Brian Douglas:把智能体纠正记录变成可复用的审查知识Brian Douglas · Paper Compute这位 Paper Compute 开发者记录编程会话中的专家纠正,并测试如何在代码审查中复用。
 12:20EN → 简体中文AI Engineer· 2026年11月10日Ayush Bhardwaj:智能体的绕行做法就是命令行工具的反馈Ayush Bhardwaj · Allos AI对编程会话的审计显示,输出、错误和过时指令在哪些地方迫使智能体自行变通。
 12:57EN → 简体中文AI Engineer· 2026年11月10日Harvey 的代理扩张后,平台和合并队列接连遇阻Joey Wang · Harvey告警启动 900 个代理、一名工程师发出 950 个任务后,Harvey 增加了去重和公平调度。
 23:00EN → 简体中文AI Engineer· 2026年11月10日PR 声称检查通过,需要关联到提交代码的证据Stephen Chin, Cassandra Chin · Neo4jStephen 与 Cassandra Chin 展示 Tracetoon 如何在起草可审查的拉取请求前关联智能体轨迹、代码修改与检查。