30 秒看懂
Harvey 的 Spectre 平台已经处理了 1 万个代理编写的拉取请求,但 Joey Wang 说,困难的故障来自代理外围的基础设施。一场告警风暴启动了 900 个重复调查;之后一波 950 个任务又占满集群。团队为告警去重并引入公平启动队列,但公司 PR 数量增长 60% 后,合并环节仍是未解决的瓶颈。
- 1代码写完后,后续循环继续处理工作它验证真实技术栈、修复 CI 失败,并让 PR 进入统一审查流程。
- 2可调用接口每月产生 6,500 个终端启动的任务人和代理可以使用相同的命令行操作,无需打开网页应用。
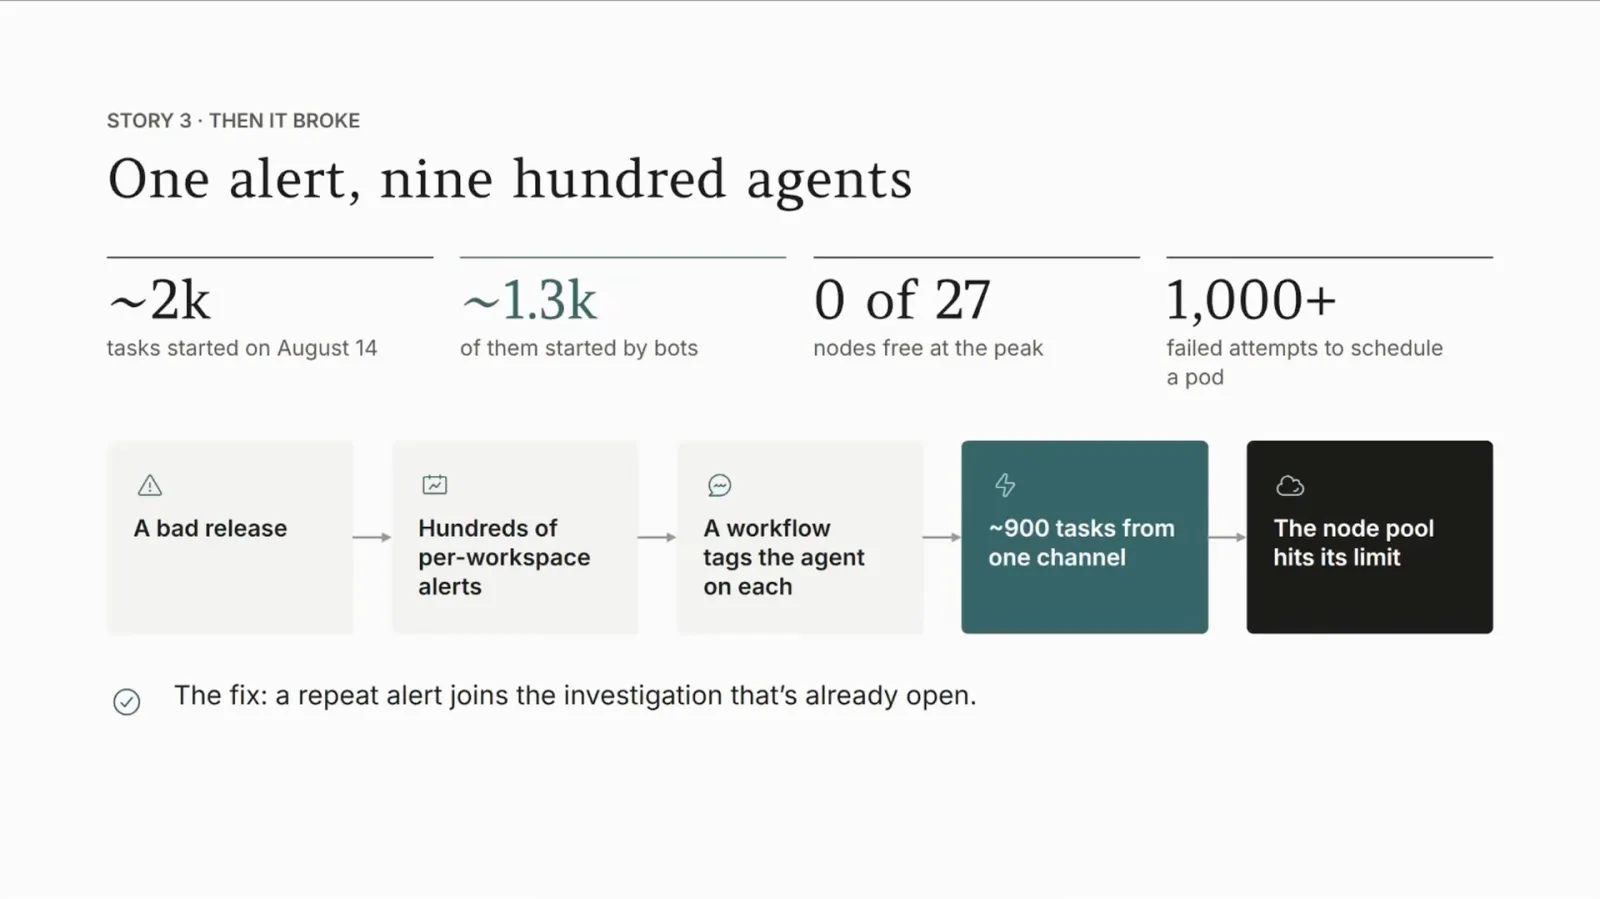
- 3一场告警风暴为同一个故障创建了 900 个调查现在重复告警会加入已有调查,而不是启动新任务。
- 4一名工程师的 950 个任务占满集群公平启动队列优先照顾交互用户并限制争用;在 300 任务模拟测试中,任务列表 p95 从 1.7 秒降至 71 毫秒。
- 5瓶颈转移到了尚未解决的合并队列公司 PR 数量一个月增长约 60%,合并时间从 15 至 30 分钟延长到一小时以上。
要点建议
- 对重复告警去重,让它们加入已有的代理调查。
- 通过排队和公平分配容量,防止用户或代理占满集群。
- 代码生成后,还要处理 CI 失败跟进、验证证据、审查和合并。
- 让代理能够调用平台操作,同时限制每个调用方能启动的工作量。
- 为无人值守的自动化设置失败次数上限、预算或到期日。
按章节阅读整理后的全文
代理外围的平台成为难点
Spectre 使用公司上下文运行现有代理,并提供统一流程;使用范围已经扩展到编码之外。
Joey Wang 说,上个月 Harvey 平台平均每分钟启动不止一个代理。经历 1 万个代理编写的拉取请求后,他的主要体会是,困难的故障出现在外围平台:调度、测试、审查和合并。
上个月约有 460 名 Harvey 员工使用该平台。工作范围也从编码扩展出去:员工在 Slack 询问数据问题,一位营销同事还根据原型和讲稿请求制作产品视频的分镜。
Wang 将内部云平台称为 Spectre。它运行现有编码代理,而不是与它们竞争、重新打造一个代理。在他看来,云端运行提供了公司密钥、真实技术栈、告警、工单、统一规则和容量,这些并非单个笔记本工具本身所具备。
代码生成之后还要完成工作
平台验证变更、跟进 CI 失败,并让 PR 进入共同审查队列。
团队没有为每个编码工具重复构建集成,而是让工程师选择喜欢的代理,并在底层调用 Spectre。工作可以从本地开始、转到云端再返回;共享平台处理初次代码编写之后的阶段。
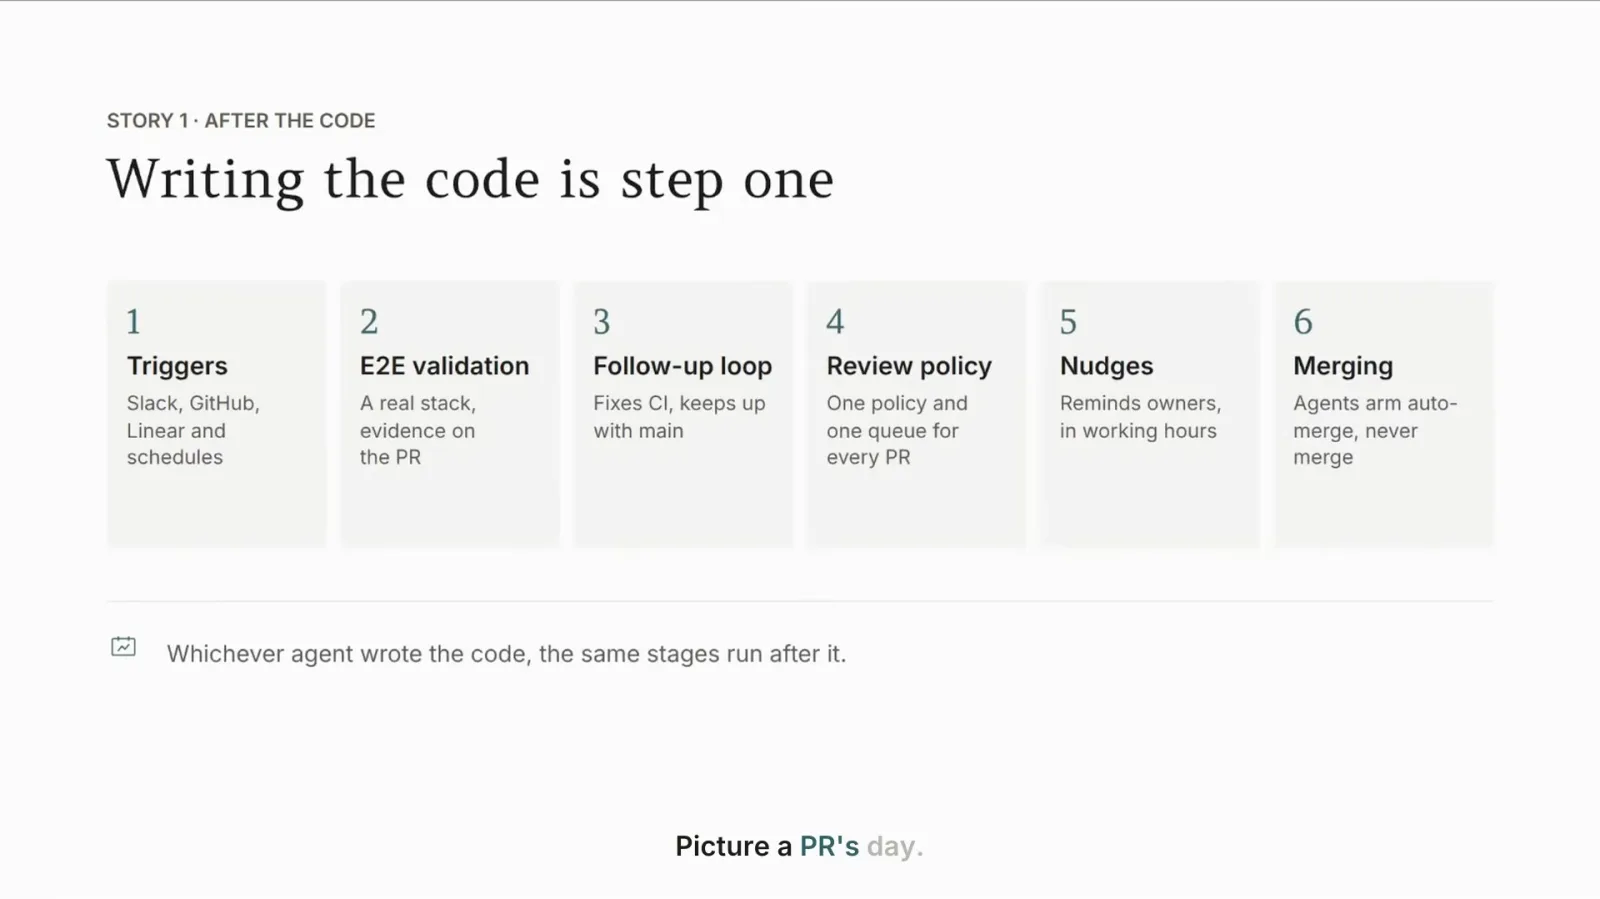
夜间告警发生后,代理可以编写修复、启动一套真实技术栈并把验证证据附到拉取请求。后续循环读取 CI 失败并推送修复。请求进入统一审查队列,负责人在工作时间收到提醒,批准后代理可以启用自动合并。
Wang 说,后续循环于 10 月初向所有人启用;当月合并到后端的代理 PR 中,五分之四经过了这一循环。团队还记录项目知识和可信技能,让代理共享测试说明并保留审计记录。
让代理调用所有平台操作
命令行让本地代理、沙箱代理和 CI 都能启动工作,每月终端启动的任务增长到数千个。
下一条规则是:如果人能点击某个操作,代理就应能调用它。命令行可以启动任务、启用后续循环或自动合并,以及发布页面。笔记本代理、沙箱代理和 CI 都能使用同一接口。
5 月只有一个任务来自终端;到 10 月,命令行每月启动约 6,500 个任务,而网页应用仍在使用。有人每月启动数百个任务,却完全不打开应用。
Wang 曾让本地代理担任协调者,把工作拆成十个里程碑,并向 Spectre 发送数百个任务,每个任务都有隔离环境进行端到端验证。他还介绍了一个助手:列出等待他答复的问题,起草答案,得到他的同意后再发送。
任务最慢的阶段不是模型推理,而是检出代码库:复制所有代码库平均需要一分多钟。团队在每台机器上保留各代码库副本,让任务借用。
两次任务风暴占满集群
重复告警和大批正常任务暴露了容量限制,团队通过去重和公平启动队列应对。
8 月一次错误发布为每个工作空间触发了告警。工作流对每条告警都标记代理,四小时内产生约 900 个任务,平时约为 50 个。它们追查同一个故障,直到节点容量耗尽。修复办法是让重复告警加入已有调查。
10 月,一位工程师在约三小时内通过命令行发送了约 950 个正常任务。一台笔记本就占满了集群,其他人的工作都排在后面。Wang 将其视为平台设计问题,而不是工程师使用不当。
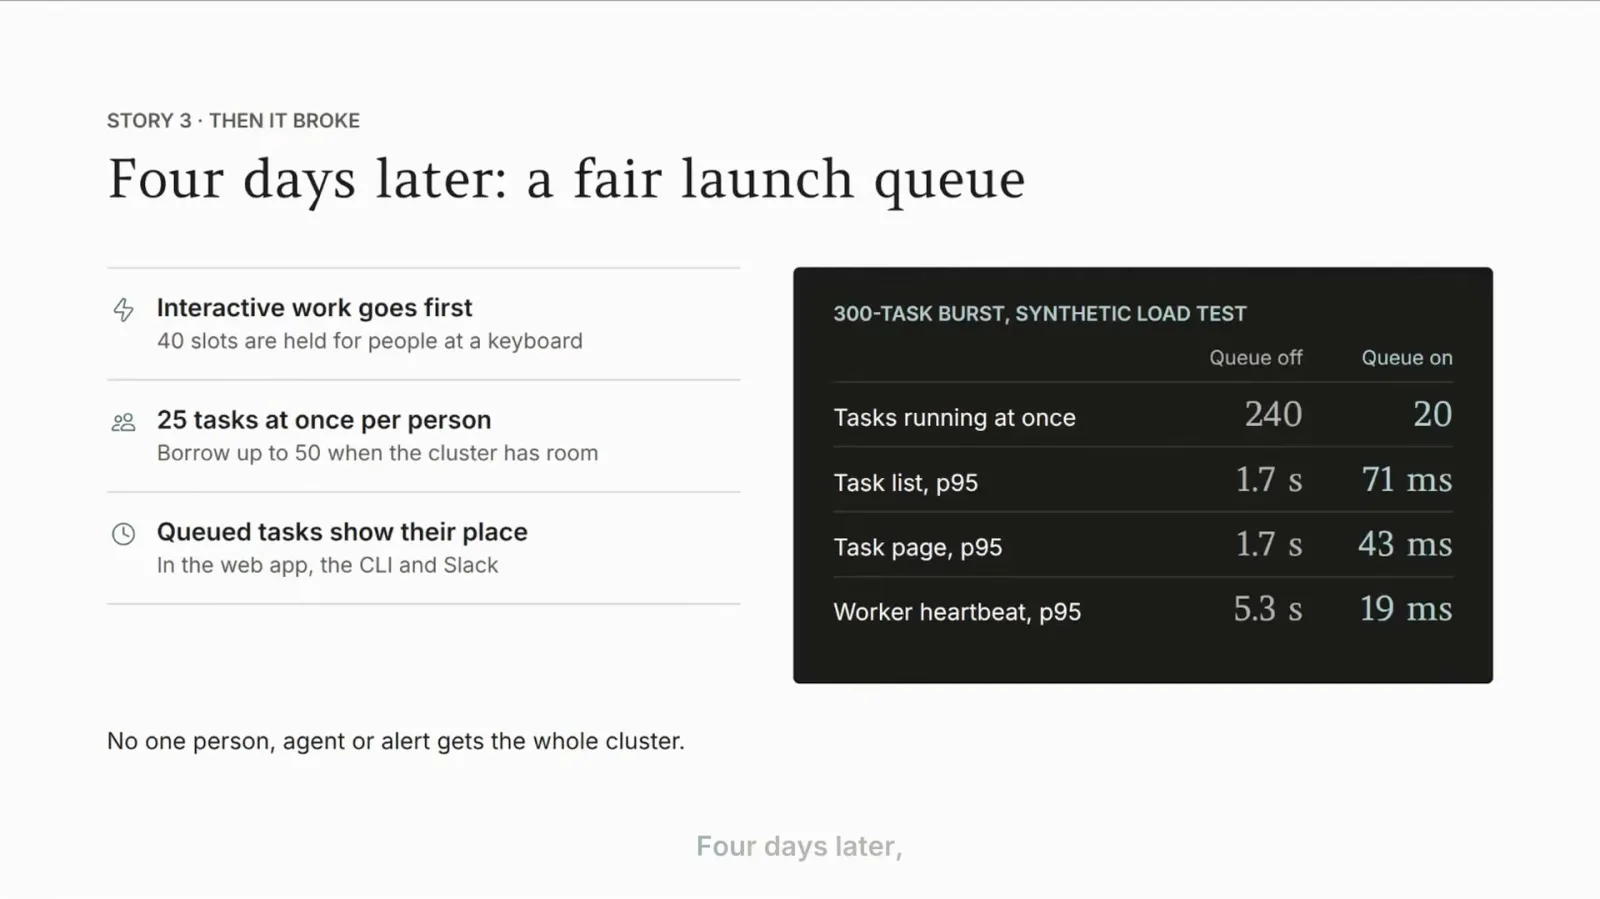
四天后团队引入公平启动队列:交互用户优先,每人获得公平份额并可借用闲置容量,排队任务会显示位置。在 300 个任务的模拟突发测试中,启用队列后任务列表的 p95 延迟从 1.7 秒降至 71 毫秒。
Wang 说,之后一个繁忙日的任务量超过 8 月高峰的两倍,完成情况也更好。由于团队同时进行了多项修改,他无法把改善归因于某一项修复。此后突发量继续增大,平台仍然跟上。
合并成为下一个未解决的瓶颈
PR 数量激增使合并队列过载;无人值守的定时自动化同样需要限制。
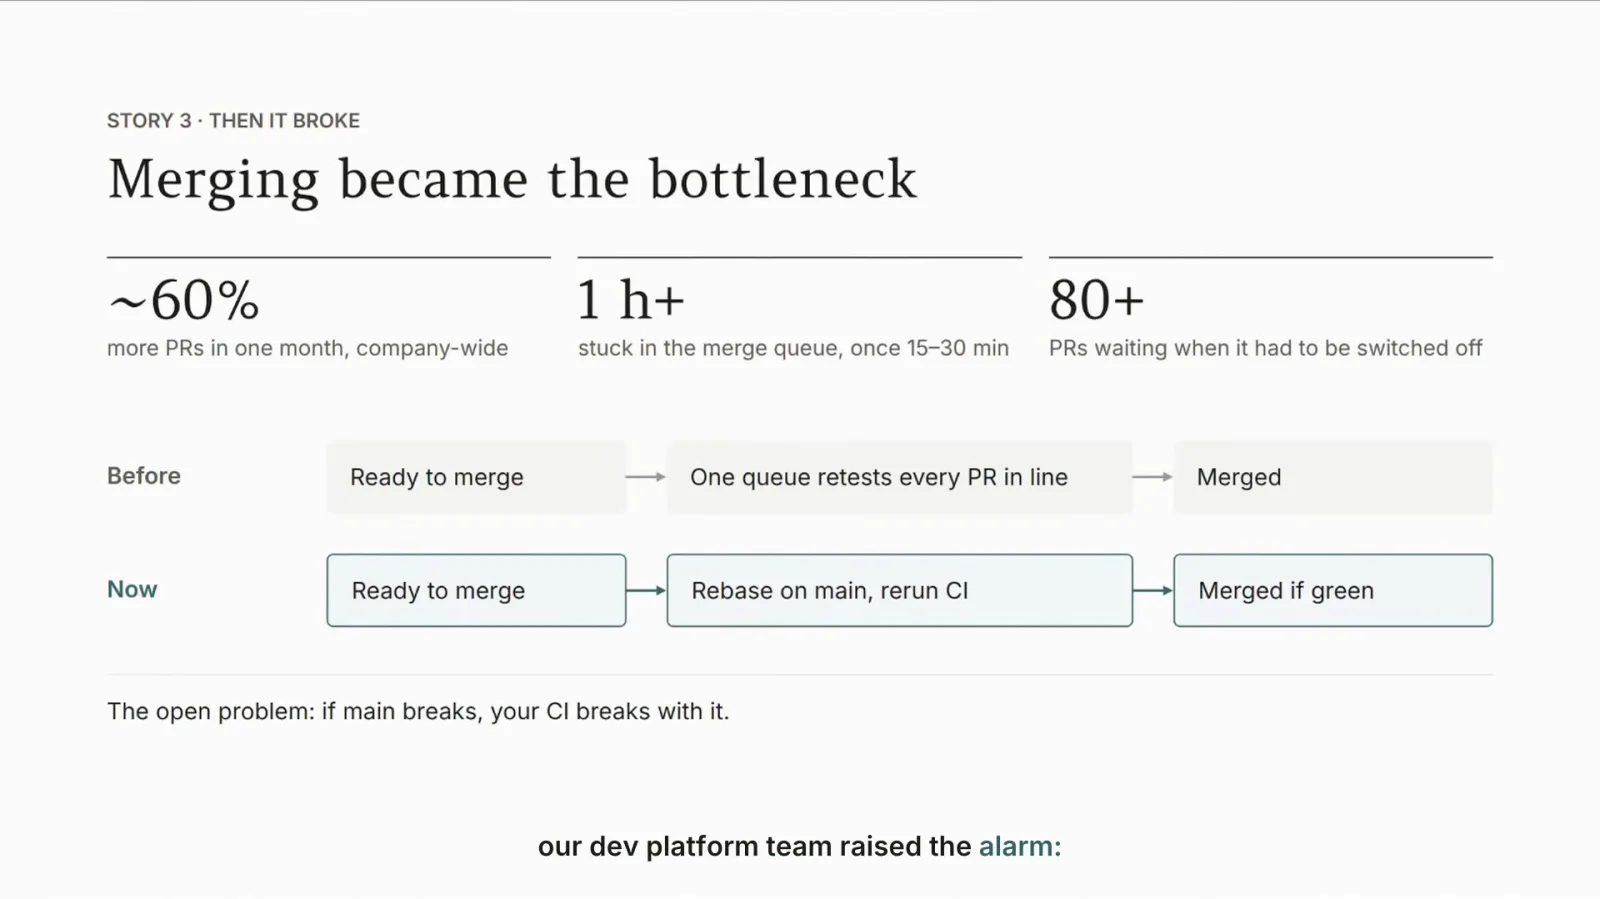
随后瓶颈转移到了合并环节。公司 PR 数量一个月内增长约 60%,原本需要 15 至 30 分钟的合并超过一小时。合并队列不得不关闭;现在 PR 要变基到主分支并重跑 CI,主分支出错时所有人都会受影响。Wang 说这一问题尚未解决。
按时间表或事件启动的自动化正在快速增长。上个月约有 110 人运行了自动化。任务连续失败五次后会自动停用,也可以设置预算或到期日,以限制无人值守时产生的大量任务。
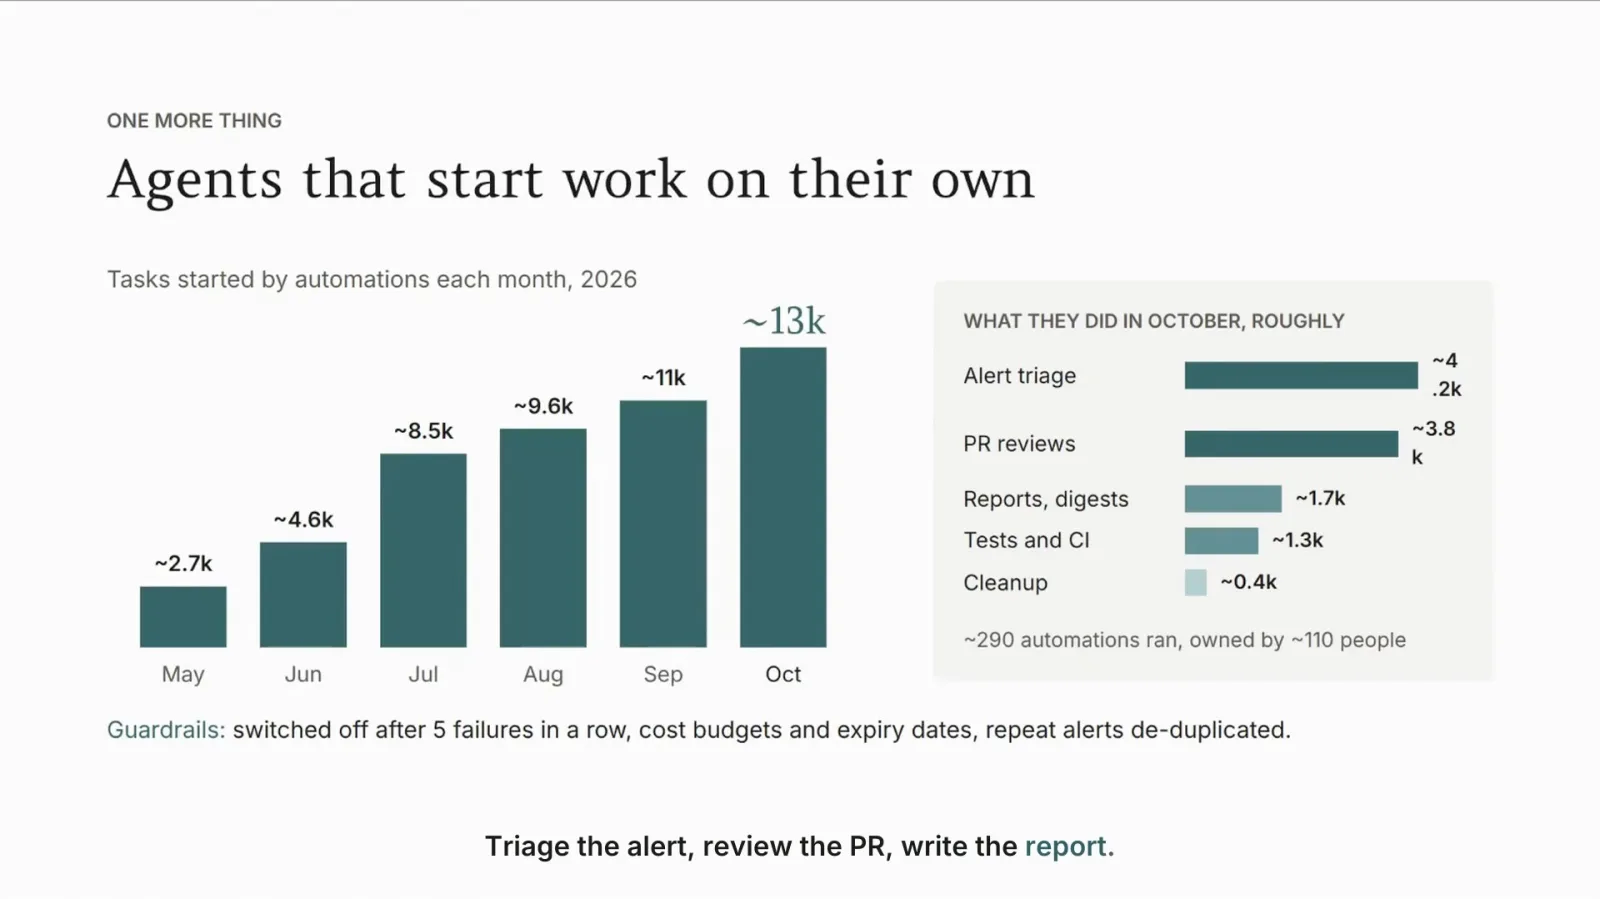
Wang 仍在探索如何运行持续在线的频道代理、让人在审查 PR 前就获得验证证据,以及在代理不断创建请求时如何完成合并。他说,目前只有约二十分之一的合并附有此类证据。
他的建议是负责代码写完后的流程,让代理能够调用各项操作,并限制代理、人员或告警可以启动的工作量。工程师可以选择喜欢的编码代理;共享系统仍需负责运行、检查和合并工作。
同频道的其他文章
 38:50EN → 简体中文
 AI Engineer· 2026年11月10日LinkedIn 的自我改进代理,先要修好评估裁判Ziwei Guo, Saloni Gandhi · LinkedIn一个提示词优化循环改进了职业代理,但团队首先需要通过人工校准提高评估器的可靠性。
 28:00EN → 简体中文AI Engineer· 2026年11月10日Robinhood 的 AI 审查让 60% 的数据 PR 无需人工审核合并Chetas Joshi · Robinhood脚本核验实时事实,代理追踪代码风险,敏感决策由人负责。
 19:41EN → 简体中文AI Engineer· 2026年11月9日高可靠自动化的第一步:把难处理的案例分流出去Matthew Jewkes · Standard CyberneticsMatthew Jewkes 介绍如何在生物医药文档索引流程中区分关键错误、模糊判断和异常情况。
 52:08EN → 简体中文AI Engineer· 2026年11月9日编码智能体压垮自托管模型时,应尽早拒绝请求Harshul Jain, Parv Khatri · Audible准入控制可以保护 GPU 容量,但评测时必须计算所有到达的请求,包括被拒绝的请求。
 22:01EN → 简体中文AI Engineer· 2026年11月9日Zach Lloyd:让软件工厂可以衡量和修改Zach Lloyd · WarpWarp CEO 建议记录智能体运行、评估失败原因,并用真实任务测试工作流的改动。
 27:35EN → 简体中文AI Engineer· 2026年11月9日Uber 为加快 AI 时代的代码合并,放弃主干始终通过测试Preetam Dwivedi, Manjari Akella · Uber合并队列放宽部分冲突限制,合并后再验证组合状态,并保留已验证的可用版本。