30 秒看懂
Matthew Berman 回顾 BloombergGPT 的 500 亿参数架构、金融和通用训练数据、硬件及评估,并思考金融专用模型的商业价值与开放性的取舍。 原论文的数据章节标题和表格给出的比例不一致;表格列出 FinPile 占总语料的 51.27%。作者明确表示不会发布该模型。视频没有披露赞助。
- 1混合语料论文将 FinPile 金融文档与公开通用数据源相结合。
- 2比例不一致论文的章节标题写为 54.2%,而表 1 显示 FinPile 占语料的 51.27%。
- 3评估展示的每字节比特数比较针对保留的金融数据,数值越低越好。
- 4模型开放性与 Berman 的解读不同,作者明确表示不会发布模型。
要点建议
- BloombergGPT 结合了约 3,630 亿个金融数据 token 和 3,450 亿个公开通用数据 token。
- 论文表格显示 FinPile 占语料的 51.27%,而一个章节标题给出的 54.2% 与之冲突。
- ALiBi 原则上允许处理比训练序列更长的输入,但不能保证任意长度下的质量。
- 在展示的保留金融数据语言建模比较中,BloombergGPT 表现较好,但这不能证明它在所有任务中都更优。
- 作者表示不会发布模型,理由包括对 FinPile 数据泄露的担忧。
- Berman 对访问方式和定价的预测属于猜测;视频没有披露赞助。
按章节阅读整理后的全文
模型及其训练数据
Berman 介绍 500 亿参数模型及其金融和通用文本的混合语料。论文报告的金融数据占比存在内部不一致。
2023 年 4 月,我评测 BloombergGPT,这是一款为金融领域开发的 500 亿参数语言模型。我对结合公司专门的金融档案和通用文本的想法感到兴奋,而不是只使用其中一种数据训练。Bloomberg 发表了介绍模型的研究论文;这一公告本身不意味着其权重已公开发布。
[论文](https://arxiv.org/abs/2303.17564v1)介绍了约 3,630 亿个金融文档 token 和来自公开通用数据集的 3,450 亿个 token。金融数据集 FinPile 包括英文金融网页、新闻、申报文件、新闻稿和 Bloomberg 档案资料。这些是语料规模,并不是说每个 token 都是专有数据,也不是说训练中所有数据都恰好使用了一次。
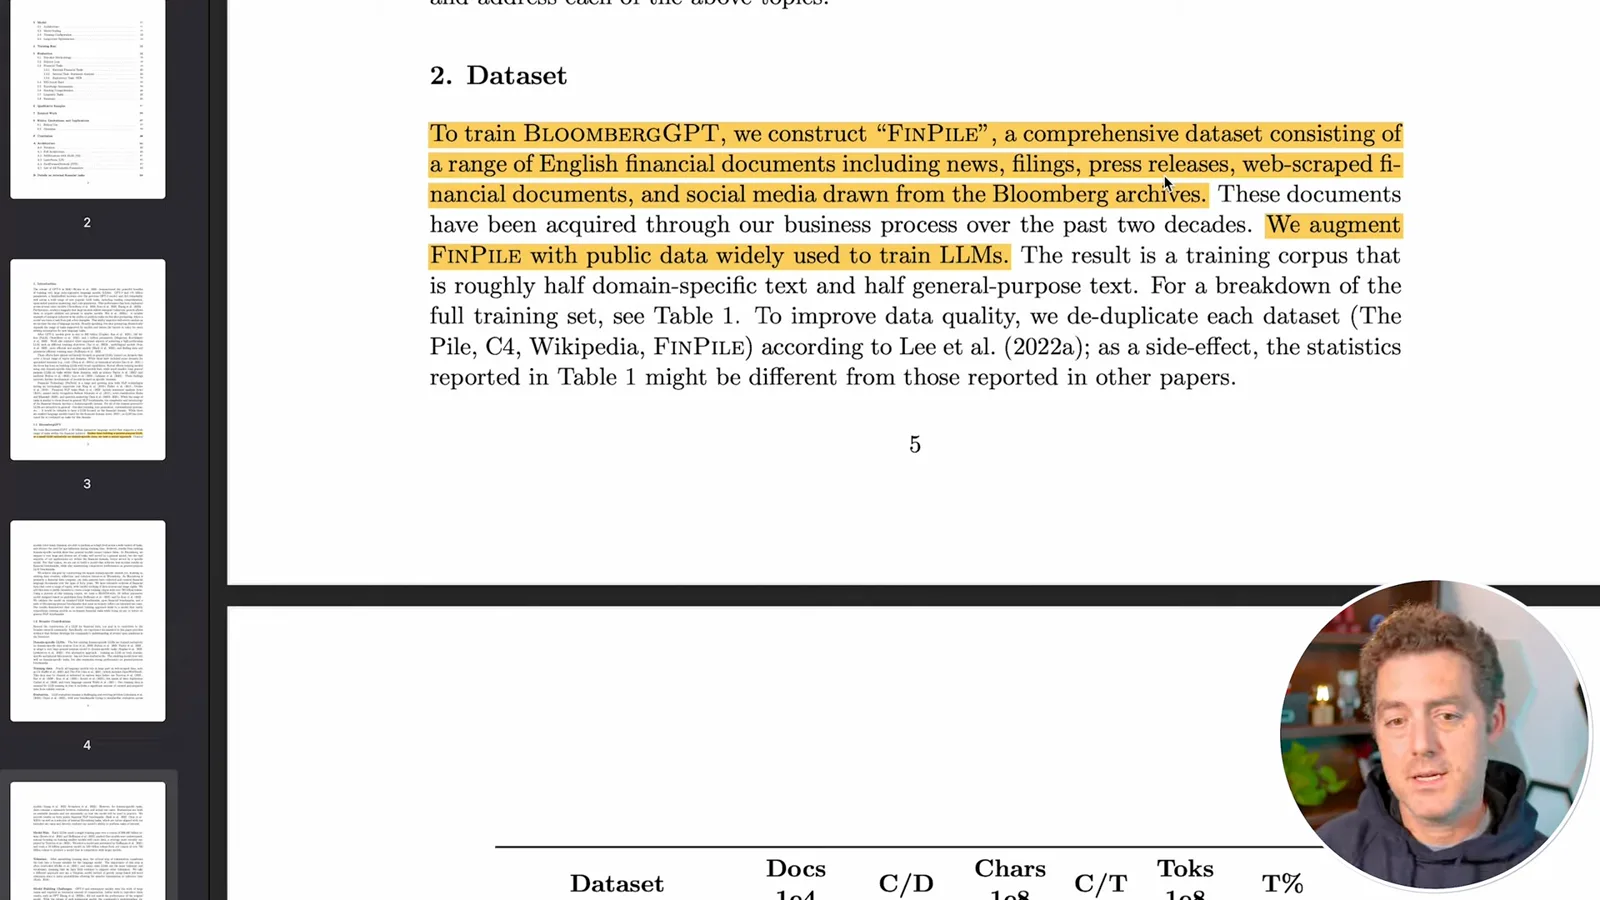
Bloomberg 使用 The Pile、C4 和 Wikipedia 等公开来源补充 FinPile。展示的组成部分包括 GitHub、Books3、FreeLaw、Stack Exchange、专利文本、YouTube 字幕、Hacker News 和 Enron 邮件。它们出现在表格中,并不代表对每项内容的质量或权利状态作出判断。
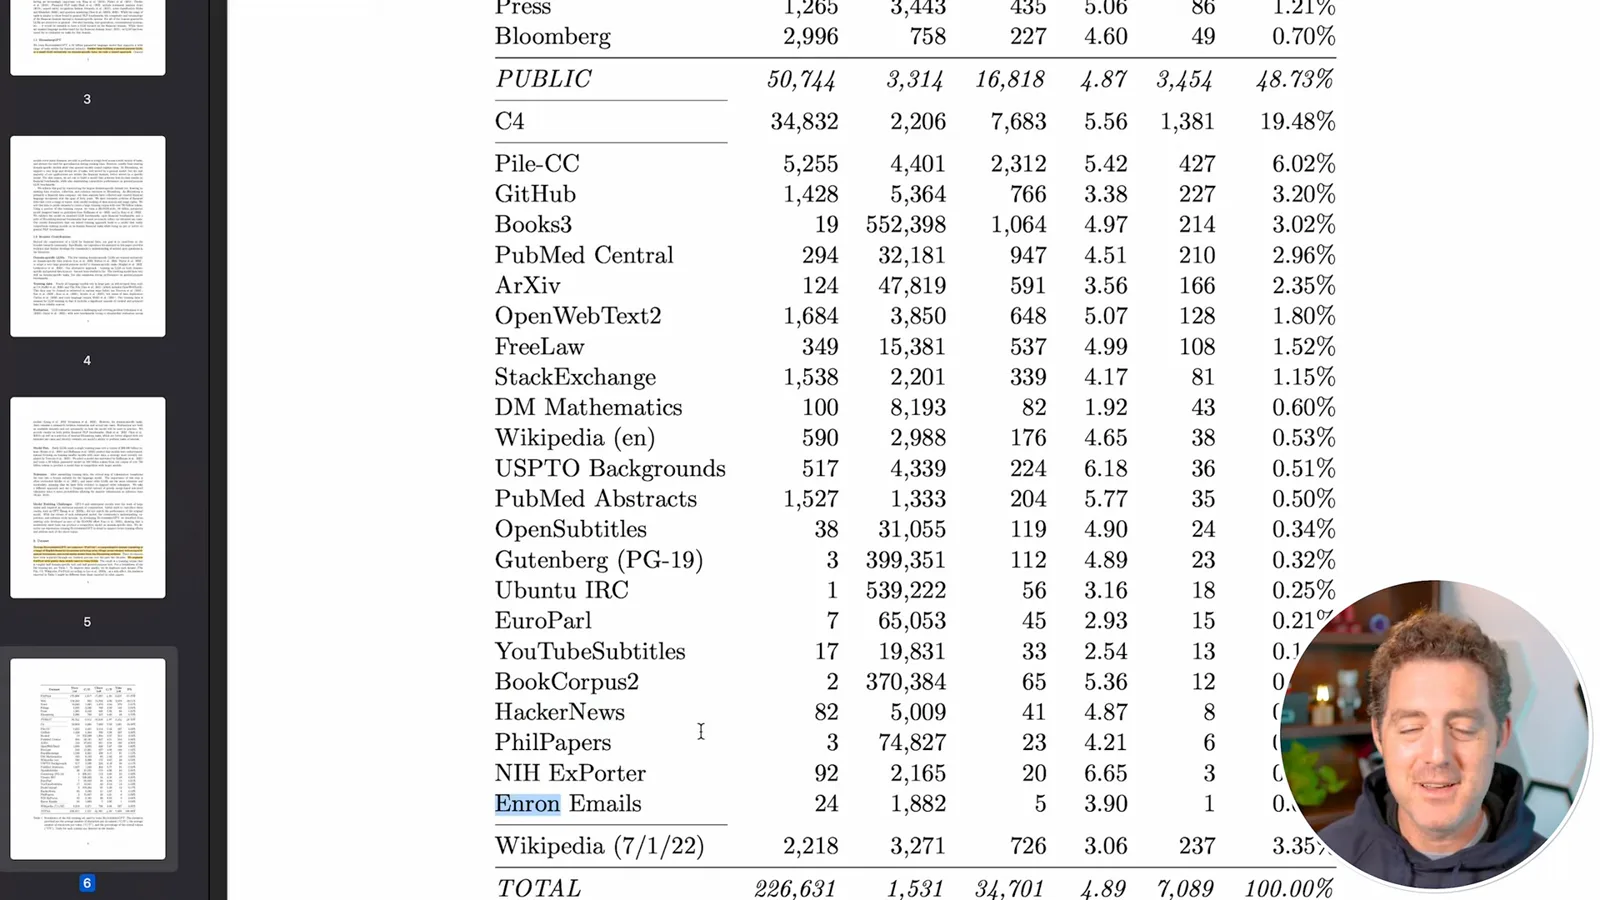
我引用论文一个标题中的数字,称金融数据占 54.2%。但其表 1 显示 FinPile 占 7,089 亿 token 语料的 51.27%,公开数据占 48.73%;论文中的两个数字不一致。表格列出金融网页文本和 C4 分别占整个语料的 42.01% 和 19.48%,而非占公开数据子集的比例。
架构、算力与评估
视频讨论 ALiBi、SageMaker 硬件和金融专项评估。作者对申报文件结果差距提出的解释仍是一种假设。
该模型使用 ALiBi 位置编码;论文称它可以应用于超过训练时 2,048 token 长度的序列。这是架构上的可能性,并不能保证任意上下文长度下都有同样可靠的表现。
训练使用 Amazon SageMaker 实例,每个实例配备八块 NVIDIA A100 40 GB GPU。我指出这类硬件价格昂贵,训练如此规模的模型需要大量资源。我对 GPU 价格的观察属于个人见闻,反映的是 2023 年的情况。
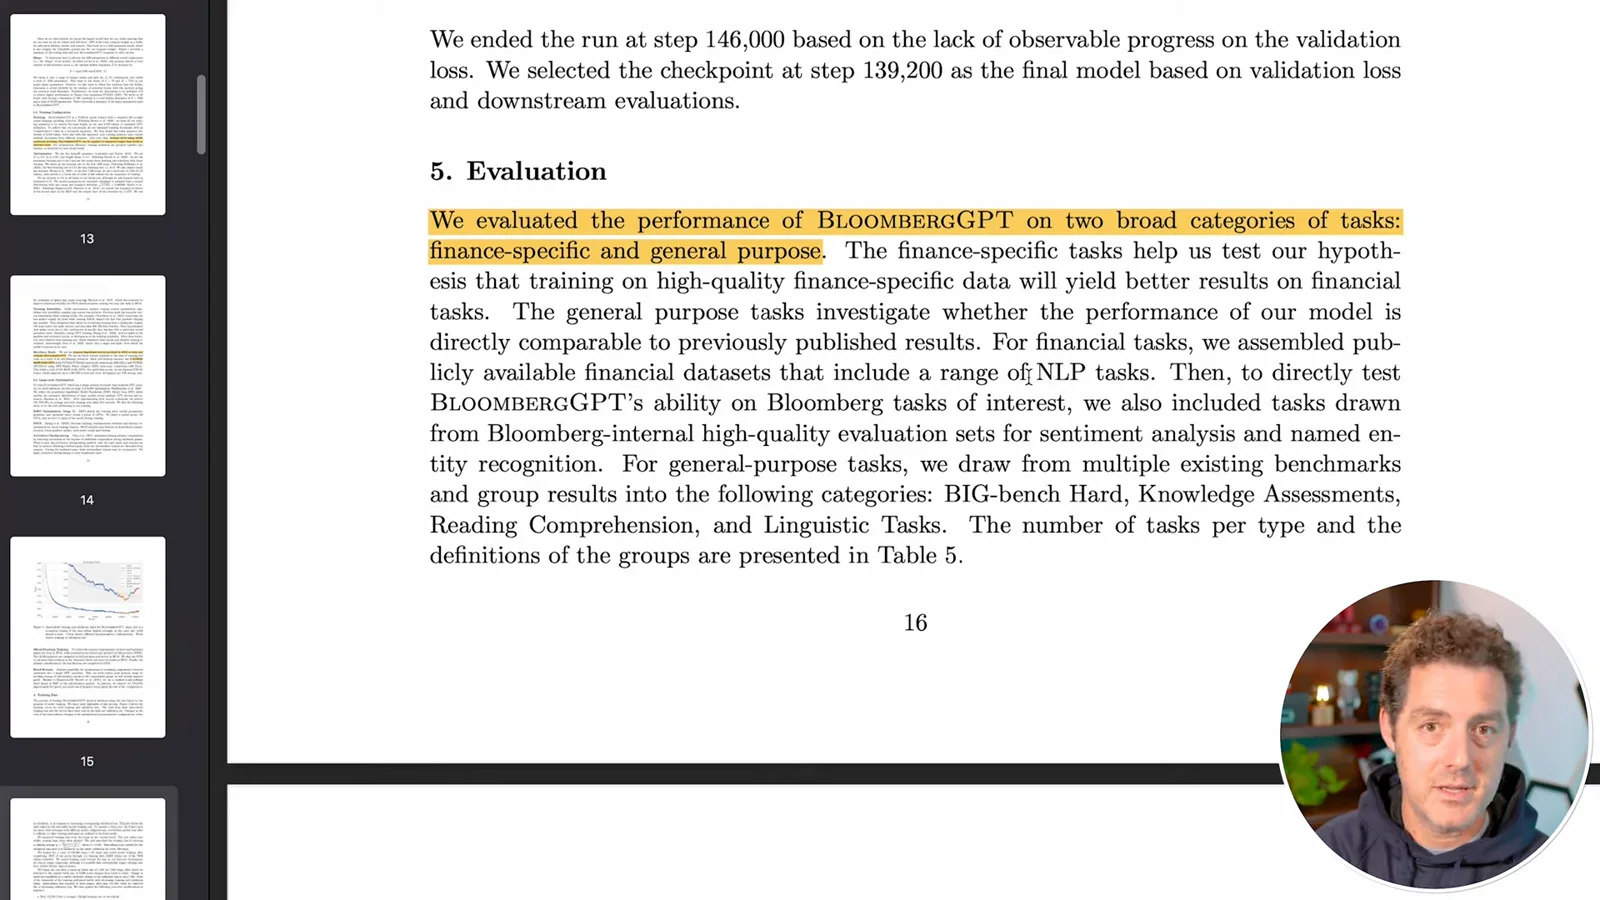
研究人员评估了金融专项任务和通用任务,将 BloombergGPT 与 GPT-NeoX、OPT 和 BLOOM 比较。在保留的 FinPile 语言建模评估中,图表使用每字节比特数作为指标,越低越好。研究人员报告 BloombergGPT 在展示的类别中表现更好;这是特定评估,并不能证明它在每项金融任务上都最好。
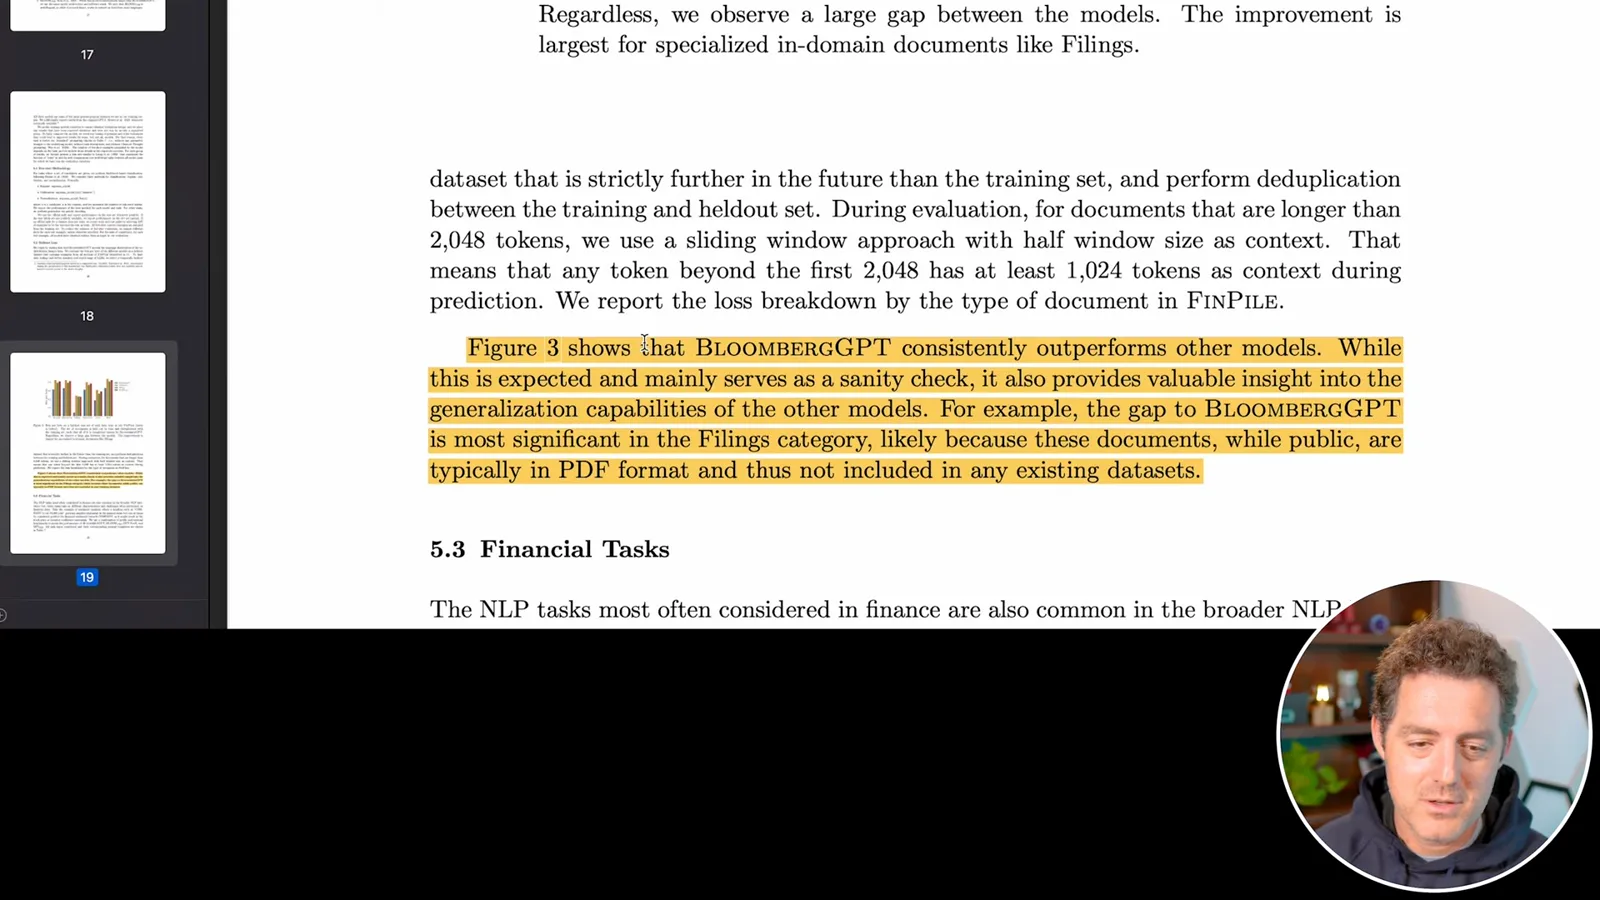
图中差距最大的是申报文件类别。作者提出一种可能的原因:公开申报文件通常为 PDF 格式,可能没有包含在现有数据集中。这是他们对观察到的差异所提出的解释,并不能证明其他模型无法解析任何 PDF。
定价猜测与开放性
Berman 推测商业价值和访问方式。论文实际上表示作者不会发布模型,并提到对数据泄露的担忧。
我以 Bloomberg Terminal 为例,思考基于宝贵金融数据训练的模型最终是否可能成为付费产品。我提出的定价和访问方式属于猜测;我说一个终端每年花费数百万美元,并非有依据的单用户价格,不应依赖这一说法。
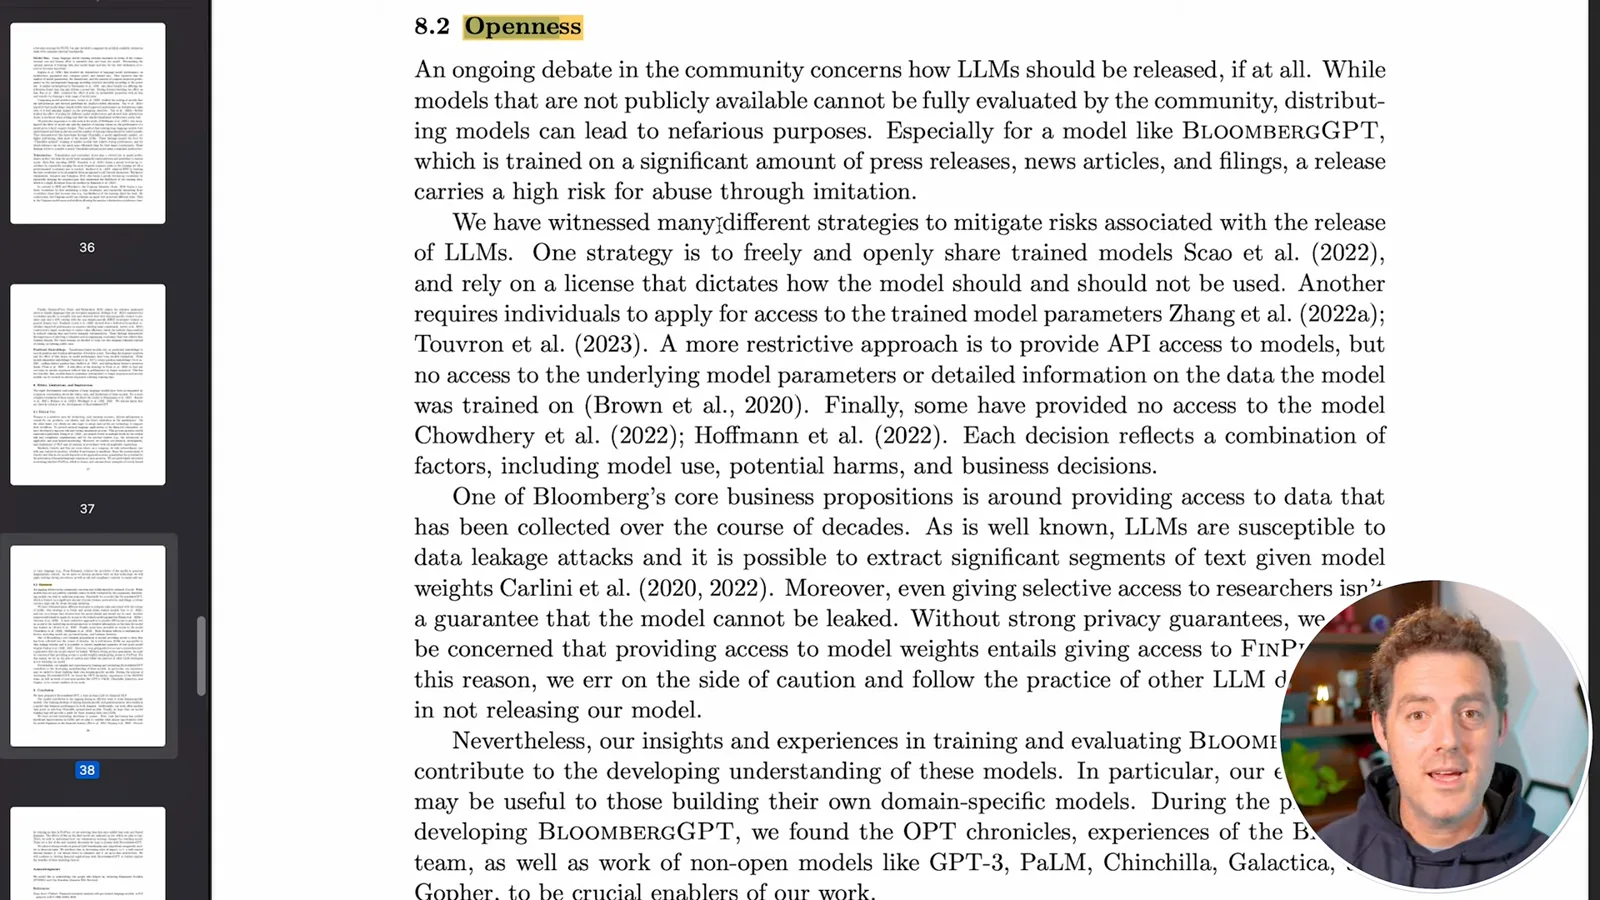
我说论文没有说明是否会发布模型,但其开放性章节实际上指出作者不会发布,并提到从模型权重提取 FinPile 数据等担忧。他们也讨论了开放评估的价值和潜在滥用。我对昂贵访问方式的预测与这一公开决定是两回事。
我通常更希望组织开放发布模型,也很高兴看到新的专业系统出现。这项研究介绍了基准结果和训练方法;它没有证明该模型是世界上最有价值的模型,也没有提供金融建议。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。