摘要
30 秒看懂
Theo Browne 质疑 Elon Musk 关于 Grok 4.7 将优于 4.6、token 效率也会更高的预测。他引用了部分基准比较和每项任务的 token 用量,但短视频没有提供足够的方法细节,无法据此得出适用于所有工作负载的性能或成本比较。
- 1发布前的预测Theo 回顾 Musk 曾声称新模型将超越当时的现有模型。
- 2效率预期他质疑 Grok 4.7 将比 4.6 更节省 token 的预测。
- 3一次特定比较他引用的数字是 4.6 x-high 每项任务约 38000 个 token,4.7 约 81000 个,但没有详细说明完整测试条件。
要点建议
- Musk 曾预测 Grok 4.7 将比 4.6 更出色,token 效率也会更高。
- Theo 表示,在他引用的部分基准和比较中,4.7 分数低于 4.6,每项任务使用的 token 更多。
- 仅比较 token 数量,不能确定所有工作负载的成本或性能。
全文
按章节阅读整理后的全文
01
Grok 4.7 的预期与结果
Theo 将发布前的预期与部分结果进行比较。他认为 token 用量数字与此前的效率预测不符。
Elon Musk 已经为 Grok 4.7 宣传了一个多月,称它将超越现有模型。在我引用的基准中,它在多项测试上的得分却低于 Grok 4.6,我觉得这很值得注意。这只是对部分基准的比较,不是说 4.7 在所有任务上都更差。
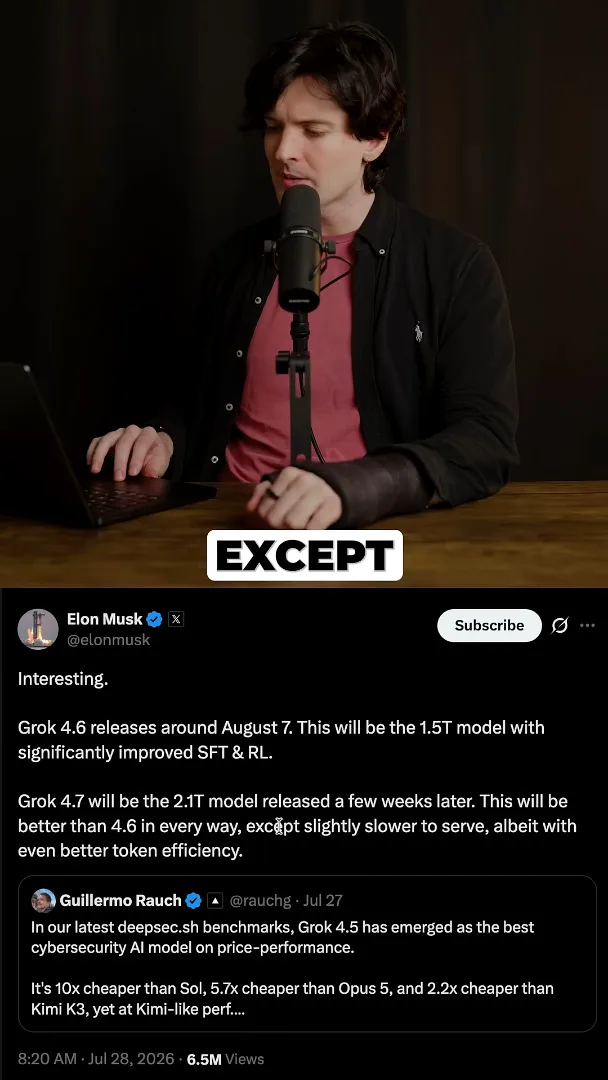
Musk 还预测,除了服务速度稍慢外,4.7 在各方面都会更好,而且 token 效率会提高。我质疑这一预测:我引用的数字是 Grok 4.6 在 x-high 档每项任务约使用 38000 个 token,4.7 约为 81000 个。我将其描述为成本约两倍,但短视频没有提供足够的价格或测试细节,无法证明普遍适用的成本倍数,也无法证明有意误导。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。