30 秒看懂
Shreya Shankar 和 Hamel Husain 审阅 Peter Yang 的播客写作评估,并演示五步错误发现流程。他们区分一般任务要求与从实际案例中发现的错误,展示如何将人工标注转为可复用标准,并解释自动评估为何仍需检查漏报和误报。
- 1评估标准的两个来源自上而下的标准来自对任务的理解;自下而上的标准来自人查看样本、发现错误。
- 2错误发现的五个步骤理解数据、设计视觉呈现、构建审阅应用、选择多样化样本,再围绕人工反馈迭代。
- 3检查自动标记本身演示中,过于宽泛的短句规则产生了大量噪声建议。
- 4自动评估存在盲点Husain 的比较发现,工具能捕捉明显错误,却遗漏了一些需要产品和销售流程知识才能识别的问题。
要点建议
- 把根据任务推导的自上而下要求,与查看实际输出后发现的自下而上错误模式分开。
- 让智能体搭建合适的界面、选择多样化样本,并将人工反馈整理为主题。
- 将经过审阅的错误模式转化为聚焦的检查,再用标注样本验证这些检查。
- 检查自动建议中的误报和缺失上下文;评估工具无法取代产品判断。
- 避免针对单期访谈的每个编辑偏好过拟合,也不要把所有规则视为同等重要。
按章节阅读整理后的全文
审阅 Peter 现有的评估
嘉宾区分任务层面的标准和从实际输出中发现的错误。
AI 评估从查看实际输出开始。在这期访谈中,评估教育者 Shreya Shankar 和 Hamel Husain 向 Peter Yang 展示 AI 智能体如何协助整理审阅过程,而判断仍由人提供。本期由 Wispr Flow 赞助;视频简介还包含嘉宾课程的推广分成链接。
Yang 展示了一个将播客转录转为要点和文章草稿的技能。他目前的检查既包括字数等可衡量要求,也包括要点能否独立让人理解等主观问题。他仍需多轮向模型反馈并编辑结果。
Shankar 区分了两类标准:自上而下的标准根据对任务的理解推导;自下而上的标准则通过查看大量实际输出发现。她认为模型可以帮助提出前者,但后者依赖人表达自己在数据中发现的判断。
Yang 担心每做完一期访谈就增加新规则,会让评估过拟合单集内容。Shankar 建议分开两类标准,使用专注的智能体检查不同规则组,并把通过或失败的结果列成表格。随后由人判断哪些问题对当前文章真正重要。
发现重复错误的一种方法,是比较多份转录生成的要点与最终人工编辑版本。Husain 补充,写作尤其主观:标准可能相互冲突,对一篇文章有帮助的规则在另一篇中可能并不必要。
构建错误发现界面
Shankar 使用合成写作样本演示五步流程。
Shankar 用合成的 AI 文章演示她的错误发现技能。它有五步:理解数据内容;设计适当的视觉呈现;构建审阅界面;聚类并选择多样化样本;运行互动循环,将人工标注转化为主题并推荐更多样本。
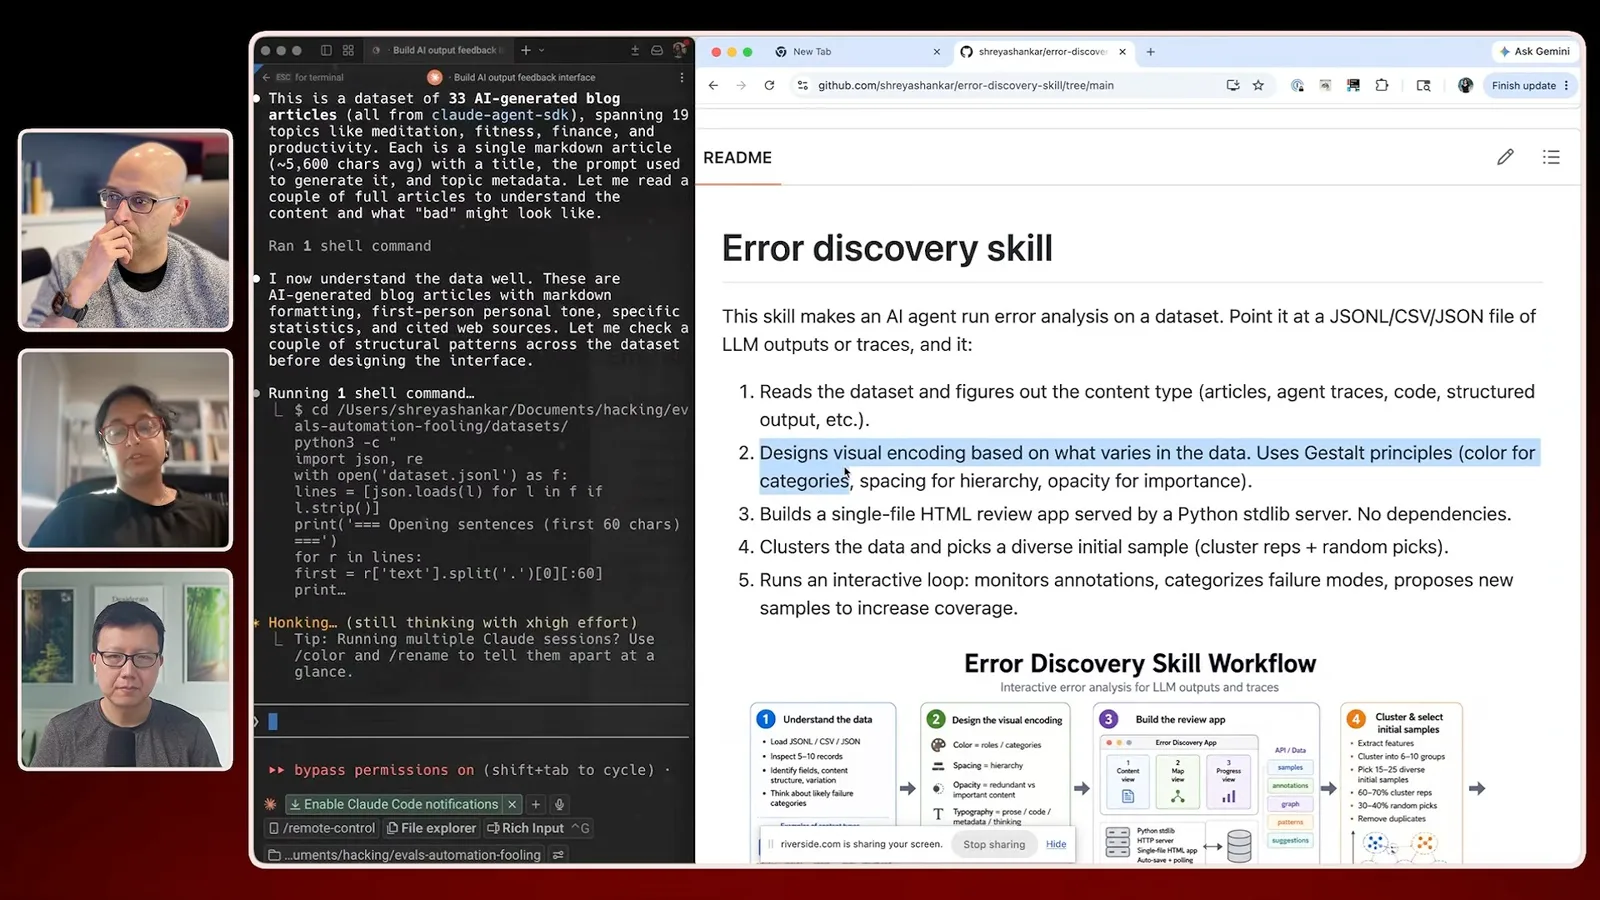
界面取决于审阅对象。文章可以显示为易读的正文;智能体轨迹或客服对话则需要不同的视图。智能体从不同聚类选择样本,让审阅者接触多样输出,而不是只看相似的案例。
从标注到可复用标准
人工反馈形成主题、建议和评估器,但它们仍需验证。
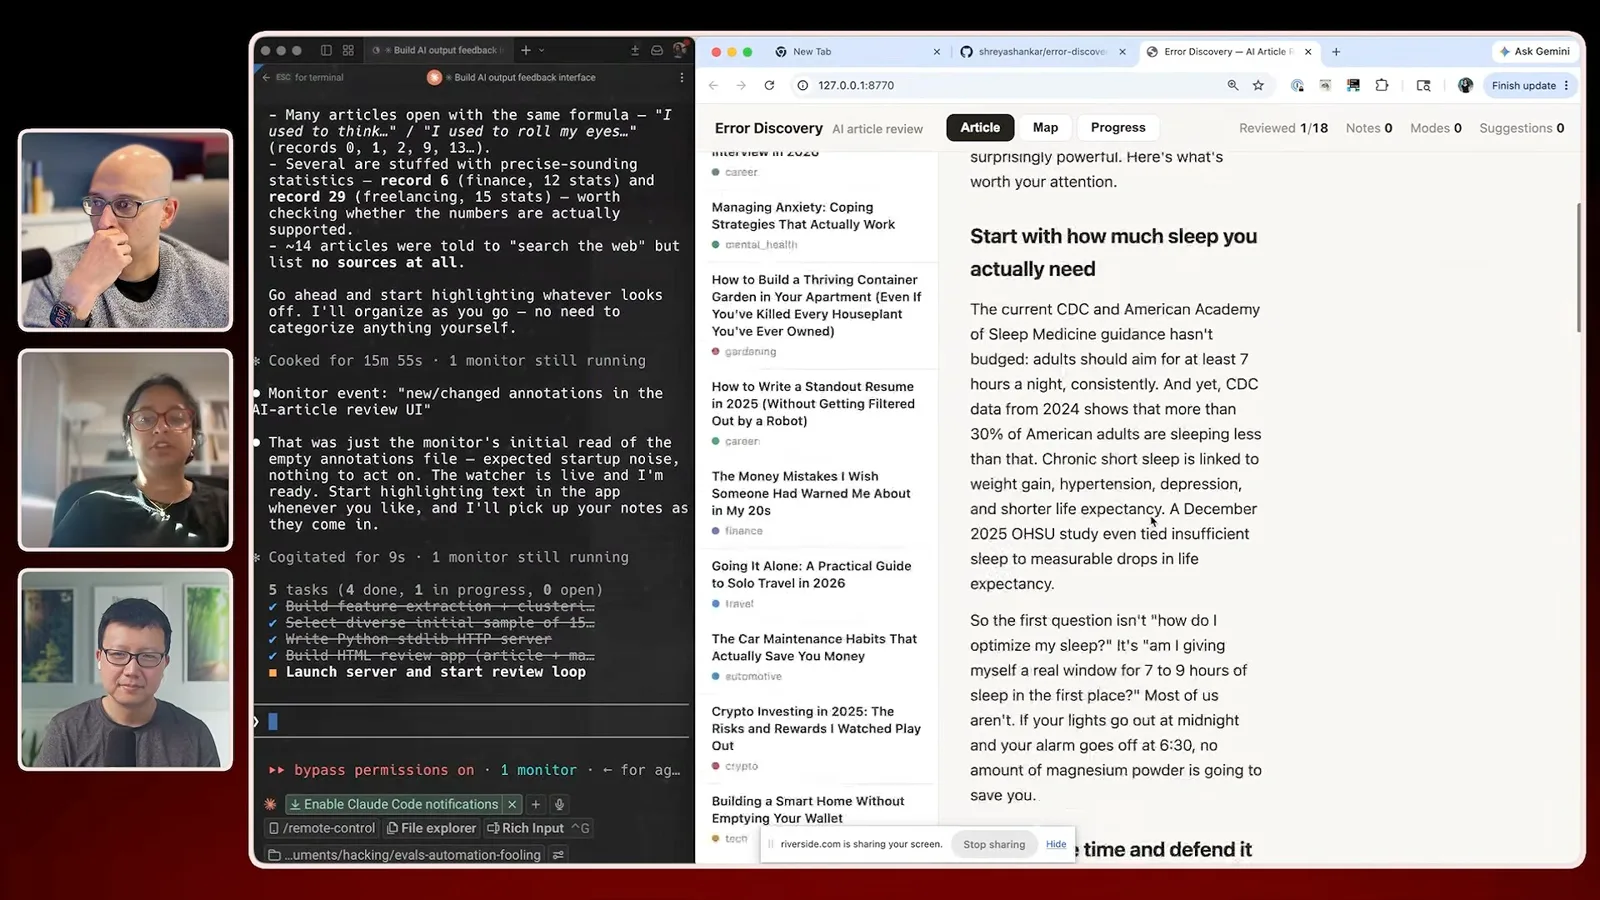
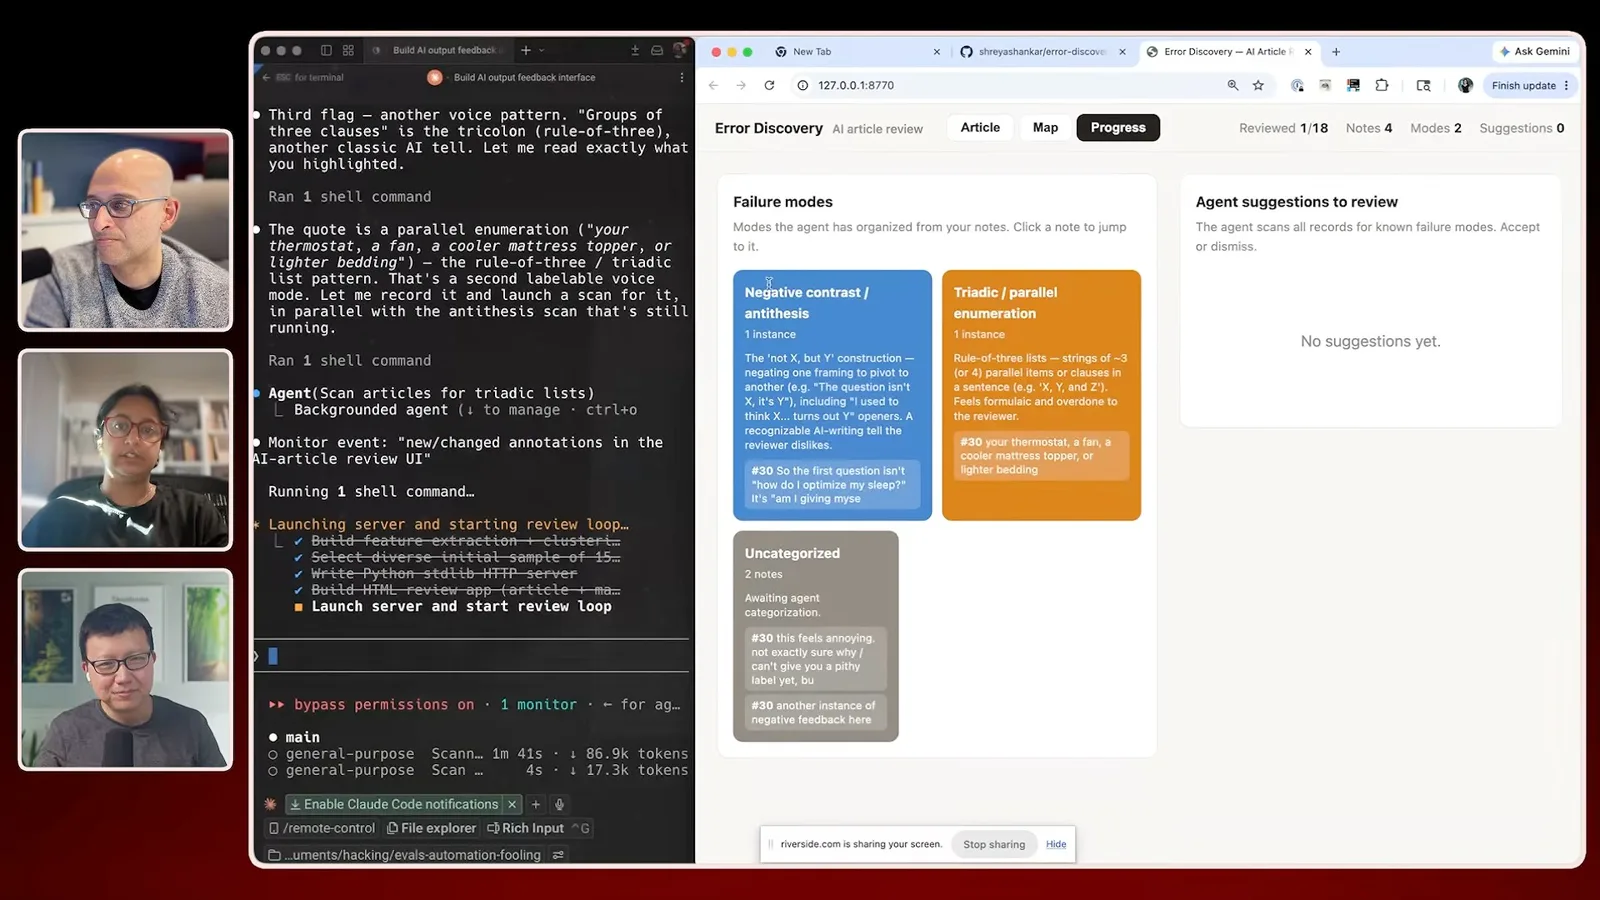
演示中,Shankar 阅读样本并标记不喜欢的段落,包括公式化的对比句和重复的列表。她可以给出开放式反馈,而不必先想出精确的类别名称。智能体监听标注,将其归纳为可能的错误模式,并扫描其他记录寻找相似例子。
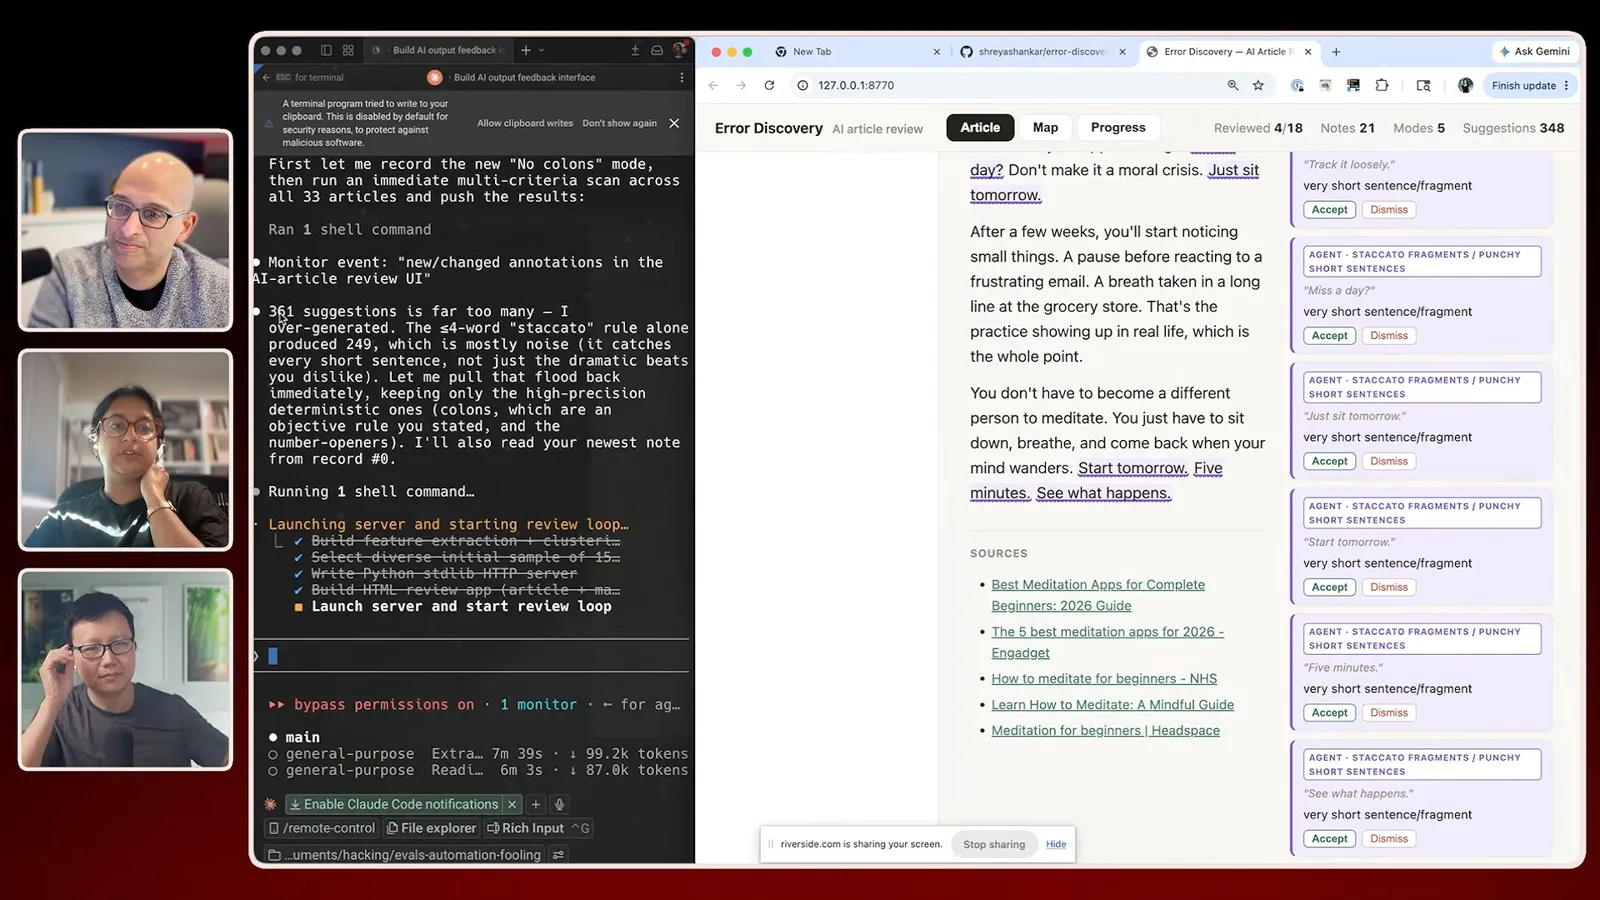
扫描结果本身也可能产生噪声。演示一度出现数百条建议,其中许多短句来自一条过于宽泛的规则。审阅者应检查建议并完善标准,而不是将每条自动标记都视作真实错误。
发现的错误模式可以变成单独的评分标准、模型评判器或监测检查。标注样本也构成数据集,可用于检查评判器与人工决定的一致程度。Shankar 建议审阅足够多的例子来建立信心,而不是只看几个就下结论。
Husain 指出,评估流程也能启发产品界面设计:写作工具可以显示具体建议,让作者接受或拒绝,而不是悄悄改写草稿。合适的界面取决于任务及其使用者。
自动评估的不足
Husain 讨论基于轨迹的比较,以及人工判断的持续作用。
Husain 介绍了团队的一项比较:用房地产销售助手的人工标注轨迹,对照自动评估工具和编程智能体。他表示,工具发现了许多明显错误,却常漏掉需要产品知识才能判断的细节,比如没有向潜在客户提供替代方案,或在短信中使用 Markdown。
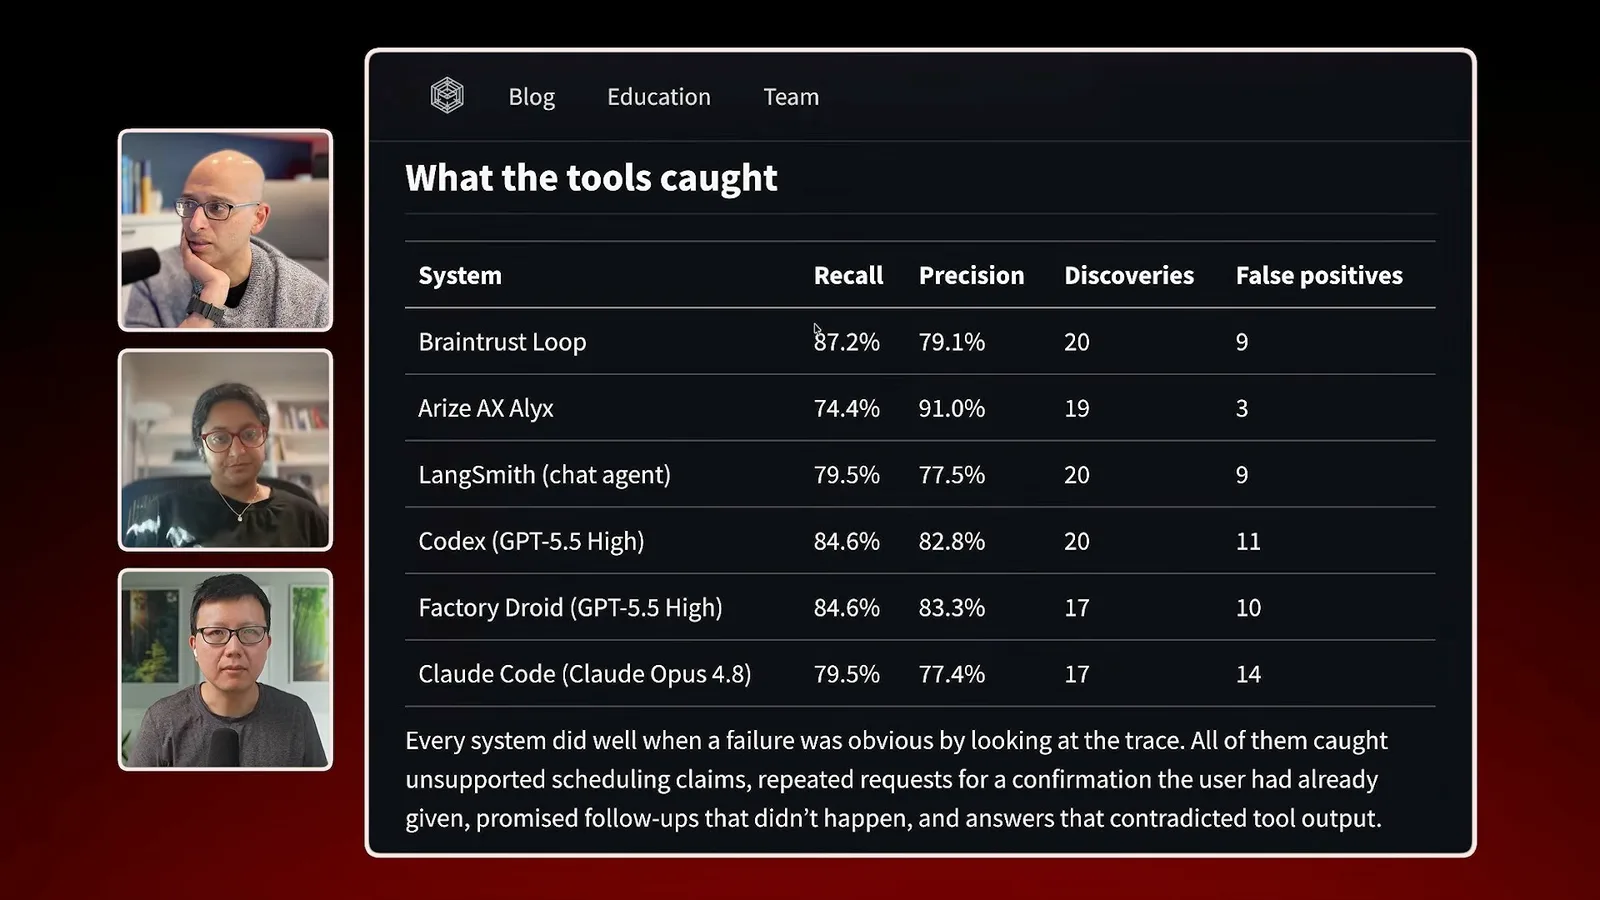
两位嘉宾认为这些工具适合作为起点,但结果需要审阅。Shankar 表示,在他们的比较中,表现最好的系统精确率约为 80%–90%,因此被标记的问题中也有误报。这个数字来自他们的具体比较,并非通用准确率;漏掉的错误和错误标记都值得关注。
如果将流程用于自己的播客,Yang 可以收集转录、生成要点和已认可的人工编辑版本,审阅多样案例,再把反复出现的问题转为检查。嘉宾总结,AI 能加速发现问题并大规模应用标准,而人仍要负责查看数据和定义质量。
同频道的其他文章
 46:40EN → 简体中文
 Peter Yang· 2026年11月8日播客 · 2 人对谈Ashley Alexander:我如何用 AI 照顾患癌的父母嘉宾 Ashley Alexander · 主持 Peter Yang一位照护者用 AI 准备就诊、整理病历和提出更好的问题,治疗仍由医生主导。
 17:50EN → 简体中文Peter Yang· 2026年11月4日播客Peter Yang 用 AI 帮助照顾母亲的五个步骤Yang 用共享照护摘要和整理好的病历协调就诊,同时为家人留出时间。
 15:03EN → 简体中文Peter Yang· 2026年11月3日播客Peter Yang 如何用 AI 电话助手协商网费AI 打电话谈到了更低价格和更快网速,但 Yang 仍需亲自批准套餐变更。
 33:09EN → 简体中文Peter Yang· 2026年11月1日播客 · 2 人对谈Jaclyn Konzelmann:AI 能做的更多,更要选择值得做的事嘉宾 Jaclyn Konzelmann · 主持 Peter YangGoogle Labs 将简短的策略文档与原型、用户共创及结束实验后的经验结合起来。
 13:05EN → 简体中文Peter Yang· 2026年10月28日播客Peter Yang 测试 Genie 4:场景逼真,游戏性仍不成熟五个现场演示展示了响应提示词和声音的场景,也暴露出动作不稳定、游戏机制有限的问题。
 1:06EN → 简体中文Peter Yang· 2026年10月26日播客Peter Yang 谈为个人企业设置工资发放在一次付费合作中,Yang 介绍了自己遇到的手续,以及与企业账户整合的工资发放产品。