30 秒看懂
Jordan Nanos 与 Kimbo Chen、Wenyao Gao 讨论 GLM 5.3 的架构和推理成本。他们解释稀疏注意力为何减轻带宽压力却不能消除缓存容量需求,分析推理测试和后训练,并区分已确认的芯片支持与尚未证实的猜测。
- 1稀疏注意力模型选择相关 token,而不是以同样方式对所有 token 进行注意力计算。
- 2带宽与容量稀疏注意力降低带宽压力,但仍需保留上下文。
- 3推理测试随着推理软件成熟,AMD 测试结果有所改善,结果取决于测试配置。
- 4后训练嘉宾介绍了注重稳定性的初始训练,以及长 agent 轨迹带来的后续权衡。
- 5硬件猜测数值相似不足以证明 GLM 针对某款中国芯片进行了优化。
要点建议
- 稀疏注意力选择相关 token,但仍需在内存中保留上下文。
- 缓存卸载用主机内存和潜在延迟换取 GPU 内存空间。
- 随着软件优化,AMD 的推理测试结果有所改善;比较结果取决于具体配置。
- 嘉宾认为后训练带来了 GLM 5.3 的显著提升,但详细实现信息仍不完整。
- 针对某款中国芯片进行优化是 Chen 未经证实的猜测。
按章节阅读整理后的全文
稀疏注意力
嘉宾介绍 GLM 5.3,并比较稀疏注意力和其他方法。他们解释长上下文为何给推理系统带来压力。
Jordan Nanos 邀请 SemiAnalysis 的 Kimbo Chen 和 Wenyao Gao 讨论 GLM 5.3,话题包括稀疏注意力、推理基准测试、后训练、网络安全和硬件支持。
Chen 解释说,稀疏注意力保留核心注意力运算,同时选择一部分相关 token。线性注意力则通过改变基础算法采取不同路径。两者都旨在让长上下文更易处理。
从 GLM 5 开始,Z.ai 使用 DeepSeek Sparse Attention,通过 lightning indexer 选择 token,再使用基于多头潜在注意力的稀疏注意力。其他实验室也继续尝试不同的注意力设计。
Chen 说,DeepSeek 后来的压缩稀疏注意力和高度压缩注意力在这些思路上增加了压缩机制。Nanos 指出高效处理长序列可以降低服务成本,同时提到人们对硬件限制是否促使中国实验室更重视效率的讨论。
缓存与内存
HiCache 和 HiSparse 在不同内存层之间移动数据。带宽与容量仍是不同的约束。
Gao 描述了一种推理服务场景:许多用户同时使用模型,每个人都可能携带很长的上下文。GPU 内存有限,增加并发需要更多空间存放推理过程中使用的缓存信息。
HiCache 可以复用前缀缓存,并将数据从 GPU 的高带宽内存卸载到主机 DRAM。Gao 说,并发增加会改变主机内存的使用量,而每颗芯片的内存差异也会影响结果。
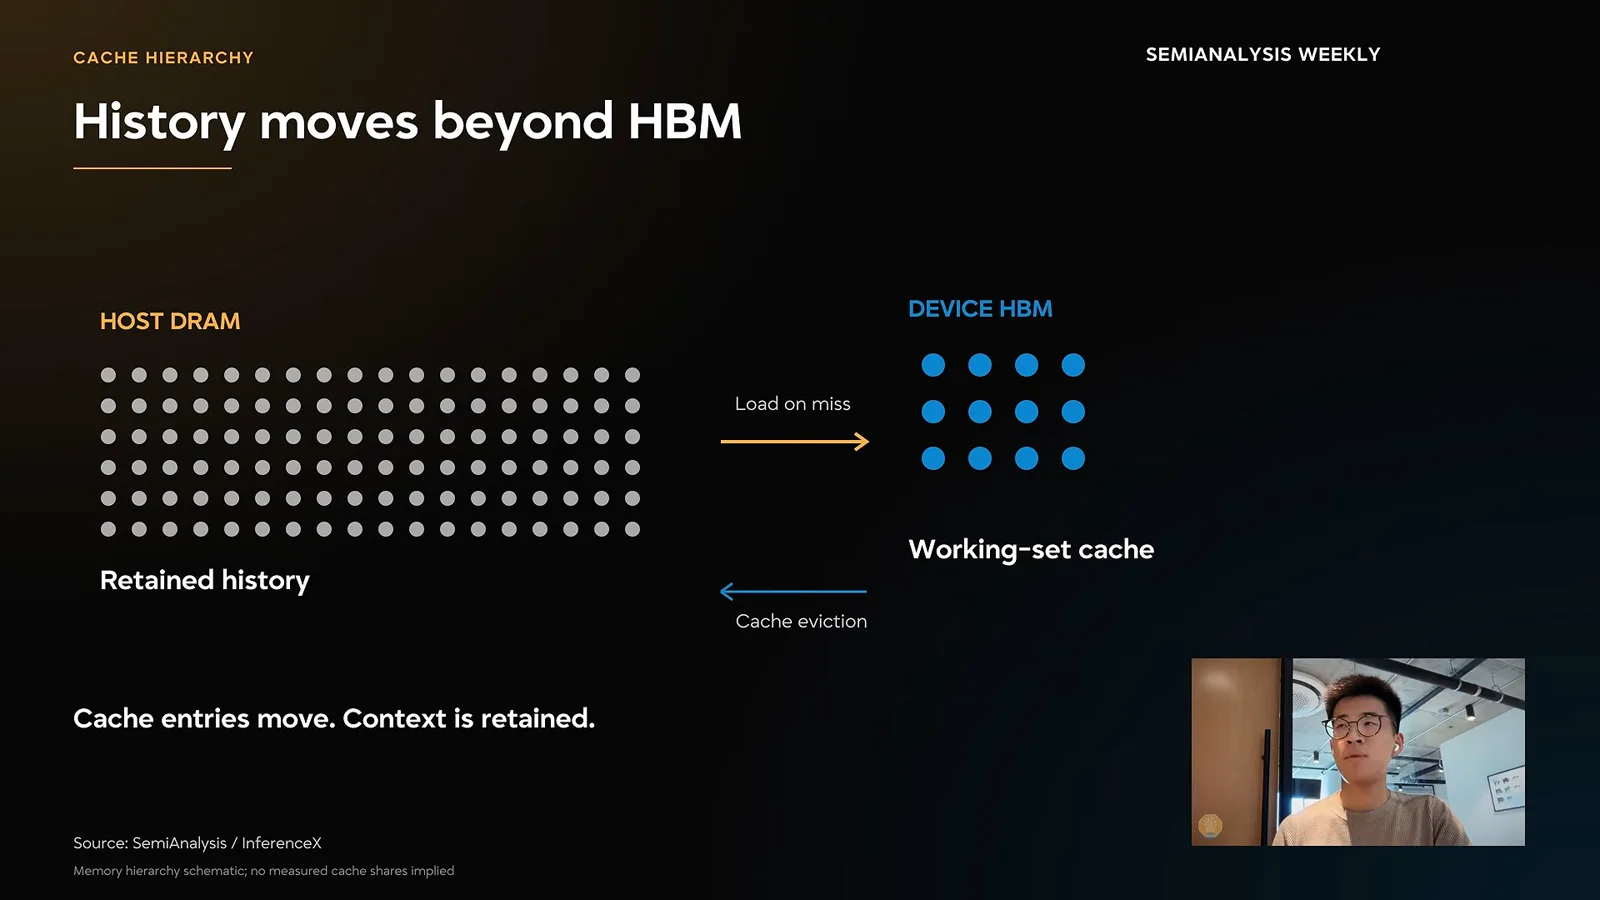
Chen 将 HiSparse 描述为 HiCache 在稀疏注意力场景下的对应方案。它把缓存数据移到容量更大、带宽更低的内存层,再在计算时取回相关部分。
他强调一个区别:稀疏注意力减少单次注意力运算读取的数据量,有助于缓解带宽压力,但本身不能消除保留完整上下文的需求。由于仍需从 token 中做选择,缓存容量依然重要。
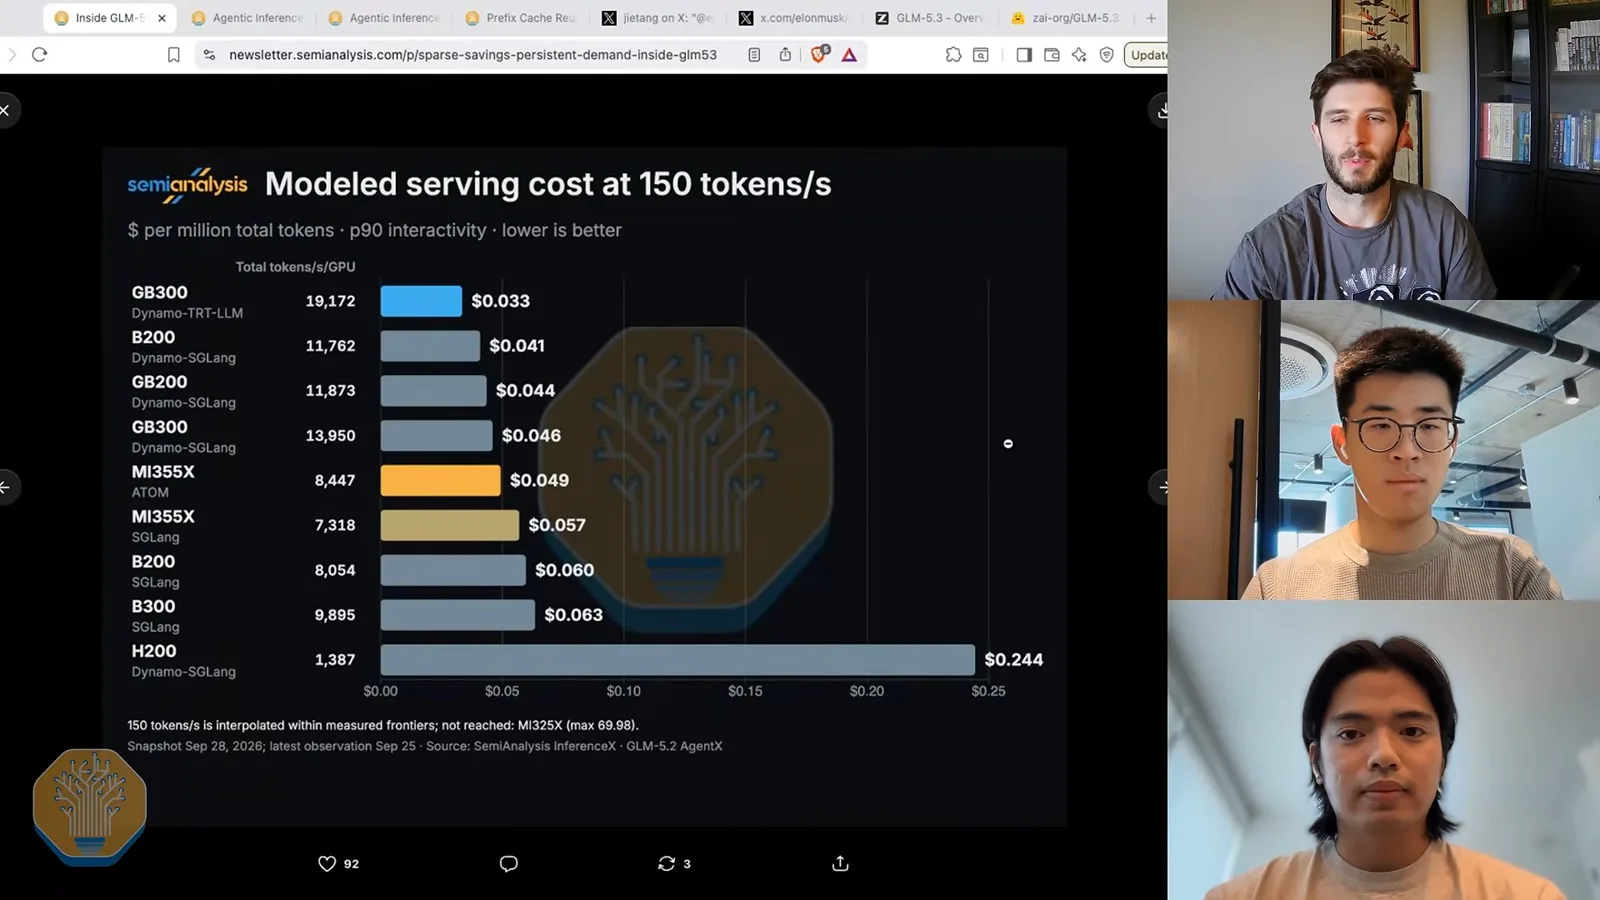
Nanos 指着基准测试中的每美元建模吞吐量。Gao 说,不能把模型计算效率高等同于消除内存需求;HBM 与 DRAM 之间的卸载仍是重要的服务技术。
推理基准测试
嘉宾比较随时间变化的测试结果,讨论 AMD 软件的改进。不同配置会带来不同的成本和延迟权衡。
Gao 说,NVIDIA 的测试配置最初领先,但后来 AMD 在每位用户约每秒 150 token 的速度下,成本接近 NVIDIA B200 配置。比较结果取决于具体基准、软件和硬件配置。
InferenceX 仪表盘可以回看模型 8 月初发布以来的性能变化。Nanos 指出,AMD MI355 的结果显著改善,在约每秒 100 token 的交互速度下也有较好表现。
Gao 将部分进步归因于 AMD 持续优化 ATOM 推理引擎。给定芯片的硬件能力是固定的,但软件可以不断优化,从而改变实际成本和吞吐量。
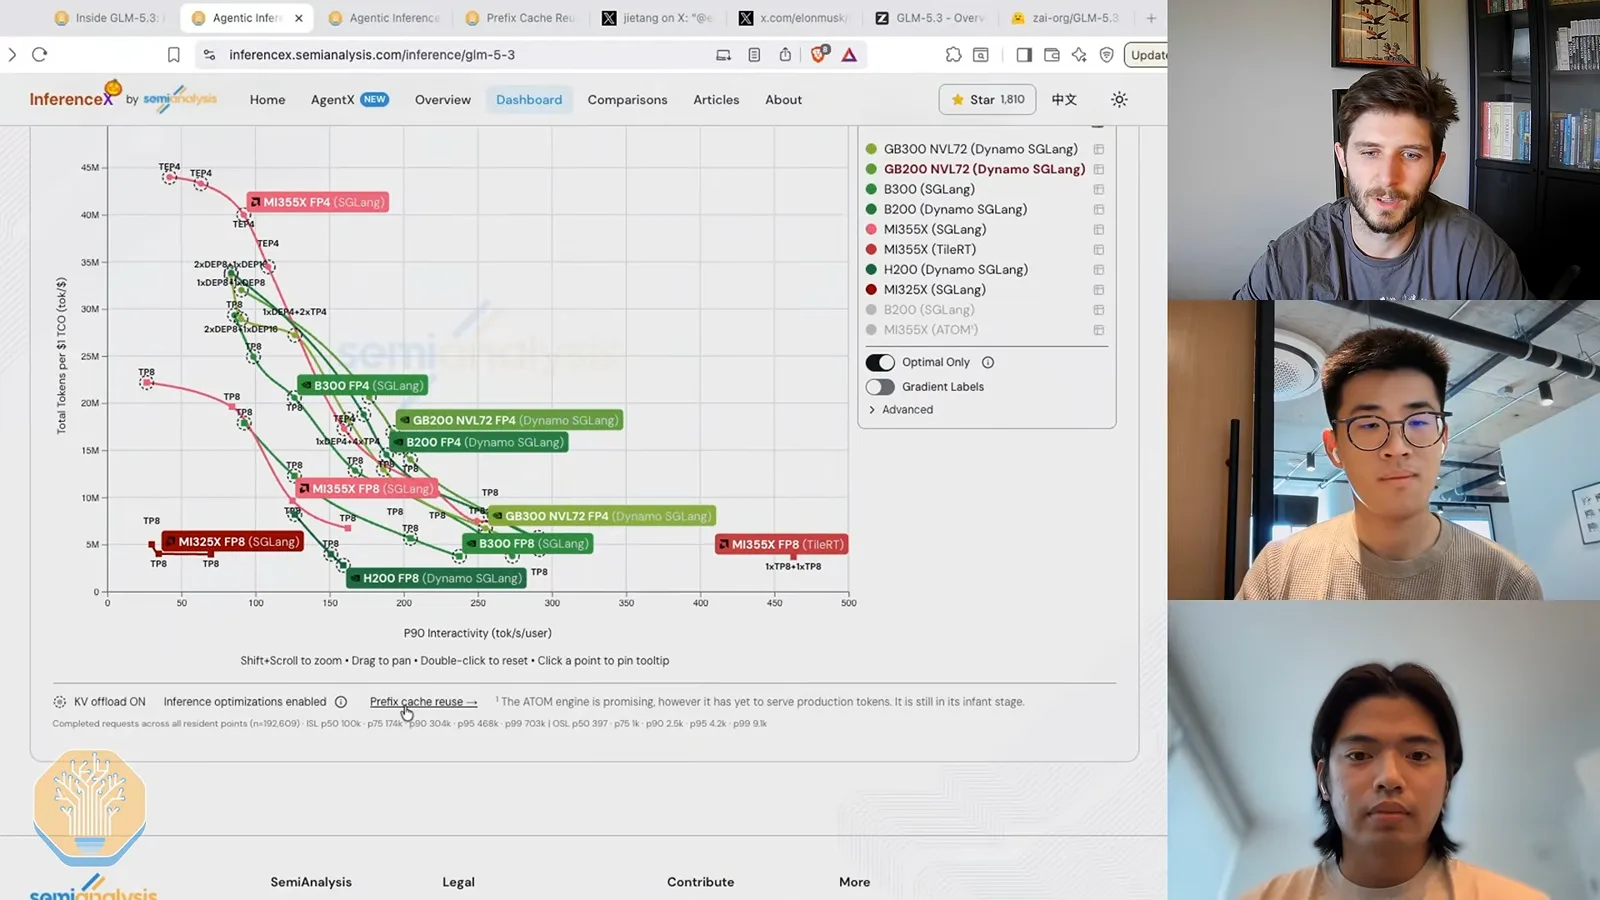
Nanos 询问主机 DRAM、GPU 内存容量和带宽之间的关系。他指出,一些投资者曾担心高效模型会减少内存需求;但更高效的推理也可能支持更多并发用户,使内存需求持续增长。
延迟与带宽
卸载有助于提高并发,但可能增加延迟。低延迟引擎展示了另一种优化目标。
Gao 说,卸载可以支持更多用户,提高总输出,但也会增加延迟,尤其是长尾延迟。如何平衡取决于工作负载和用户愿意支付的价格。
作为另一种取舍,Gao 介绍了 TileRT 的解码 mega-kernel:它减少内核启动开销,在小批量场景下达到每秒最多 470 token。这种低延迟表现的代价是难以服务大型批次。
两位嘉宾都表示自己通常不使用超高速编程模式:Gao 觉得价格太高,对普通 agent 任务也不太能感受到差别。她认为,对响应时间敏感的交易公司可能会作出不同选择。
Chen 认为,在超低延迟场景中带宽尤其重要:计算量相对较少时,性能受限于模型权重和相关数据能够以多快的速度载入。
容量仍然重要,但缓存层级以及让计算与数据传输重叠,可以帮助管理容量限制。Chen 将节目中讨论的 Rubin 内存权衡理解为:保留带宽,同时借助网络连接和其他方法解决容量问题。
架构与能力
嘉宾讨论 GLM 5.3 Flash 和模型表现。Nanos 分享他在安全工作中的个人体验。
被问及 Z.ai 是否会保留注意力架构时,Chen 猜测 GLM 5 系列可能继续采用现有设计,而未来模型可能探索其他方案。他以结合 Kimi Delta Attention 和 DeepSeek Sparse Attention 的 GLM 5.3 Flash 为例。
话题转向模型能力和后训练。Nanos 说,在其他模型拒绝某些经授权的网络安全工作时,他会使用 GLM 5.3 作为替代,并认为它擅长编程和安全任务。这是他的个人体验,并非普遍基准结果。
嘉宾讨论它与领先闭源模型的比较。Chen 提醒说,GLM 5.3 并不等同于他们提到的最高水平模型,但考虑到提升来自后训练,他认为这一进步仍然值得注意。
后训练与基础设施
嘉宾讨论强化学习、异步优化和 Slime 框架,也强调公开细节的局限。
Chen 说,Z.ai 专注通过后训练改进 GLM 5 架构,其他实验室则更频繁地改变架构。他将 GRPO 等常见强化学习方法列为整体方案的一部分。
他说,初始的同步 GRPO 阶段侧重训练稳定性。更长的 agent 轨迹可能稀释奖励信号,因此后续阶段会在算法和系统上作出不同权衡,包括如何处理生成数据所用策略的陈旧性。
Nanos 问这些技术是否根本上独一无二。Chen 说,迄今讨论的大部分内容并非 Z.ai 独有。Gao 强调,仅通过后训练就能提高基准成绩,说明团队不从头预训练也有改进空间。
嘉宾认为 GLM 5.2 到 5.3 的提升十分显著,包括他们讨论的安全任务。Chen 提醒说,Z.ai 自 GLM 5 后没有发布详细技术报告,因此部分细节来自公开声明和与研究人员的交流。
Chen 特别提到单次 rollout 异步优化,即 SAO。他称该方法使用一个与主模型配合的 critic 来评估 rollout。他还将开源后训练框架 Slime 视为重要的基础设施贡献。
Nanos 认为,高效的基础设施本身就是优势:在相同算力预算下,团队可能运行更多实验或任务。Chen 表示赞同,并说 Z.ai 曾讨论利用模型帮助提高系统效率。
例子包括在不同硬件上调通和验证内核,以及监控系统级工作负载。Chen 认为,算法工作和开源基础设施都可能帮助加快研究与训练。
中国硬件
嘉宾讨论模型作者关于支持中国芯片的声明。Chen 明确表示,他对特定硬件目标的判断尚未证实。
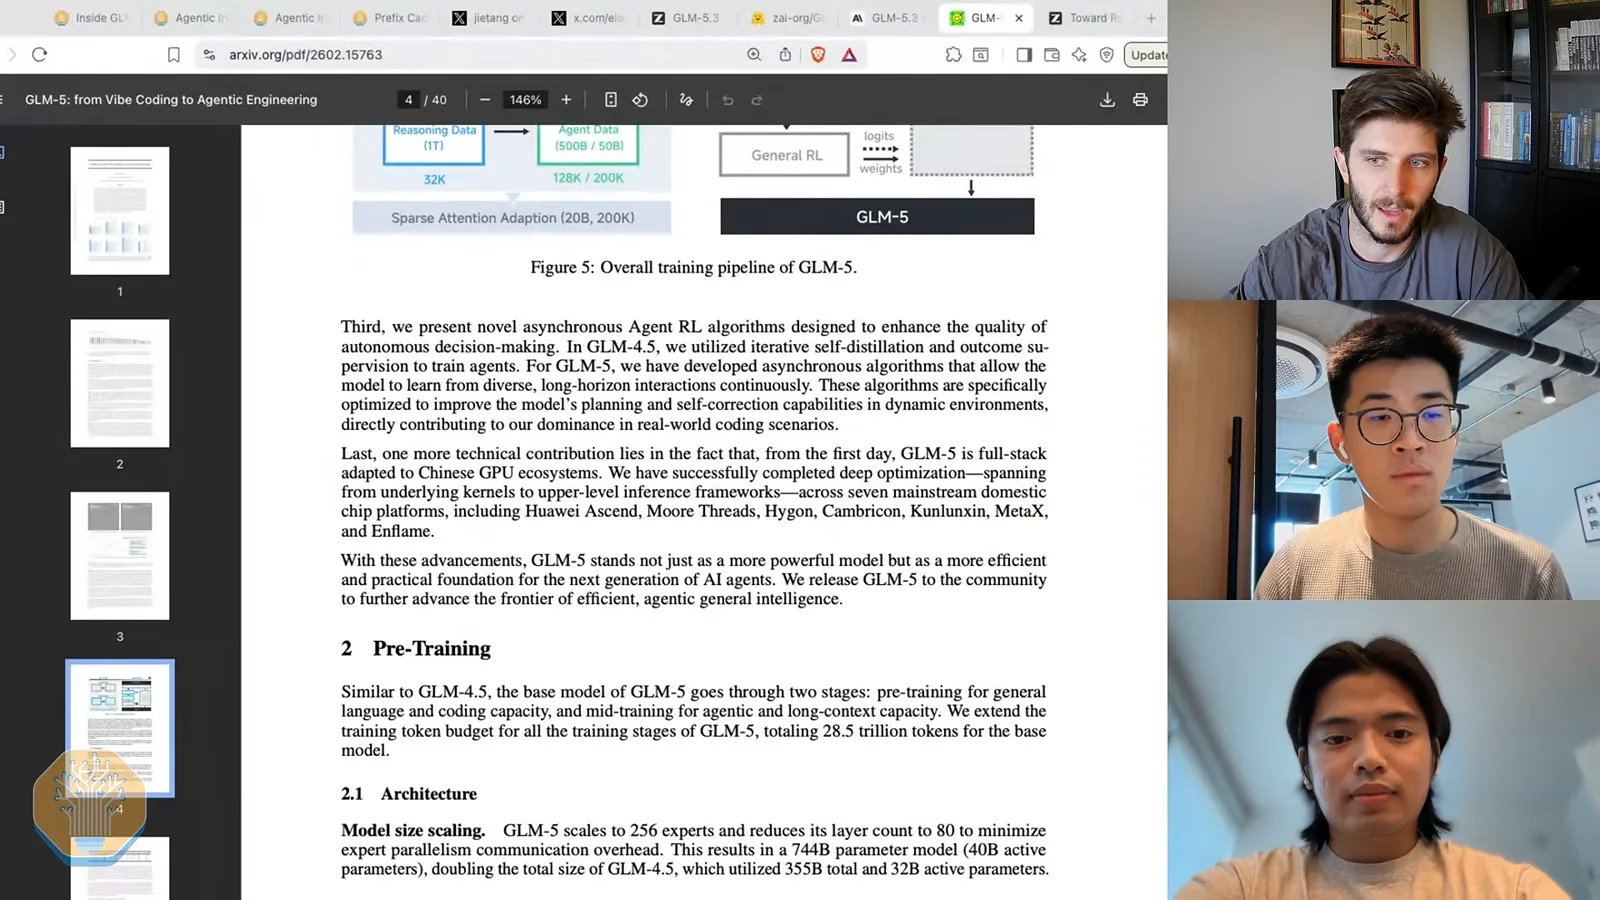
Nanos 引述 GLM 5 论文:作者表示,他们针对七种中国芯片平台适配了软件栈,包括 Huawei Ascend、Moore Threads、Hygon、Cambricon、Kunlunxin、MetaX 和 Enflame。
Chen 说,Z.ai 还公开宣称,以 aux alpha 名称提供的 GLM 5.3 Flash 使用中国硬件提供服务。他认为这表明团队完成了内核和服务系统方面的工作,同时承认这一判断依赖公司的说法。
GLM 5.3 Flash 的发布时间让 Chen 猜测其研发周期很短。他明确表示自己不知道项目确切何时开始,因此提出的时间范围只是估计。
Chen 描述了软硬件协同设计的一种可能:根据目标硬件的算术特性选择注意力配置。他以 DeepSeek 针对 H800 的设计作为比较。
他粗略计算 GLM 5 的算术强度约为 120,认为与 Moore Threads 硬件相近。他明确表示,这并不能证明模型针对该硬件优化或在其上提供服务;他没有得到确认。
Gao 说,更好的模型和合适的工具可以缩短研发周期,GPU 内核开发就是一例。嘉宾好奇 AI 在近期高性能内核的开发中贡献了多少,但并不知道答案。
接下来会怎样
嘉宾讨论未来的模型架构、更小的高效模型和人工数据工作的作用,最后谈到可能的内存需求。
展望未来,Chen 猜测 GLM 5.3 Flash 的混合注意力架构可以进一步扩大规模。Gao 预计模型能力和推理效率都会继续改善,尤其对重视服务成本的机构而言。
Gao 提到有公司针对专业应用调整开放模型。她想观察后训练能否在固定模型规模下提升实用能力,也期待未来的 GLM 版本。
Chen 补充说,人工投入和数据质量是后训练中很重要、却没有得到充分解释的部分。他猜测数据标注发挥了作用,但承认数据背后的具体工作并未公开。
Gao 还关注更小、更高效的模型:它们可能以低成本很好地完成特定任务。Nanos 最后表达团队的看法:效率提升可能鼓励更多 token 使用,并维持对内存和带宽的需求。
同频道的其他文章
 55:06EN → 简体中文
 SemiAnalysis· 2026年10月27日播客 · 4 人对谈Anthropic 的 S-1:收入、算力成本与规模竞赛SemiAnalysis 嘉宾解读 Anthropic 的申报文件,讨论算力经济性、客户集中度与竞争。
 34:35EN → 简体中文SemiAnalysis· 2026年10月23日播客 · 3 人对谈SemiAnalysis 谈 ASML 的 hybrid bonding 专利、HBM 经济账和下一代设备生态嘉宾 Sherry Zhang, Howie · 主持 Jordan NanosJordan Nanos、Sherry Zhang 和 Howie 审视一种轨道式键合设计:把晶圆送到芯片处,并说明这项技术能否落地,取决于精度、洁净度、经济账,以及一条正在变化的供应链。
 34:47EN → 简体中文SemiAnalysis· 2026年10月20日播客 · 3 人对谈SemiAnalysis 为何上调 2027 年数据中心预测嘉宾 Jeremie Ontiveros, Reyk Knuhtsen · 主持 Jordan NanosJeremie Ontiveros 和 Reyk Knuhtsen 解释他们的项目级模型、建设风险,以及未来可能出现的供需失衡。
 1:23:18EN → 简体中文SemiAnalysis· 2026年10月9日播客 · 2 人对谈谁来为 AI 基础设施建设融资?嘉宾 Daniel Nishball · 主持 Jordan NanosSemiAnalysis 分析预计的资金需求、GPU 租赁经济性,以及支持数据中心融资的担保。
 50:13EN → 简体中文SemiAnalysis· 2026年10月7日播客 · 3 人对谈SemiAnalysis 如何比较 AI 订阅额度嘉宾 Max Kan, Andrew Megalaa · 主持 Jordan Nanos从 token 计费、缓存密集型工作负载出发,理解按 API 价格折算订阅价值所依赖的假设。