30 秒看懂
Matthew Berman 演示如何安装 Text Generation WebUI,并在本地 GPU 上加载量化的 WizardCoder-Python 13B 模型。他展示依赖安装、故障排除、模型下载、加载器设置和一个基础 Python 提示。教程反映的是当时的软件版本;兼容性和安装步骤可能已经变化。
- 1本地编程模型Berman 选择基于 Code Llama 微调的 WizardCoder,并使用 Text Generation WebUI 作为界面。
- 2环境与依赖他创建 Python 3.10.9 conda 环境,克隆界面仓库并安装依赖与 PyTorch。
- 3下载与加载他下载约 7 GB 的量化 13B 模型,并选择 ExLlama_HF 加载器。
- 4小规模测试本地模型生成了两个可运行的示例,用于打印 1 到 100;这并非全面评估。
要点建议
- 演示在 PC 上使用 Text Generation WebUI 运行量化的 WizardCoder-Python 13B 模型。
- 量化可减少模型存储和内存需求,但可能影响质量,速度取决于硬件和加载器。
- Berman 使用 Python 环境、安装依赖,并在该配置中选择 ExLlama_HF 加载器。
- 模型在一个简单提示和某项基准比较中的表现,不能证明这个 13B 配置在整体上优于 GPT-4。
按章节阅读整理后的全文
选择模型和界面
Berman 介绍使用 Text Generation WebUI 在本地运行 WizardCoder 的配置。他与 GPT-4 的广泛比较需要结合基准及模型版本理解。
我要从头开始在自己的 PC 上安装一个本地编程模型。我会使用 Text Generation WebUI 和基于 Code Llama 微调的 WizardCoder。我根据先前比较说该模型击败 GPT-4,但这不应被解读为对所有编程任务或这里使用的特定 13B 模型的普遍结论:基准结果取决于模型版本和测试条件。
首先,我安装 Anaconda 来管理 Python 环境,并打开 Text Generation WebUI 仓库。我复制仓库地址,创建使用 Python 3.10.9 的 conda 环境并激活,然后克隆仓库并进入目录。这些是 2023 年视频中展示的步骤;目前的项目说明可能不同。
安装与故障排除
他创建环境、克隆仓库并安装依赖,还处理自己配置中缺失的包和 CUDA 问题。
我安装仓库依赖,并展示 PyTorch 安装命令。我还提到 CUDA 不可用的错误,以及适用于该配置的 PyTorch 和 CUDA 包。当我的安装报告缺少 chardet 和 cchardet 模块时,我安装它们并用 Python 启动服务器。
加载并测试模型
他下载量化 13B 模型并配置加载器和生成参数。一条简单的 Python 提示生成了可运行的示例。
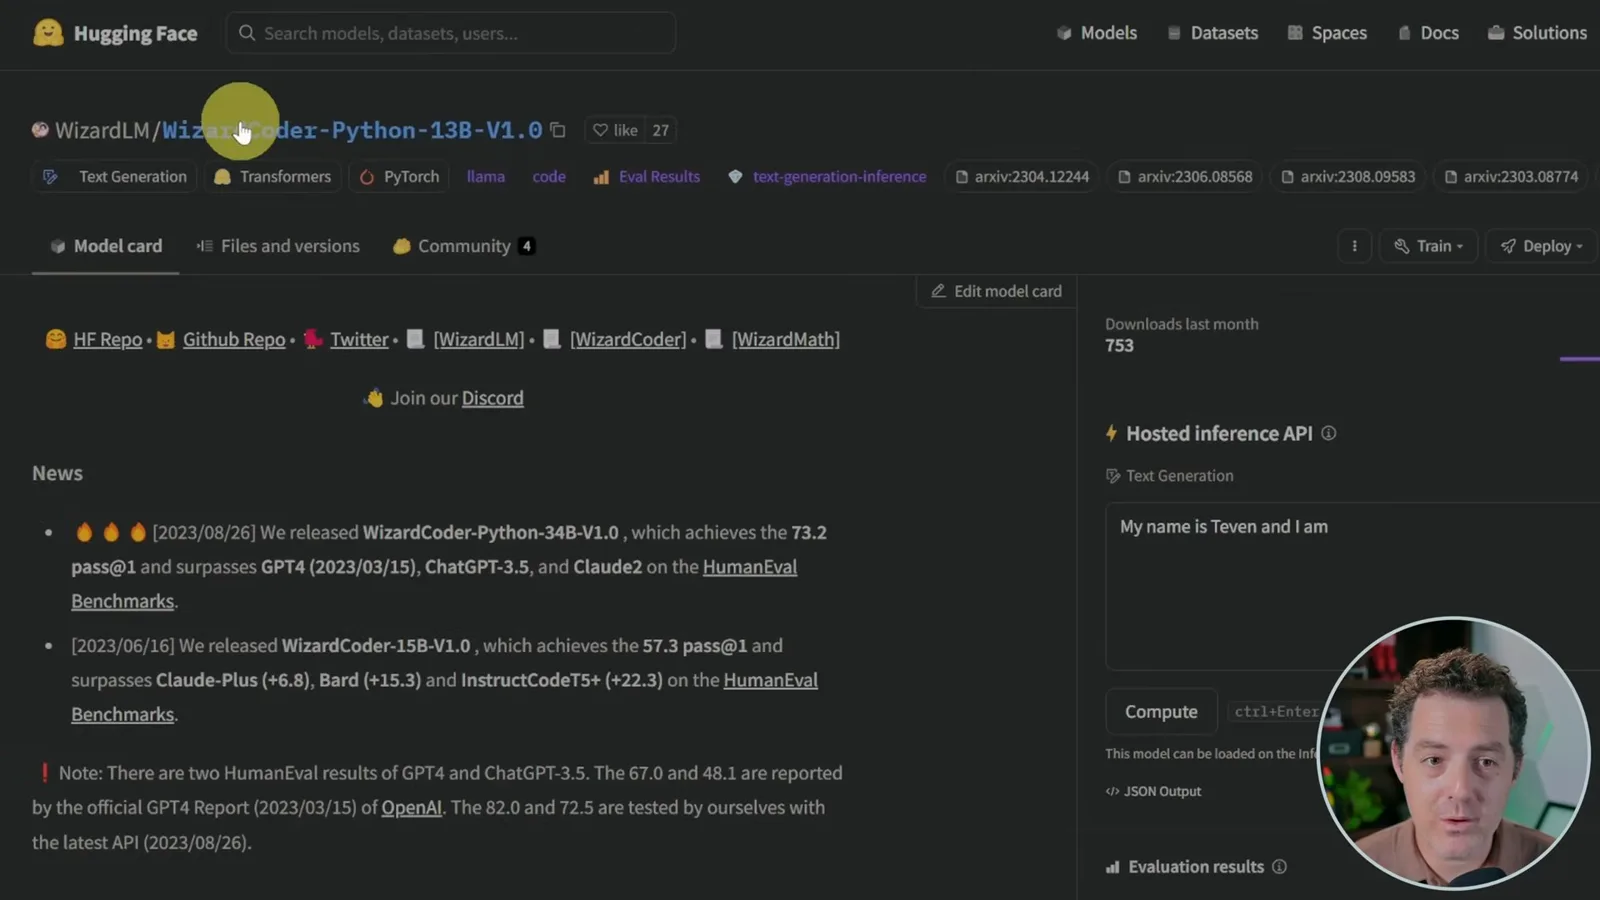
在网页界面的 Model 标签页中,我在 Hugging Face 上查找 WizardCoder-Python 13B。我选择较小的模型,虽然我有 24 GB GPU 内存,也认为自己可能运行 34B 模型。不同模型尺寸和量化格式对硬件的要求不同。
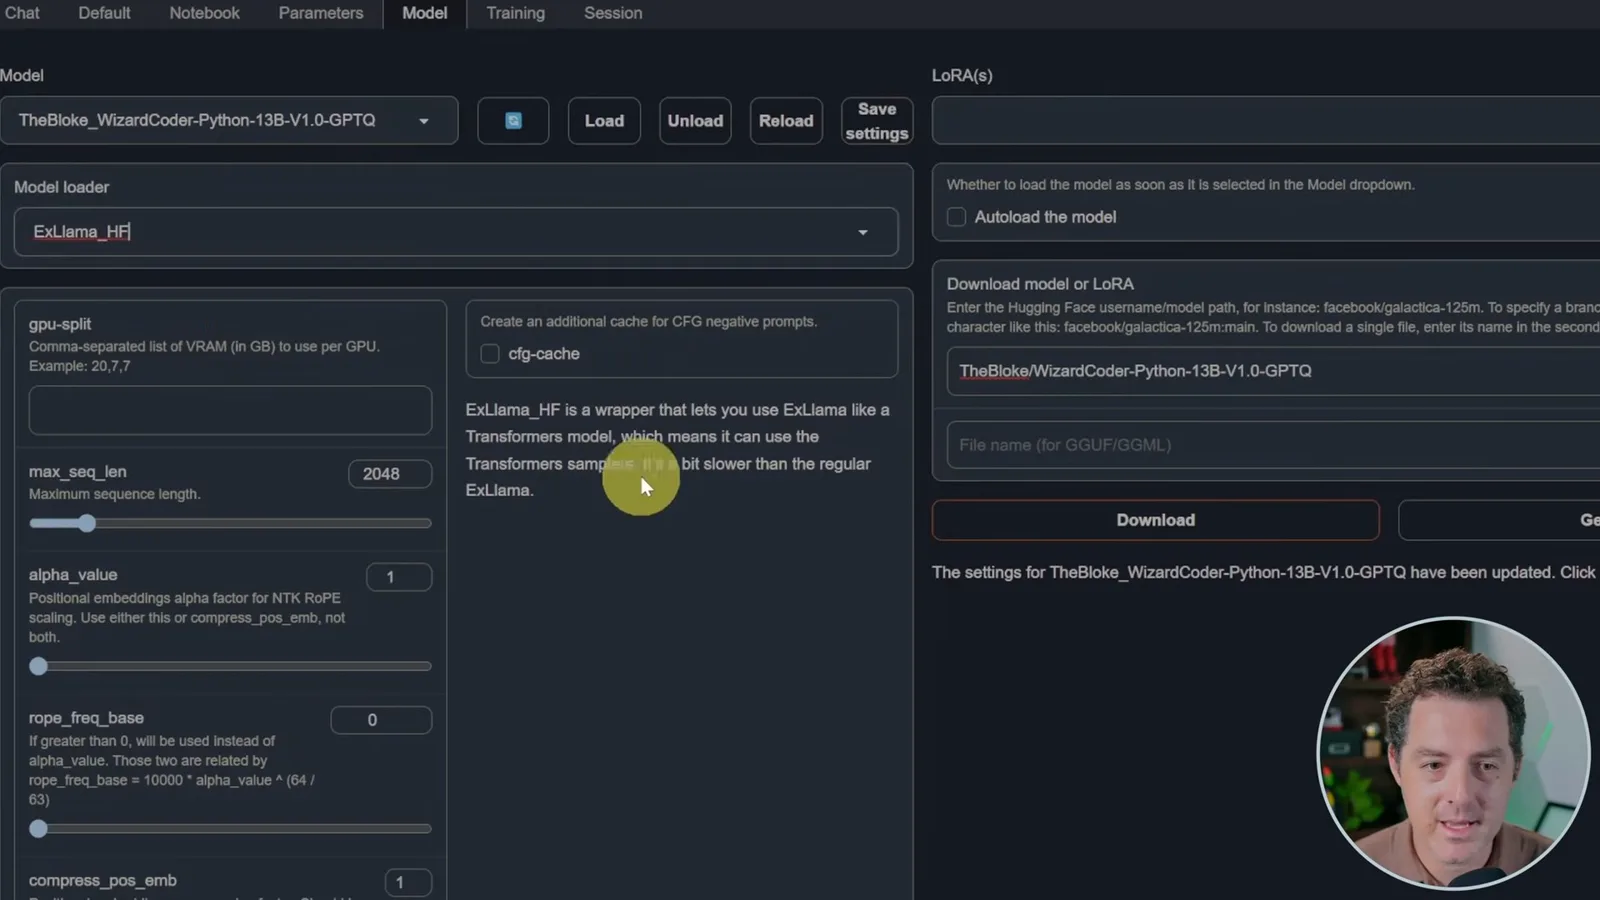
我使用 TheBloke 提供的 GPTQ 量化版本,模型文件约为 7 GB。量化降低模型权重的精度和大小;它可能影响质量,速度则取决于硬件和使用的软件。我将模型标识符复制到界面并下载。
刷新模型列表后,我选择下载的模型,并为此配置选择 ExLlama_HF,而不是默认加载器。我将最大序列长度设为 2,048,加载模型,再为编程设置最大新 token 数和较低的温度。展示的界面和加载器选项对应演示中使用的版本。
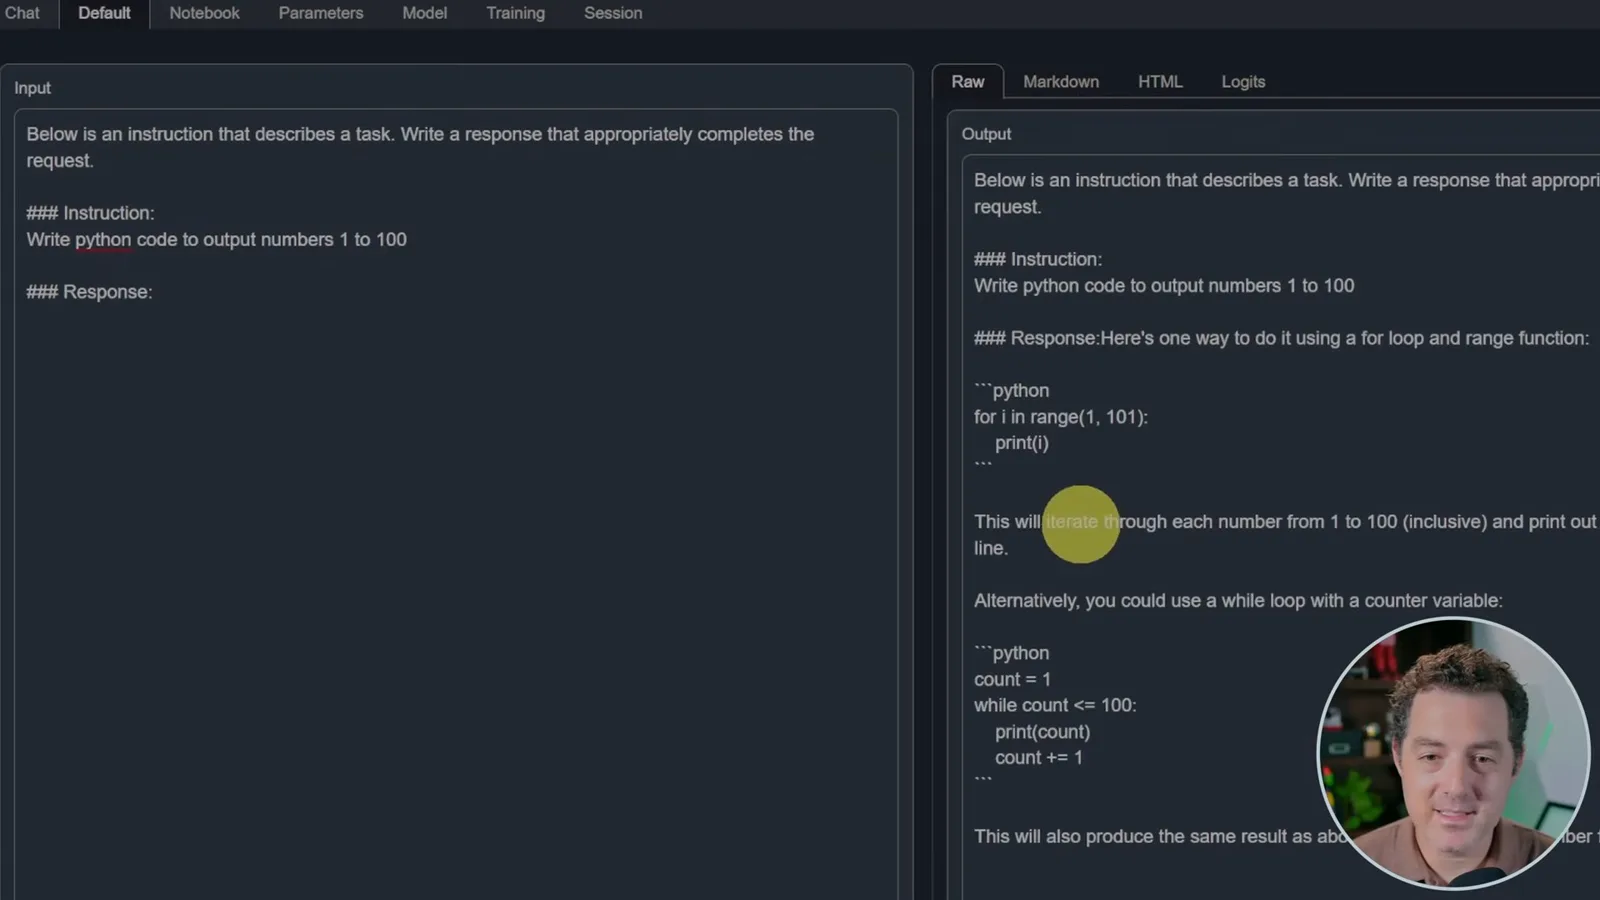
我使用指令模板,要求生成输出 1 到 100 的 Python 代码。模型返回了两个可运行的示例。这有助于检查本地配置是否运行正常,但一个简单提示不能证明它的整体编程可靠性,也不意味着硬件和电力免费。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。