30 秒看懂
Theo Browne 阅读 Anthropic 对 Claude Code 团队代码审阅的介绍,并与 T3 Code 的经验比较。他讨论 CI、agent 审阅者、人工风险评估、事故衡量和防止无限审阅循环。
- 1衡量下游结果审阅时间需要与回滚和事故一起衡量。
- 2给 agent 验证工具测试、运行应用和视觉证据有助于验证变更。
- 3先解决源头问题增加指令之前,优先改进代码和检查。
- 4让审阅收敛设置停止规则,避免 agent 无限迭代。
- 5保留人工责任人决定方向、处理风险并对结果负责。
要点建议
- 将审阅时间与回滚和事故一起衡量。
- 请求审阅前给 agent 提供可运行的行为验证方式。
- 使用多层检查,并在重要变更中保留人工判断。
- 让审阅循环收敛,而不是处理每条轻微建议。
- 对重复错误,先改进代码和确定性检查,再添加指令。
按章节阅读整理后的全文
以 agent 的速度审阅
Theo 研究 Anthropic 的描述,并与自己团队的经验比较,讨论取舍与实例。
Theo Browne 追问团队如何审阅 agent 大量生成的代码。他说 T3 Code 项目一天最多收到过 800 个拉取请求,小团队面临很大的分诊负担。
他阅读并回应 Anthropic 对 Claude Code 团队审阅流程的介绍。讨论结合了原文描述和他对 T3 Code 的观察,两套工作流并不完全相同。
人工注意力与验证
Theo 研究 Anthropic 的描述,并与自己团队的经验比较,讨论取舍与实例。
Anthropic 描述了在监控回滚和事故的同时优化人工审阅时间。Theo 赞同:只有团队之后不必花更多时间修复故障,减少审阅时间才真正有帮助。
原文报告称,6 月至 9 月 Claude Code 合并的拉取请求增加一倍以上,回滚比例下降超过 40%。Theo 提醒模型进步也可能有贡献;这些数字本身无法单独确定审阅流程变化的效果。
Theo 说,代码审阅有两个作用:发现缺陷,以及建立对代码库的共同理解。随着产出加快,即便机器读取更多差异,他也担心如何维持第二个作用。
他质疑人工阅读每一行就能可靠发现所有回归的假设。他认为自动审阅可能有价值,但人和模型都会漏掉问题,需要其他验证方法。
文章称,许多变更在请人查看前已经经过自动审阅和修复。Theo 倾向将其作为标准步骤,把稀缺的人类注意力留给最能发挥作用的决定。
他区分人的精力与时间:工作流可能很短,却依然令人疲惫。拉取请求、审阅、修复和再次审阅之间的等待,也会增加实际工作之外的延迟。
Claude Code 团队提出的目标是,让大多数变更最多由一人参与审阅,同时不增加回滚或事故。文章用事故率和回滚率检查是否只是把工作转移到了下游。
Theo 强调在审阅前给 agent 提供验证行为的方法。对用户界面,他描述了运行应用、截屏或录屏,并使用可预测的模拟事件,让 agent 不依赖实时模型调用也能测试产品。
审阅与发布的多层检查
Theo 研究 Anthropic 的描述,并与自己团队的经验比较,讨论取舍与实例。
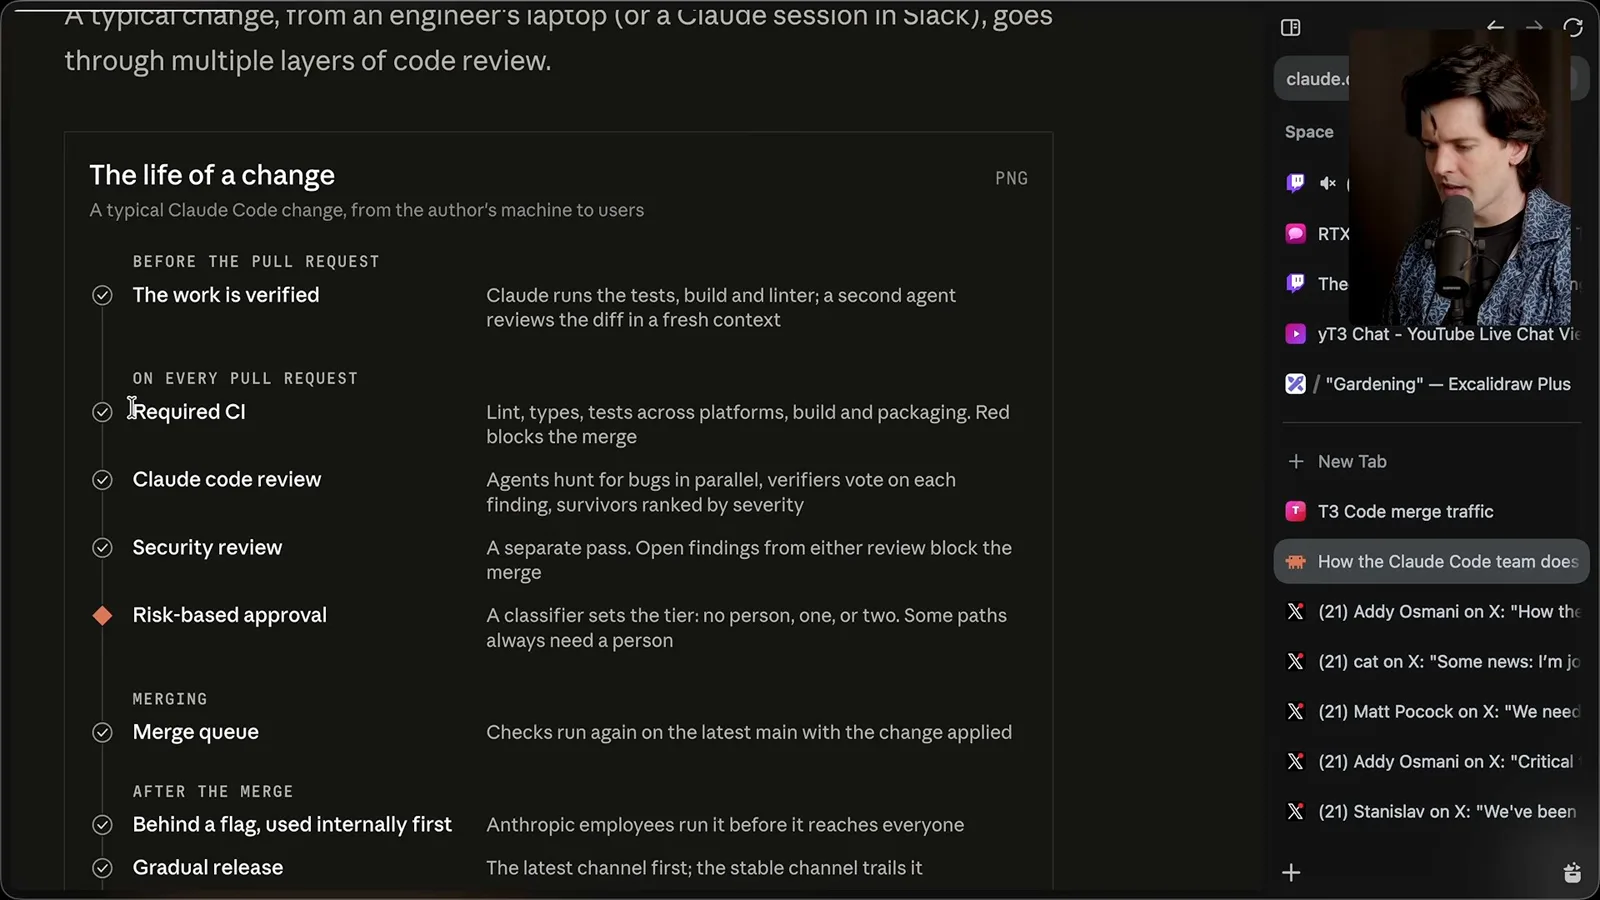
他概述 Anthropic 的多层流程:必需的 CI、多个审阅者参与并核验的自动缺陷审阅、独立安全检查、基于风险的人工批准和合并队列。合并后还有内部使用、分阶段发布和监控。
不同层可以捕获不同故障,但 Theo 提醒,如果 agent 盲目处理每条评论,也可能增加不必要的代码。他重视保持变更可理解,并让有问题的发布能够快速回滚。
在提交拉取请求前,原文介绍了运行测试、构建或视觉检查,并让拥有新上下文的 agent 审阅差异。一些团队还分别检查缺陷、简化、端到端行为和设计合规。
从源头解决问题
Theo 研究 Anthropic 的描述,并与自己团队的经验比较,讨论取舍与实例。
对于反复出现的错误,Theo 建议先让代码库更容易使用,再添加类型检查或 lint 规则等确定性检查;这些方法无法解决时,才添加指令或技能。
文章介绍了一种结合差异、仓库和变更意图的自动审阅。其报告的实质性评论覆盖率在研究预览后从 16% 升至 54%,但更多发现只有准确且可处理时才有价值。
Theo 质疑托管审阅产品对高产出项目的成本。他介绍自己使用不同模型家族的审阅者,并让编写代码的 agent 先评估反馈,再提交给人处理。
发现、安全与风险
Theo 研究 Anthropic 的描述,并与自己团队的经验比较,讨论取舍与实例。
文章称,多个 agent 寻找缺陷,独立验证步骤再过滤发现;保留的问题按严重程度排序,并标为重要、轻微或原有问题。作者需要修复问题,或解释为何关闭。
安全审阅是独立的阻塞环节。Theo 提到,如果发现是误报或不适用,可以说明理由后解决审阅线程;在所描述的工作流中,未解决问题会阻止合并。
原文根据风险等级决定需要零人、一人还是两人参与,并对敏感路径特殊处理。Theo 更倾向灵活评估,但同意 agent 的批准不能替代要求的人类批准。
无论代码由谁或什么工具编写,作者仍对变更负责。批准适用于特定提交,后续修改可能需要重新审阅。
合并后,功能开关、渐进发布、值班监控和快速回滚限制错误的影响。Theo 倾向改进发现与恢复能力,而不是假设仅仅放慢速度就能解决根本问题。
评估审阅者与收敛
Theo 研究 Anthropic 的描述,并与自己团队的经验比较,讨论取舍与实例。
为了改进审阅者,团队从事故和回滚中建立评估案例,由工程师确认缺陷。团队还通过观察人们如何回应评论,以及对已知干净的变更运行审阅,衡量噪声。
Theo 提醒,人可以很快忽略轻微建议,而 agent 可能实现它、增加一次提交并触发另一轮审阅。低价值发现因此可能消耗时间并膨胀代码差异。
他回忆曾让一个 agent 审阅循环运行四天,之后拉取请求膨胀到约 8 万行。这个例子说明,反复审阅不再取得有意义进展时,需要停止规则和升级处理。
Anthropic 文章描述了另一个拉取请求一夜之间经历 50 多轮审阅的案例。文章说,许多后续发现涉及首次审阅时已经存在的代码,说明反复审阅并不总是在发现新引入的缺陷。
团队增加了轮次上限、后续聚焦差异的审阅、针对一类缺陷的修复和重复发现抑制。团队报告平均通过轮次从 2.08 降至 1.32;这是内部结果,并非普遍预期。
Theo 尝试使用分数阈值,而不是要求每条评论都消失。他也转述同事的替代方案:让 agent 直接判断某条评论是否可以忽略。
人工责任与共享上下文
Theo 研究 Anthropic 的描述,并与自己团队的经验比较,讨论取舍与实例。
人仍负责决定方向、范围和工作是否值得做。Theo 强调账单和 CI 等高风险路径、架构决策以及对实际证据的审阅;作者仍对结果负责。
知识共享问题仍然存在。Theo 说,他会让模型解释模块或拉取请求,包括改了什么和风险在哪里;他也重视开放的团队频道,让大家看到正在进行的工作。
文章的责任模式强调小而可逆的变更、遥测和共享上下文。负责意味着准备好修复自己的变更,而不是在失败时自动归咎于某个人。
由于 agent 降低了开始工作的成本,Theo 说团队在出现更好方向时可以关闭或调整拉取请求。尽早提出替代方案,能避免把审阅精力投入团队不想发布的工作。
实践清单
Theo 研究 Anthropic 的描述,并与自己团队的经验比较,讨论取舍与实例。
他的实践清单覆盖拉取请求之前、期间和之后:提供可运行检查,记录测试与回滚方法,使用 CI 和适合风险的审阅,分阶段发布,并将事故转成评估案例。
他再次强调主要分歧:与其为每次失败不断增加文字指令,不如先改进代码和检查,让人和 agent 都更不容易犯同样的错误。
Theo 欢迎 Anthropic 分享详细经验,并请团队交流如何审阅 agent 编写的代码。节目引用的原文:https://claude.dev/blog/solving-code-review-at-anthropic/
同频道的其他文章
 41:02EN → 简体中文
 Theo - t3․gg· 2026年11月5日Theo 谈 PewDiePie 的本地 AI 项目、训练数据与模型安全Theo, PewDiePie对 Ajax 和 Odysius 项目的一次视频回应,延伸出自愿提供数据、智能体轨迹、微调和本地模型取舍的讨论。
 31:44EN → 简体中文Theo - t3․gg· 2026年11月3日Theo:用迭代评审改善智能体生成的界面Theo一项 T3 Code 实验利用多个模型评审、截图和反复修改改善界面,同时暴露了主观评分的局限。
 15:50EN → 简体中文Theo - t3․gg· 2026年11月3日Theo 比较用量调整后的 Codex 与 Claude 订阅价值TheoTheo 讨论额度估算、每任务成本和个人审查实验,同时认为模型质量仍是关键。
 16:46EN → 简体中文Theo - t3․gg· 2026年11月2日Theo Browne:Claude Ultra、五小时限额与 SDK 用量Theo Browne · Ping Labs解读更名后的订阅档位、账户验证,以及交互式 CLI 与 SDK 用量的报告差异。
 49:29EN → 简体中文Theo - t3․gg· 2026年10月30日Theo:智能体 Harness、界面与不断变化的抽象层次Theo · T3 CodeT3 Code 创建者解释他对 harness 的理解,以及为什么他预计用户会越来越少地注意它们的差异。
 41:49EN → 简体中文Theo - t3․gg· 2026年10月29日Theo 演示如何用 T3 Code 协调编码智能体Theo · t3.ggT3 Code 的创建者介绍多个智能体提供方、远程机器、会话组织方式,以及开源编码界面的取舍。