30 秒看懂
Theo Browne 认为 Anthropic 的 Fable 5.2 在公布的技术基准上表现强劲,处理难题也有用,但它可能遗漏上下文并作出不佳的设计决定。在他自己的代码库审查中,模型常常较慢,而 Opus 5.5 仍是他日常工作的首选。他还分析了模型专属限额与订阅总限额的关系,并通过一个小游戏比较两种模型。
- 1公布的领先成绩没有保证它在他的代码库测试中领先Browne 报告自己的评测存在结果波动和错误说法。
- 2仔细审查带来了显著时间成本他的一批 8 个拉取请求约用两小时。
- 3能力增强并未消除检查输出的必要一个隐私显示示例暴露了本应隐藏的邮箱地址。
- 4他默认使用 Opus,按需选择 Fable游戏比较和编程工作展示了两者不同的优势。
要点建议
- 公布的基准成绩与 Browne 自己的代码库测试呈现出不同结果。
- Fable 能处理难题,但仍需要人类监督。
- 他观察到模型专属订阅限额也会计入总限额。
- Browne 日常默认使用 Opus,在选定的难题上使用 Fable。
按章节阅读整理后的全文
发布、访问条件和公布的基准
Browne 查看公告,并将公布的成绩与自己的结果比较。
Theo Browne 首先谈到 Anthropic 发布 Fable 和 Mythos 5.2。经过一天测试,他认为模型能力很强、有明显优势,但仍需要仔细监督。
他将新版本与此前的 Fable 5.1 和 Opus 5.5 比较,认为新版本改善了速度和价格,同时带来不同取舍。
Browne 先拿公告中的破折号数量开玩笑,随后介绍要讨论的内容:基准测试、订阅用量、编程示例和视觉设计。
发布公告介绍了软件、硬件和科学任务。Browne 说,其中一些编程演示与他此前见过其他模型完成的任务类似。
他将 Fable 与 Mythos 描述为底层模型相同、访问和安全控制不同的两个版本。他说,后者通过核验项目向某些研究用途开放。
他引用发布时公布的 API 价格:每百万输入词元 8 美元、每百万输出词元 40 美元;可选的快速模式价格更高。
Browne 说自己只粗略阅读了较长的系统说明,计划之后深入研究。他还提到公司建议:日常工作从 Opus 开始,更困难的技术任务再使用 Fable。
他非常认同把 Opus 用作日常模型,但说自己使用 Fable 的经历让他对更广泛的建议有所保留。
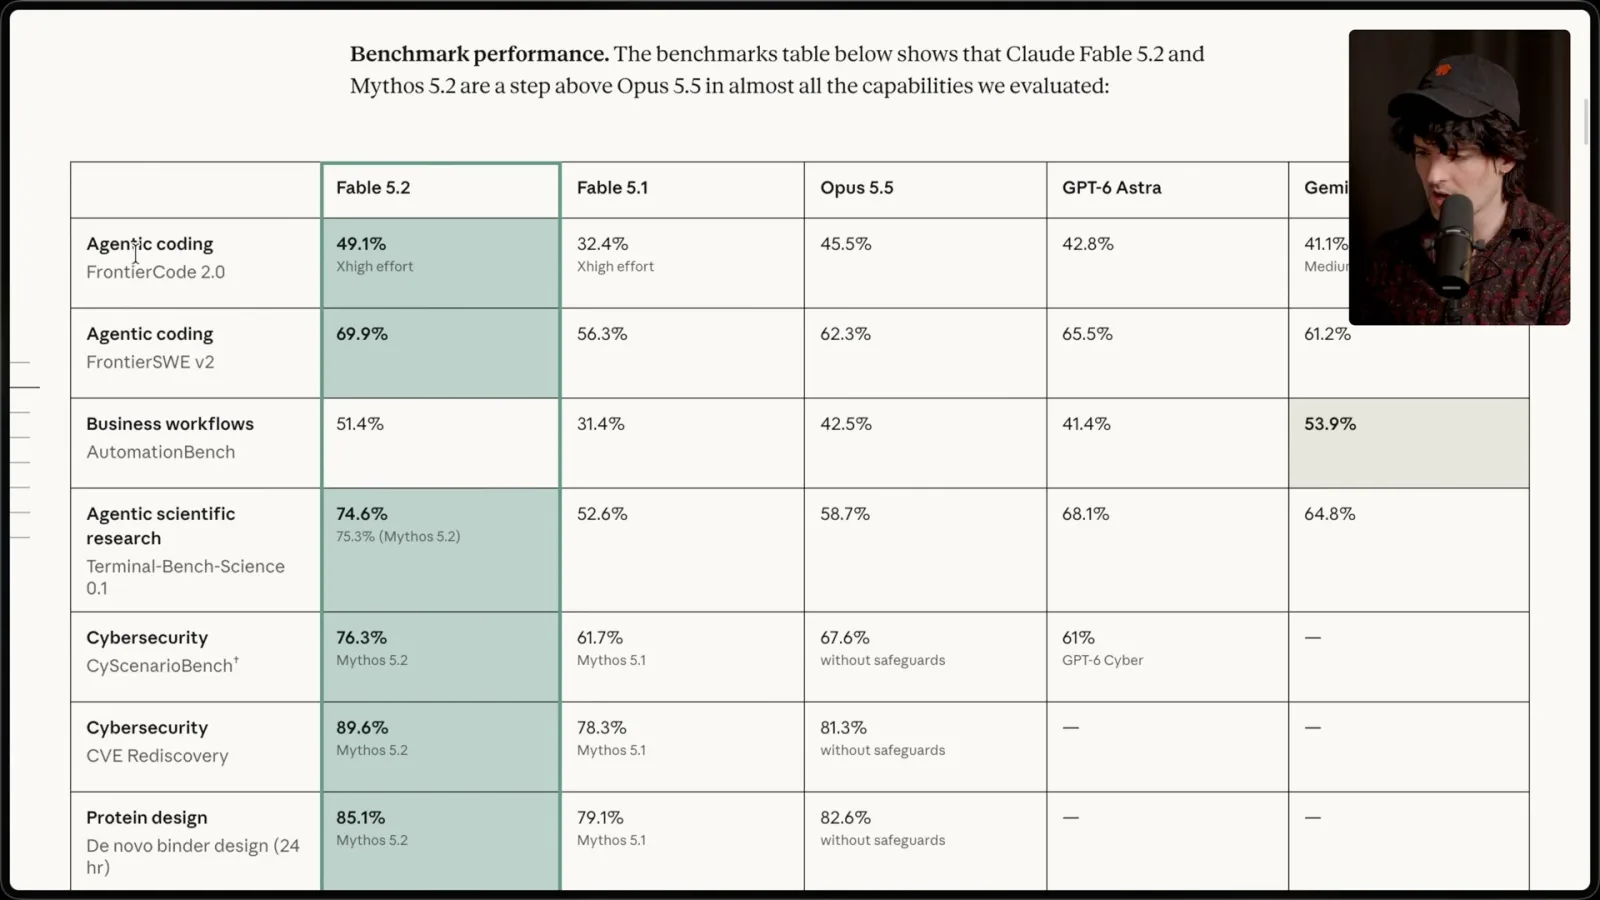
Browne 逐项查看公布的基准表,强调智能体编程、科学、网络安全和蛋白质设计方面的强劲成绩,同时指出两个版本的访问限制不同。
他自己的代码库分析测试呈现出不同情况:他说 Fable 5.2 有时落后于 Opus 和 Sonnet,尽管在该测试集中超过了一些其他模型。
他认为 Fable 有时能给出异常巧妙的答案,但也会遗漏上下文并犯出令人意外的错误。他把这种波动视为需要检查输出的理由。
Browne 提醒,不要以为最高推理档位一定最适合编程。他查看的结果显示,最高档可能更贵、表现却不如较低档。
他注意到硬件设计基准上的提升,并预计编程智能体的方法会更多应用到电子工程中。
公司公告称其大量代码变更由 AI 编写,并举出 Python 迁移到 Rust 的例子。Browne 将这些演示与自己的项目作比较。
他查看科学、数学和机器人方面的宣传,但说自己做数据分析时的结果有好有坏:新颖建议可能与缺乏依据的推断或遗漏背景同时出现。
采用情况与代码库评测
他讨论数据保留政策、使用数据和拉取请求审查。
Browne 说,数据保留设置会影响企业采用。他对比了自己所述的 Fable 限制,以及有严格政策的组织使用 Opus 的条件。
他以自己的 T3 Code 流量为例,报告 Opus 5.5 发布后使用明显转向该模型。这些数字来自他自己的产品。
他的评测要求模型分析代码库并审查真实拉取请求。对于一个 TypeScript 转 Rust 项目,他报告 Fable 在 61 个说法中有 4 个错误,该次运行成本约 23 美元。
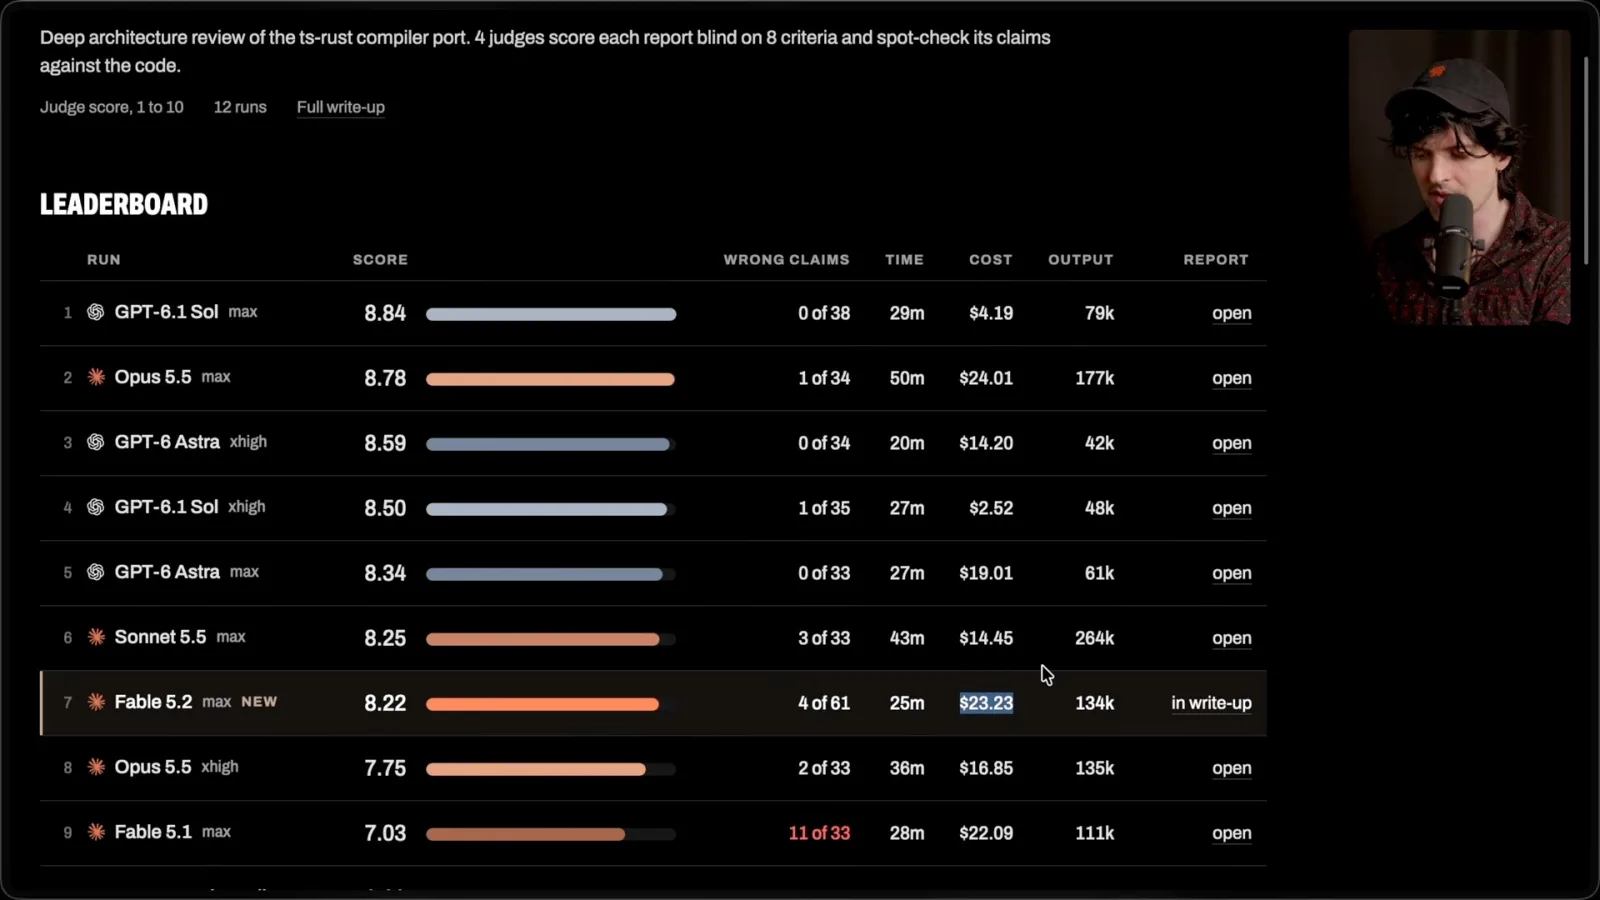
他说,另一个模型在那次运行中提出的说法更少且没有错误,而 Opus 在他的 T3 Code 分析中领先。他指出结果会因项目不同而变化。
在拉取请求审查中,他觉得 Fable 仔细但速度慢:一批 8 个审查约用两小时。他欣赏它愿意略过小问题,同时指出它也可能漏掉重要问题。
他回忆让 Fable 改进一个比较使用成本的页面。虽然重新设计改变了外观,但他认为第一版没有让数字差异更容易比较。
订阅限额和定价
他讲解观察到的限额、重置及不同使用方式的价值。
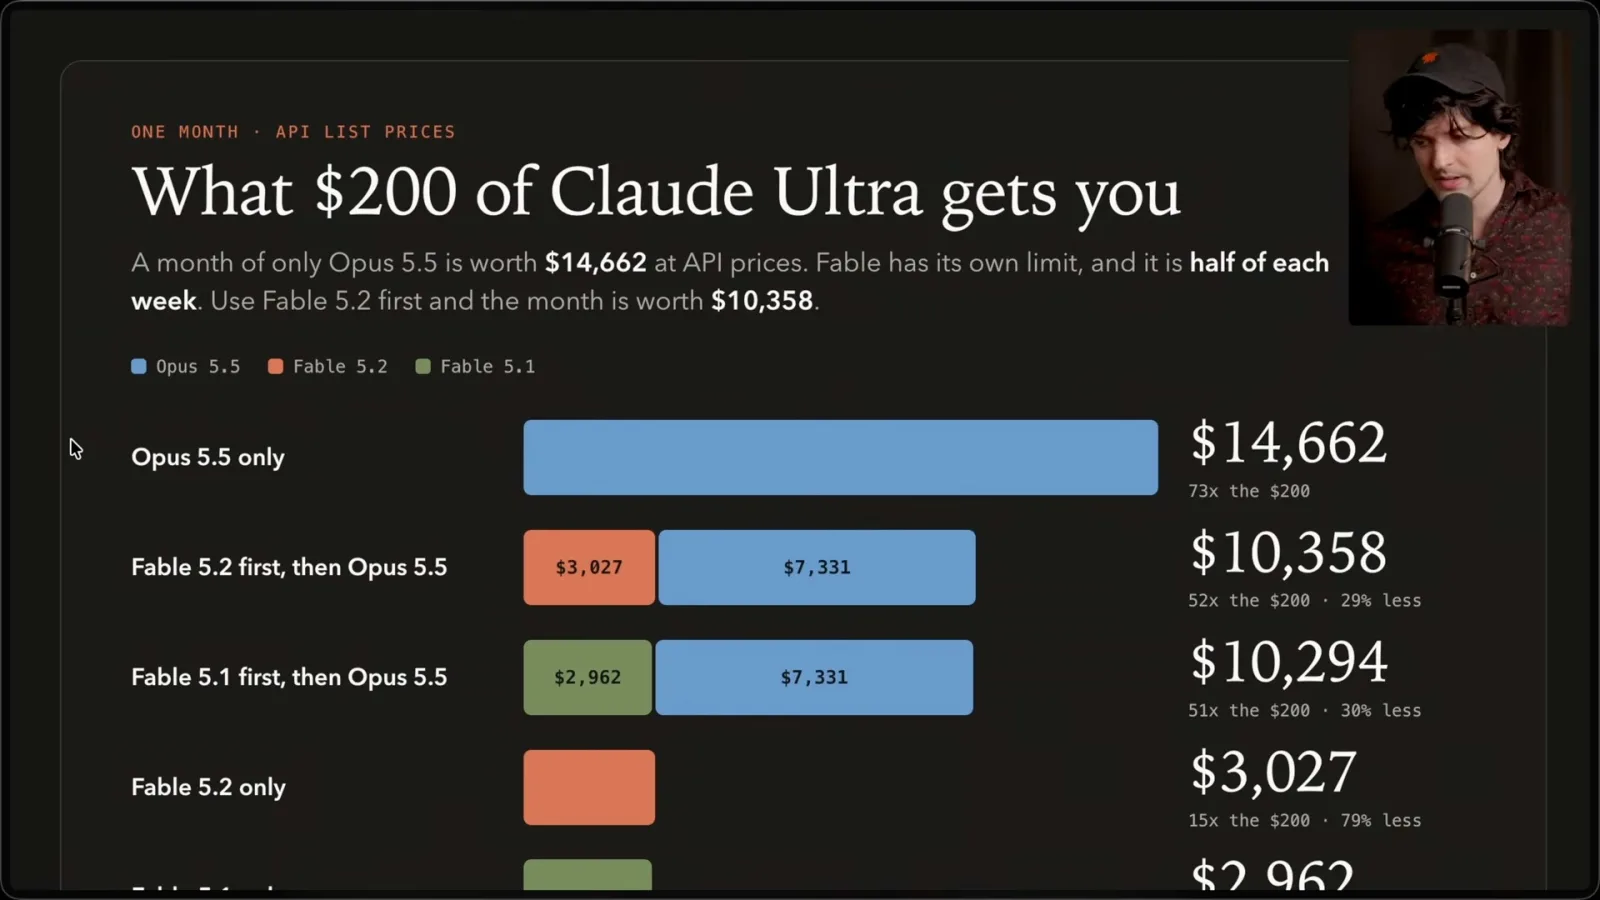
Browne 解释自己观察到的订阅限制:模型专属周限额也计入总周限额。用完一个限额,不一定意味着另一个也已用完。
他测试一次模型限额重置,观察可用周额度如何变化以及重置时间表是否改变,并与自己在其他产品中的体验作比较。
他根据自己的高用量假设,比较订阅用量按 API 价格折算的名义价值。他强调,API 标价与实际底层成本是不同的数字。
他报告自己测试中 Fable 5.2 的输出速度约为每秒 106 个词元,Opus 约为 112。他推测新模型更快、更便宜的原因,但没有得到架构方面的确认。
他估算混用 Fable 与 Opus 对月度额度的影响,并指出实际可获得的有效轮次取决于任务长度以及单轮完成任务的频率。
设计与编程示例
Browne 展示前端和技术工作中的优势与失误。
在前端示例中,他喜欢一些动画和颜色,但不喜欢另一些布局。他展示的例子里,关闭设计 skill 后,结果更趋同。
他说,使用 Fable 时自己需要比预期更频繁地介入。模型能解决难题,但也可能沿着明显不佳的设计决定继续走,直到有人纠正。
一个例子涉及一台运行缓慢的机器:他比较不同模型给出的解释,更喜欢指出存储差异的简洁回答。
讨论 MCP 配置时,他说 Fable 先质疑一项建议,查看相关历史后又改变了看法。他重视模型提出异议和修正答案的能力。
他还报告一个隐私显示错误:本应隐藏邮箱地址的页面却在横幅中显示了地址。这个例子强化了他检查生成结果的建议。
他的区分是:模型可能更擅长克服技术障碍,但在需要人类判断的决定上,自主性并没有按同样幅度提升。
他回忆自己称赞一份审计结果后,才发现误用了 Opus 而不是 Fable。这次失误强化了他对 Opus 日常工作能力的评价。
为了向团队移交工作,他要求模型解释一个内部工具。结果外观精致,却遗漏了他想要的架构图;追加要求后才补上。
游戏演示前,他遇到所用工具的输入错误,也承认自己的 T3 Code 产品同样存在缺陷。
游戏比较与最终评价
他比较游戏输出,解释为何仍默认使用 Opus。
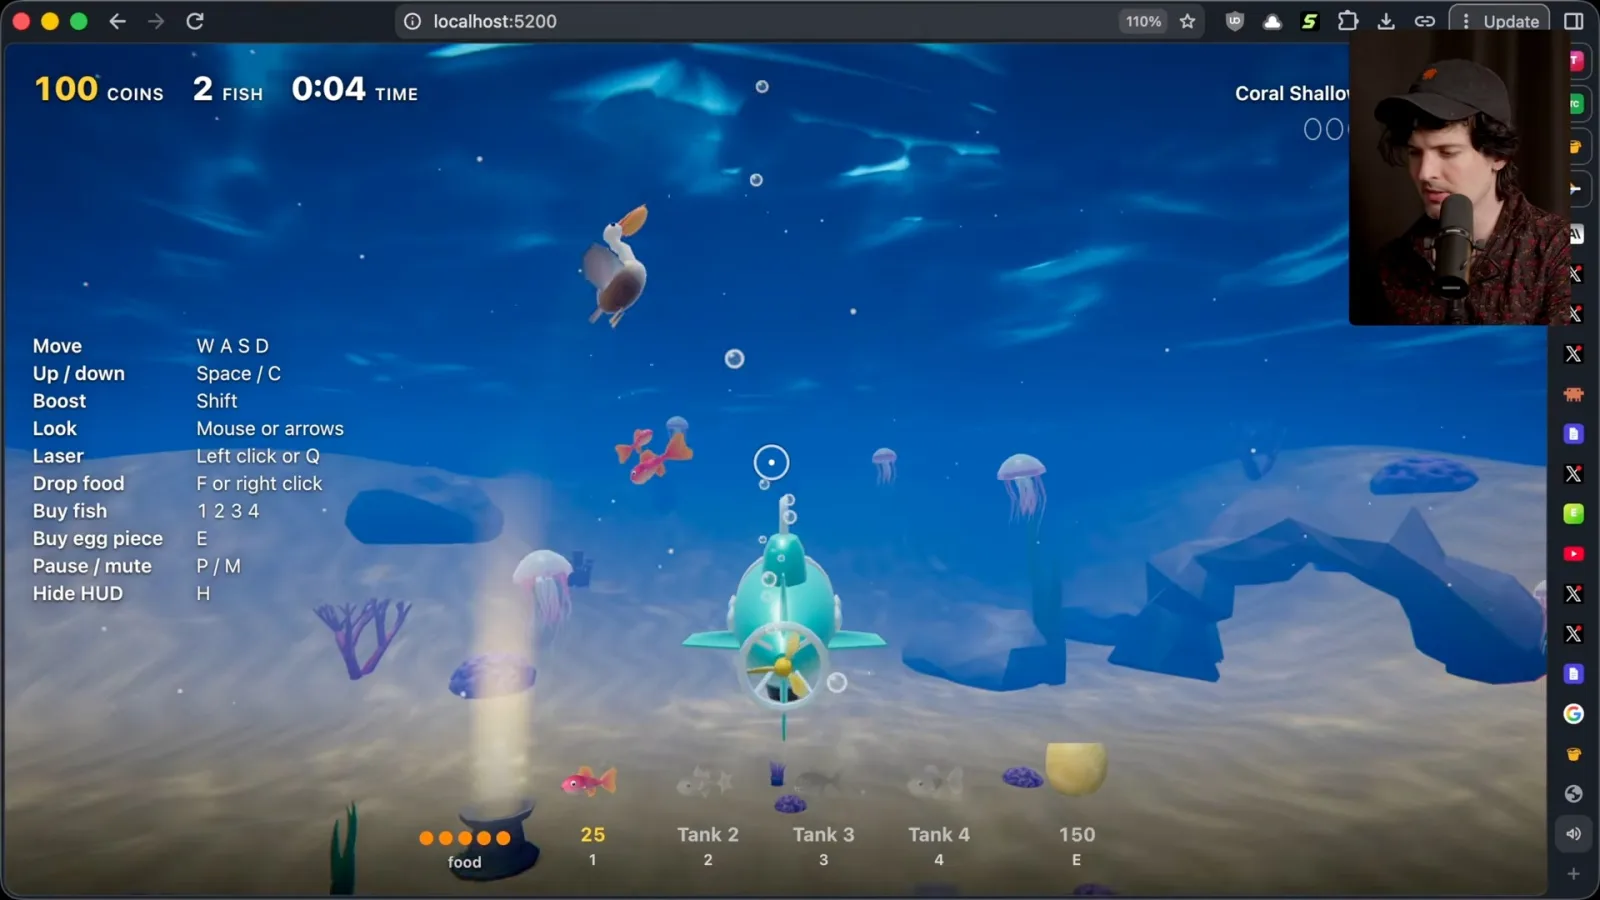
他比较 Fable 与 Opus 制作的鱼类游戏版本。他喜欢 Fable 版本的视觉效果,但认为 Opus 版本的游戏循环更有趣。
他的结论是在适当情况下组合使用模型:他把 Fable 视为解决高难问题的强力专才,把 Opus 视为更实用的日常默认选择。
Browne 对版本号作出推测,但承认自己不知道内部原因。他预计在使用更长时间后重新比较。
同频道的其他文章
 45:21EN → 简体中文
 Theo - t3․gg· 2026年11月9日Theo:AI 编程时代,维护开发环境成了重要工作Theo Browne · Ping Labs从 Twitch 到 T3 Code,Theo 认为工程师需要消除阻碍智能体的摩擦,并建立有效反馈。
 42:14EN → 简体中文Theo - t3․gg· 2026年11月6日Theo Browne:Claude Code 如何审阅自己的变更Theo Browne · Ping LabsTheo 将 Anthropic 的分层审阅流程与 T3 Code 对比,重点讨论验证、回滚和 agent 审阅的停止规则。
 41:02EN → 简体中文Theo - t3․gg· 2026年11月5日Theo 谈 PewDiePie 的本地 AI 项目、训练数据与模型安全Theo, PewDiePie对 Ajax 和 Odysius 项目的一次视频回应,延伸出自愿提供数据、智能体轨迹、微调和本地模型取舍的讨论。
 31:44EN → 简体中文Theo - t3․gg· 2026年11月3日Theo:用迭代评审改善智能体生成的界面Theo一项 T3 Code 实验利用多个模型评审、截图和反复修改改善界面,同时暴露了主观评分的局限。
 15:50EN → 简体中文Theo - t3․gg· 2026年11月3日Theo 比较用量调整后的 Codex 与 Claude 订阅价值TheoTheo 讨论额度估算、每任务成本和个人审查实验,同时认为模型质量仍是关键。
 16:46EN → 简体中文Theo - t3․gg· 2026年11月2日Theo Browne:Claude Ultra、五小时限额与 SDK 用量Theo Browne · Ping Labs解读更名后的订阅档位、账户验证,以及交互式 CLI 与 SDK 用量的报告差异。