30 秒看懂
2026 年 8 月,Matthew Berman 评测了 GLM-5.3-Flash,即 Z.ai 此前以 Ox Alpha 名称预览的模型。他重点介绍了其混合专家架构、报告中的基准表现、当时的 API 成本比较和关于中国芯片推理的报道,随后展示了编码和演示文稿示例。 他的演示结果有好有坏,而比较使用了不同工具和联网条件。基准数据、价格和基础设施相关说法都有时间限制,不能证明模型在所有任务上的质量。视频由 Higgsfield 赞助。
- 1Ox Alpha 身份揭晓Berman 表示,匿名预览模型是 Z.ai 的 GLM-5.3-Flash,并强调它共有 3,200 亿参数,其中 180 亿为激活参数。
- 2基准成绩展示的厂商图表显示,Terminal-Bench 2.1 成绩为 84.3,DeepSWE v1.1 成绩为 63.4。这些结果适用于特定测试。
- 3每项基准任务的成本Berman 解读 Artificial Analysis 图表:在展示的设置下,GLM 每项指数任务约 0.09 美元,Claude Fable 5 约 3.14 美元。
- 4中国芯片推理Berman 引述每天处理 100 万亿 token 的报道,以及 Z.ai 关于中国芯片集群的声明。这些吞吐量和经济性比较是报告中的说法,取决于具体工作负载。
- 5实际测试结果不一魔方演示令他满意,而设计对比中胜出的模型各不相同,使用的工具权限也不一样。
要点建议
- GLM-5.3-Flash 是开放权重的混合专家模型,据称共有 3,200 亿参数,每个 token 激活 180 亿参数。
- 大型模型即使每个 token 只激活部分参数,在本地运行仍可能需要大量内存。
- 厂商基准以及 Artificial Analysis 的指数和成本数据比较的是特定工作负载,并非所有真实任务。
- Berman 喜欢 GLM 制作的魔方、部分网站设计和演示文稿,但更喜欢 GPT-5.6 Sol 的生物群系场景,并不满意两个模型在其他网站任务中的表现。
- 两个模型使用的编码环境和联网条件不同,限制了直接对比的说服力。
- 视频由 Higgsfield 赞助;讨论的价格和可用性均为当时情况。
按章节阅读整理后的全文
Ox Alpha 背后的模型
Berman 介绍 GLM-5.3-Flash、其开放权重和混合专家设计。他回顾厂商报告的基准成绩,并介绍付费赞助商。
一个名为 Ox Alpha 的神秘模型出现在 OpenRouter 上并受到关注,随后 Z.ai 确认它就是 GLM-5.3-Flash。Matthew Berman 对这个相对便宜的开放权重模型感到兴奋,他认为它与更大的系统相比表现出色。他的视频发布于 2026 年 8 月;价格、排名和模型可用性可能变化。
Z.ai 将其描述为混合专家模型,共有 3,200 亿参数,每个 token 激活其中 180 亿。开放权重让用户可以按许可证检查、改造或托管模型,但这本身并不意味着全部训练数据和流程都公开。激活参数数量不等同于存放整个模型所需的内存;自行托管仍需要大量资源。
Berman 表示,Flash 模型在多项测试中超过 GLM-5.2,成本却只是旧模型的一小部分,并将它与更昂贵的模型比较。他说 Flash 的总体水平还达不到 Fable。他对某个竞争专有模型参数数量的估计并未在视频中得到证实,不应视为已确认的规格。
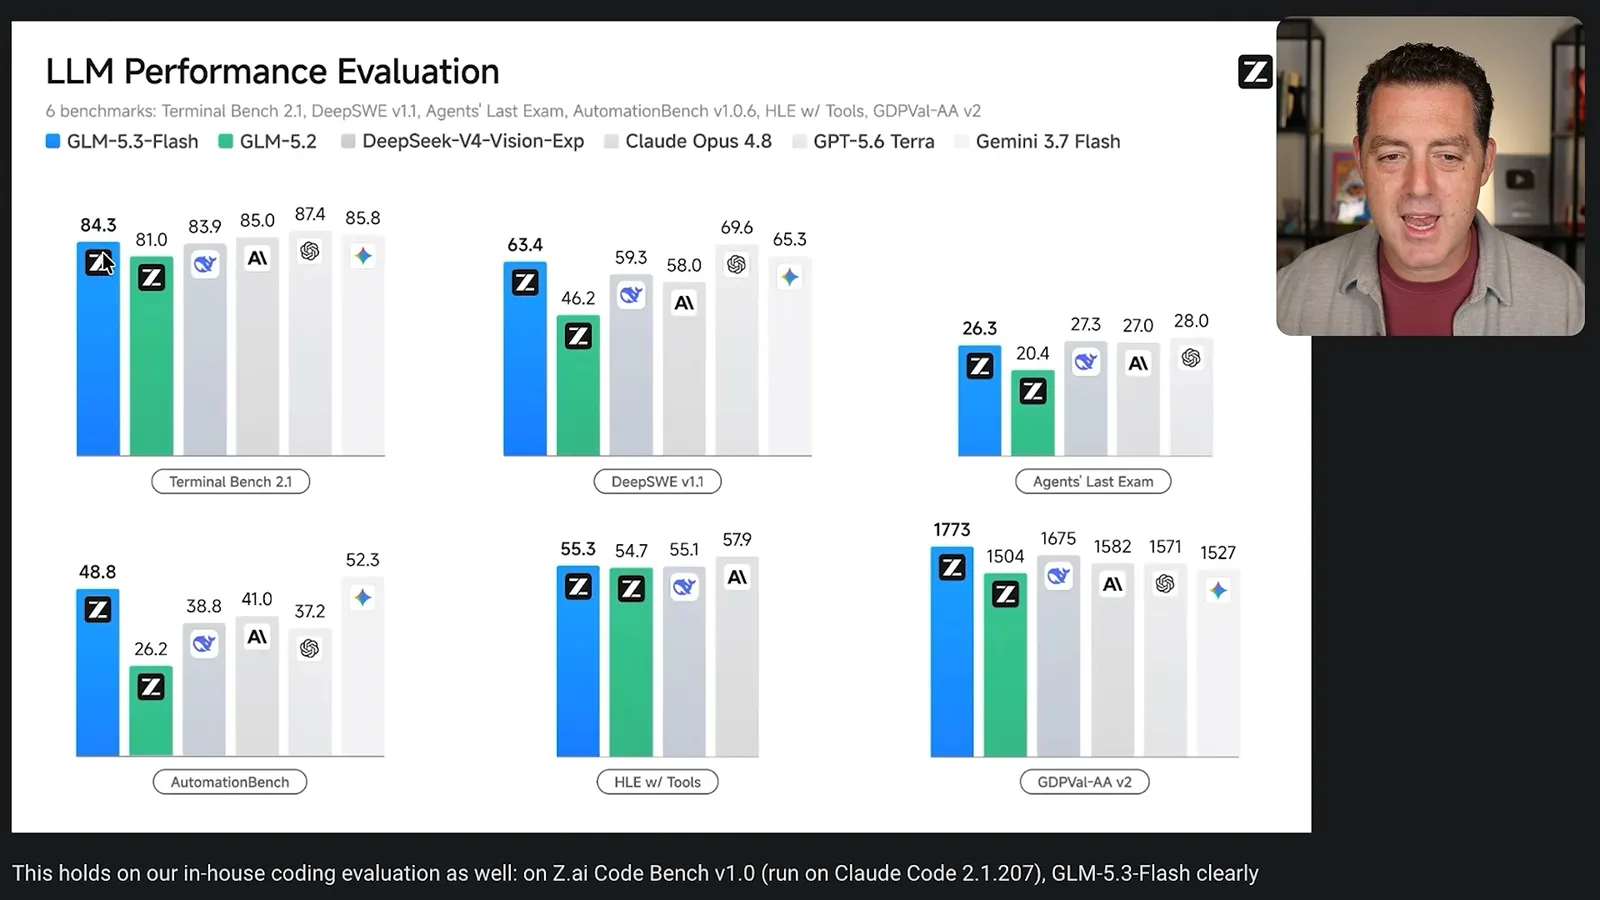
视频展示的 Z.ai 图表报告,Terminal-Bench 2.1 成绩为 84.3,DeepSWE v1.1 成绩为 63.4,GDPVal-AA v2 的成绩也很高。这些是厂商展示的指定基准比较,并不能证明它在所有任务中都更强。Berman 尤其关注相较 GLM-5.2 的提升。
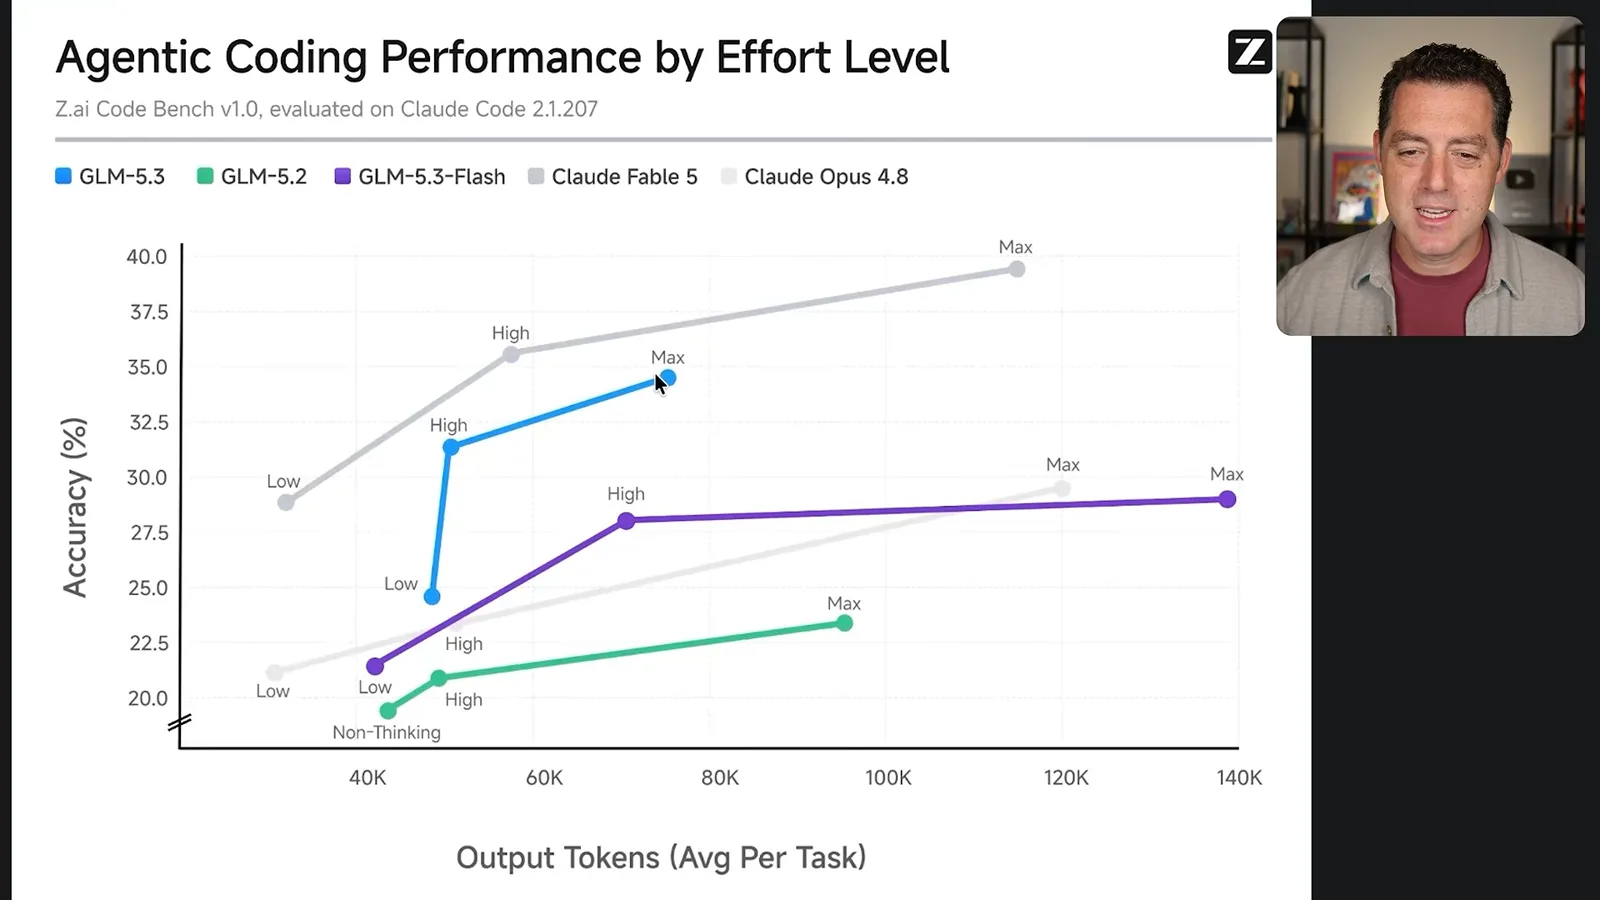
另一张 Z.ai 编码图表展示了不同推理强度下,准确率与平均输出 token 数量的关系。Berman 指出,图中最大推理强度的完整版 GLM-5.3 接近高推理强度的 Fable,而最大推理强度的 Fable 得分更高。蓝色的完整版 GLM-5.3 曲线与紫色的 GLM-5.3-Flash 曲线不同;那项特定比较不应归给 Flash。
Berman 引用他展示的 Artificial Analysis Intelligence Index 快照:GLM-5.3-Flash 得分 57,Claude Fable 5 得分 62。指数汇总了选定评测,并不意味着可以精确衡量一个模型具有另一个模型通用智能的百分之多少。视频包含 Higgsfield 的付费赞助,推广其图像和视频 API。
成本、token 与基础设施
他比较基准成本和 token 用量,随后讨论有关中国 AI 芯片服务推理的报道。他介绍了通过不同服务商访问模型的方法。
展示的 Artificial Analysis 成本图表估计,在所示设置下,GLM-5.3-Flash 每项 Intelligence Index 任务的加权平均成本约为 0.09 美元,GPT-5.6 Sol 为 0.95 美元,Claude Fable 5 为 3.14 美元。Berman 认为得分与成本的组合令人瞩目。这些是基于当时 token 用量和价格计算的基准任务平均值,并非每项成功完成的真实任务的价格。
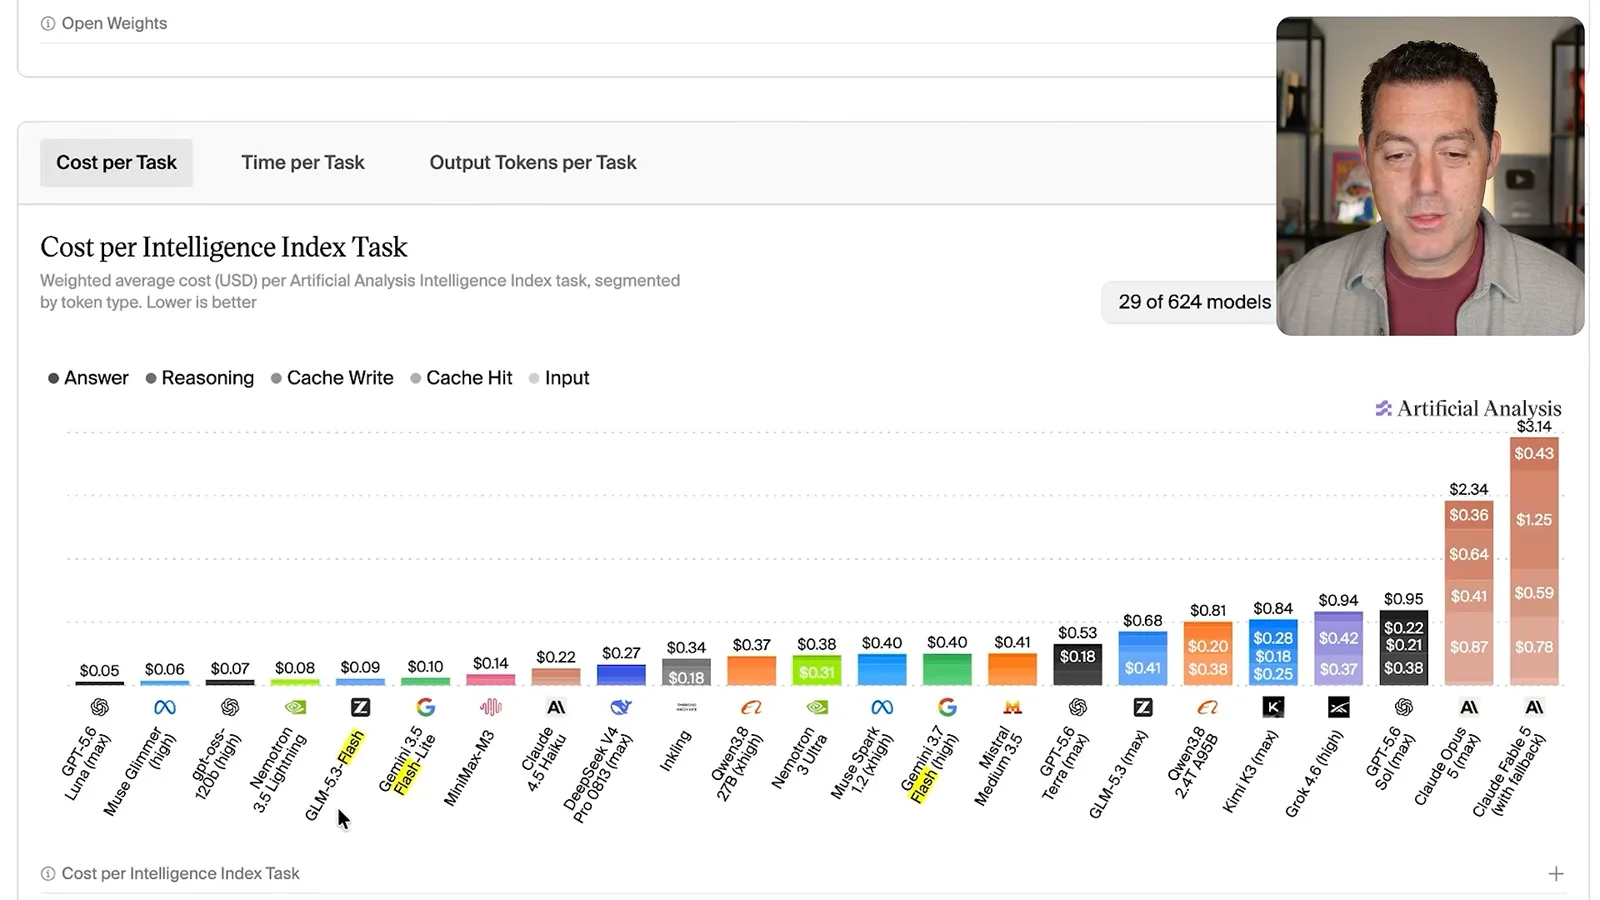
他比较了每项指数任务约 0.05 美元的 GPT-5.6 Luna 和约 0.09 美元的 Flash,指出 Flash 在该快照中得分更高,而且开放权重。这两个四舍五入后的成本,相对于 0.05 美元的差额约为 80%,而不是他后来所说的 40%。哪个更划算取决于任务、服务商、设置和具体需求。
图表显示,Luna 每项指数任务平均输出约 20,000 个 token,Flash 约为 47,000 个。Berman 借此解释,即使模型单价较低,token 用量也会影响总成本。这些是指数测试的平均值,并不能证明模型给出了相同答案,或在每项任务中表现同样好。
Berman 推测开放权重社区可以通过实验更快提高效率,同时承认这只是猜测。他介绍了发布时所展示的 100 万 token 上下文窗口、最大 131,000 token 输出和较低的缓存输入费率。实际上下文、限制、缓存和价格可能因服务商不同而异,也可能随时间变化。
Berman 引述 SemiAnalysis 的报道,称中国芯片每天处理 100 万亿 token;他还读出 Z.ai 的声明,介绍使用优化互联和服务软件的大规模中国芯片集群。这些是报告中的说法,视频没有独立验证这些测量值。这个数字不应与 OpenRouter 图表中六天处理 23.2 万亿 token 的数字混为一谈,也不能假定它描述所有服务商。
Berman 测试 Z.ai 的 API 端点,并指出其服务托管在中国,因此他避免发送敏感信息。他表示,开放权重也可以由其他推理服务商提供,并连接到兼容的编码工具。服务商所在地、数据保留政策、成本和安全性可能不同;设备条件合适的用户也可以选择自行托管。
编码与设计实验
Berman 演示一个魔方,并将生物群系场景和五个网站与 GPT-5.6 Sol 的结果对比。结果有好有坏,两种环境的联网条件也不同。
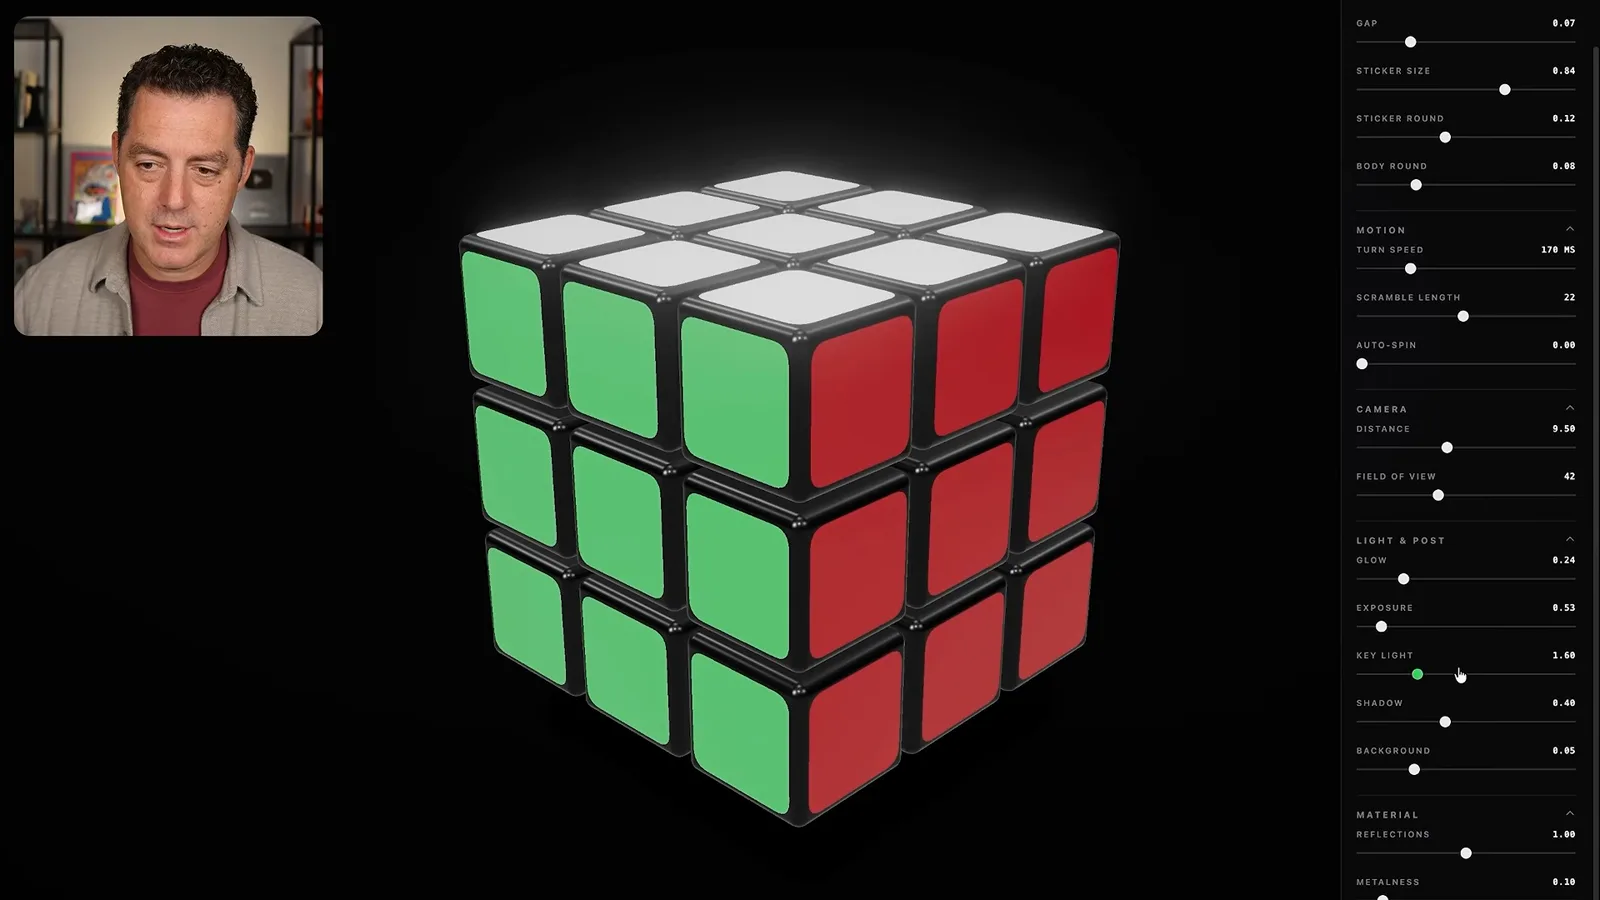
他的第一个演示是魔方模拟。他旋转各面、打乱并复原魔方,将大小改为 5×5,并调整旋转、灯光和材质。他认为演示流畅且逼真,同时指出其他近期模型也能制作类似作品。视频没有独立测试所有可能的魔方状态或物理行为。
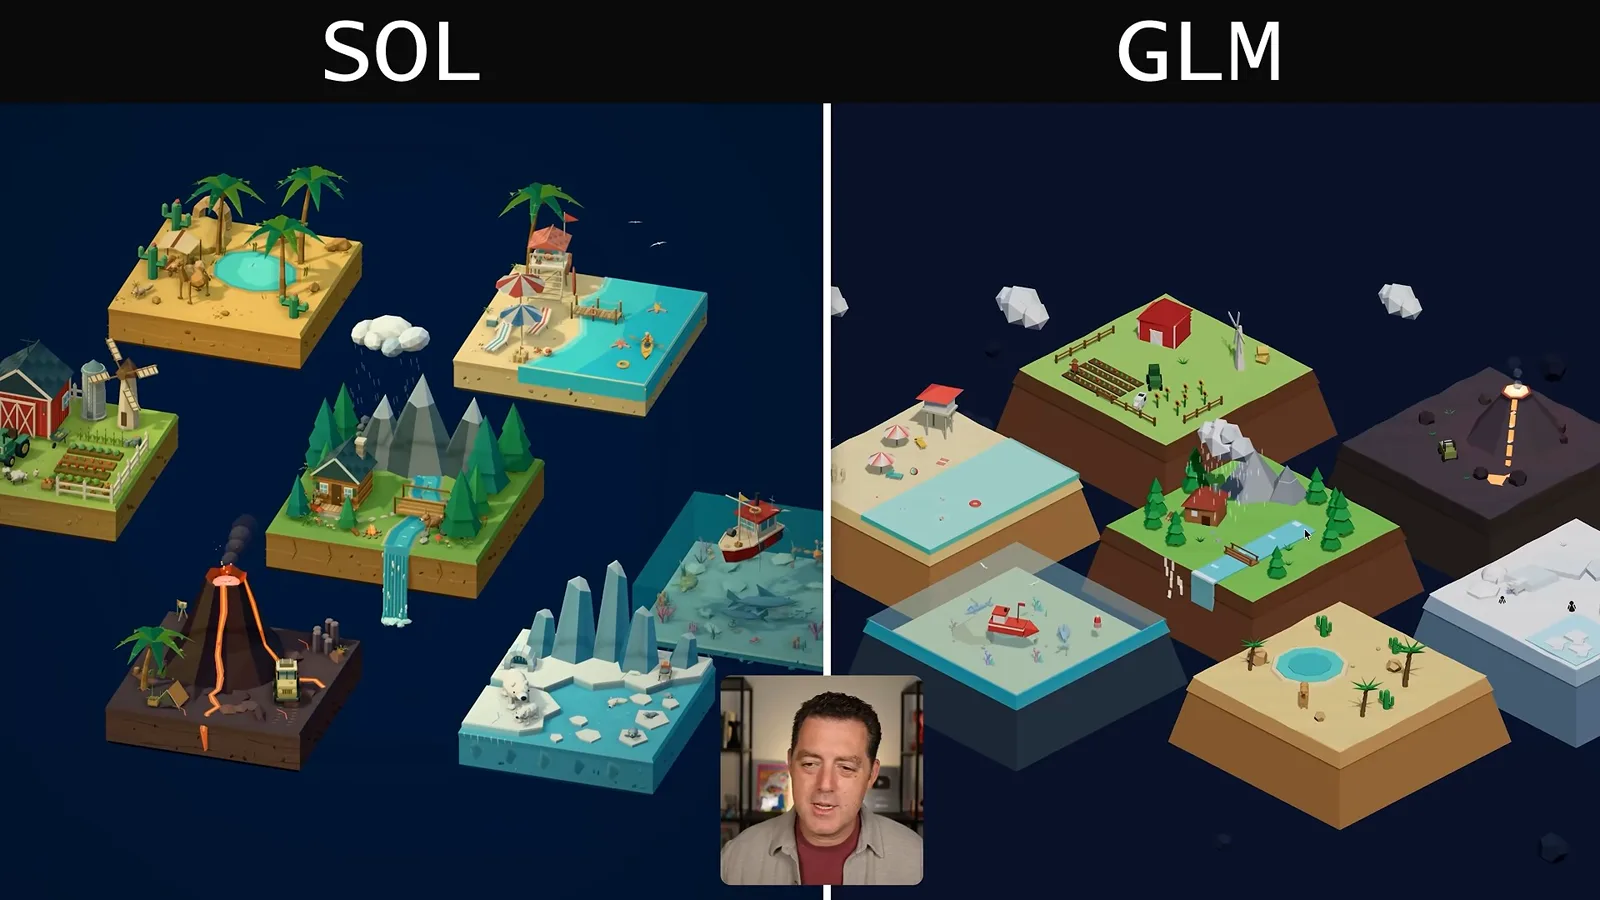
Berman 给 GLM-5.3-Flash 和 GPT-5.6 Sol 相同的提示词,让它们制作七个浮动的微型生物群系场景。他因细节和连贯性而明显更喜欢 Sol 的结果。这是他对一个提示词结果的视觉判断,而非对整体编码能力的受控评估。
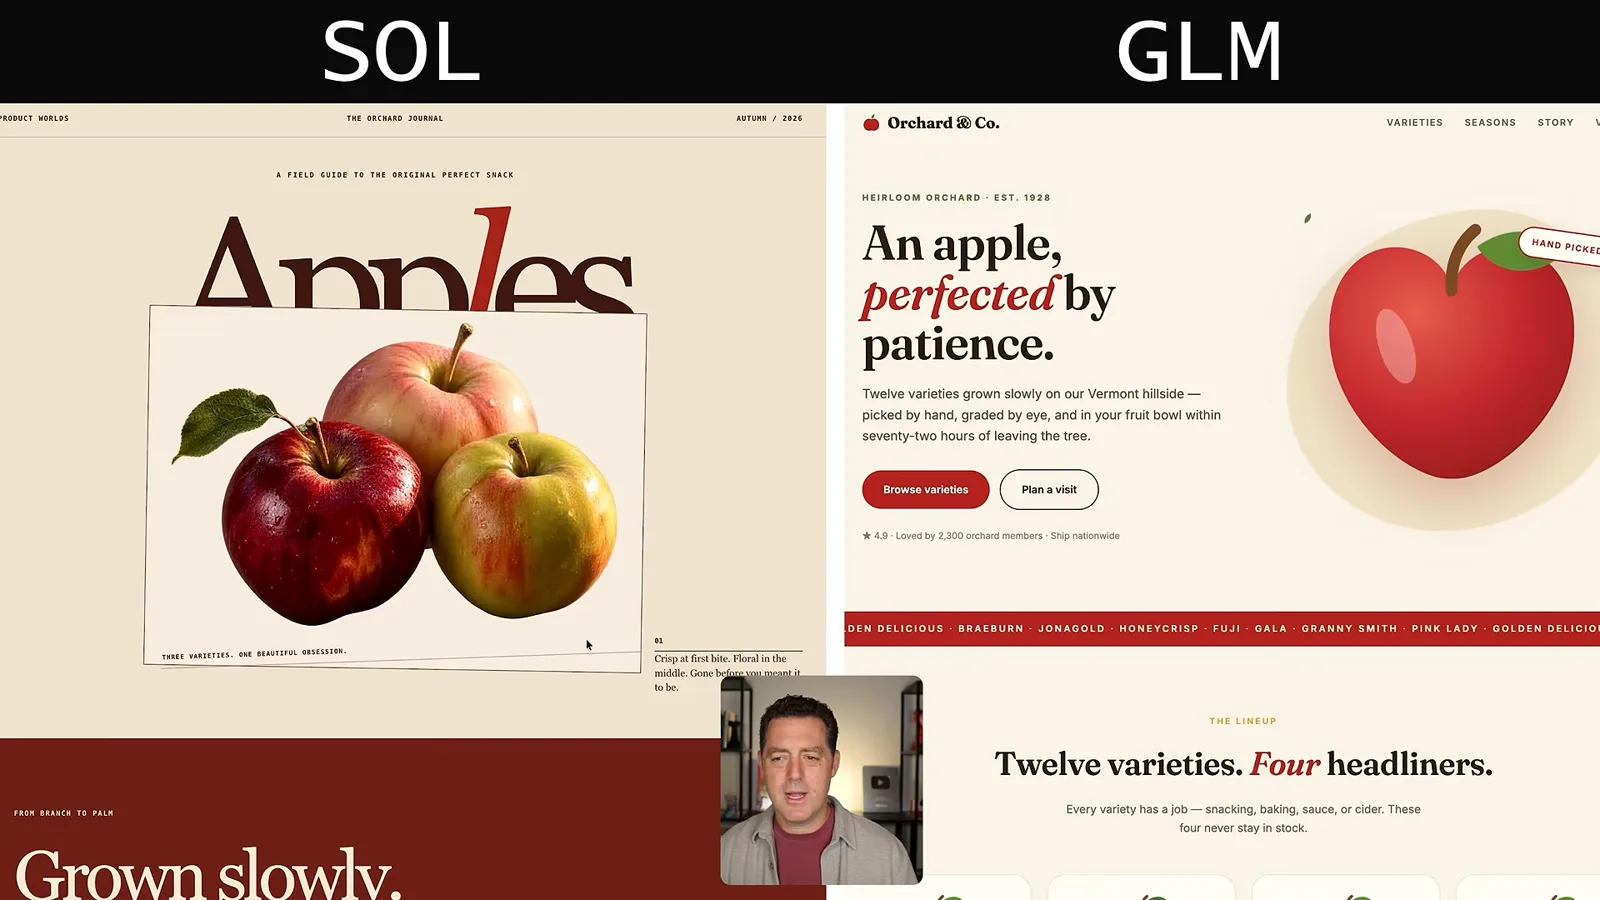
接下来他比较五个网站。在苹果主题页面中,他更喜欢 GLM 的设计;他不喜欢 Sol 版本中大图遮挡文字。他指出,Codex 中的 Sol 可以联网,而他的 OpenCode 配置不能,因此两个环境并不等同。GLM 输出中一个看似合理的地址也促使他检查,但他无法确认那里是否是果园。
对于 NVIDIA DGX Spark 页面,他更喜欢 GLM 的终端式界面,并批评 Sol 虚构的硬件图像。在橡皮鸭页面上,他也认为 GLM 略胜,尽管觉得两种设计都还不错。这些是针对单个样本的主观判断,不能证明页面上的产品细节准确。
对于 Galaxy Z Fold 页面,他认为两个结果都不好,并质疑部分规格的准确性。在 Tesla Model Y 页面上,他批评 GLM 的设计与 Tesla 网站过于相似,车辆插图也不够可信;他没有选出明确赢家。这两个例子说明,即便页面看起来精致,也可能包含误导性或模仿性内容。
数据中心演示文稿
他查看了一份带品牌标识的幻灯片,并称赞其设计。最后他强调了自己看到的开放权重模型的价值。
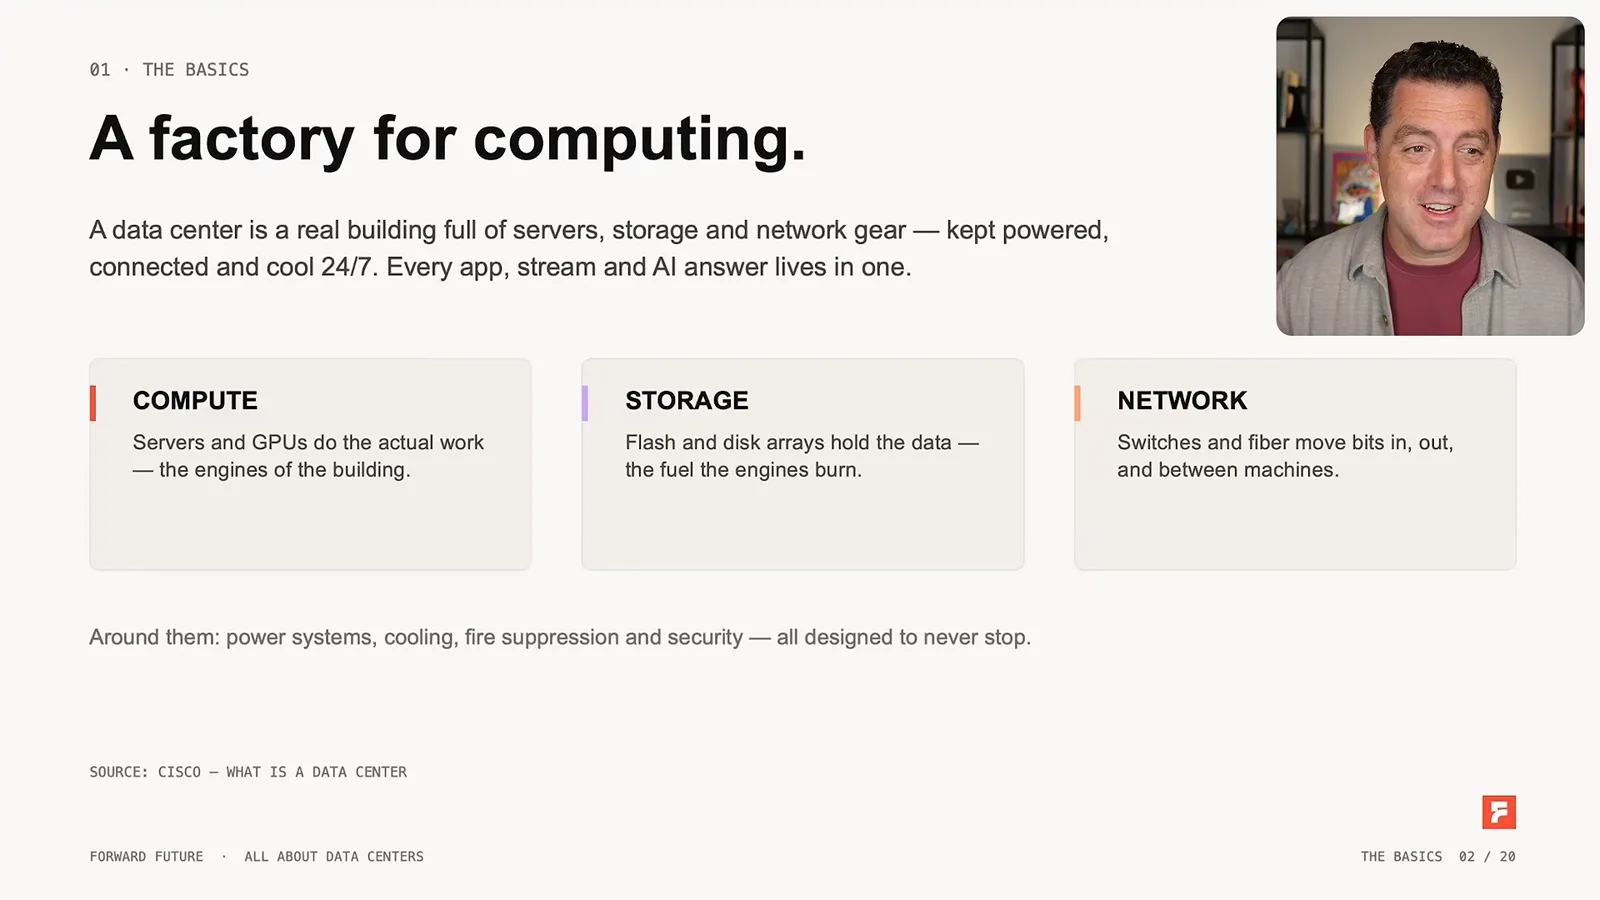
最后,Berman 查看了一份采用 Forward Future 品牌元素、主题为数据中心的 PowerPoint 演示文稿。他说模型获取了该组织的标志和配色,并称赞视觉效果。这个成功案例并不能证明整份文稿的事实都准确。他最后再次表达对开放权重模型的热情,并感谢赞助商 Higgsfield。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。