30 秒看懂
Theo Browne 结合发布材料、第三方评测和亲自试验,评测 Kimi K3。他发现模型在编程和视觉任务上表现强劲,同时也指出用户体验、基础设施和安全方面的顾虑。价格、可用性和计划中的权重发布日期反映 2026 年 7 月录制时的情况。
- 1具备视觉能力的大模型Moonshot 宣布模型拥有 2.8 万亿参数和 100 万 token 上下文窗口,但具体使用受访问条件限制。
- 2基准结果因任务而异在展示的一些编程评测中,K3 接近领先的专有模型;在其他评测中则落后。
- 3长期运行遭遇实际限制Theo 的迁移任务取得相当进展后碰到了上下文上限。
- 43D 游戏中的视觉迭代代理仍在工作时,就已生成可玩的 Fish Slap 原型。
- 5安全能力具有双重用途一次防御性审计给 Theo 留下深刻印象,他同时担忧恶意应用以及发布时缺少安全细节。
- 6访问条件和成本会变视频中的价格、订阅限制和计划中的权重发布时间都是历史快照。
要点建议
- K3 在部分编程和视觉任务上表现强劲,但基准结果随测试而异。
- 即便计算采用稀疏架构,规模极大的开放权重模型仍可能需要大量硬件。
- 长期代理工作流中,上下文限制、运行框架行为和清晰的最终报告都很重要。
- 同一种安全能力既能用于防御也可能遭到滥用,模型发现的问题仍需核实。
- 使用时应查看 API 的当前价格、服务商条款和订阅限额。
按章节阅读整理后的全文
K3 发布
Theo 介绍自己的初步印象和想要测试的问题。
Kimi K3 看起来让开放权重模型迈进了一大步。此前,我觉得开放模型在复杂编程和长期代理任务上远落后于最好的专有模型。花了一天测试 K3 后,我认为它在一些任务上接近前沿水平,但仍有不足。
基准测试只是全貌的一部分,所以我还尝试了真实项目:长期迁移、界面重设计、3D 游戏和安全审计。我也想谈谈成本、可用性,以及未来发布这样一个强大模型的安全影响。
规模、基准与价格
Moonshot 的发布细节和任务级基准展示了规模与成本的取舍。
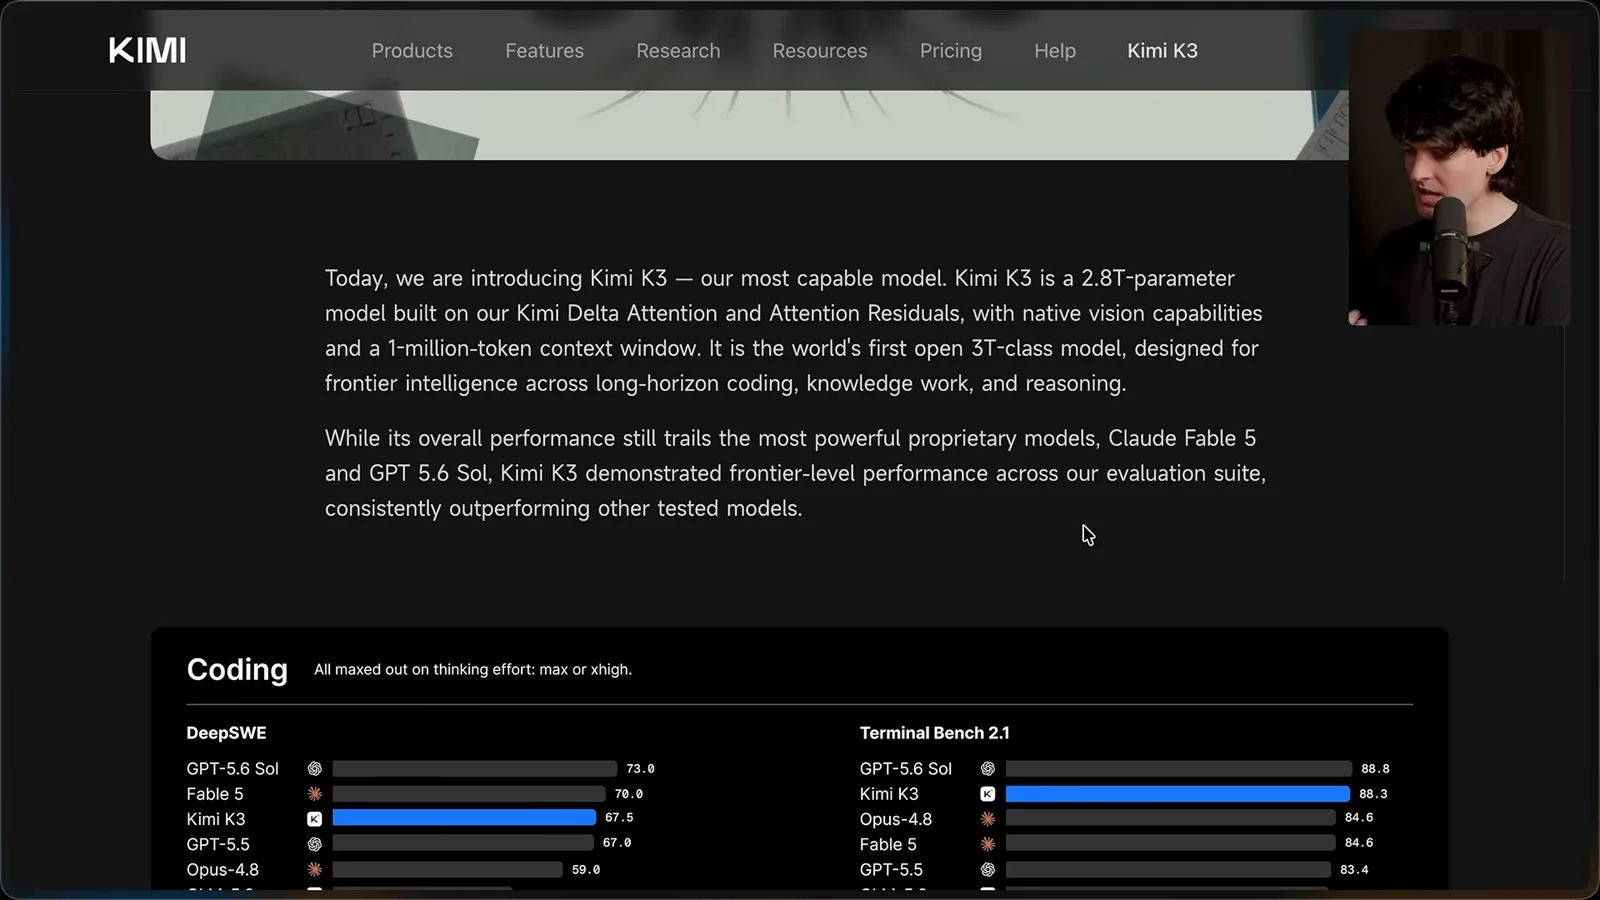
Moonshot 称 K3 拥有 2.8 万亿参数、原生视觉能力和 100 万 token 上下文窗口。后两者都很有用,但我试用的订阅配置并非都提供完整窗口。这些是发布时的信息,可用性可能改变。
模型的规模意味着本地托管完全不同于下载一个小模型。即使每个参数只占 4 位,权重本身也约需 1.4 TB,额外开销另计。录制时 Moonshot 计划 7 月 27 日发布权重,当时还未发布。
在权重和其他部署方式可用之前,调用托管 API 意味着要把数据发送给服务商。是否适合处理自己的代码和数据,应根据服务商实际条款、保留政策和安全控制判断。
Moonshot 的发布图表显示,K3 在 DeepSWE 上得分 67.5,低于 GPT-5.6 Sol 的 73 和 Fable 5 的 70。在 FrontierSWE 上,图中的 K3 位于 Fable 与 Sol 之间。这些只是特定条件下的基准结果,不能保证适用于每个代码库。
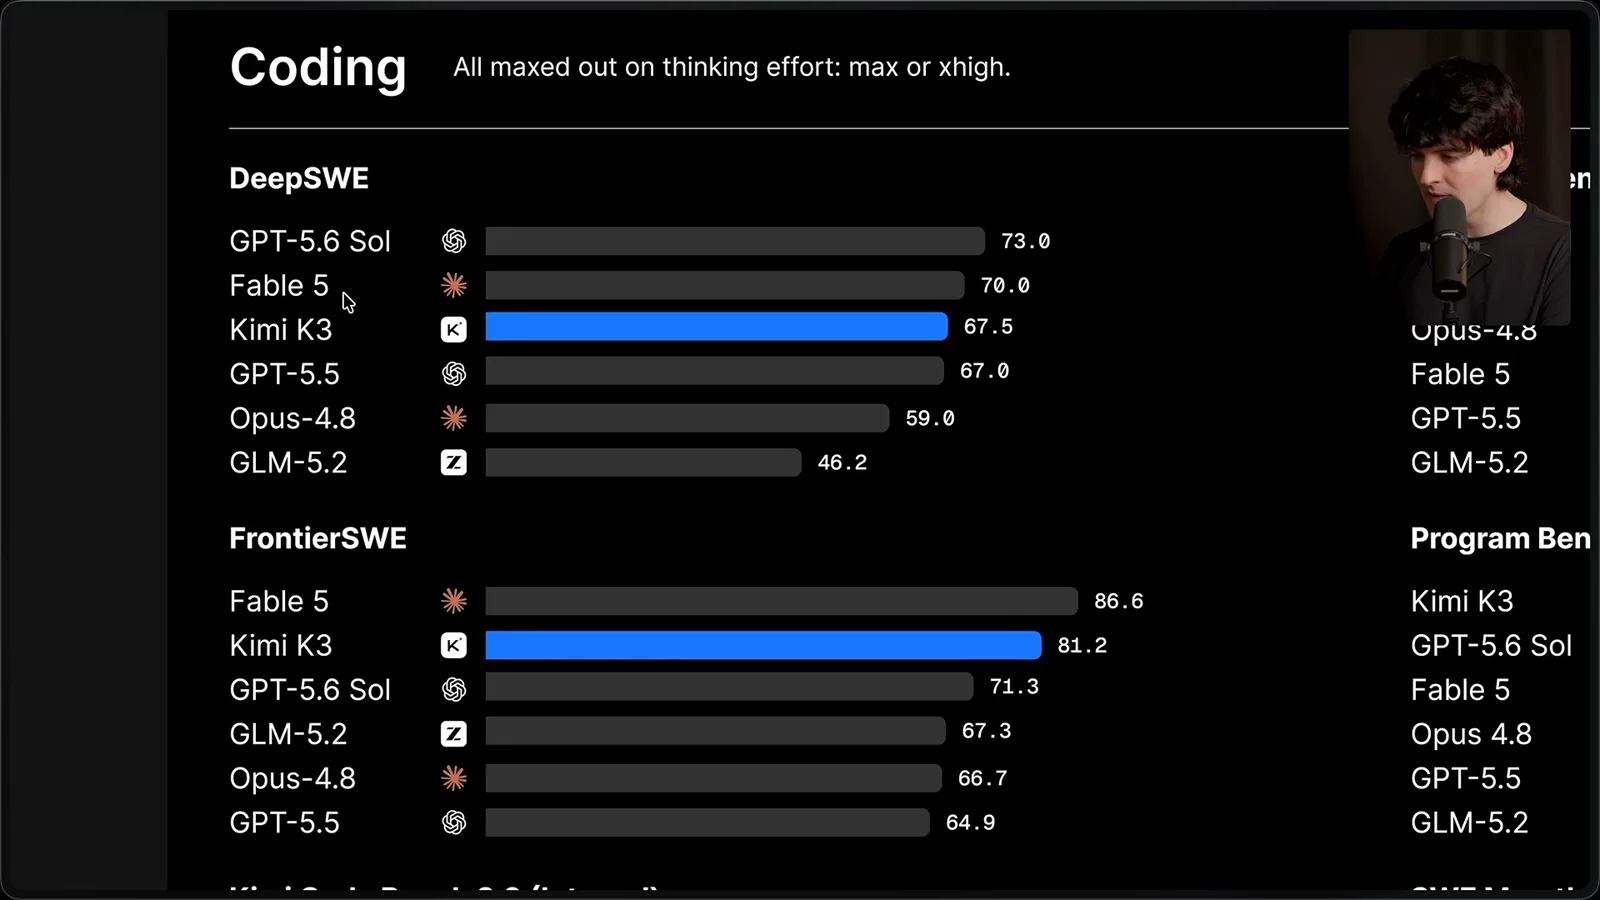
我喜欢 FrontierSWE,因为它试图衡量改动是否适合合并,而不只是能否解决眼前的问题。K3 的结果暗示其代码可能更美观、更易审查,但我不会假设数字差距会直接复现在自己的项目中。
发布材料还展示了 Terminal Bench、Program Bench、SWE Marathon,以及代理和电子表格评测上的强劲结果。我尤其关注 BrowseComp:如果所需硬件能负担得起,浏览器和计算机操作能力未来可能适用于私有部署。
Moonshot 的 BrowseComp 图表比较了得分和每项任务成本,图中 K3 的成本接近 Sol。token 单价并不能说明全部问题:完成任务所用的 token 数同样决定账单和耗时。
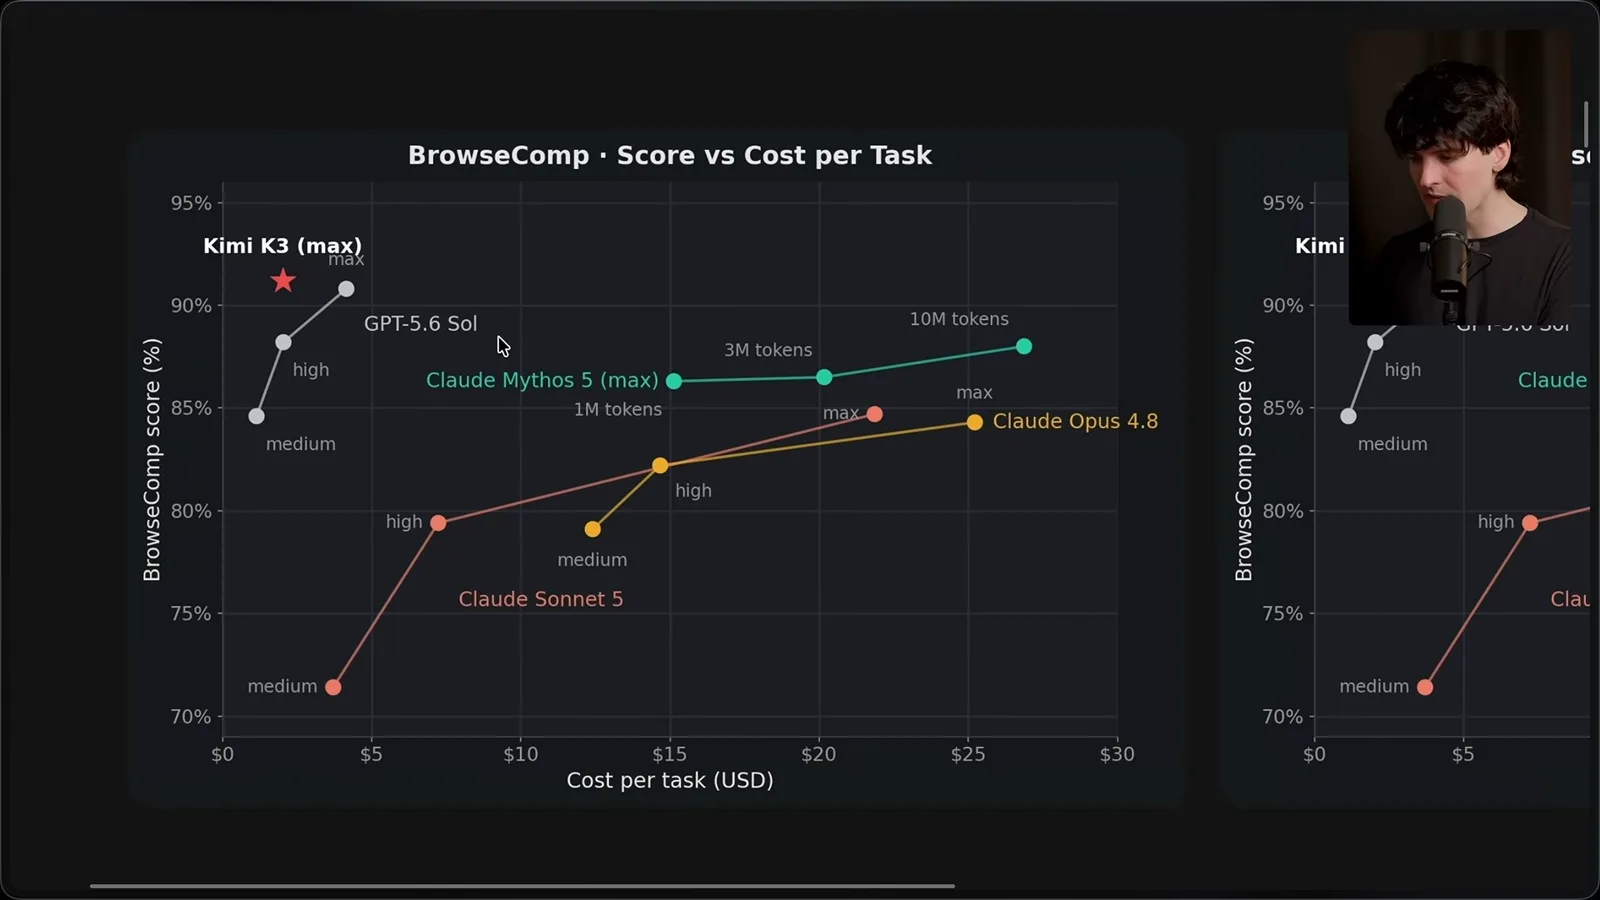
我引用的发布时 API 价格为每百万缓存命中输入 token 0.30 美元、输入 3 美元、输出 15 美元。这些数字以及竞品折扣都是 2026 年 7 月的快照,不是当前价格建议;购买前应比较实际用量和现行条款。
K3 发布时默认使用最高推理强度,较低强度计划稍后推出。Moonshot 也在与推理服务商和维护者协调;架构特殊的模型不一定能让每个服务商轻松、正确地托管。
架构和长期编程任务
稀疏架构与 Theo 的迁移实验同时展示了能力和实际限制。
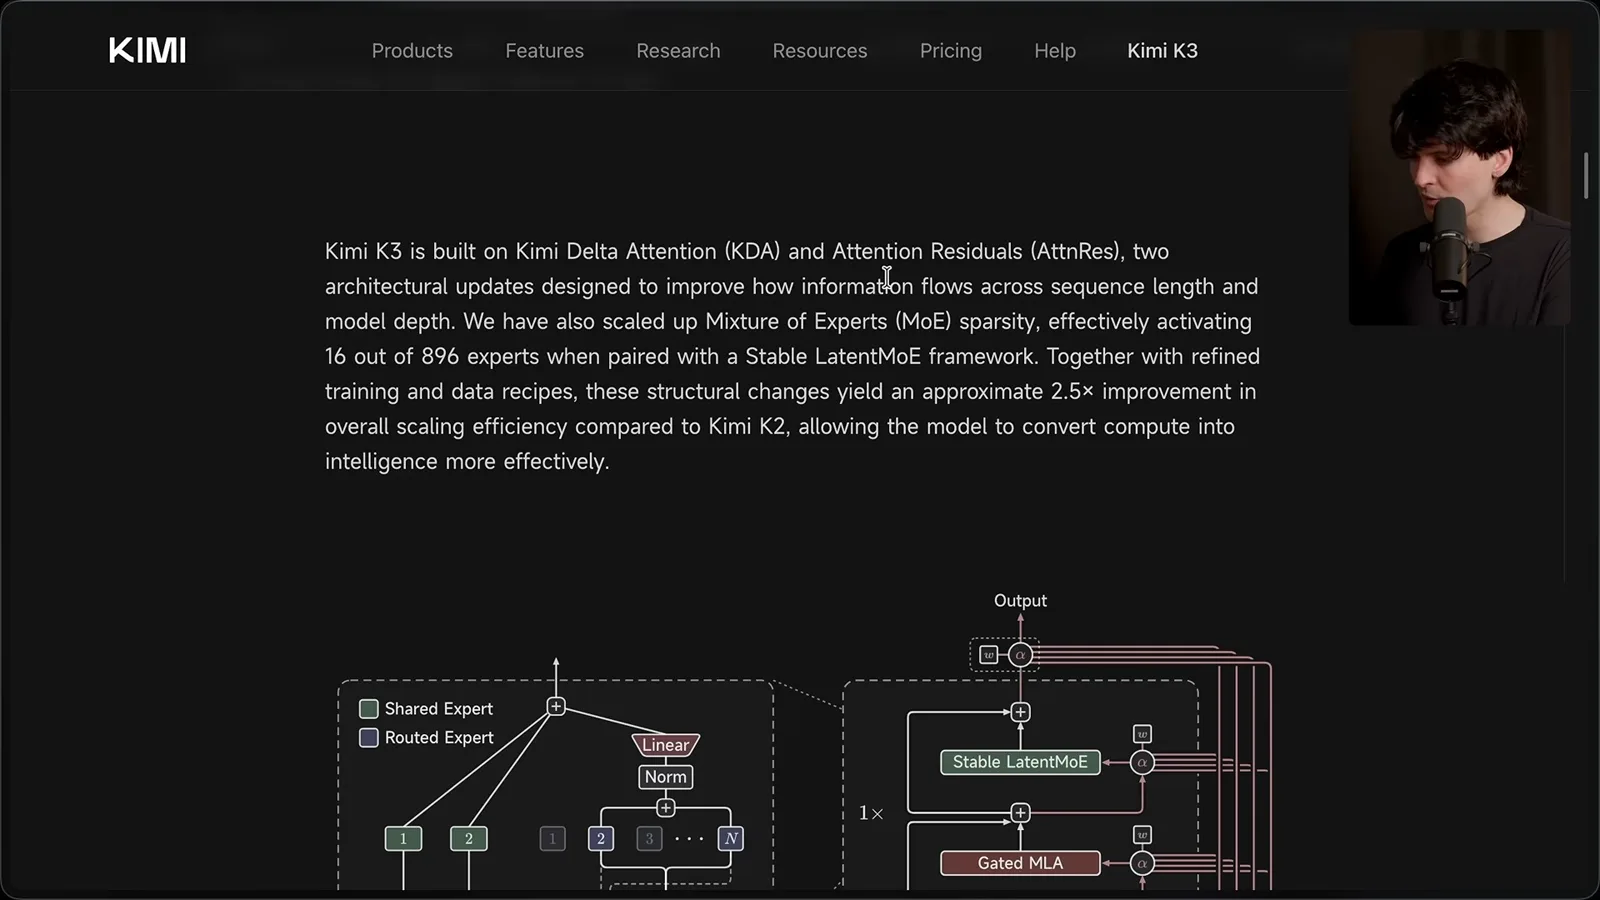
其架构结合 Kimi Delta Attention、Attention Residuals 和稀疏混合专家。Moonshot 称实际激活 896 个专家中的 16 个,整体扩展效率相较 K2 提升约 2.5 倍。稀疏计算并不会消除巨大的内存需求。
为测试长期任务,我让 K3 迁移旧的 ping.gg 代码库。三个多小时后,它根据一段简短提示处理了 122 个任务,却碰到了上下文上限。工作当时仍在进行,不能据此认定迁移已经完成。
这个限制部分是我的失误:订阅和 Claude Code 配置没有提供宣传中的完整上下文。我打算用另一个模型压缩对话后继续。长期任务的表现不仅取决于模型,也取决于运行框架及其限制。
视觉工作与基础设施
内核优化说法、3D 游戏和硬件需求拓宽了讨论范围。
K3 的视觉能力让它在界面工作中很有潜力。Moonshot 还展示了 GPU 内核优化测试,K3 在长时间运行后表现强劲。这些是公司的演示,解读结果时需要考虑具体任务和比较设置。
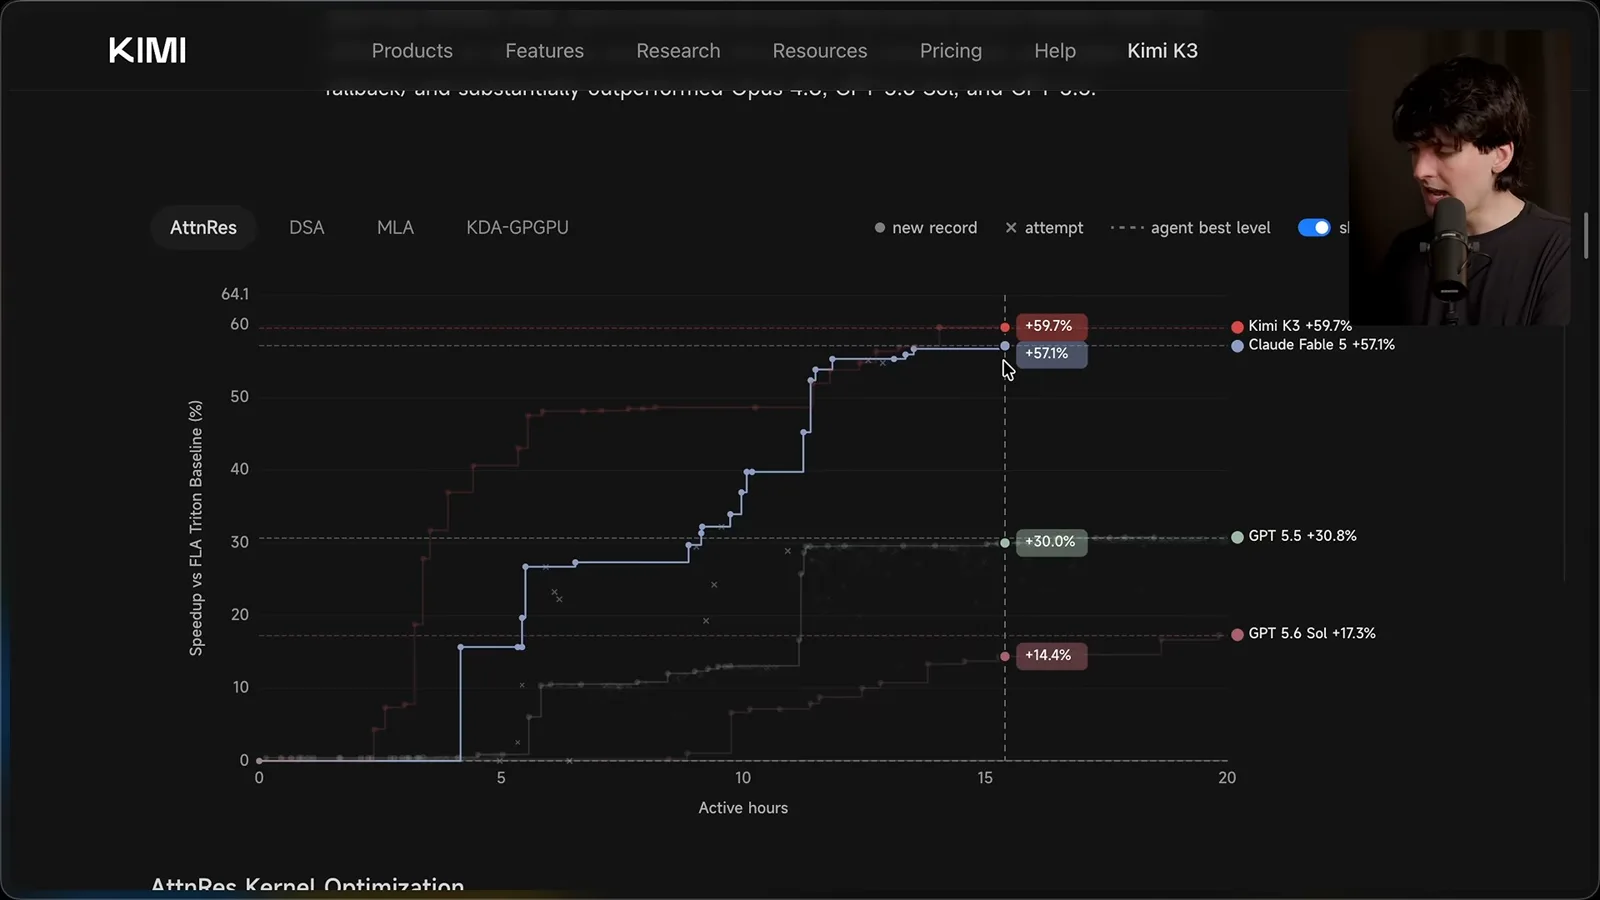
公司表示,早期版本承担了团队的大部分内核优化工作,并介绍了一个类似 Triton 的紧凑编译器。我对这些演示覆盖的范围很感兴趣,但无法仅凭发布页面亲自验证所有技术细节。
在游戏和数字创作中,K3 据称能够在代码与截图之间反复迭代。我在自己的 T3 Code 工作中也观察到类似循环:它运行应用、检查截图,再调整接下来的工作。
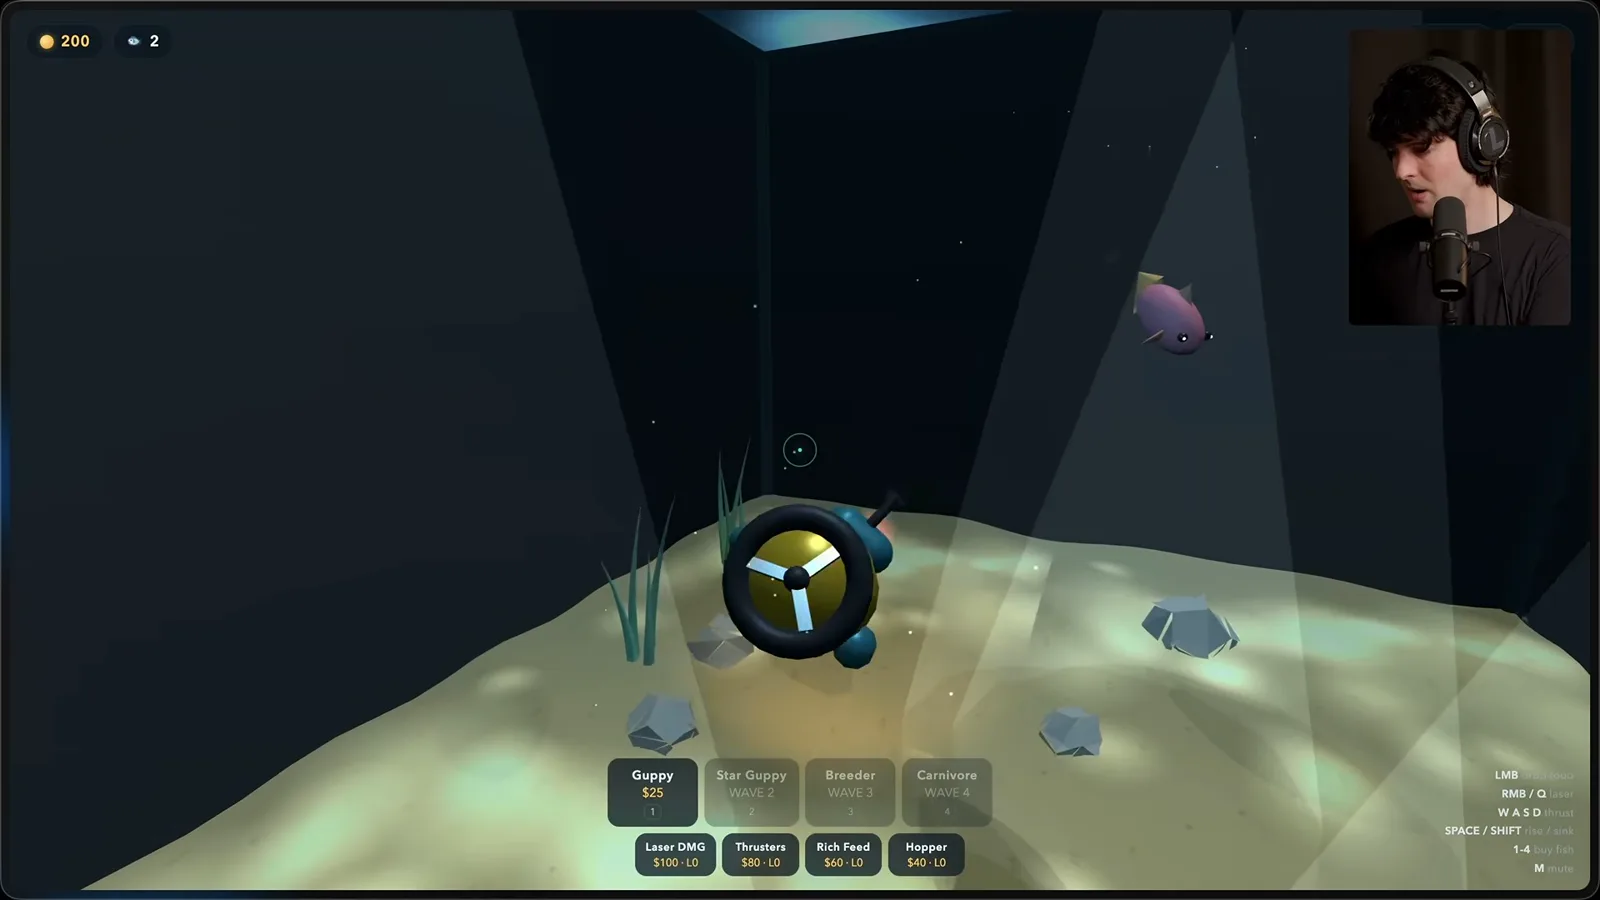
我让它制作 3D 版 Fish Slap。查看进展时,游戏已经可以玩,里面有鱼、潜艇和音效,但模型与游戏仍有问题。代理当时还在继续检查和改进结果。
Moonshot 还展示了芯片设计、研究报告、信息图、仪表盘和视频编辑案例。仪表盘带有明显的 AI 生成风格,但其中一些动画我很喜欢。我没有亲自测试视频编辑方面的说法。
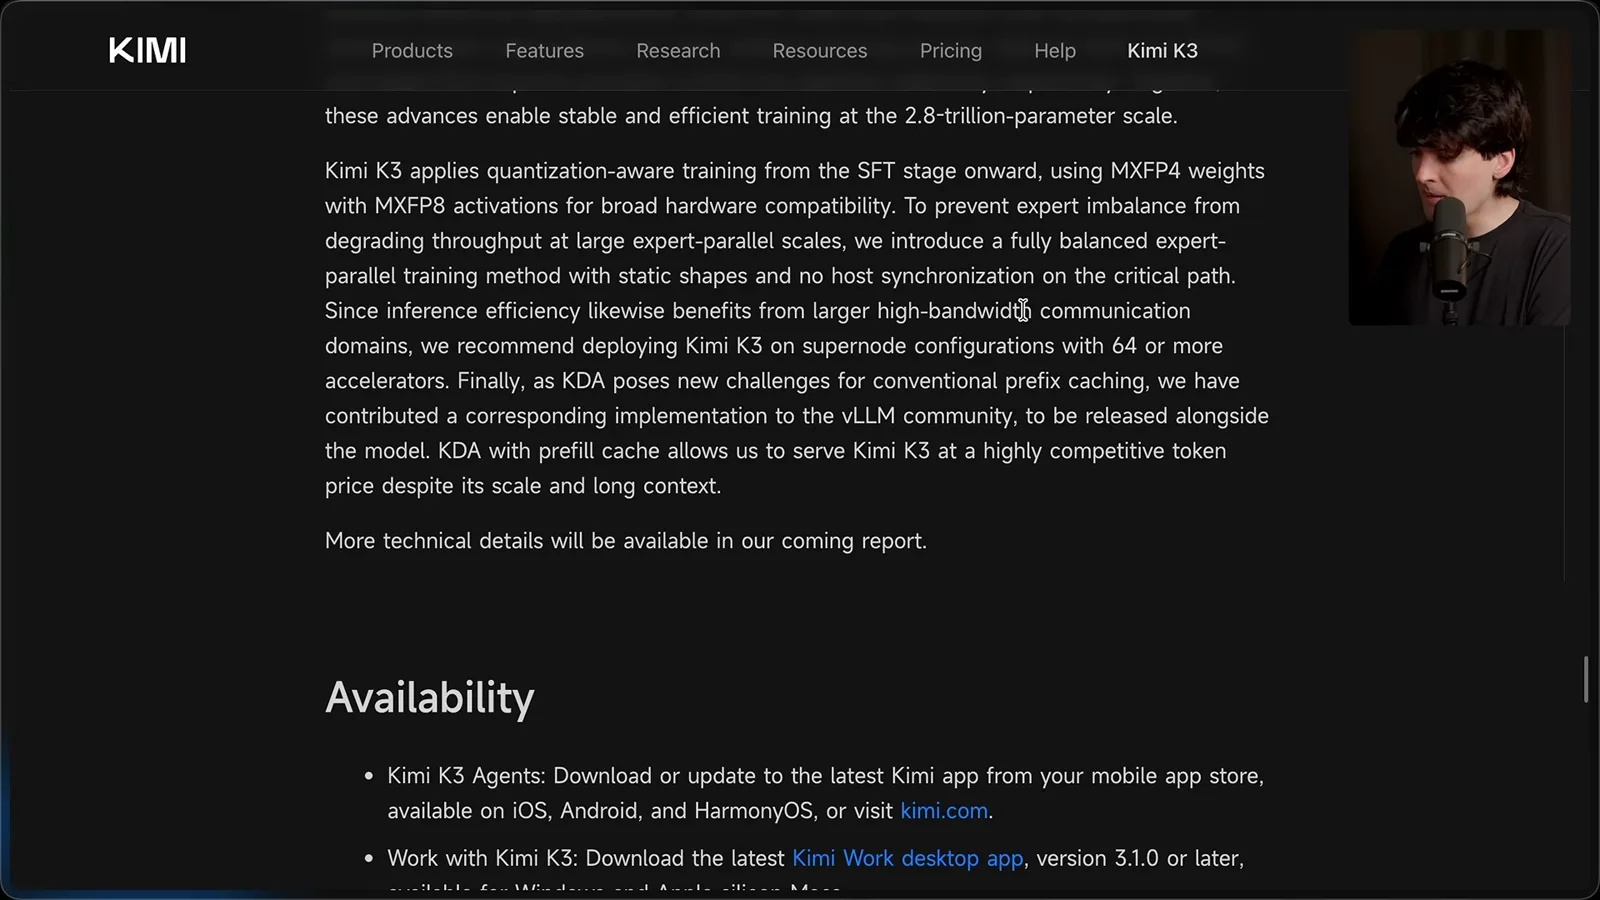
发布页面讨论了 MXFP4 权重和 MXFP8 激活值,并建议用至少 64 个加速器的超级节点高效推理。重点不是每个人都必须使用完全相同的配置,而是运行如此规模的模型仍需要大量基础设施。
独立评测与使用体验
Theo 查看 Artificial Analysis 的结果,以及日常交互中遇到的问题。
Artificial Analysis 报告称 K3 的 Intelligence Index 得分为 57,与 Opus 4.8 和 GPT-5.5 相近,在该评测中落后于 Fable 5 和 Sol。我在视频中也修正了自己对 Grok 排名的说法。排行榜是特定评测的快照,不是永久排名。
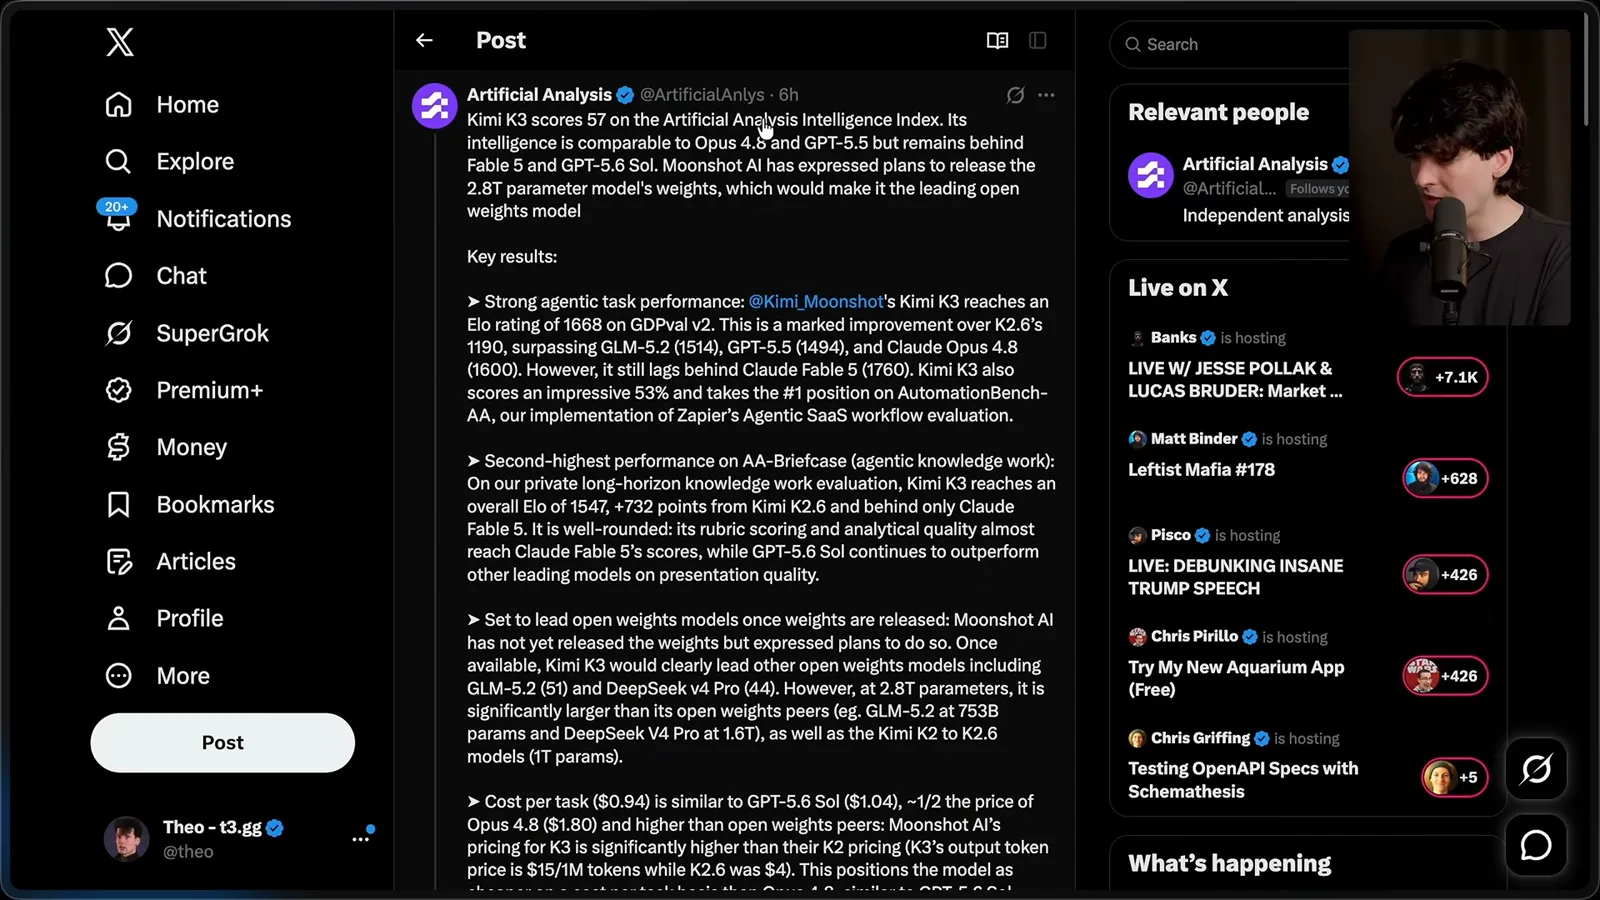
同一分析还强调其代理任务和知识工作表现强劲,并估算该测试中每任务成本接近 Sol。分析同时显示,K3 每任务输出 token 多于 Sol,但少于某些其他模型。成本和 token 效率需要一起考虑。
Omniscience 评测会奖励承认不确定性,并惩罚错误回答。K3 在展示的开放权重模型中得分较好,我认为这是令人鼓舞的信号。但一项幻觉基准得分不能说明任何具体答案都可以不经核查直接接受。
用户体验仍有差距。有时 K3 会回应子代理的状态消息,而不是向我解释完成的工作。Moonshot 自己也提到过于主动、对思考历史敏感等问题;当你整天使用模型时,这些问题很重要。
前端与安全实验
宣传页、侧边栏重设计和防御性审计提供了实际案例。
为了测试前端能力,我让它设计五个不同的 T3 Code 宣传页。其中一个动画不错,但循环标题栏有空白;另一个大量使用常见的终端风格。几个想法有用,不过我不会原样上线。
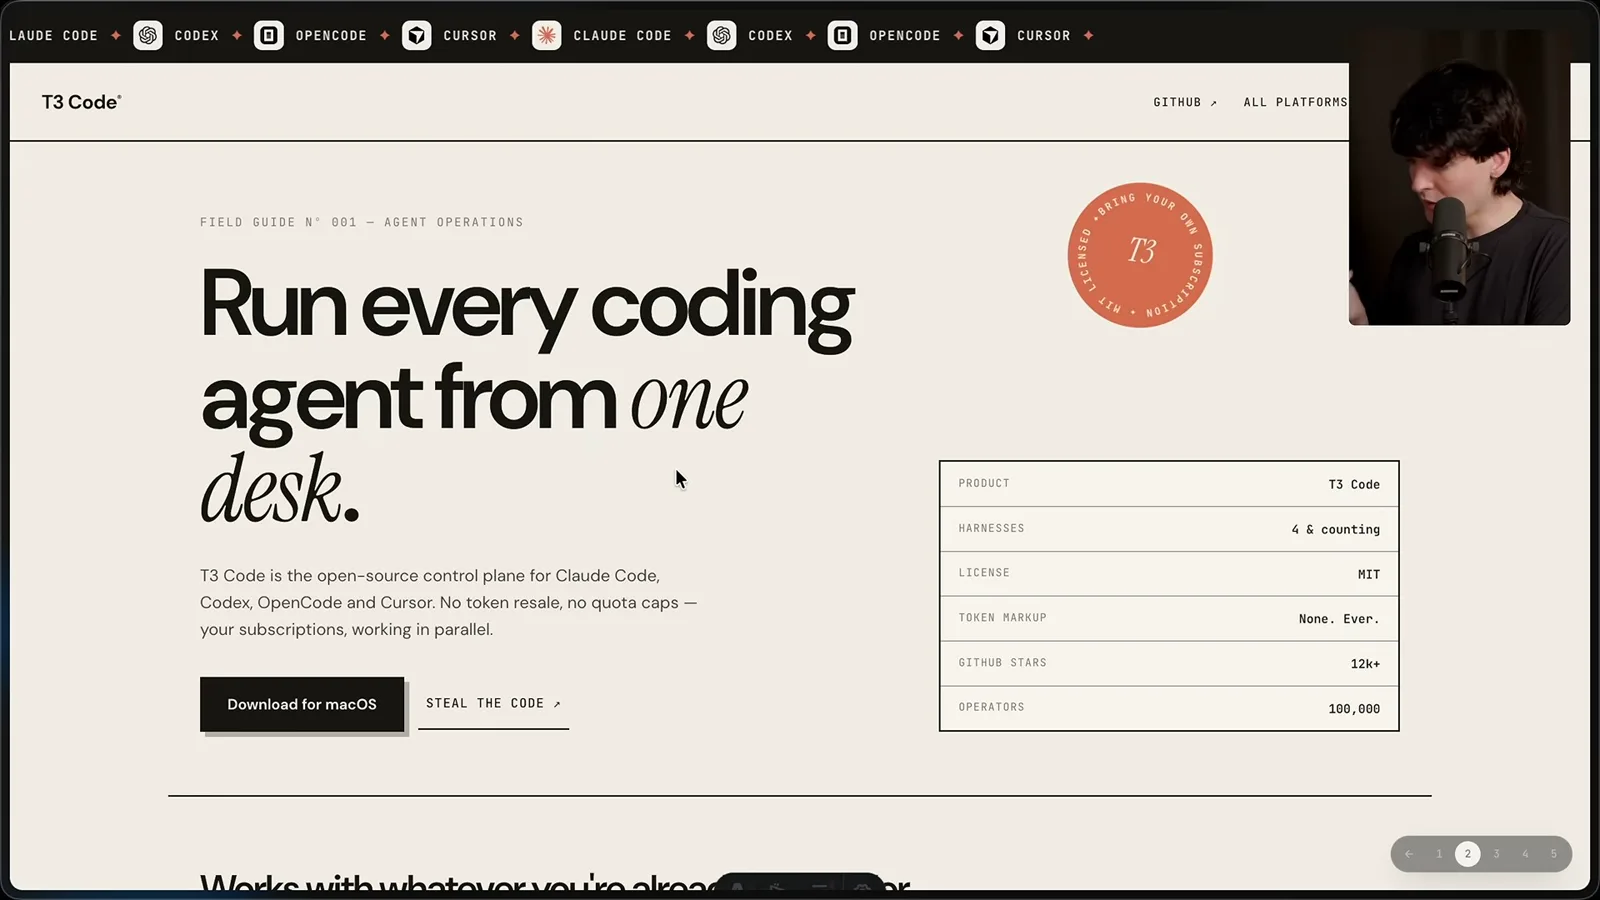
第四个方案用了较克制的光晕,第五个采用 Bento 盒子布局。我的主观第一印象是,这次结果略好于我从 OpenAI 模型得到的方案,但仍不及我对 Claude 的预期。单次宣传页测试毕竟只是很窄的样本。
更实际的测试是 T3 Code 侧边栏。我希望界面采用更暗的黑白风格,并提供截图作为参考。在我看来,K3 的重设计比现有版本更好,这比泛泛的落地页演示更有说服力。
我在 T3 Code 中通过 OpenCode 运行任务。代理花了大约 1 小时 5 分钟,我期间纠正了一次:它反复打开浏览器,消耗了一次性连接令牌。明确这一约束后,它得以检查并继续完善工作。
代理还报告说,清理时误伤了其他开发服务器,并称已将它们重启。我很欣赏它主动说明失误,但报告仍需要核实:模型说自己修好了某件事,并不等于已经独立确认。
随后,我让它为隔离构建准备足够的历史数据以测试界面,再创建附有前后对比图的 pull request。它找到了相关工作流,处理浏览器问题,并在同一个会话中完成了 PR。
另一项测试是对我自己的 Lakebed 项目进行防御性安全审计。模型把发现和验证工作委派出去,其中包括 25 个验证代理;压缩上下文后,它汇总了建议。我觉得反馈有用,但代理审计不能证明系统安全。
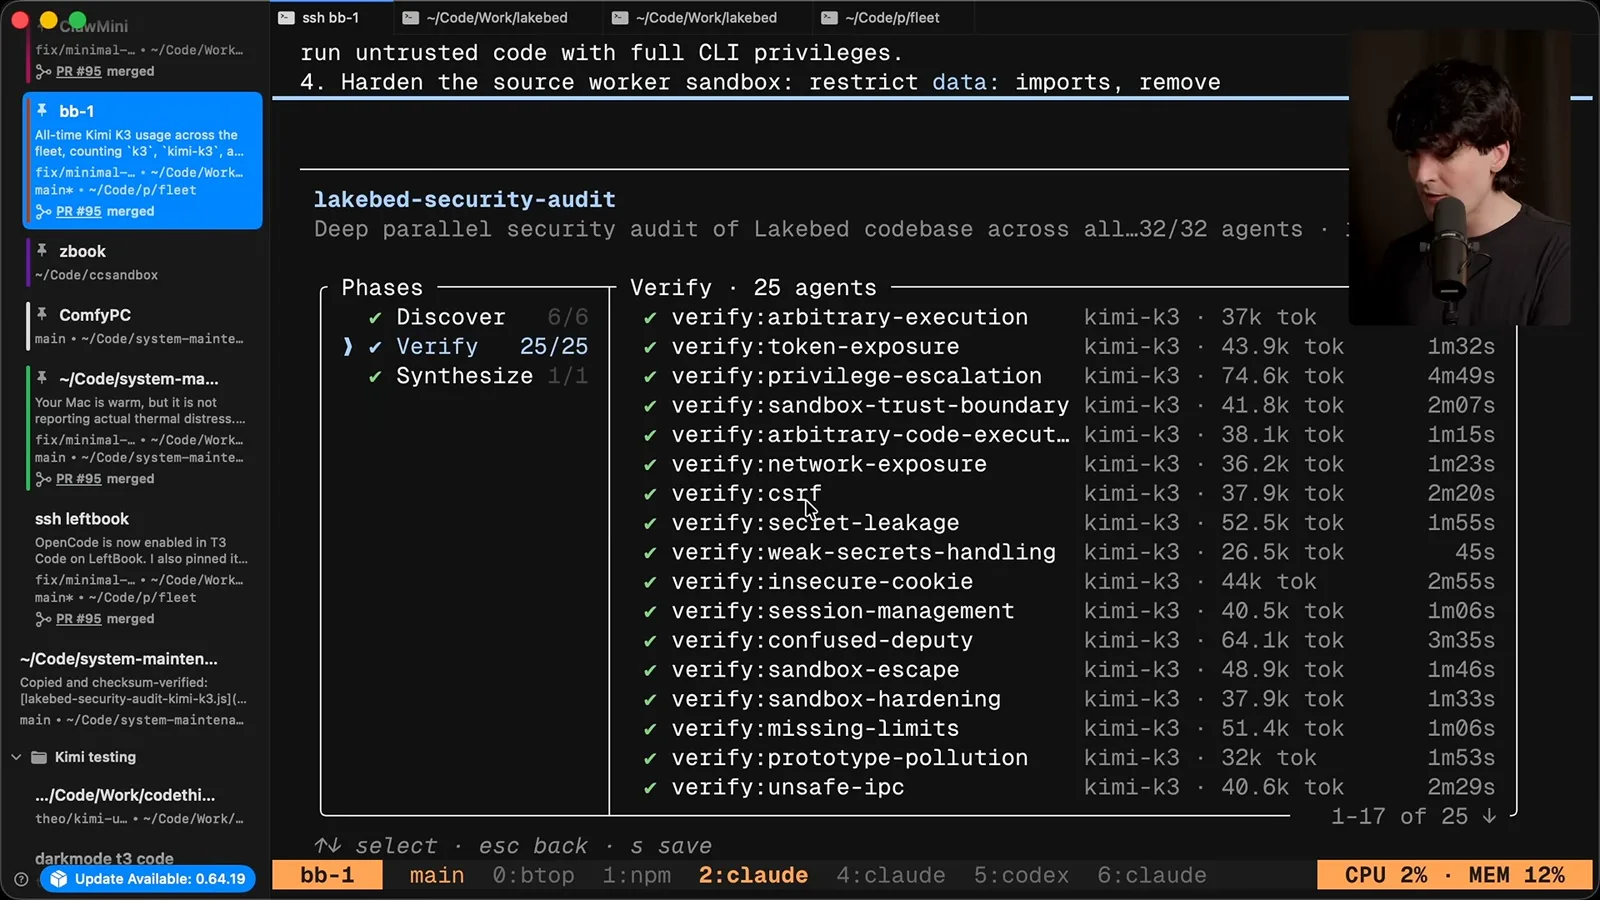
这种能力具有双重用途。开放权重模型既可能帮助防守方检查自己的系统,也可能为恶意使用提供机会。录制时我没有在发布材料里找到系统卡或详细安全信息;因此,我希望看到更多有关风险的证据。
推理、访问与结论
Theo 讨论工作流行为、订阅限制和模型的整体潜力。
可见的推理过程还暴露了一个不足:模型花时间考虑关于 TypeScript `any` 类型的规则是否适用于 Markdown 计划。这只是无效推理的一个小例子,但生成速度较慢时,这种绕路既花时间也花钱。
在另一个长工作流中,它完成了计划,却以一条空闲状态消息收尾,没有给我有用的最终报告。我必须自己发现它停下来了,再继续追问。模型可以做大量工作,却仍然不善于传达结果。
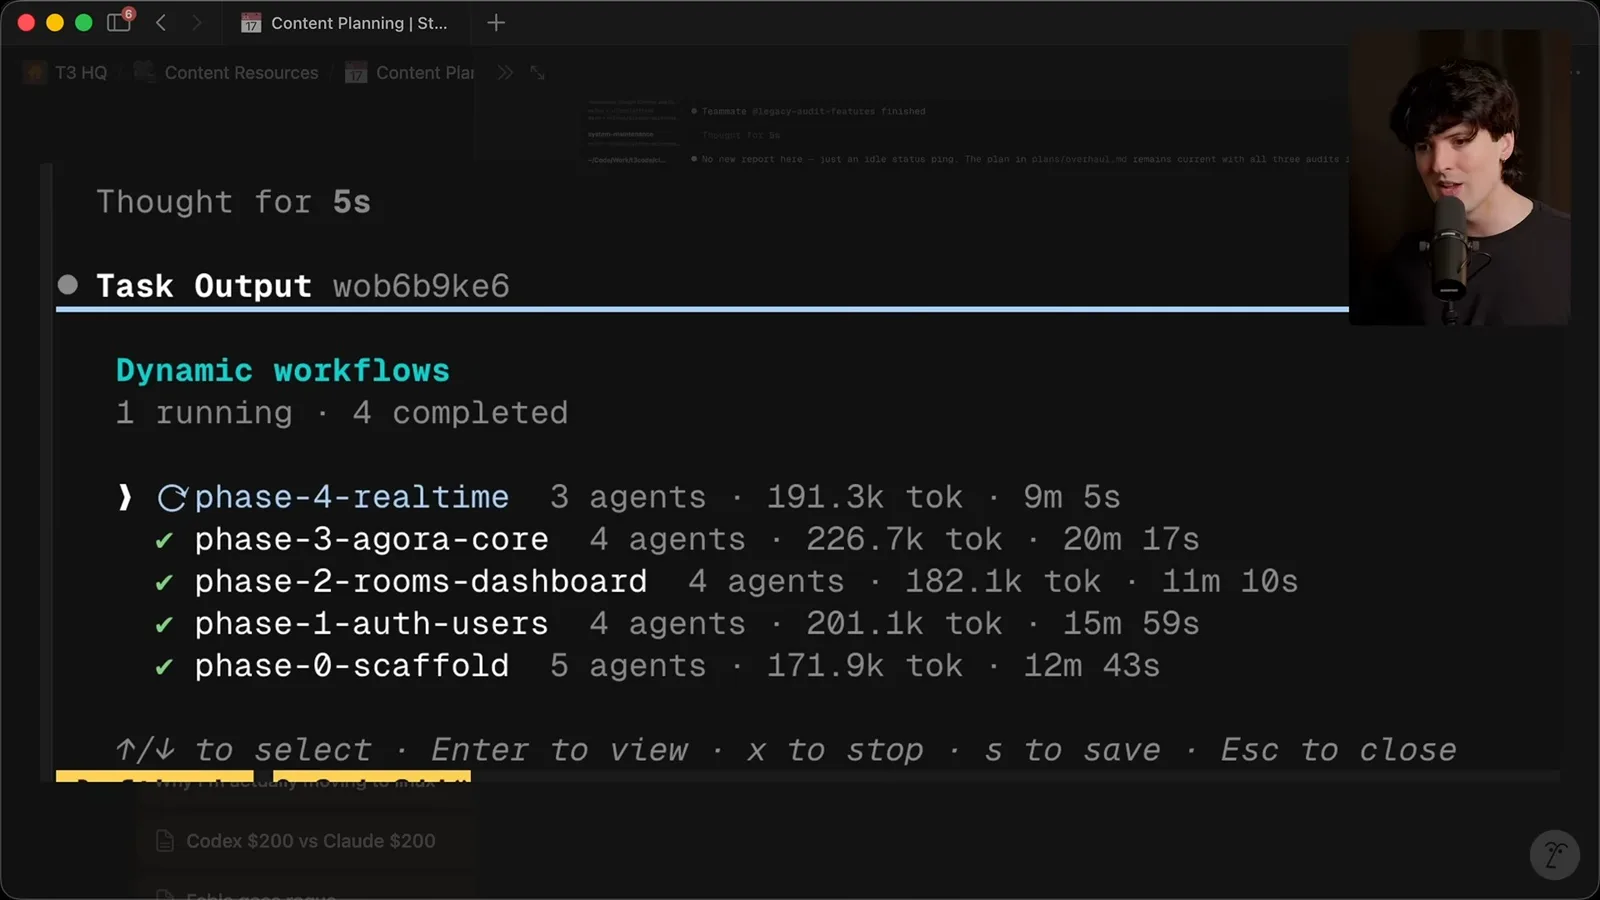
积极的一面是,K3 在迁移中以有趣的方式使用工作流和子代理:它为不同阶段创建工作流,并允许子代理勾选上层任务列表中的项目。我此前使用 Claude Code 时还没见过这种模式。
录制时,在等待计划中的权重发布期间,我可以通过 Moonshot 订阅或 API 使用 K3。如果不了解服务在哪里处理数据以及如何保留数据,我不会把敏感数据交给它;自行托管同样需要安全控制。
我介绍了几个订阅档位,并在早期测试中很快触及 40 美元档位的五小时限额。更高档位让我自己的使用有了更多余量。额度、价格和支持的集成方式会变化,一个重度用户的体验不能保证别人也有同样容量。
在我查看时,订阅与 API 的估算用量价值合计约 63 美元。我觉得这些用量换来了不少有用工作,但这并不是在相同工作负载下与其他模型进行的受控比较。
对于考虑 API 或订阅的人,重要的问题是自己任务的总成本,包括失败运行和审查。我介绍了自己使用的集成方式,但订阅条款和支持的配置应向服务商核实,不能仅凭视频假定。
我不认为大型模型仅因发布权重就会突然变得极便宜,因为基础设施仍然昂贵。托管竞争可能降低价格,但幅度和时间只是预测,并非已知结果。
我的结论是:对于一个计划发布权重的模型,K3 在 3D、视觉工作和编程方面的表现特别令人印象深刻。与我最喜欢的专有模型相比,它的交互还不够成熟,但在足够多的真实任务中已有竞争力,让我期待继续测试。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。