30 秒看懂
Matthew Berman 回顾了 OpenAI deep research 的早期反应,包括研究报告、基准结果和涉及癌症病例的个人经历。他认为,推理与智能体工具结合预示着 AI 可能迅速起飞。 智能起飞与递归自我改进是预测,这些例子尚未证实它们。基准分数和个别医疗经历的适用范围更窄;OpenAI 也承认该工具可能出现事实和来源判断错误。
- 1智能起飞假说Berman 将近期进展与递归自我改进联系起来;所引用的例子并不能证明自主自我改进循环。
- 2推理与工具结合Berman 强调 Ethan Mollick 的观点:推理系统与智能体可以结合起来研究并综合信息。
- 3基准的局限GPQA 图表展示了特定科学题集上的成绩,而不是全面的专业研究能力。
- 4医疗个案需要验证早期用户称赞特定癌症相关报告,但这些病例不是临床研究,不能取代临床医生的审查。
- 5Google 更早的产品Google 员工提到 Gemini 已有 Deep Research 产品;仅凭同名不能证明抄袭。
要点建议
- Deep research 将多步推理与网页研究及其他工具结合起来生成报告。
- 基准进步衡量的是特定测试中的表现,不能证明模型在各方面等同于专家,也不能证明递归自我改进。
- 关于智能即将起飞的说法是预测,而非视频中的例子已证实的结论。
- 对癌症相关报告的正面评价是个案,不是临床验证;治疗决策需要有资质的临床医生审查。
- Google 早已有同名 Deep Research 产品,但这些反应不能证明存在抄袭。
按章节阅读整理后的全文
业界反应与智能起飞论点
Berman 回顾早期反应并预测 AI 将快速进步。所讨论的例子没有展示自主的递归改进循环。
2025 年 2 月,我关注了业界对 OpenAI 新推出的 deep research 的反应。研究人员和评论者介绍了它搜索和综合资料的能力,有些人则认为这是 AI 进步迅速加快的证据。这些反应既有个人体验,也有预测,本身并不能证明通用智能取得了突破。
我引用 Stability AI 创始人 Emad Mostaque 的预测:机器很快就能以更快、更好、更便宜的方式完成大多数数字知识工作。他将其称为智能起飞。这是对未来能力和经济影响的预测,而不是 deep research 发布时测得的结果。
我将这一观点与 Leopold Aschenbrenner 的递归自我改进情景联系起来:AI 发现有用知识,将它用于改进自身,再重复这个过程。我认为我们正在接近这样的情景,但这里讨论的例子并没有展示 AI 自主、持续地改进其后继系统的循环。
我提到 Simon Willison 讨论的一个例子:有人提示模型提出代码优化,据称让一项特定操作的速度提高了一倍。在人类指导下优化单一工作负载很有意思,但它不能证明模型自主提高了自身的整体能力。
科技专栏作家 Kevin Roose 比较了 Humanity’s Last Exam 上报告的分数:在较低的领先成绩出现后不久,deep research 在所引用的配置下达到 26.6%。这些是特定工具和测试条件下的基准结果,不是对全部人类知识的评分,也不能可靠预测智能起飞。
推理模型与研究智能体
他讨论强化学习以及 Ethan Mollick 对研究输出的比较,并解释模型与工具如何协同工作。
我认为 DeepSeek 的 R1 论文让更多人看到了推理模型技术,也强调 Nathan Lambert 的观察:OpenAI 使用浏览和推理任务上的强化学习训练 deep research。我认为推理与工具的结合很重要,但把它描述为已经证实的通用人工智能实现方法,超出了这些例子能证明的范围。
Ethan Mollick 的文章[《搜索的终结,研究的开始》](https://www.oneusefulthing.org/p/the-end-of-search-the-beginning-of)认为,推理系统和自主研究智能体正在融合。他在案例中判断生成报告的质量各不相同。这些是他对具体输出的评价,并不保证每份报告都达到专家工作的水平。
我把模型描述为推理组件,把工具描述为智能体采取行动的途径:它可以搜索网页、编写并执行代码,或查询其他数据来源。两者结合可以生成综合报告,但质量仍取决于来源、任务和模型的解读。
基准与医疗案例
Berman 解读 GPQA 图表并讲述癌症研究的个案经历。这两类证据都有重要局限。
视频展示了一张 GPQA Diamond 图表,将不同时期的模型分数与人类专家参考线进行比较。图表反映了模型在一组特定高难科学问题上的进步。它不能证明模型是通用型博士、能够独立完成所有研究,或在专家的全部工作中超越他们。
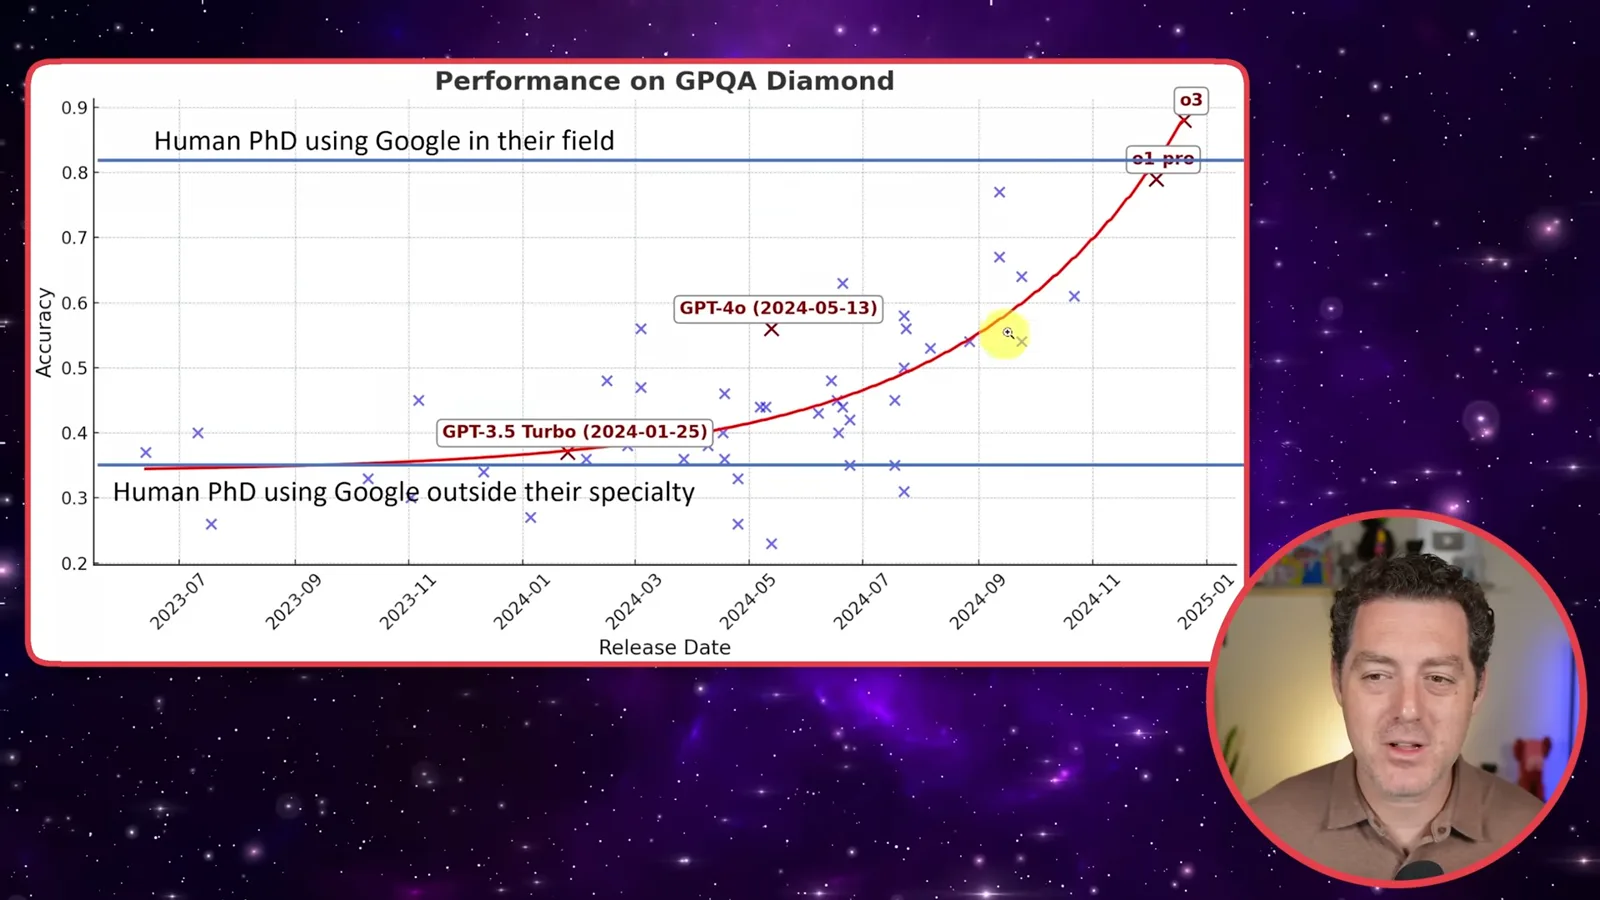
我将这张图解读为硬起飞的证据,并设想许多智能体并行开展 AI 研究、改进自身。这是我的推论。仅凭基准分数上升,不能确定递归自我改进是否存在、速度有多快,或硬起飞是否正在发生。
我提到 Sam Altman 的看法:低成本计算可能为用户创造高得多的价值。这是对潜在价值的说明,而非受控的经济测量。实际价值和成本会随任务、输出质量及所需审查而变化。
生物医学科学家 Derya Unutmaz 介绍了自己早期使用 deep research 的良好体验,并表示两份关于癌症病例的报告令人印象深刻。这是少量个案及他的专业评价,不是临床验证研究,也不能证明医疗建议可靠。
我还讲述了一名 OpenAI 员工的经历:他使用 deep research 调查妻子的乳腺癌治疗问题,并独立核查相关信息。这份报告是信息收集的例子,不能证明应由该工具决定治疗。患者应与有资质的临床医生讨论治疗选择,并核实所引用的来源。
经济主张与业界回应
他讨论 Sam Altman 的估计、Google 更早的产品及一项预期中的公告,背景均为 2025 年 2 月。
在发布会片段中,Altman 估计该系统可以完成具有经济价值的任务中个位数百分比。他明确表示这只是自己的估计。我讨论了其可能的经济规模,但这一百分比并没有通过对整个经济中工作的全面测量得到证实。
Altman 区分了综合现有信息与未来系统创造新知识。我认为这一方向可能带来变革;这一说法是预测,并不能证明产品已经实现自主科学发现或递归自我改进。
Google 员工对发布作出回应,指出 Gemini 此前已经提供名为 Deep Research 的产品。我觉得名称重合很引人注意。这些回应支持此前已有类似名称产品这一事实,但不能证明 OpenAI 复制了 Google 的实现。
最后,我提到 Altman 当时表示,deep research 不是他为 o3-mini 预告的另一项发布内容。这反映的是 2025 年 2 月的产品公告情况,并非关于当前发布计划的说明。
OpenAI 自己的[发布资料](https://cdn.openai.com/API/docs/deep_research_blog.pdf)指出,deep research 可能产生幻觉、作出错误推断,也可能难以区分可靠来源和传闻。这些限制对于医疗及其他高风险研究尤其重要,其中的主张和引用需要独立审查。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。