30 秒看懂
Matthew Berman 回顾 OpenAI 于 2024 年 12 月展示的 o3 预览版所引发的反应。评论者赞叹报告中的 FrontierMath 和 ARC-AGI 结果,同时讨论成本、泛化能力及该系统是否达到 AGI。后续基准信息披露和修订后的成本估算为这些讨论提供了背景;视频包含 Vultr 赞助内容。
- 1FrontierMathOpenAI 声称在一个高难度数学基准的特定版本上取得 25.2% 的成绩;人与模型之间的比较存在局限。
- 2ARC 成绩与算力预览版在半私有评估中,不同算力水平下取得不同成绩。
- 3竞赛规则该奖项使用另一套私有题集,要求提交开源方案,并设有固定算力预算。
- 4一则生物医学轶事Derya Unutmaz 描述了 o1 Pro 提供的评审反馈;这是个人体验。
- 5成本估算57 亿 token 指的是一次高算力运行,而美元估算取决于所采用的假设。
要点建议
- OpenAI 报告称在特定版本的 FrontierMath 上取得 25.2% 的成绩;该基准获得 OpenAI 的资助,OpenAI 根据已披露的安排享有访问权。
- 2024 年预览版在不同算力设置下,分别取得 ARC 半私有评估 75.7% 和 87.5% 的成绩。
- 高算力成绩没有满足另一项开源 ARC Prize 竞赛的规则,也没有证明 AGI 已经实现。
- 该基准测试的成本估算取决于定价假设,后来经过修订。
- 一位科学家对论文反馈的积极体验涉及 o1 Pro,并非对 o3 的受控评估。
按章节阅读整理后的全文
FrontierMath 与最初的反应
Berman 综述对 o3 预览版的早期反应。数学成绩及其与人类的比较都需要结合具体基准背景理解。
OpenAI 在 2024 年 12 月展示的 o3 预览版取得了引人注目的基准成绩,也引发了各种反应。我收集了研究人员、企业家和评论者的看法,从对数学表现的热情,到对成本和可靠性的警告。这些反应针对的是当时评估的预览版;ARC Prize 后来表示,2025 年 4 月公开发布的 o3 与其测试的系统并不相同。
Balaji Srinivasan 关注的是 FrontierMath,这是一组具有挑战性的数学题。OpenAI 声称取得 25.2% 的成绩,而此前模型的得分要低得多。这是一项报告中的基准结果,并不能证明 o3 可以解决所有研究数学问题的 25%,或超过每一位数学家。
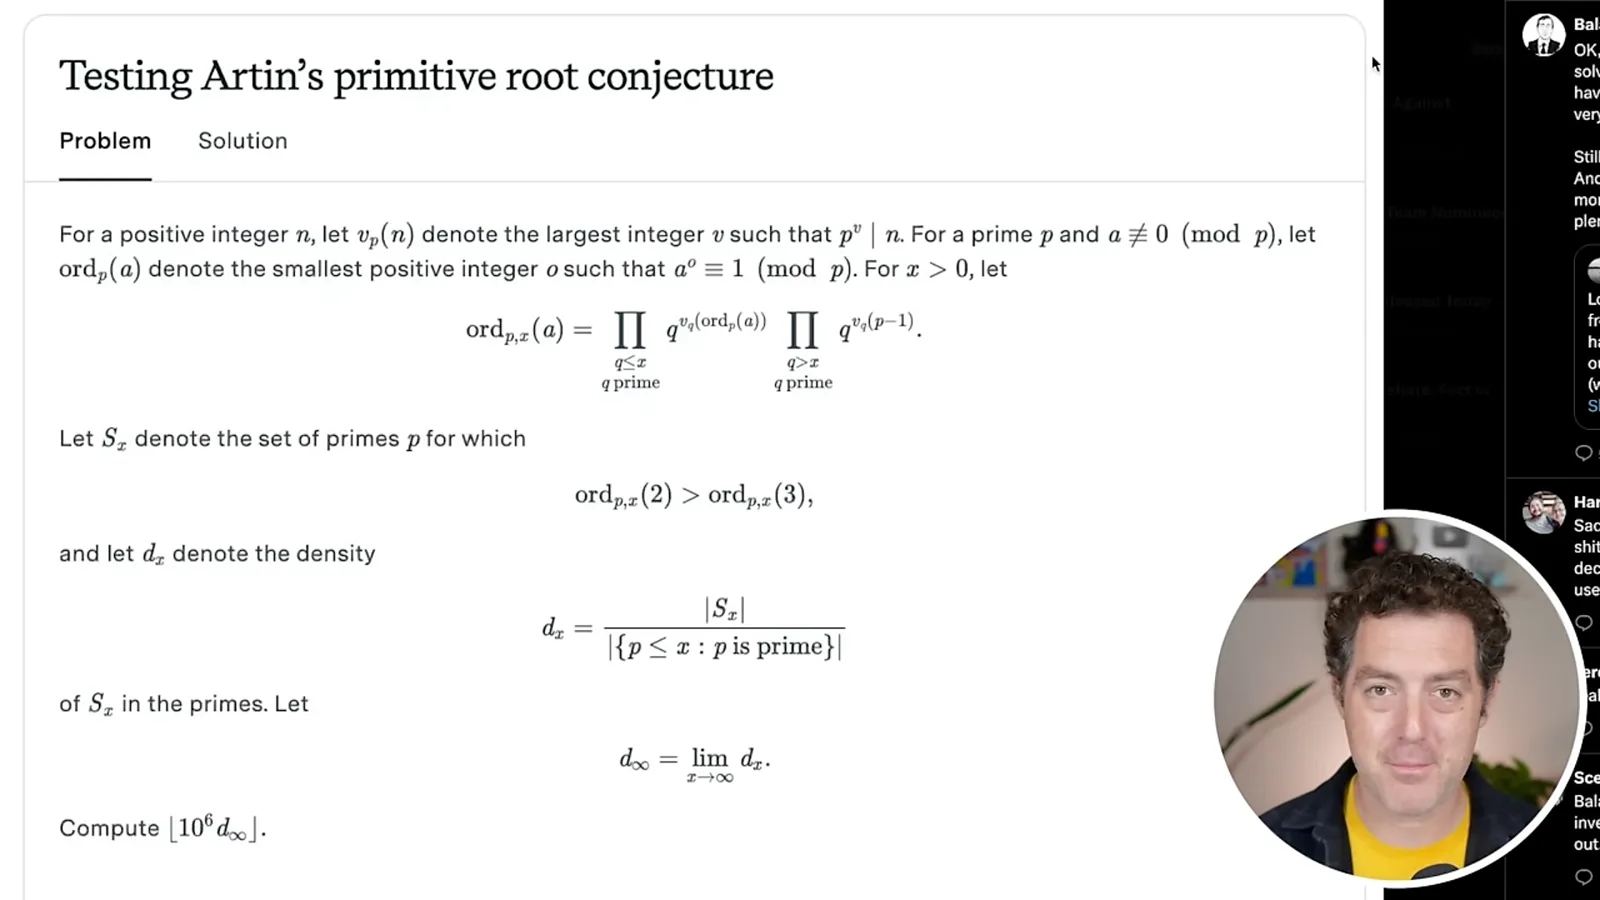
画面展示的示例题涉及数论,FrontierMath 的创建者表示,许多题目需要专家花费数小时或数天解决。我觉得这一成绩很了不起。不同题目的难度各异,视频也没有证明某位具体的人类专家能够解决多少道题。
Srinivasan 还提到了 ARC 和编程竞赛。这些数字反映的是特定基准和测试条件下的表现,并非在所有人类程序员中的通用排名,也不是一场直接对决。这类比较的价值取决于任务、规则、工具和评估方法。
数学家陶哲轩和 Timothy Gowers 曾将他们审阅过的 FrontierMath 题目形容为极具挑战性。这些评论针对的是他们看过的题目,并不能证明没有数学家能够解决整套基准中 25% 的题目。视频中更宽泛的比较属于推测。
算力与 ARC-AGI
Mollick 和 Chollet 讨论测试时计算与 ARC 成绩。半私有评估不同于开源奖项竞赛。
Ethan Mollick 将增加推理时计算比作 Douglas Adams 作品中的虚构超级计算机:困难问题可能需要更多时间,也需要提出正确的问题。这个类比突出了潜力和成本,并不能证明更多计算总能得出正确答案。
视频包含云计算提供商 Vultr 的赞助环节。其中有关可用性、性能和价格的说法来自赞助商。
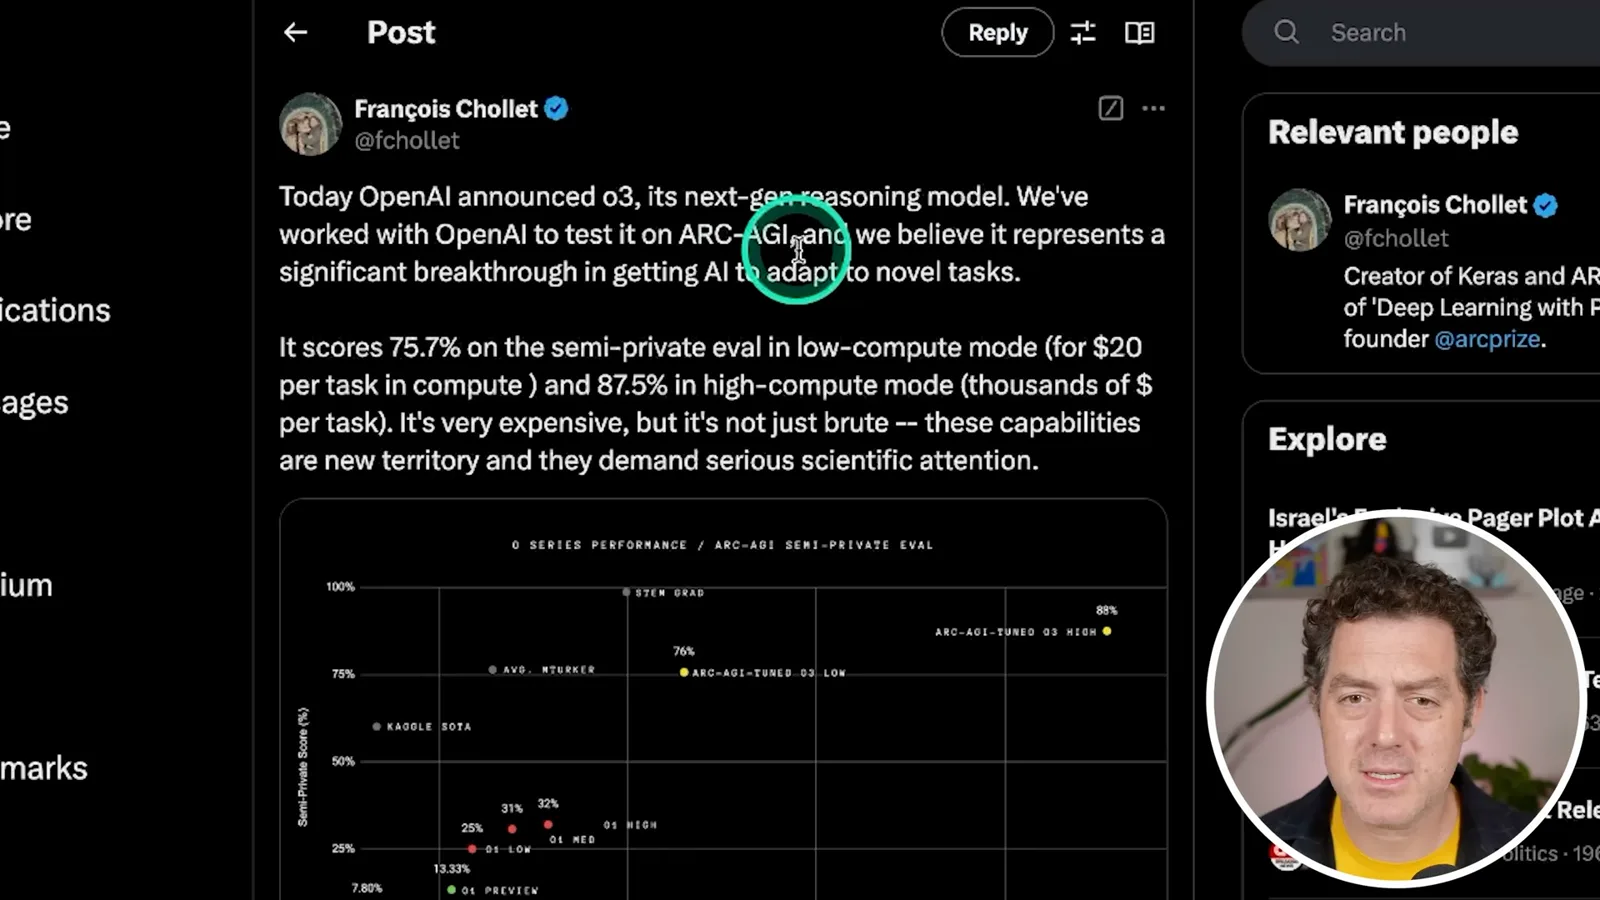
ARC 创建者 François Chollet 报告称,o3 在 ARC-AGI-1 半私有评估中,较低算力配置取得 75.7%,高得多的算力配置取得 87.5%。ARC Prize 表示,测试系统曾使用部分公开训练集进行训练。这些成绩衡量的是该评估设置下的表现,而非通往 AGI 的通用进度百分比。
Chollet 称这一结果是在适应新任务方面取得的重要进展,同时指出其成本高昂。我认为成本可能随时间改善;这是一种预测。随着定价假设变化,ARC Prize 后来修订了零售成本估算,因此视频中粗略的美元数字不是最终账单,也不是当前价格。
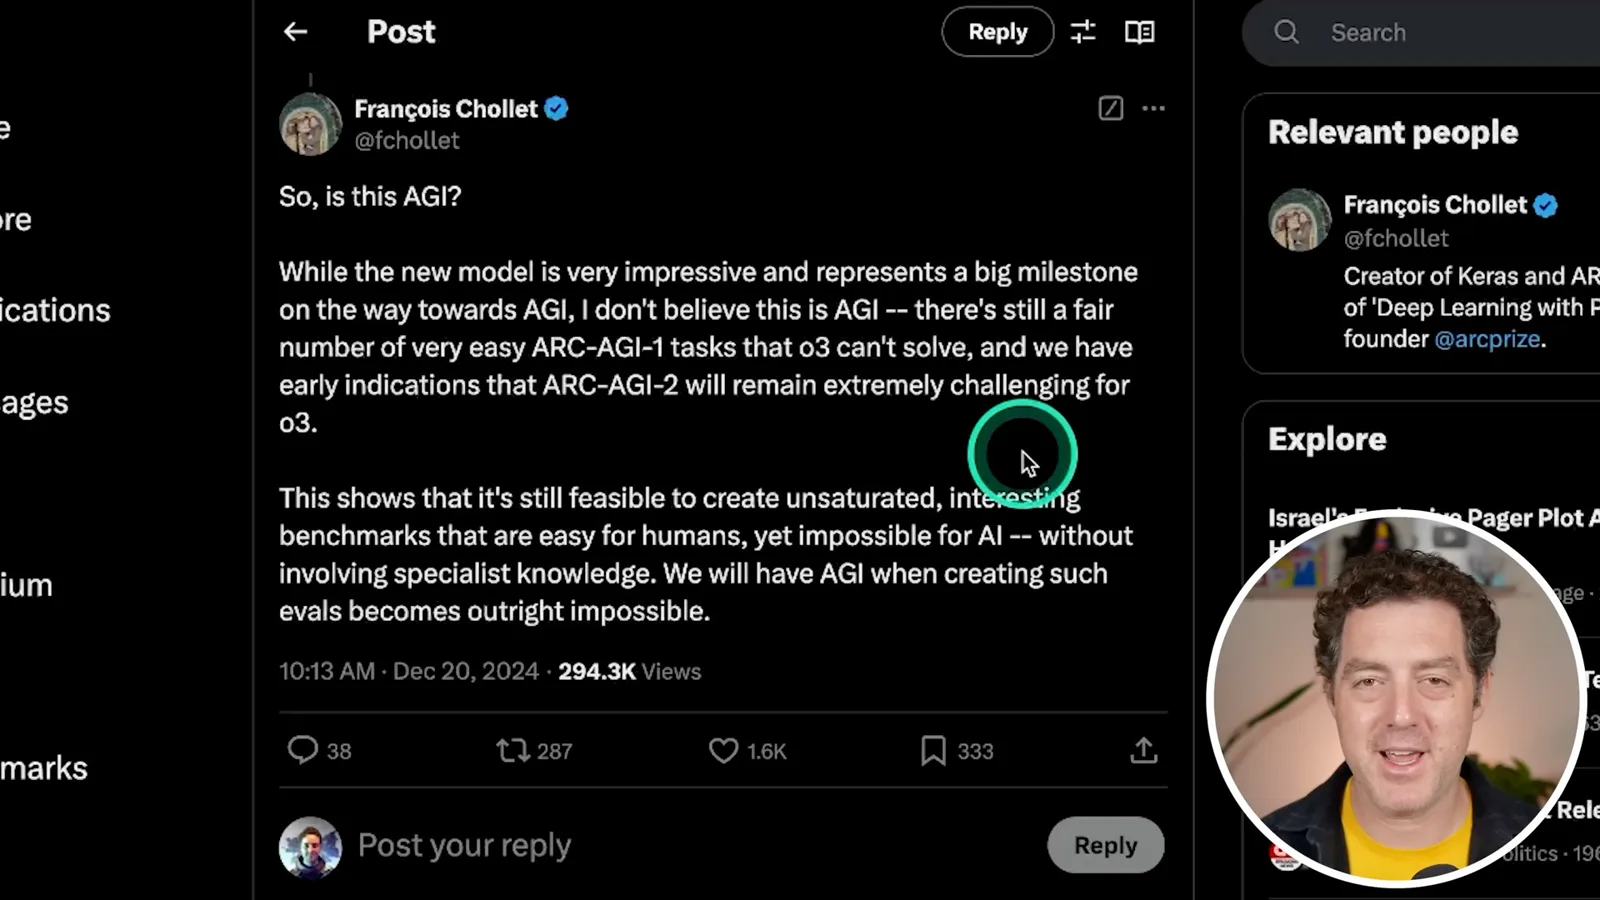
Chollet 不认为这一结果就是 AGI:模型仍无法解决一些看似简单的 ARC 任务。某项竞赛的 85% 门槛是获奖条件,并非公认的 AGI 定义。视频推测了他的动机,但没有证据表明这些因素决定了他的判断。
ARC Prize 竞赛有另一套规则:完全私有的题集、开源提交方案和固定算力预算,视频称每道题预算为 10 美分。高算力半私有评估的成绩本身并不能赢得该竞赛。比较成绩时,基准版本、访问权限和预算都很重要。
失败案例与科学界反应
Berman 展示了一道模型未能解决的网格题,并转述有关经济变化和生物学的评论。生物医学轶事涉及 o1 Pro,而非 o3 的临床研究。
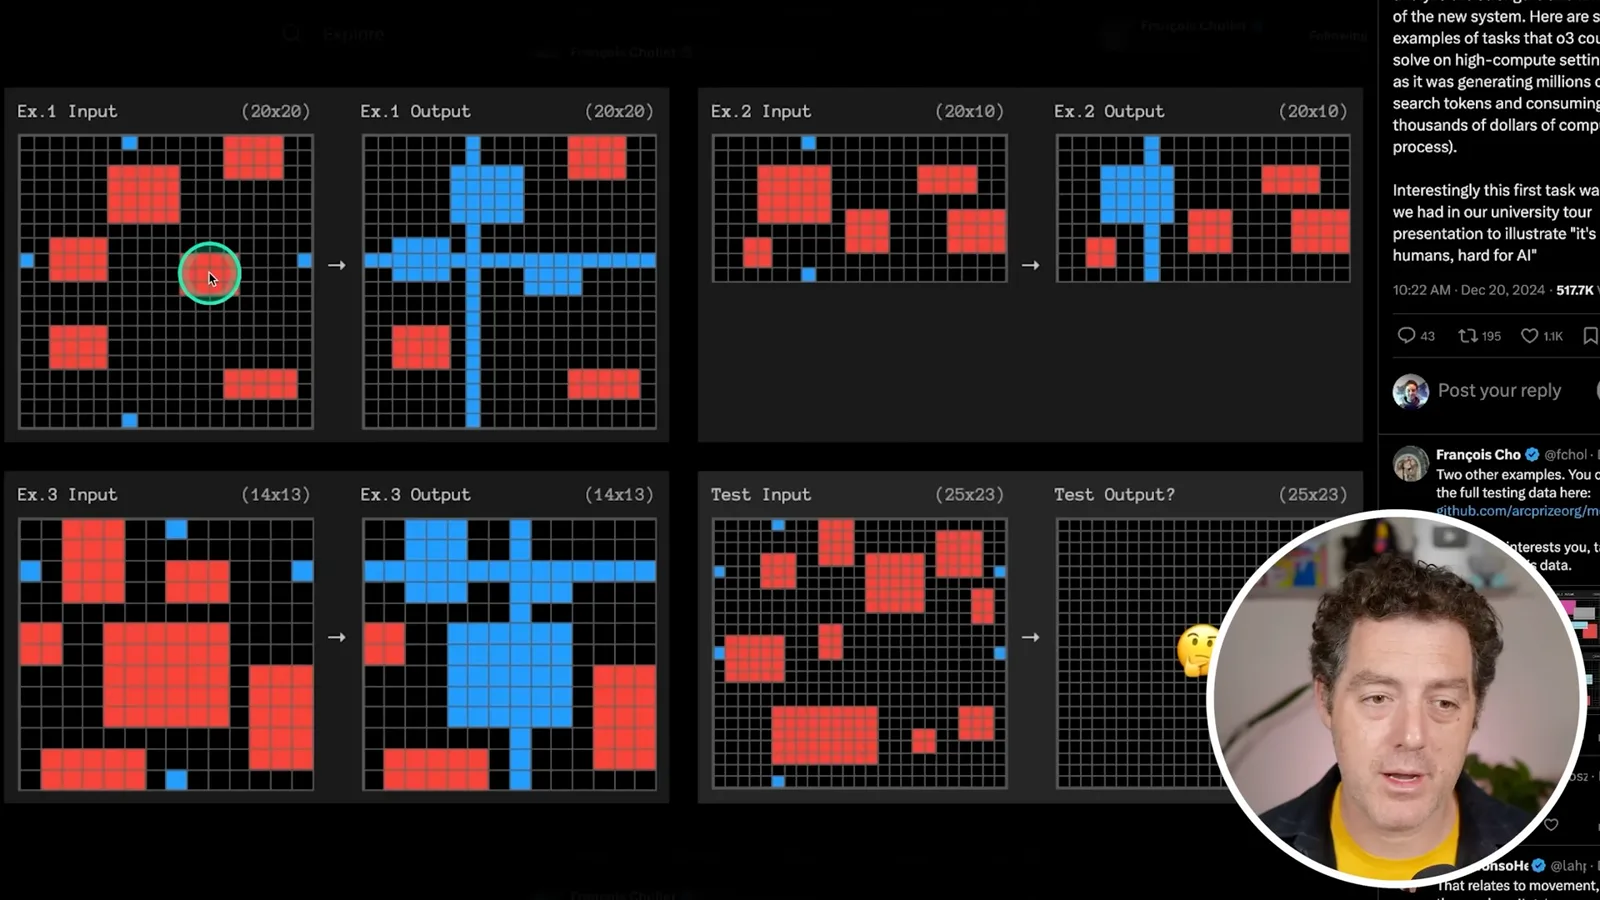
o3 未能解决的一个示例在网格中展示了红色图形和蓝色标记。我从蓝色标记推断出一个十字,与其相交的红色图形会变蓝。我觉得这道题很简单,但个人反应并非衡量所有人解决难易程度的受控实验。
OpenAI 研究人员 Steven Heidel 使用类似 AGI 的说法描述这一时刻,而 Emad Mostaque 预测,随着 AI 以更低成本完成电脑上的工作,经济将遭受重大冲击。这些是反应和预测,并非已经确定的结论。我提出宣布 AGI 会自动终止与 Microsoft 的协议,但画面所示信息不能支持这一说法。
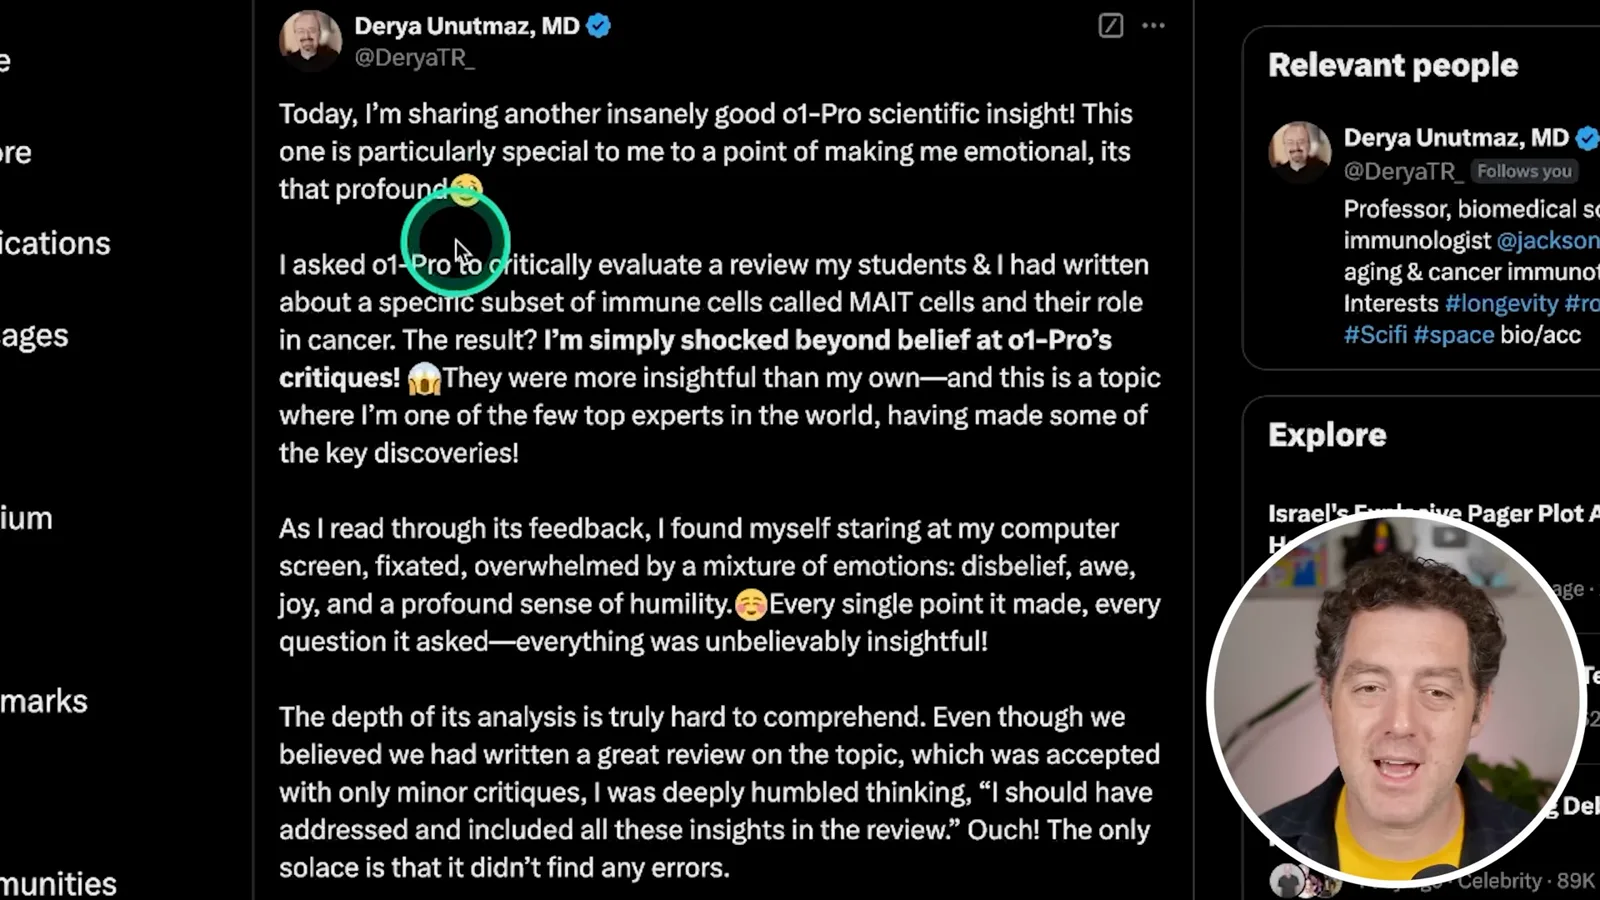
免疫学家 Derya Unutmaz 描述了另一个模型 o1 Pro 对一篇关于 MAIT 细胞与癌症的综述提出的批评。他认为反馈非常有洞见,并想知道更强的模型会对生物学产生什么影响。这是一位专家报告的个人体验,并非对 o3 的独立受控评估,也不是临床发现的证据。
成本、质疑与下一步
评论者讨论扩展、成本、可靠性和泛化能力。后续披露澄清了基准访问权限与估算成本。
Riley Goodside 分享了一张展示不同代模型 ARC 成绩上升的图。这一特定基准的跃升值得关注,但将少数历史结果绘制成图,并不能确立指数规律,也不能保证未来继续进步。Deedy Das 等人也强调了报告中的 FrontierMath 跃升。
OpenAI 研究人员 Noam Brown 强调,o1 与 o3 发布公告之间大约只相隔三个月。David Dohan 讨论了 16 小时这一数字和不断提高的 ARC 成绩;视频将其解读为每个答案的耗时,但仅凭那则帖子无法证实。ARC Prize 后来的表格报告,高算力半私有测试平均每道题约 13.8 分钟,同时使用了大量并行采样。
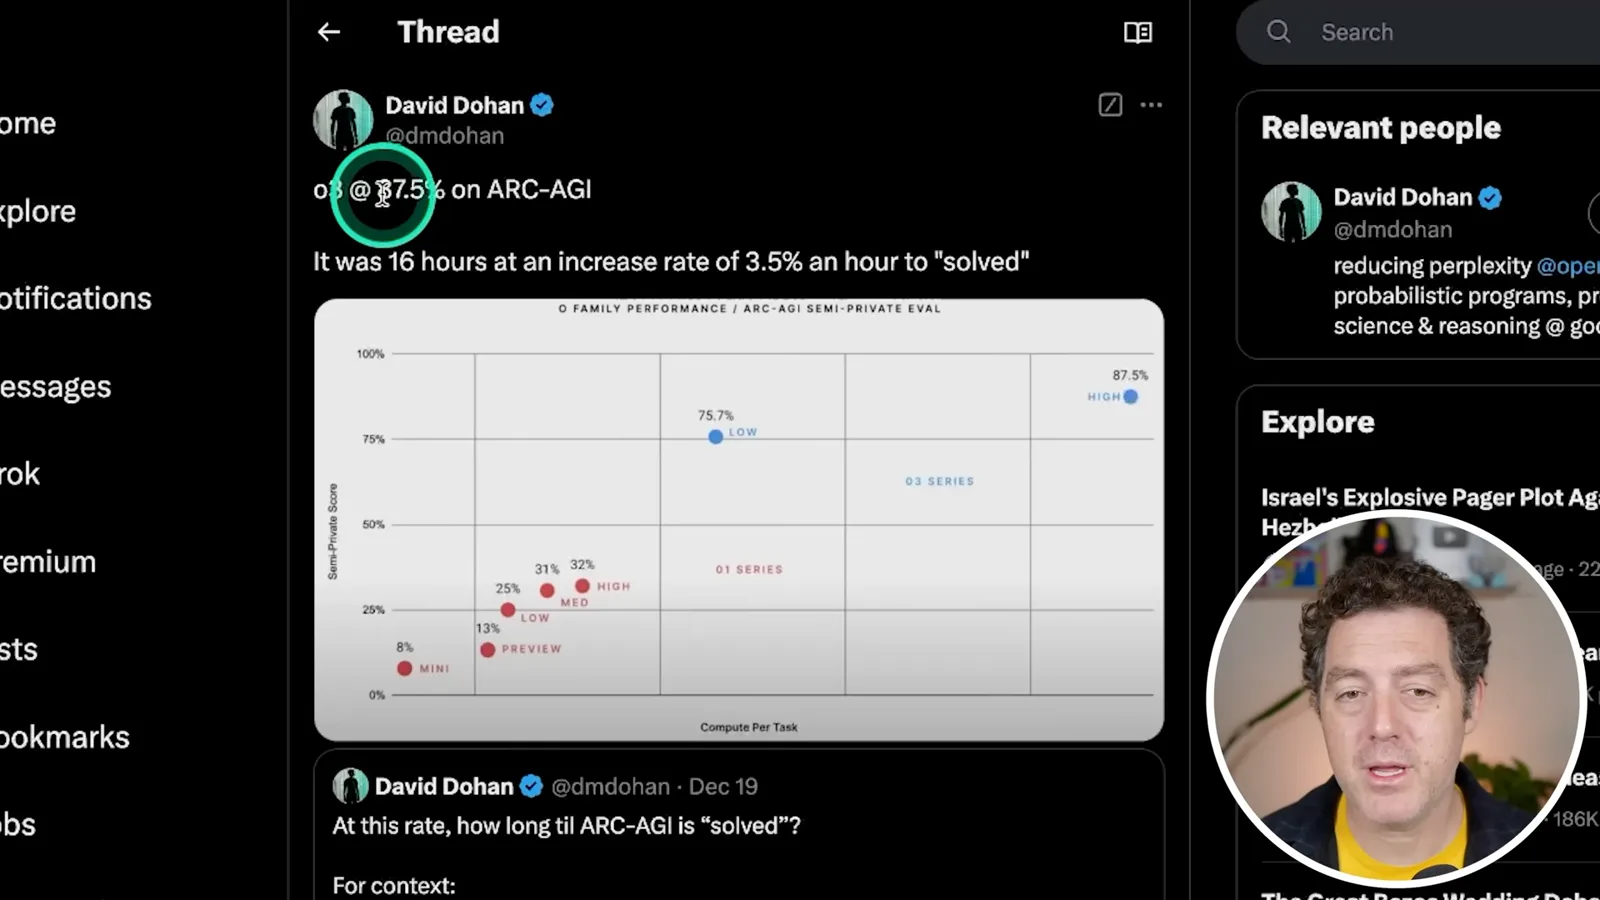
我转述了高算力测试约 35 万美元、使用 57 亿 token 的估算。ARC Prize 确实报告了 57 亿 token 和 172 倍算力增加,但成本估算取决于定价假设,后来也经过修订。这些是整次基准运行的估算,而非已确认的单个用户费用或一道题的花费。
Gary Marcus 预测,该系统最初会令人惊叹,但可能不可靠,尤其是在封闭领域之外。我认为应先亲手测试再下结论。ARC 谜题考察某种适应能力,但仅凭其成绩无法确定系统在开放式真实世界情境中的可靠性。
Santiago Valdarrama 称 o3 是重大进展,但认为它不是 AGI,成本仍然很高,也会在简单任务上失败;他提醒人们,它是否能泛化到其他领域尚不确定。Ben Thompson 则认为,这是先前 o1 揭示的推理时扩展可能产生作用这一洞见的延续。这两种观点都不能证明更多计算总能改善答案。
Epoch AI 的 Tamay Besiroglu 认为,报告中的 FrontierMath 25.2% 成绩比他预期来得更早。Epoch 后来澄清,OpenAI 委托制作并拥有核心基准题目,可以访问题目和答案,同时另有保留集安排。解释这一报告成绩时,访问权限和资助关系很重要;但它们本身不能证明训练数据污染。
Sam Altman 预测,o3-mini 将以更低成本在许多编程任务上超过 o1,而获得额外性能可能需要高得多的支出。这些是 2024 年对产品的前瞻性说法,并非对每项任务的独立结果。
NVIDIA 研究人员 Jim Fan 比较了 AI 在围棋、StarCraft、机器人和数学基准等专门领域的成就。他认为,一个系统可以在某一领域表现出色,同时在简单任务上失败,这说明了狭窄领域的能力与广泛能力之间的差距。我认为这些反应很有说服力,尤其是数学结果,但这些局限仍然重要。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。