30 秒看懂
Theo Browne 分享 DEF CON 的经历,并讨论 Thomas Ptacek 关于 AI 智能体将改变漏洞研究的预测。他区分已展示的发现和人工验证,以及对攻击、防御和监管的未确定预测。
- 1解谜不等于攻击Theo 报告模型解出一道困难谜题,但没有把它等同于真实系统入侵。
- 2未能复现的结果一位专家最初对早期模型的回答感到惊讶,后来却无法复现这一行为。
- 3人工验证的发现Anthropic 报告了超过 500 个高严重性漏洞,并说明进行了充分验证,初期补丁有人类参与。
- 4维护者需要支持自动报告可能有误也可能正确,两者都需要分诊和协调修复。
- 5防御仍然重要讨论中引用的专家对智能体能否轻易克服分层防御存在分歧。
要点建议
- 解谜、发现漏洞和入侵真实系统是不同的能力。
- AI 可以加快调查,但模型输出需要证据和专家验证。
- Anthropic 报告发现超过 500 个经验证的高严重性漏洞,工作中有人类参与。
- 维护者既要处理错误报告,也要协调修复真实缺陷。
- 分层防御、及时更新和负责任披露仍然重要。
按章节阅读整理后的全文
AI 辅助安全研究为何重要
Theo 区分已报告的发现与自己对未来滥用的担忧。发现漏洞和实际入侵是不同的步骤。
AI 编程工具不仅能写软件,也能帮助发现漏洞。我担心更快、更便宜的调查会改变攻击者与防御者之间的平衡。视频录制于 Mythos 公告之前;案例和预测反映的是我当时看到的情况。
一些公开案例来自研究人员和实验室,他们报告缺陷以便修复。这令人欣慰,但不能说明攻击者私下发现或利用类似问题的频率。发现漏洞、做出可用利用程序和实际入侵,是不同的步骤。
DEF CON 的经历
谜题测试和 Theo 对竞赛的回忆加深了他的担忧。他也讲述了一次无法稳定复现的安全测试。
我对这个问题的担忧在 DEF CON 期间加深:在那里我看到了密码谜题和安全竞赛。谜题可以测试耐心和推理能力,但解谜不等于入侵真实系统。我把这些经历作为能力变化的信号,而不是攻击成功率的直接衡量。
Gold Bug 提供一系列需要找出隐藏短语的奇特谜题。其中 Smugglers Manifest 花了我两天,需要分析虚构的货运文件。当时我尝试的 AI 工具帮助不大;后来的模型取得了更多进展,有时还需要一点提示。
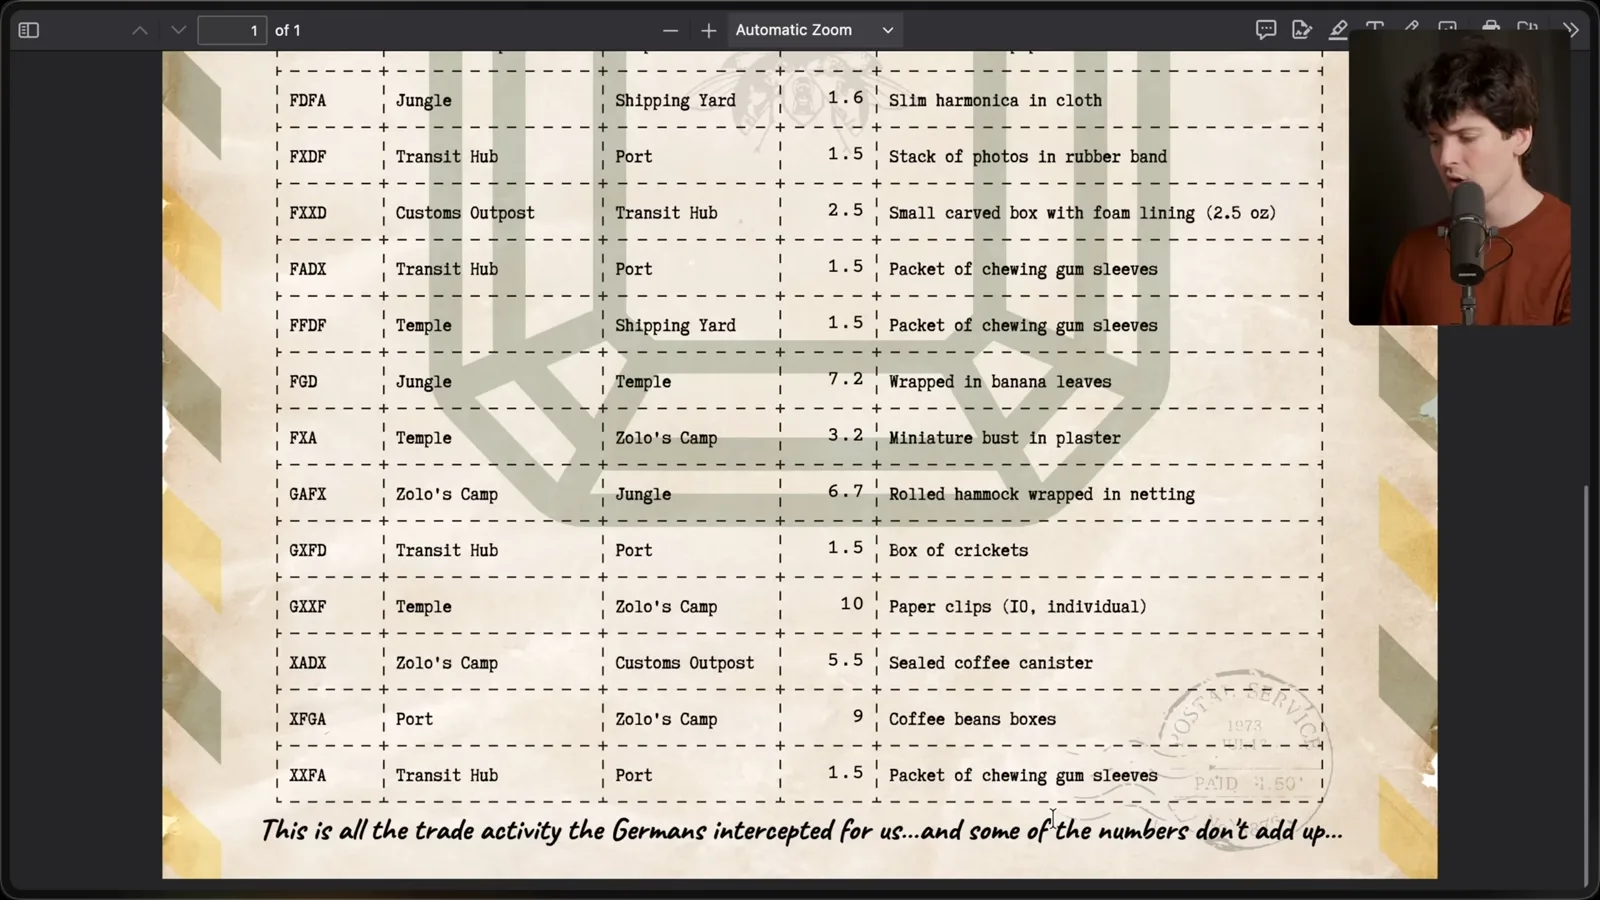
另一道 Sea Shanty 谜题给出带短语的瓶子和一首诗。我的团队花了很长时间才解出。我报告说 GPT-5.4 Pro 后来约用 16 分钟解决了它,其中包括核对答案的时间。这是我对一次特定测试的描述,并非攻击能力的受控评测。
我还记得组织者说,AI 在 DEF CON 的夺旗竞赛中作出了有意义的贡献。我没有找到相关闭幕式录像或准确数字,因此这仍是我的回忆,而不是独立记录的证据。竞赛环境也不同于生产系统。
在酒店房间里,我认识的一位安全专家用早期 GPT-5 测试一个冷门 Windows 问题。回答看起来有用,令他惊讶,但模型没有找到或完整解决该问题。之后的尝试没有复现这一行为,他也就没那么惊叹了;这种不确定性很重要。
我谈到关于服务商如何路由或限制部分安全相关请求的报道。这些政策和模型行为可能变化,我的描述不能证明存在普遍适用的路由规则。更广泛的问题是,如何在管理滥用风险的同时支持合法安全研究。
漏洞研究的经济模式
Theo 讨论 Thomas Ptacek 的预测和安全研究历史。专家注意力可能发生的变化仍是预测。
我引用 Anthropic 与 Mozilla 合作以及测试中发现漏洞的报告,随后讨论安全研究员 Thomas Ptacek 关于智能体可能改变漏洞研究经济模式的文章。即使基于真实案例,他对未来的判断仍然是预测。
Ptacek 认为,AI 可能带来大量被发现的漏洞,而不只是 AI 编写代码引入的漏洞。如果工具能快速调查许多项目,维护者可能收到更多此前未知的问题。其规模和速度是否会达到他预测的程度,仍不确定。
文章描述了漏洞调查可能从依赖专门的人力,转向更容易并行化的过程。我担心许多系统存在尚未发现或修复的缺陷。这说明应加强审查和响应,但不能证明每个具体系统都可被攻破。
Ptacek 回顾漏洞研究历史:从业者会钻研一些冷门实现细节,因为它们会接触不可信输入。他想说明,弱点可能出现在远离认证或安全代码的地方。理解输入到处理的完整路径很重要。
他论点的第二部分是:专家注意力有限,历史上会影响哪些组件得到审查。如果智能体降低分析成本,被忽视的设备和应用可能同时受到防御者和攻击者更多关注。这是在讨论激励如何变化,并不是说扎实的防御从未起作用。
自动调查和验证
模型可以帮助探索代码和假设,但输出需要专家核实。Anthropic 报告了人工验证的发现和补丁工作。
我在关闭网页搜索的情况下询问模型 Linux 子系统之间的关系,以展示它可以调用的知识范围。我不是内核专家,看起来合理的回答也不会自动变成正确结论。领域专家仍需对照源代码和证据核实。
Ptacek 认为,智能体可以反复比较模式、检查代码和测试假设,而不会疲倦。这可能加快研究的部分环节,但测试、工具、算力、权限和专家判断仍然重要。找到可疑模式并不等于证明实际影响。
Anthropic 报告称,在使用 Opus 4.6 进行开源安全研究时,发现并验证了超过 500 个高严重性漏洞。报告说这些发现经过充分验证,初期漏洞由人工研究人员检查并编写补丁。这个数字指已验证漏洞,不是无人参与的攻击次数。
Ptacek 描述 Nicholas Carlini 针对源文件反复运行智能体,再检查候选报告。他说该流程效果很强,但讨论中引用的接近 100% 数字缺乏足够细节,不能当作普遍准确率或成功率。人工验证和负责任披露仍然必不可少。
文章还以一个 Web 应用缺陷为例,说明发现范围并不局限于内存破坏。教训是,成熟代码和熟悉的组件仍可能存在缺陷。一份报告需要可复现的证据和协调修复,不能只凭模型的解释建立信心。
修补与维护者负担
更多对被忽视目标的关注可能增加维护者压力。现有分层防御和谨慎披露仍然重要。
Ptacek 预测,调查更多目标将变得合算,其中包括难以更新的设备。我同意缓慢修补会带来风险。及时更新仍受支持的系统,并为无法更新的设备做好安排,可以降低暴露面,但没有任何单一措施能保证安全。
开源维护者已经面临低质量自动报告,也可能遇到更多需要分诊和修复的有效报告。误报和真实发现都会产生工作量,因此研究人员应先验证报告并与维护者协调,而不是只增加数量。
文章提到内存安全语言、沙箱和减少攻击面等现有防御,并预测智能体最终会让链式攻击更容易,但这仍是预测。分层防御依然会增加攻击者的工作量,自动化研究对它们的效果需要实际衡量。
Ptacek 还认为,闭源不能构成完整防御,因为二进制文件也可以被分析。开放与保密可能改变不同参与者需要付出的工作量,但都不能消除漏洞。无论源代码是否公开,组织都需要修补、隔离和监控。
监管和不确定性
Ptacek 担心规则给合法研究带来负担。其他专家强调防御、专用工具和人类持续发挥的作用。
另一个担忧是,监管可能无意中增加合法漏洞研究的负担,却对阻止滥用帮助不大。Ptacek 预计严重事件后会出现政治压力,同时也承认安全政策从业者之间存在分歧。这是对未来规则的担忧,不是对现行法律的陈述。
Ptacek 咨询的一位研究人员认为,沙箱和虚拟化等分层防御仍会让利用链很困难,专门的分析工具也会继续有价值。另一位认为,尤其是在技术未被记录的领域,顶尖人类研究人员仍有空间。这些都是对更广泛预测的重要限定。
Ptacek 预计智能体会取代大量人类漏洞研究;我觉得这一警告有说服力,也令人不安。但结果尚未确定,这些故事不能证明 AI 可以攻破每个系统。明确的是,我们需要支持防御者、验证发现,并把修复送到用户手中。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。