30 秒看懂
Oracle 的 Jeff Smith 介绍了智能体访问数据库的三个用例:回答业务问题、调查性能和探索陌生的数据模式。他建议使用经过审核的参数化报表、受限工具、人工控制以及数据库层的身份和访问策略,并介绍了 Oracle 的产品示例与路线图。
- 1看似合理的答案也可能出错模型生成的 SQL 可以返回数据行,却没有回答用户真正想问的问题。
- 2把报表作为工具提供智能体可以查找并执行经过审核的参数化报表,而不必每次都生成查询。
- 3在生产环境之外调查Smith 介绍如何使用只读备用实例,并由人控制后续变更。
- 4给智能体提供模式上下文注释和经过过滤的元数据可以解释业务术语,减少反复探索。
- 5传递用户身份数据库策略可以根据已认证用户的角色和权限过滤结果。
要点建议
- SQL 查询成功运行,仍可能回答错业务问题。
- 经过审核的参数化报表可以限制模型生成 SQL 的风险,但智能体仍可能选错报表。
- 只读备用实例和权限范围明确的工具,可以为性能调查提供更安全的环境。
- 自然语言模式注释有助于智能体理解业务术语,减少探索性查询。
- 应在数据库层执行用户身份与数据权限控制;只读访问本身无法防止信息泄露。
按章节阅读整理后的全文
为什么智能体需要数据库上下文
Smith 介绍数据库能力以及安全访问的问题。
我是 Oracle 的 Jeff Smith,从事数据库工具工作大约 25 年。我很早就发现,无论工具做得多好,人们最终还是想在 Excel 里看到答案。即便进入智能体时代,电子表格背后的业务问题也没有消失。
人们经常问 Oracle AI Database 是什么。我的简短回答是:数据库原生支持向量,因此可以参与检索增强生成(RAG)流水线。你可以把向量化信息与业务数据放在一起,通过 SQL 查询,而不必为每种工作负载把所有数据复制到另一套系统。
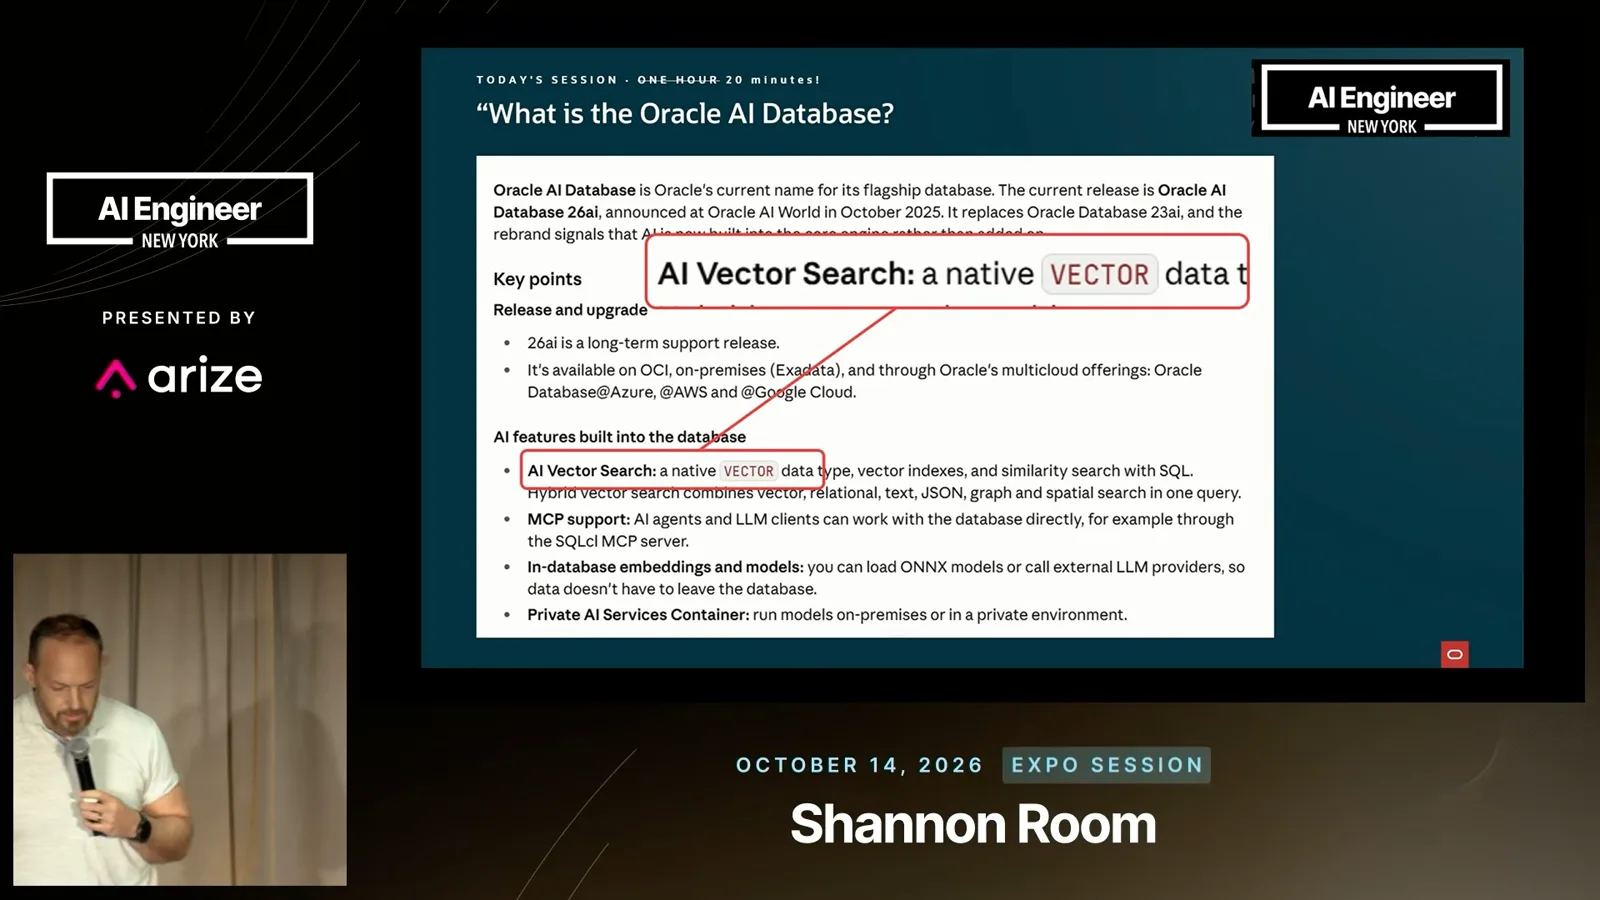
我们支持的工作负载并不只有向量。除了关系表和列,Oracle 还加入了其他数据类型和图能力,包括支持基于图的 RAG。公司虽然历史悠久,我们仍在持续开发和发布新功能。
我关注 MCP 的原因很直接:组织的数据和知识存在数据库里,而智能体需要上下文。难点是如何安全地把信息交给智能体,同时避免泄露个人身份信息或给企业造成其他损害。我会重点讨论实际用例、自然语言转 SQL 的风险,以及降低 token 消耗的方法。
业务问题与生成 SQL 的风险
自助分析可以帮助业务人员,但成功运行的查询仍可能出错。
第一个用例是自助数据访问。数据库管理员和 DevOps 工程师通常最先连接新的 MCP 服务器,因为他们能够接触基础设施。但更大的一群业务人员需要为管理者回答销售额、地区表现或折扣等问题。
如今,这些人员查找数据集市和商业智能报表,制作电子表格与数据透视表,再把结果带进会议,供管理者作重要决策。问题源源不断,稀缺的是回答问题所需的时间和人手。生成式 AI 有望帮助人们探索更多问题。
但这里有个难点:懂业务的人未必精通 SQL,也不一定看得出智能体选择了不合适的交叉连接。查询能运行、能返回数据,并不代表它回答了用户真正想问的问题。
这就是我认为自然语言转 SQL 既强大又危险的原因。模型可能生成看似合理却错误的查询,我不会仅凭一个返回结果就决定企业该往哪里投资。为了找到正确的表,智能体还可能花费大量时间和 token 探查数据字典。
把可信报表作为工具提供
经过审核的参数化报表为智能体提供了一个有边界的选择,减少每次都生成查询的需要。
大多数组织已经积累了反复使用的报表。我的建议是通过数据库或 MCP 服务器,把这些经过验证的报表作为工具提供给智能体。智能体不必从头生成 SQL,而是查找相关报表并提供输入参数。
这需要前期准备:说明每份报表的含义、接受哪些输入,以及它适合回答哪些示例问题。输入采用参数化方式,底层报表查询大体固定。模型仍可能选错报表,但少了一个自行编造错误 SQL 的环节。
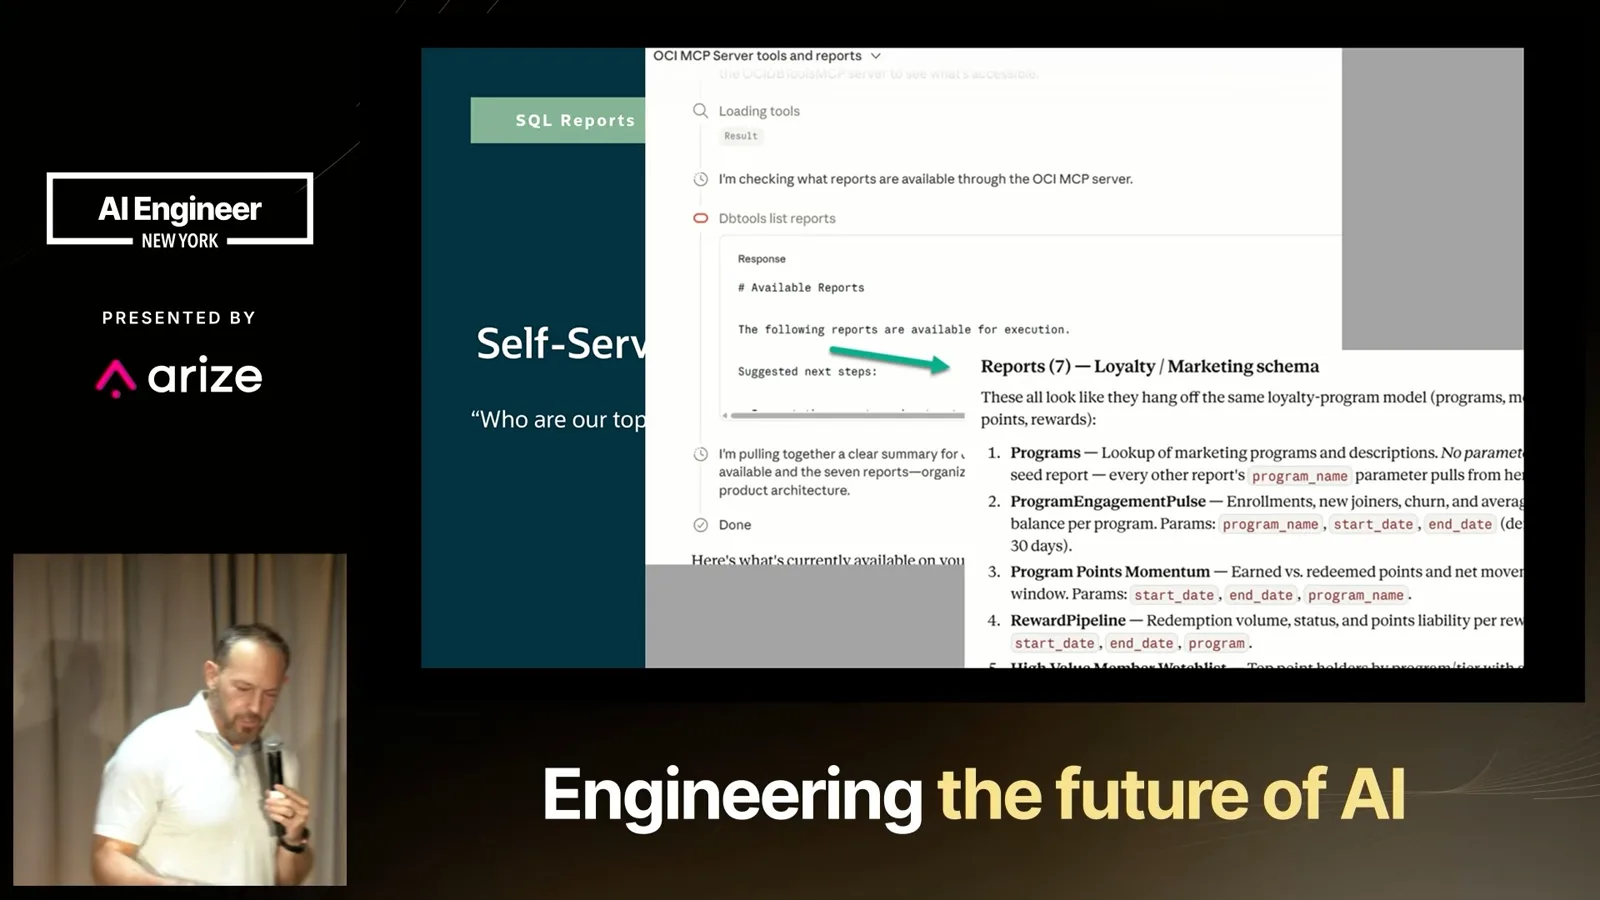
我不必把 500 份报表暴露成 500 个独立工具。我可以提供“列出报表”和“执行报表”两个工具:智能体用关键词搜索目录,拿到匹配结果,再运行选中的报表。精简工具接口也能避免数百条定义挤占上下文。
Oracle 的 MCP 服务器也能执行任意临时 SQL 或存储过程,但也支持关闭这一能力,把访问限制在自定义工具和报表内。选择哪种模式属于安全与治理决策;有执行工具,不代表每个智能体都应获得该权限。
报表还有另一个用途:它们展示业务和数据模型如何运作。如果 OAuth 2 会话具有适当的 scope 或角色,工具可以展示报表背后的 SQL。智能体需要编写新查询时,就能把这个例子作为上下文,而不必猜测组织内部的业务定义。
以受限访问调查性能
Smith 介绍只读备用实例和受控调优工具,并强调重要变更由人掌控。
第二个用例是性能调优。数据库文档和示例广泛存在,模型通常能够建议排查慢查询的方向。即便如此,我也不会信任 LLM 自行在生产环境中删除或创建索引。我希望它给出建议,再由人评估并采取行动。
理想情况下,我会尽量让智能体远离生产环境。测试环境未必与生产环境一致,但 Oracle Data Guard 可以提供用于报表和查询的只读备用实例。如果性能问题也能在那里重现,智能体就有了一个更安全的调查环境。
只读访问本身还不够:智能体仍可能读到它不该看到的信息。安全控制应在数据库层执行,而不只放在某一个客户端工具里。否则,其他人换一个工具连接同一数据库,就可能绕过只存在于原工具中的限制。
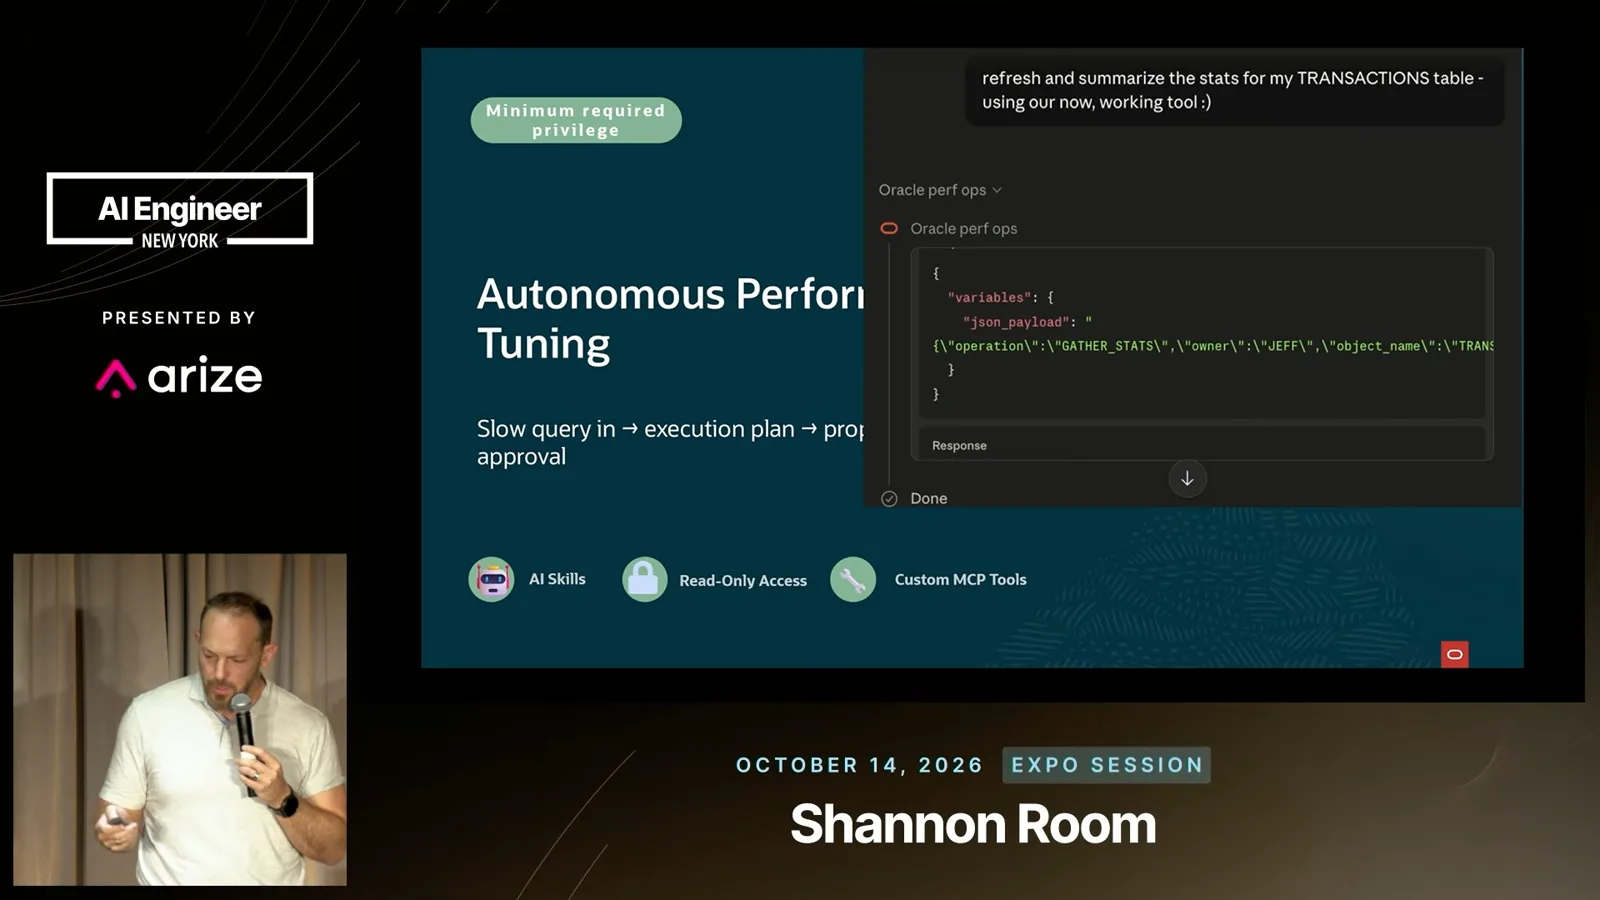
在调优示例中,我构建了一个自定义工具,只允许六种我认可的操作。其中一种是收集数据统计信息。基于成本的优化器会利用列中不同值的数量等信息选择执行计划;更新、更准确的统计信息有助于它选出更好的计划。
我不会为每个单独动作都暴露一个工具,而是把相关操作归入少数几个带选项的工具。例如,性能工具可以生成 Automatic Workload Repository(AWR)报表或收集统计信息。智能体可以协助调查,重要变更仍由数据库管理员掌控。
为智能体记录数据库模式
注释和精简元数据有助于智能体理解陌生的数据模型。
第三个用例是探索和记录数据库模式。新员工很少能找到一张完美的地图,解释内部术语、表名和业务规则。销售数据可能因为几十年前的某个决定,存放在名称出人意料的表里。模型生成 SQL 时也会遇到同样的信息缺口。
我们可以利用 Confluence 页面等现有文档,为模式元数据添加自然语言注释。这是上下文工程:主动向模型提供环境信息,而不是让它反复逆向探索数据库。这些注释既能帮助智能体,也能帮助人。
我们的 schema information 工具会以 JSON 返回压缩后的属性字典,支持不同的详细程度和关键词过滤。这样就能减少一连串探索性调用:不必为了寻找相关数据,先列出每张表和每个字段,再读取注释并抽样查看数据行。
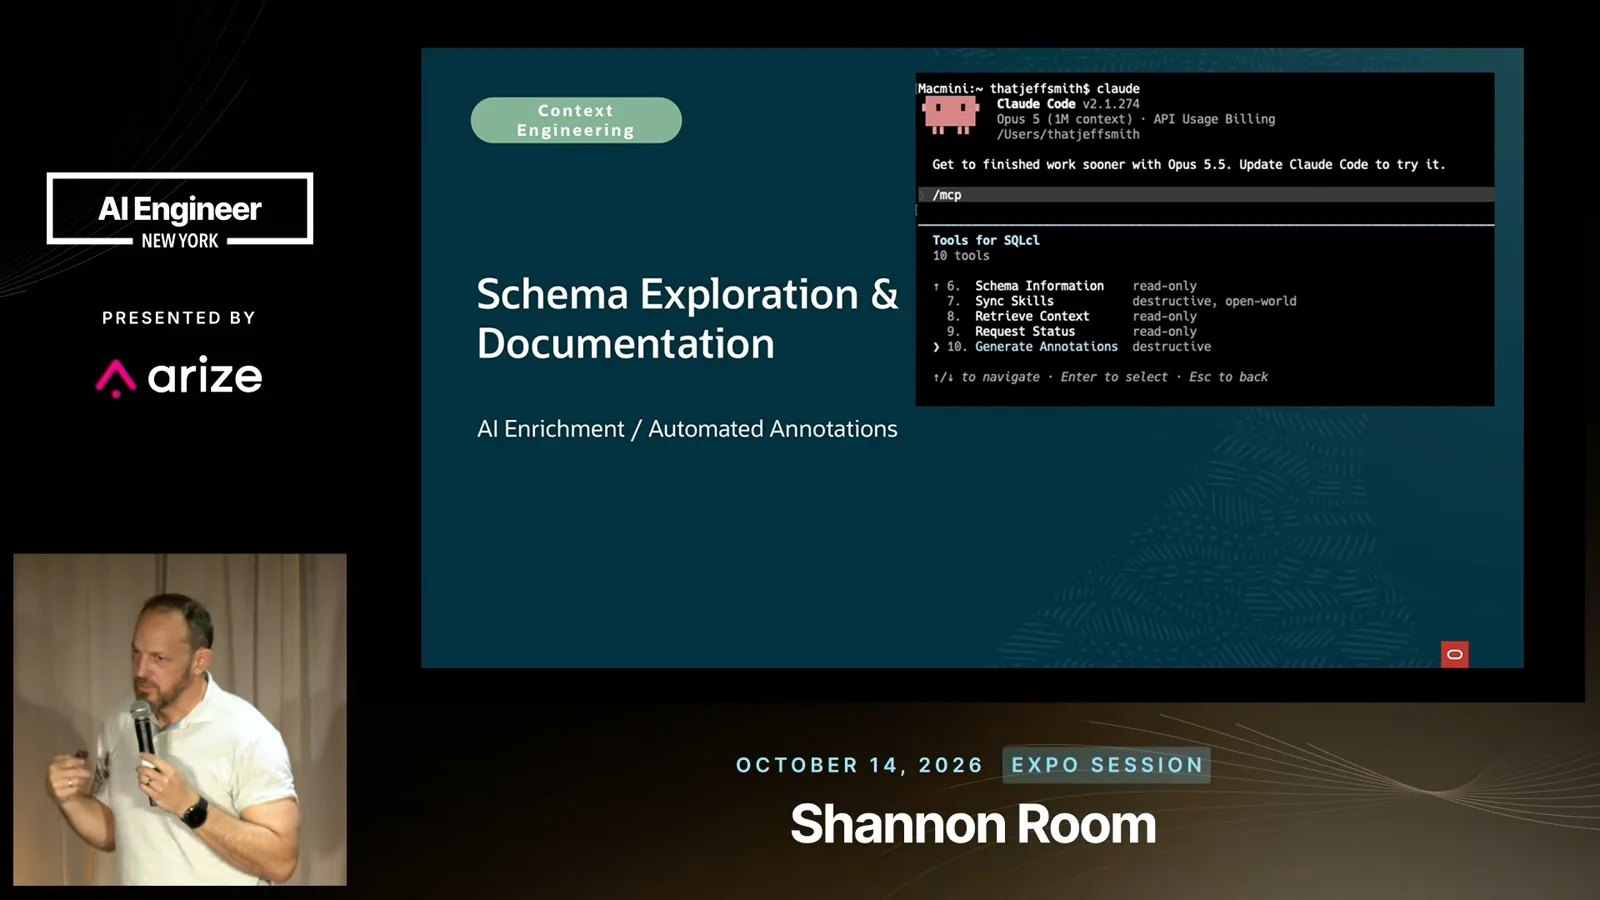
retrieve context 工具可以利用这些信息进行向量搜索。generate annotations 工具则可以处理 PDF、演示文稿、电子表格和 Word 文件,提取并整理文本,再把注释存入数据库。目的是为之后的自然语言查询提供更有用的上下文。
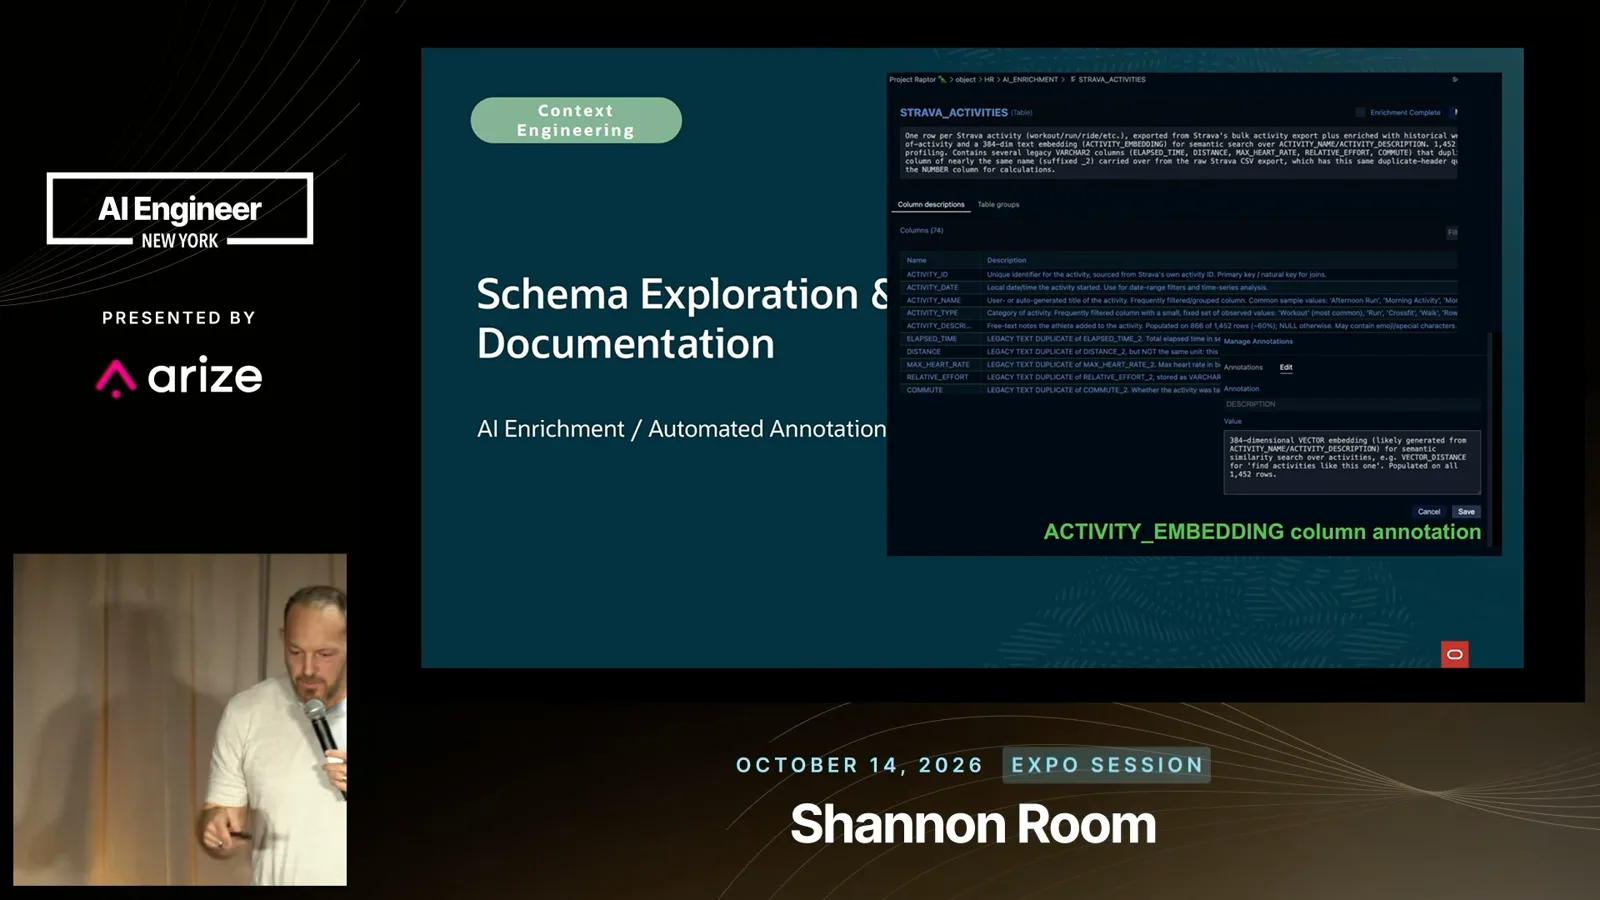
我用自己的 Strava 运动记录举例:通过 API 收集数据并存入数据库,但有些列使用不同单位,有些列的实际内容也无法从名称直接看出来。把这些细节写进注释后,我询问未来的锻炼安排时,智能体就更容易理解历史数据。
执行身份与数据安全策略
单点登录和数据库策略决定哪些信息可以返回给智能体。
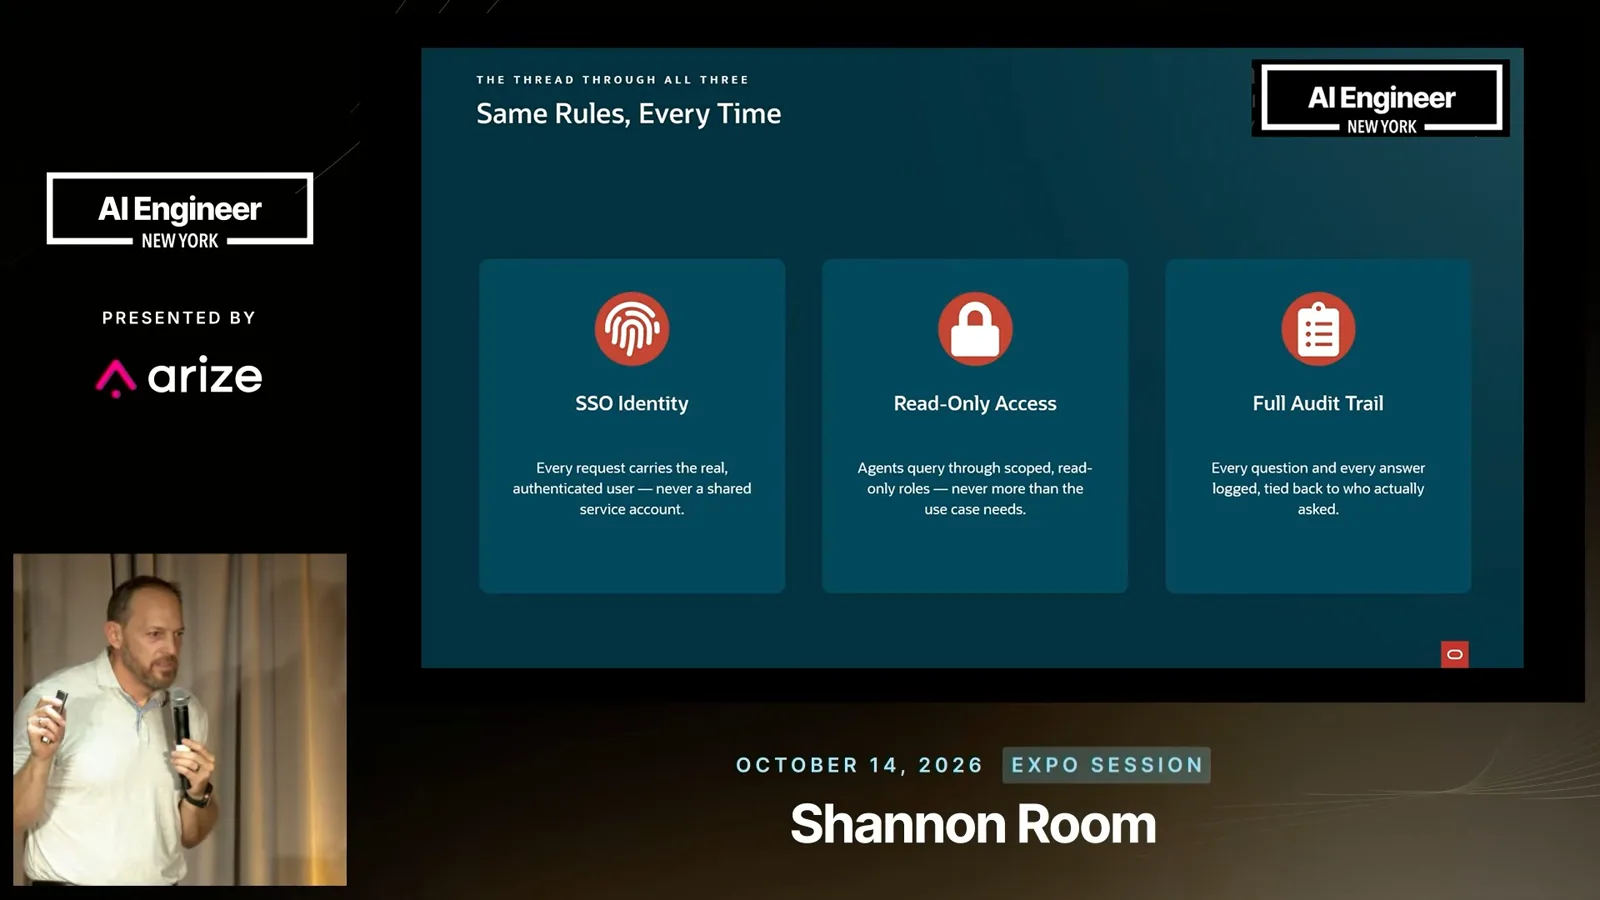
最后,安全首先要弄清楚是谁在提问。我和同事有权看到的信息可能不同。在我描述的设计中,智能体使用组织的单点登录身份及其关联的 scope 和角色,因此访问权限可以对应实际用户,而不是使用共享且不受限的身份。
例如,数据库可以允许 HR 经理查看薪资数据,同时限制其他人访问。生成的 SQL 执行后,数据库策略会在结果送到智能体之前进行过滤;Oracle 将其称为 deep data security。这依赖于正确配置身份、角色和数据库策略,不能仅凭接入了智能体就认为保护已经到位。
最后简要介绍产品路线图:Oracle 正在为智能体中的数据库界面构建 MCP apps,并提供 skills 和自动化 RAG 流水线。我提到的具体能力和可用时间属于 Oracle 的产品计划;更普遍的经验是,在让数据库访问变得有用的同时,明确控制身份、权限与执行操作。
同频道的其他文章
 18:52EN → 简体中文
 AI Engineer· 2026年11月1日Hahnbee Lee 与 Lincoln Murr:为 AI 智能体设计文档和支付Hahnbee Lee, Lincoln Murr · Mintlify随着智能体越来越多地阅读文档和使用服务,Mintlify 与 Coinbase 讨论准确内容、API、支付授权和持续维护的重要性。
 18:45EN → 简体中文AI Engineer· 2026年11月1日Ramakrishnan Lokanathan:评估 AI 智能体的工作,而不只是答案Ramakrishnan Lokanathan一套测试完整 AI 工作流的实用框架,将人工反馈、回归检查和更具挑战性的评估结合起来。
 14:44EN → 简体中文AI Engineer· 2026年10月31日Supriya Subudhi:Bumble 测试 AI 功能的五个经验Supriya Subudhi · Bumble积极的测试结果只是开始:使用率、输出质量、模型成本和监管都决定 AI 功能能否扩大规模。
 18:29EN → 简体中文AI Engineer· 2026年10月31日Steven Latré:自己运行 AI 模型的经济账Steven Latré · imecimec 研究比较了长周期编程智能体使用 API、租用 GPU 和自有基础设施的成本。
 17:02EN → 简体中文AI Engineer· 2026年10月31日如何评估受监管贷款电话中的语音智能体Brooke Hopkins, Shiv Indap · CovalShiv Indap 与 Brooke Hopkins 介绍持续评估中的人工审核、LLM 评判器和模拟。
 25:47EN → 简体中文AI Engineer· 2026年10月31日Richmond Alake:AI 智能体的记忆与智能平面Richmond Alake · OracleOracle 的 Richmond Alake 提出用智能平面连接智能体记忆、企业知识和持续学习,并通过架构图与演示解释这一思路。