30 秒看懂
AI 安全研究员 Ramakrishnan Lokanathan 认为,评估只能提供范围明确的信号,不能完整衡量模型。他建议定义成功目标、测试工作流中的每一步、结合自动与人工审查、保留回归案例并将客户遇到的失败转化为测试;他还介绍了将游戏用于探索性评估的方法。
- 1一次考试只是一个信号基准回答范围明确的问题,无法衡量生产任务所需的全部能力。
- 2先定义工作明确什么必须发生、什么绝不能发生,以及智能体何时应该停止。
- 3检查整个工作流图像编辑可能改对了背景,却意外增加了第二个把手。
- 4会作出回应的测试游戏提供了一种探索性方法,用于观察连续决策和对对手的适应。
- 5保护已有功能模型升级可能让用户依赖的功能退化,因此要保留已知任务和过去的失败案例。
- 6向客户学习复现真实失败,将其加入包含人工审查的评估流水线。
要点建议
- 选择指标之前,先定义智能体必须做什么、绝不能做什么,以及何时应该停止。
- 看似正确的最终答案可能掩盖中间步骤失败或非预期改动。
- 将自动部署检查与人工审查、对抗性案例和任务专属指标结合起来。
- 随着能力提高加入更难的案例,同时保留现有行为的回归测试。
- 利用客户报告复现失败,并把它们变成未来的测试。
- 互动游戏可以揭示连续决策中的行为,但单凭获胜无法证明系统已经适合生产。
按章节阅读整理后的全文
评估衡量什么
评估类似考试,是对 AI 系统范围明确的测试,目的是收集产品是否兑现承诺的证据。
评估之所以经常失效,是因为我们把它搞得过于复杂,却没有先问清楚要衡量什么。评估就像给 AI 系统安排考试:通过一组任务、标准和证据,帮助我们了解模型或智能体是否按预期表现。我们熟悉的各类考试也遵循同样的基本思路。
考试应该回答范围明确的问题。例如,SAT 只是衡量大学准备程度的一个信号,并不能完整衡量学生的能力。同样,AI 基准也只能提供一个信号,不能让我们据此假定模型能做好一项工作的所有部分。
实际问题是,系统表现是否符合我们向用户作出的承诺。如果我们发布一个执行特定工作的智能体,评估应该告诉我们产品在生产环境中是否实现了承诺,而不只是底层模型在公开基准上是否表现出色。
我在印度科钦长大,很早就开始编程和构建机器学习分类器。2021 年看到一个基于 GPT-3 的产品演示后,我相信新的应用形式即将出现。我们的团队在 ChatGPT 研究预览发布前不久全职投入;这一变化既验证了我们的方向,也迫使我们调整。
我们经历了几次转型,最终开发了一款宠物护理 AI 助手,通过电商和推荐业务盈利,后来公司在印度被收购。早期应用开发让我意识到评估的重要性。之后我参与了模型红队测试和 AI 安全研究。
定义有雄心的成功目标
演讲者认为生产团队现在就需要评估,并应在选择指标之前定义工作。
我猜测,如果模型能力持续提高,十年后评估的重要性可能会降低。这只是一个预测,并不能成为等待的理由:团队今天就在把系统投入生产,需要证据证明系统确实兑现了承诺。
设计测试之前,先定义最有雄心的成功结果。想象智能体能够实现的最佳结果,然后问:什么必须发生,什么绝不能发生,系统应该何时停止?在引入分数之前,这些问题先确定了工作及其边界。
瞄准你需要完成的工作,而不是最容易获得的分数。我要提醒的是,满分可能意味着评估太简单或覆盖范围太窄。随着系统进步,应当用超出当前能力的案例挑战它,而不是因为通过了固定题集就宣布成功。
测试工作流,而不只是结果
图像编辑示例说明,看似正确的结果也可能掩盖非预期改动。自动检查、人工审查和对抗性测试可以提供互补证据。
测试整个工作流,而不只是最终答案。有一个图像编辑例子,要求只是更换背景。输出确实换成了奶油色背景,却也给物体多加了一个把手。如果只检查背景是否改变,就会漏掉这个非预期改动。
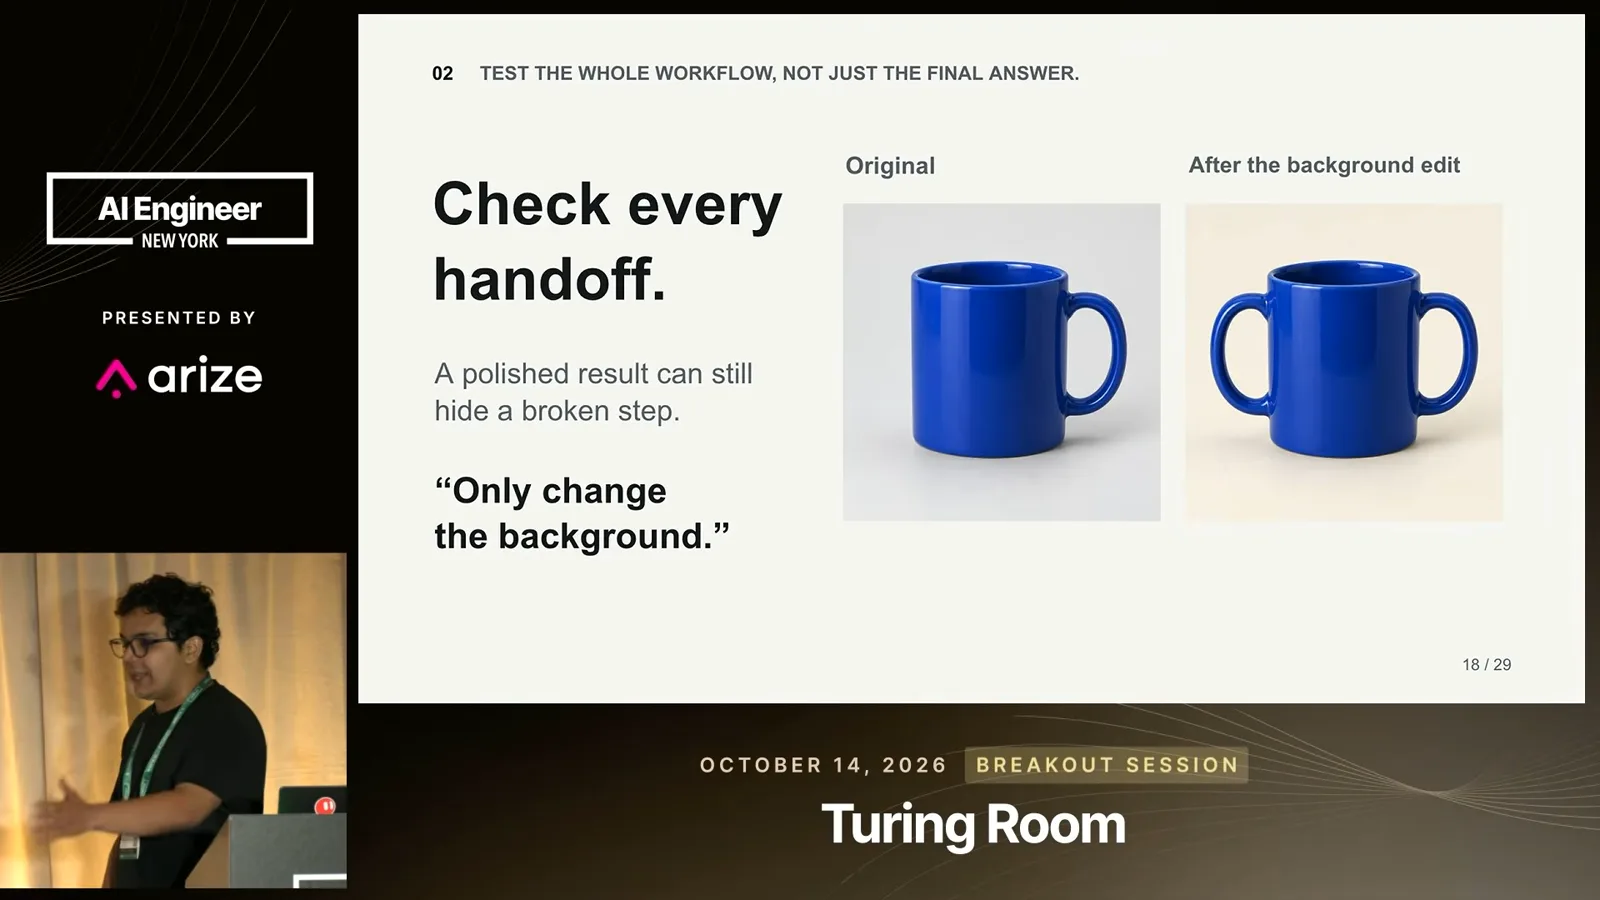
对于多步骤工作流,要检查每一步的输入、输出和预期结果。最终输出表面上可能正确,中间某个动作却违反了任务要求。应该按智能体实际执行的工作,确定合适的评估单位。
一个分数不等于一套评估系统。持续运行的智能体可能写作、调用工具并连续作出决策,因此需要多种证据。把自动检查放进部署流水线,反复运行相关评估,而不是只在选择模型时评分一次。
让人持续参与,审查结果是否合理。AI 审查者可以加快部分评估,但我不会只依赖它。还要加入对抗性测试:有意把工作流置于困难条件下,寻找可能出错的地方。
将游戏作为评估方式
eSlams 项目利用互动游戏观察智能体的连续决策。游戏补充而非取代与实际工作相关的评估。
选择测试时,要考虑它能揭示哪些失败。只有一个答案的静态任务,不一定能显示智能体在情况变化时如何处理连续决策。我一直在探索把游戏作为额外的评估方式,因为对手可以作出回应,迫使系统调整。
我的开源项目 eSlams 通过 Python 包让智能体和模型玩游戏。例如,让旧智能体与新智能体下棋,并不意味着可以简单宣布获胜者就是更好的模型。棋步、策略变化以及从失误中恢复的方式,可以让我们从另一个角度观察其行为。
这个项目支持不同类型的游戏和模型提供方。国际象棋和围棋考察可见棋盘上的规划;扑克引入隐藏信息;合作游戏涉及共同目标。我把这些视为编程、写作等评估的补充,而不是特定任务测试的替代品。
eSlams 网站展示模型之间的对局,也允许人们与模型对战。拟议中的 AI 游戏比赛旨在探索模型在互动情境中的表现。游戏结果可能有参考价值,但单凭它不能证明智能体已经准备好执行某个生产任务。
回归测试与真实失败
升级后持续检查现有功能,加入新的挑战,并把客户报告变成可复现的测试。
继续测试过去有效的功能。我曾用 Google Assistant 设置提醒,在使用体验转到 Gemini 后,发现自己当时的设置中提醒不再生效。我把它作为迁移中的回归风险示例:系统可能在许多方面进步,却失去用户已经依赖的能力。
在回归测试集中保留已知任务和过去的失败,同时加入新的挑战。如果测试对系统来说已经变得容易,就改进测试并推进能力边界。两类案例都很重要:增加新挑战时,不能忘记用户仍然需要的旧功能。
把真实世界中的失败变成未来的测试。客户是产品最重要的评估者之一,因此要建立一条让用户反馈进入评估流水线的路径。可观测性工具、简单的点赞或点踩,以及其他反馈渠道,都可以显示工作流在哪里出现问题。
像处理普通软件质量问题一样复现用户报告。找出失败发生的位置,例如某次工具调用,并追问现有测试集为什么没有发现它。审查案例、将其加入流水线,并在系统变化时保持这个反馈循环。
把框架组合起来
演讲以持续循环作结:设定有雄心的目标、针对具体步骤评估、收集多种证据并持续反馈。
核心原则是测试工作,而不只是答案。定义有雄心的成功目标,持续检查工作流,并针对每一步的功能设计测试。如果工作流的某一部分负责调用工具,就评估它使用工具的能力和准确性,而不是采用无关指标。
随着智能体的发展,要通过不同的评估方式收集证据。游戏是我正在探索的一条路径;对需要实时信息的产品,搜索表现是另一个例子。没有单一场景能覆盖所有边界情况,因此要不断寻找与实际部署系统相关的证据。
最后,要持续改进测试并向现实学习。更难的案例帮助我们看到新的能力边界,回归案例和人工审查则保护人们已经使用的功能。客户反馈能显示系统在生产环境中是否兑现承诺,而这正是整个评估工作的目标。
同频道的其他文章
 18:52EN → 简体中文
 AI Engineer· 2026年11月1日Hahnbee Lee 与 Lincoln Murr:为 AI 智能体设计文档和支付Hahnbee Lee, Lincoln Murr · Mintlify随着智能体越来越多地阅读文档和使用服务,Mintlify 与 Coinbase 讨论准确内容、API、支付授权和持续维护的重要性。
 21:39EN → 简体中文AI Engineer· 2026年10月31日Jeff Smith:如何让 AI 智能体更安全地访问数据库Jeff Smith · OracleOracle 的 Jeff Smith 解释了生成 SQL 为什么可能误导用户,并展示如何用经过审核的报表、模式上下文和数据库层控制降低智能体风险。
 14:44EN → 简体中文AI Engineer· 2026年10月31日Supriya Subudhi:Bumble 测试 AI 功能的五个经验Supriya Subudhi · Bumble积极的测试结果只是开始:使用率、输出质量、模型成本和监管都决定 AI 功能能否扩大规模。
 18:29EN → 简体中文AI Engineer· 2026年10月31日Steven Latré:自己运行 AI 模型的经济账Steven Latré · imecimec 研究比较了长周期编程智能体使用 API、租用 GPU 和自有基础设施的成本。
 17:02EN → 简体中文AI Engineer· 2026年10月31日如何评估受监管贷款电话中的语音智能体Brooke Hopkins, Shiv Indap · CovalShiv Indap 与 Brooke Hopkins 介绍持续评估中的人工审核、LLM 评判器和模拟。
 25:47EN → 简体中文AI Engineer· 2026年10月31日Richmond Alake:AI 智能体的记忆与智能平面Richmond Alake · OracleOracle 的 Richmond Alake 提出用智能平面连接智能体记忆、企业知识和持续学习,并通过架构图与演示解释这一思路。