30 秒看懂
imec AI 负责人 Steven Latré 介绍了一项针对不同模型、运行框架和硬件的编程智能体基准测试。他解释模型质量、GPU 内存、并发、利用率及运行框架选择如何影响从 API 转向基础设施的成本。
- 1测试具体工作负载团队在不同模型、运行框架和硬件上使用 SWE-bench Pro 长周期编程任务。
- 2硬件成本改变比较结果任务表现相近的模型可能需要差异很大的 GPU 配置。
- 3并发会消耗内存模型参数和用户 KV 缓存都需要放入内存,同时保持可接受的延迟。
- 4利用率改变经济性研究报告了较小和较大系统所需的不同盈亏平衡利用率。
- 5运行框架影响 GPU 时间一次 GLM 比较中,Codex 的 token 和 GPU 时间约为其他框架的一半。
要点建议
- 模型质量与硬件成本之间并非平滑的线性关系。
- 并发和 KV 缓存内存可能限制大型模型的经济性。
- 盈亏平衡所需的利用率取决于所比较的系统和工作负载。
- 即使任务表现相近,运行框架也可能改变 token 用量和 GPU 时间。
- 报告中的节省成本仅适用于研究中的编程工作负载及其假设。
按章节阅读整理后的全文
从半导体研究到 AI 工作负载
Latré 介绍 imec 和从 API 转向基础设施的过程。
我是 Steven Latré,负责比利时研究机构 imec 的 AI 工作。相较于 AI,imec 在半导体研发领域更为人熟知。我们与合作伙伴研发下一代芯片,但工作范围从晶体管延伸到系统和工作负载。我的职责是把 AI 工作负载与基础设施需求联系起来。
我们自己使用 AI 智能体的经历经过了几个可能很熟悉的阶段。2024 年和 2025 年,我们侧重使用最新的前沿模型。随着计费越来越按 token 用量计算,我们逐渐把任务路由到合适的模型,而不是总选最大的模型。
模型路由是一个容易着手的优化,但随着 token 用量增长,一些组织开始更主动地掌控技术栈。我们从封闭 API 起步,接着优化成本,如今正在探索托管开放权重模型和租用基础设施;未来也可能拥有自己的基础设施。
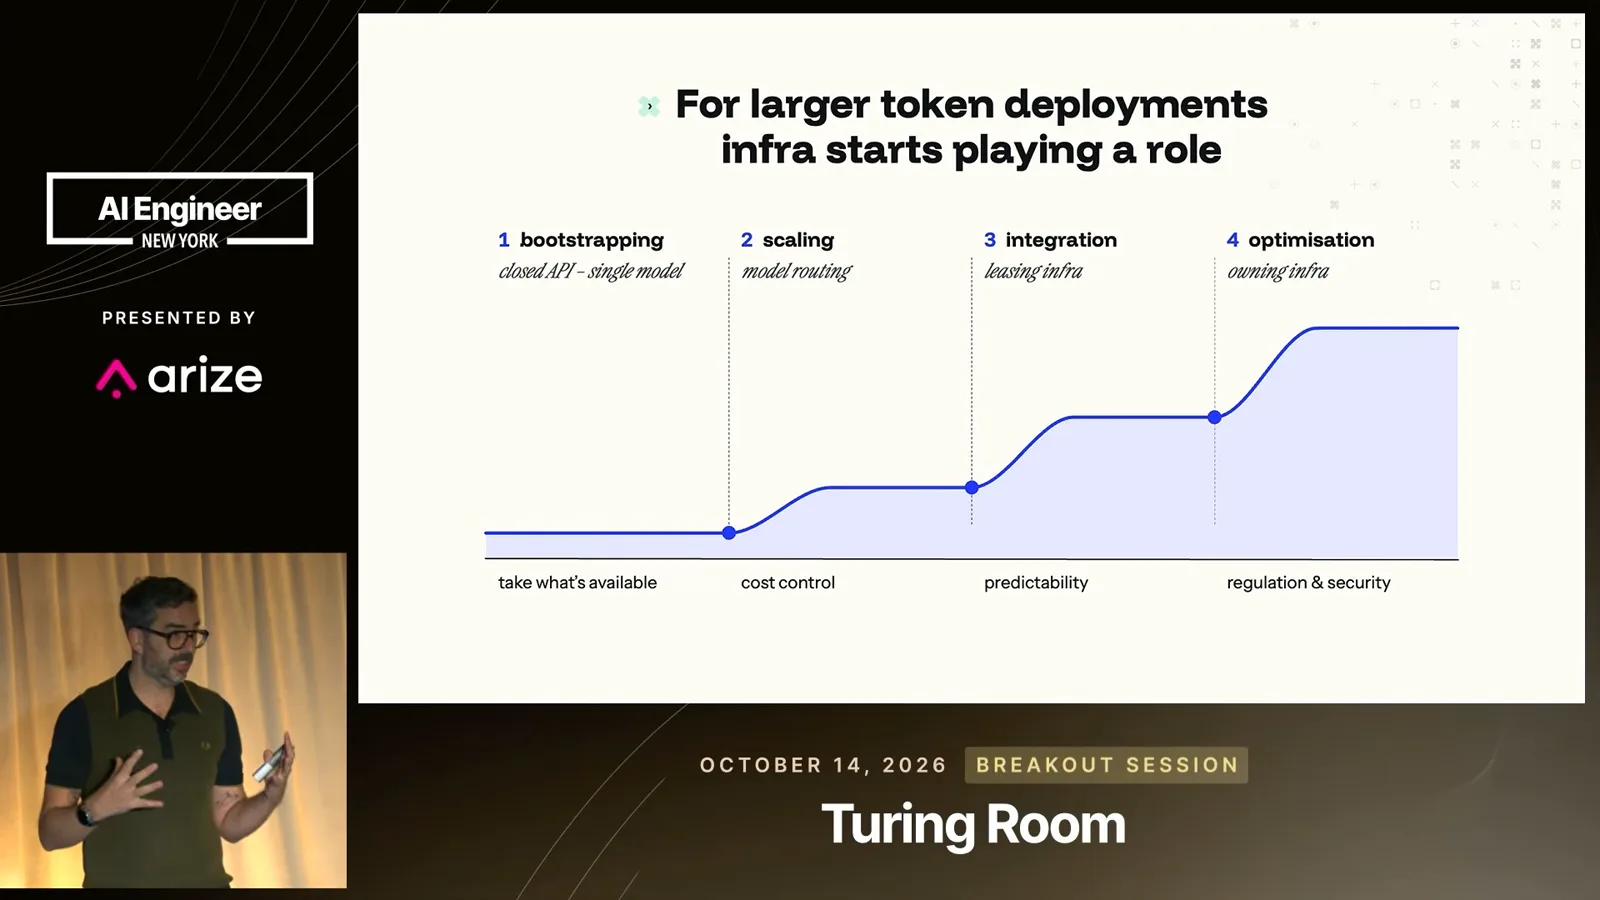
使用 API 相对直接。自己掌控更多基础设施则会大幅扩大设计空间:团队不仅要关注任务准确率,还要考虑模型选择与可信度、编程智能体运行框架、硬件架构、CPU 与 GPU 的配比,以及 KV 缓存优化。
基准测试如何设计
研究比较不同模型、运行框架和硬件上的长周期编程任务。
我们的团队运行了数千次基准测试,研究智能体 AI 从 API 计费转向基础设施和总拥有成本会带来什么变化。我们关注达到一定任务表现需要多少成本,以及哪些运行框架、推理引擎和硬件配置适合这一目标。
我们选择了 SWE-bench Pro 中的长周期编程任务。长任务可能较早适合专用基础设施;高度交互式使用的经济性可能不同。我们改变编程运行框架、API 与开放权重模型、模型规模及硬件配置,并考虑能否支持并发用户。
对每种配置,我们考察任务解决率、延迟和成本,同时提高模型与硬件复杂度。这些结果来自一个基准和一种工作负载,不能直接视为所有 AI 部署方式的通用排名。
模型表现与硬件成本
结果显示应将任务质量与 GPU 成本一起评估。
模型表现大致分成几组。在我们的测试中,Qwen 和 DeepSeek 等较小模型解决了约 35% 至 40% 的任务。GLM 模型表现处于 Opus 附近,而 Kimi K3 达到 86%。我提到部分基准内容可能出现在其训练数据中;这只是可能性,并非已经证实的结论。
加入硬件成本后,比较结果会改变。在我们的测试中,Qwen 和 DeepSeek 的应用表现大致相当,但硬件需求可能导致 GPU 租赁成本相差四倍。在所比较的配置中,从 GLM 换到 Kimi K3,准确率提高约 20%,租赁 GPU 成本增加约 15%。
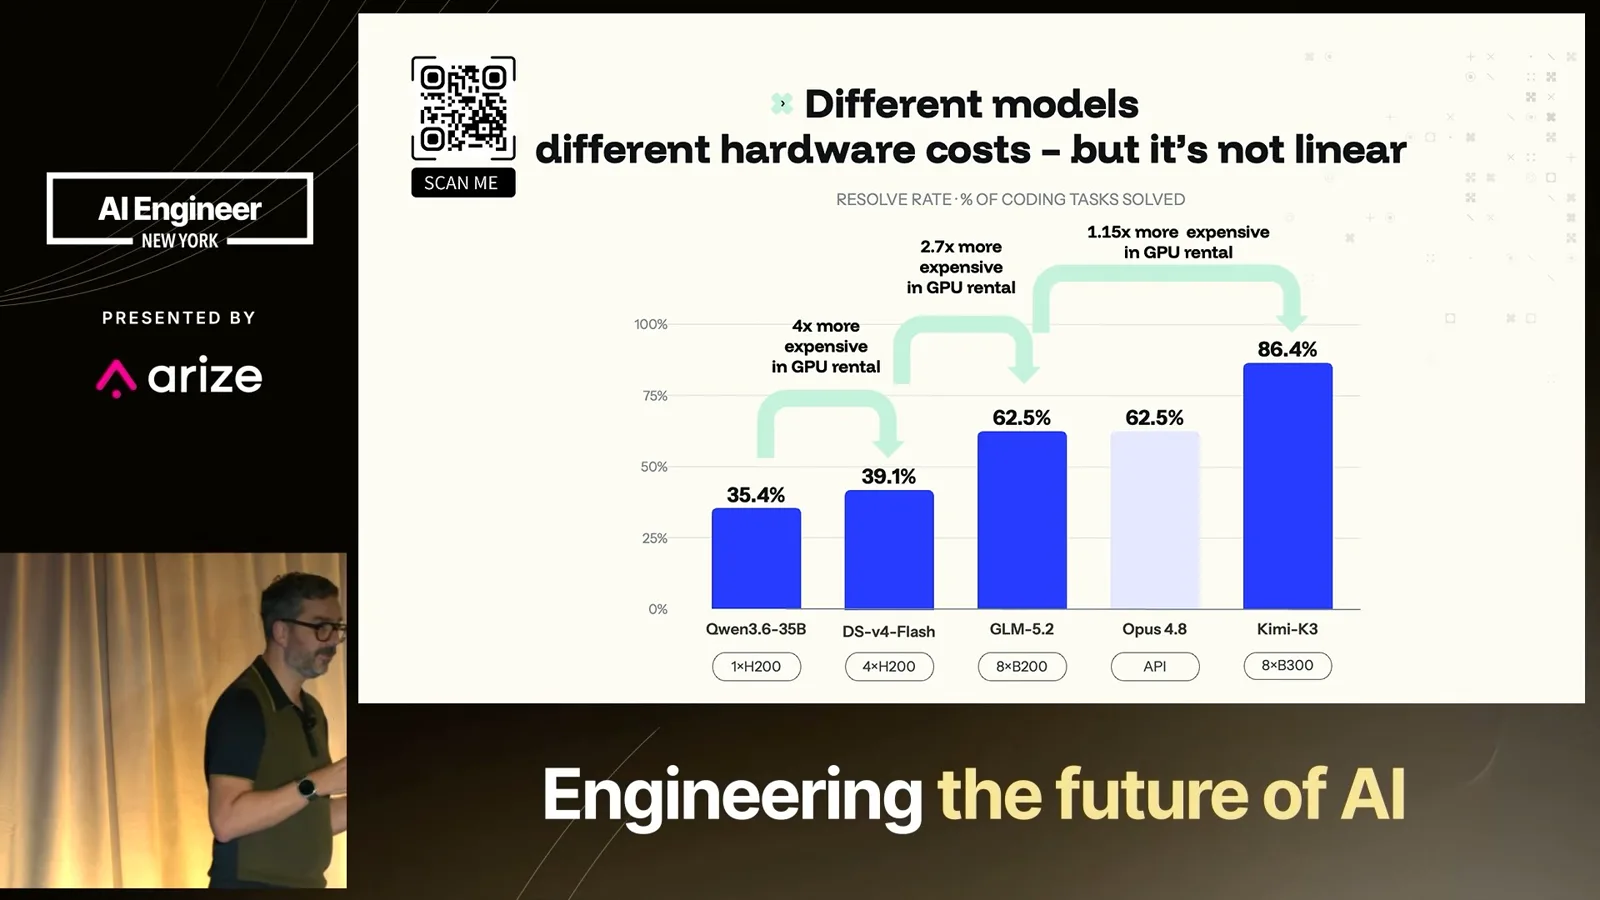
成本不会随模型质量平滑变化,而往往呈阶梯状:略有差异的模型可能需要截然不同的硬件架构。选择开放权重模型时,应将实际硬件限制和成本与任务表现一起评估。
并发和内存
并发用户数会影响 KV 缓存需求和延迟。
并发带来另一个问题:在保持延迟可接受的情况下,多少用户可以共享一台机器?使用 API 时,token 延迟和吞吐量是服务体验的一部分;使用自己的基础设施时,就必须自行管理这些限制。
许多系统受内存限制。模型参数和每个用户的 KV 缓存都必须放得下,而缓存需求会随用户数增加。因此,我们在各模型适用的硬件配置上测试了可舒适支持的并发量。
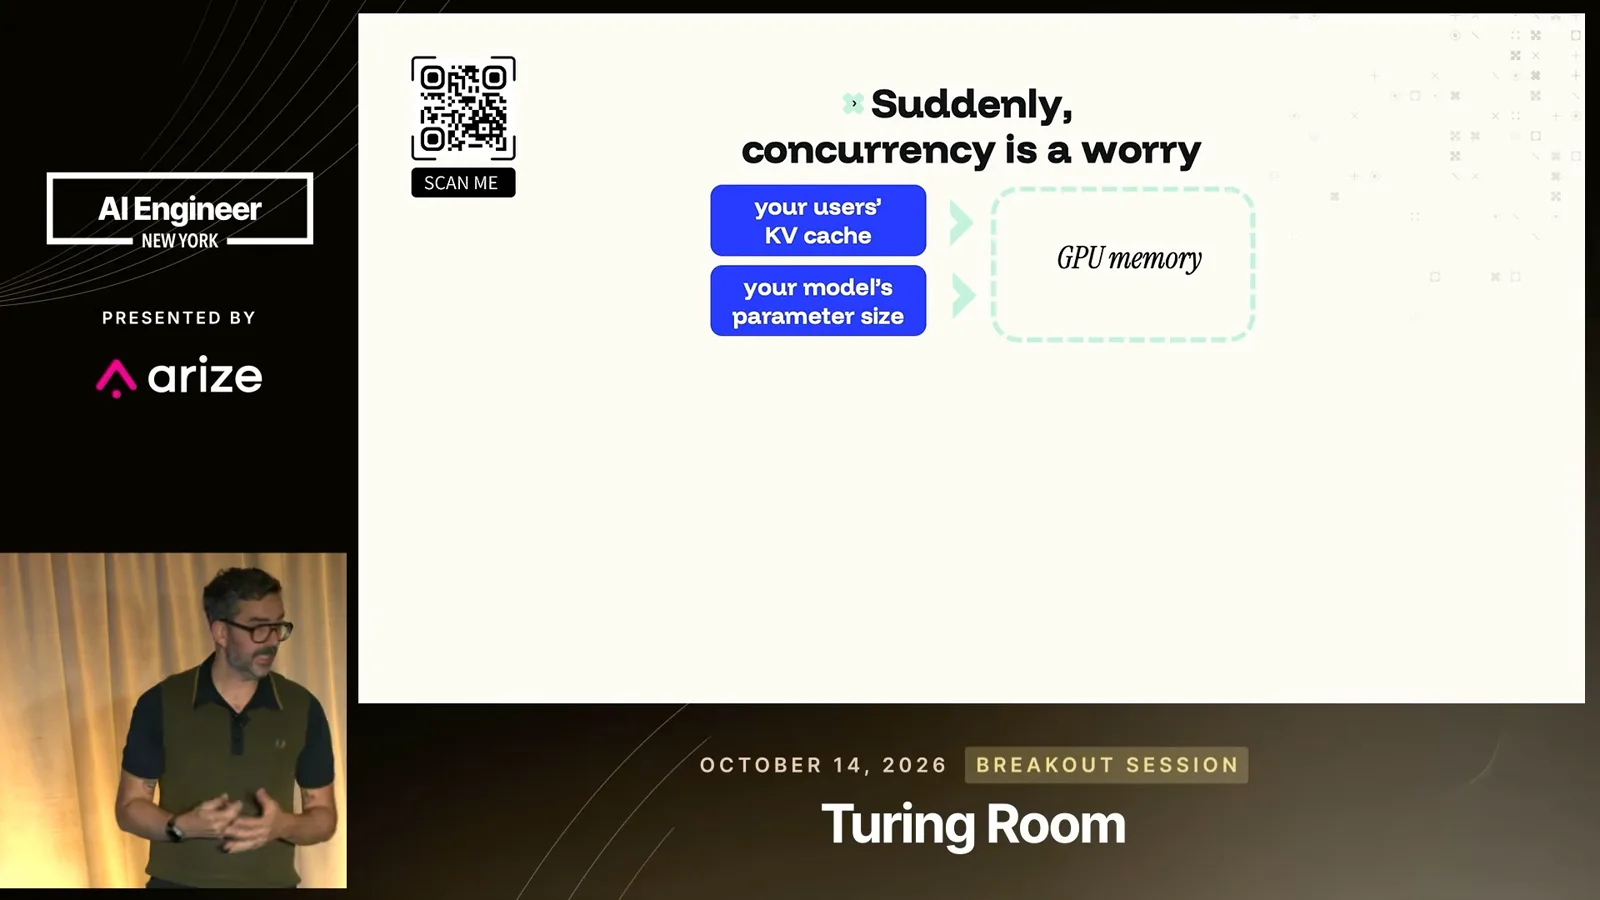
即便使用更大的硬件,较大模型支持的并发用户数仍显著下降,而且我们的配置慢于 Claude Code 基准。在这些长周期任务中,Kimi K3 配置大约能可靠支持四位并发用户,延迟约为该基准的三倍。
API、租赁还是自有设备
经济门槛取决于利用率和配置。
接着,我们从总拥有成本角度比较 API、GPU 租赁和购买。企业也可能出于其他原因选择自有基础设施;我介绍的门槛只适用于这项具体的经济分析。
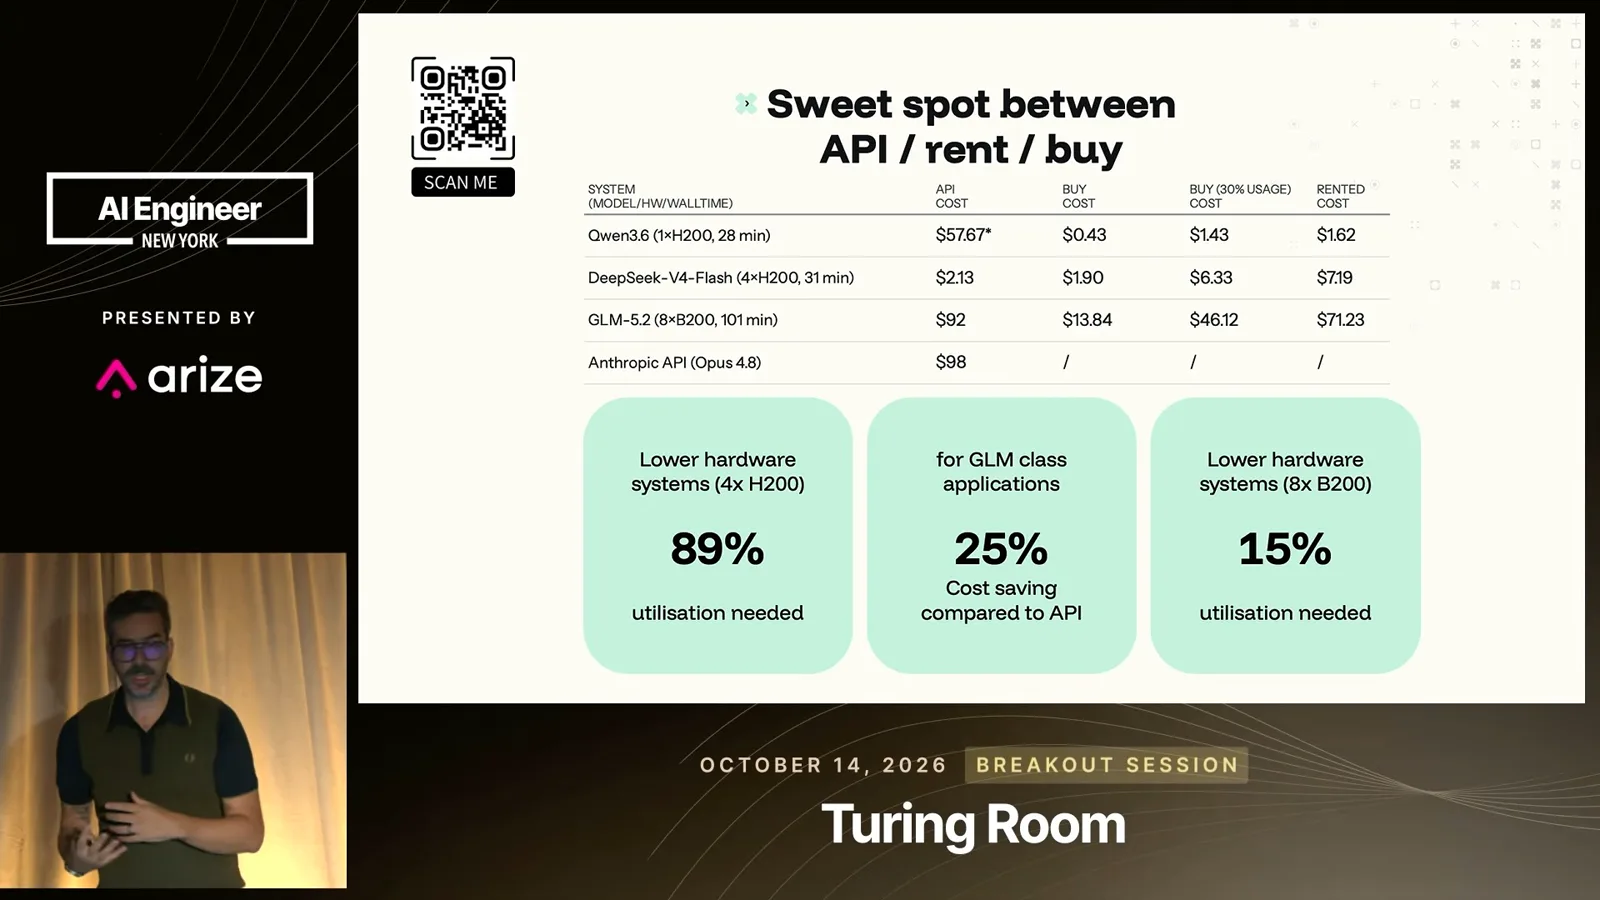
在我们的较低端系统中,离开 API 的盈亏平衡点约为 89% 的 GPU 利用率,也就是说 GPU 几乎需要持续满负荷运行。对于八张 B200 GPU 这样的大型系统,相应利用率约为 15%。这项比较取决于具体工作负载和分析假设。
对于 GLM 级别的编程助手工作负载,我们的研究找到了从 API 转向基础设施开始具有吸引力的区间,估计可节省约 25% 的成本。这是针对所评估应用和配置的估算,并不保证每个组织都能获得同样结果。
运行框架为何重要
相近的任务结果可能对应非常不同的 token 和 GPU 成本。
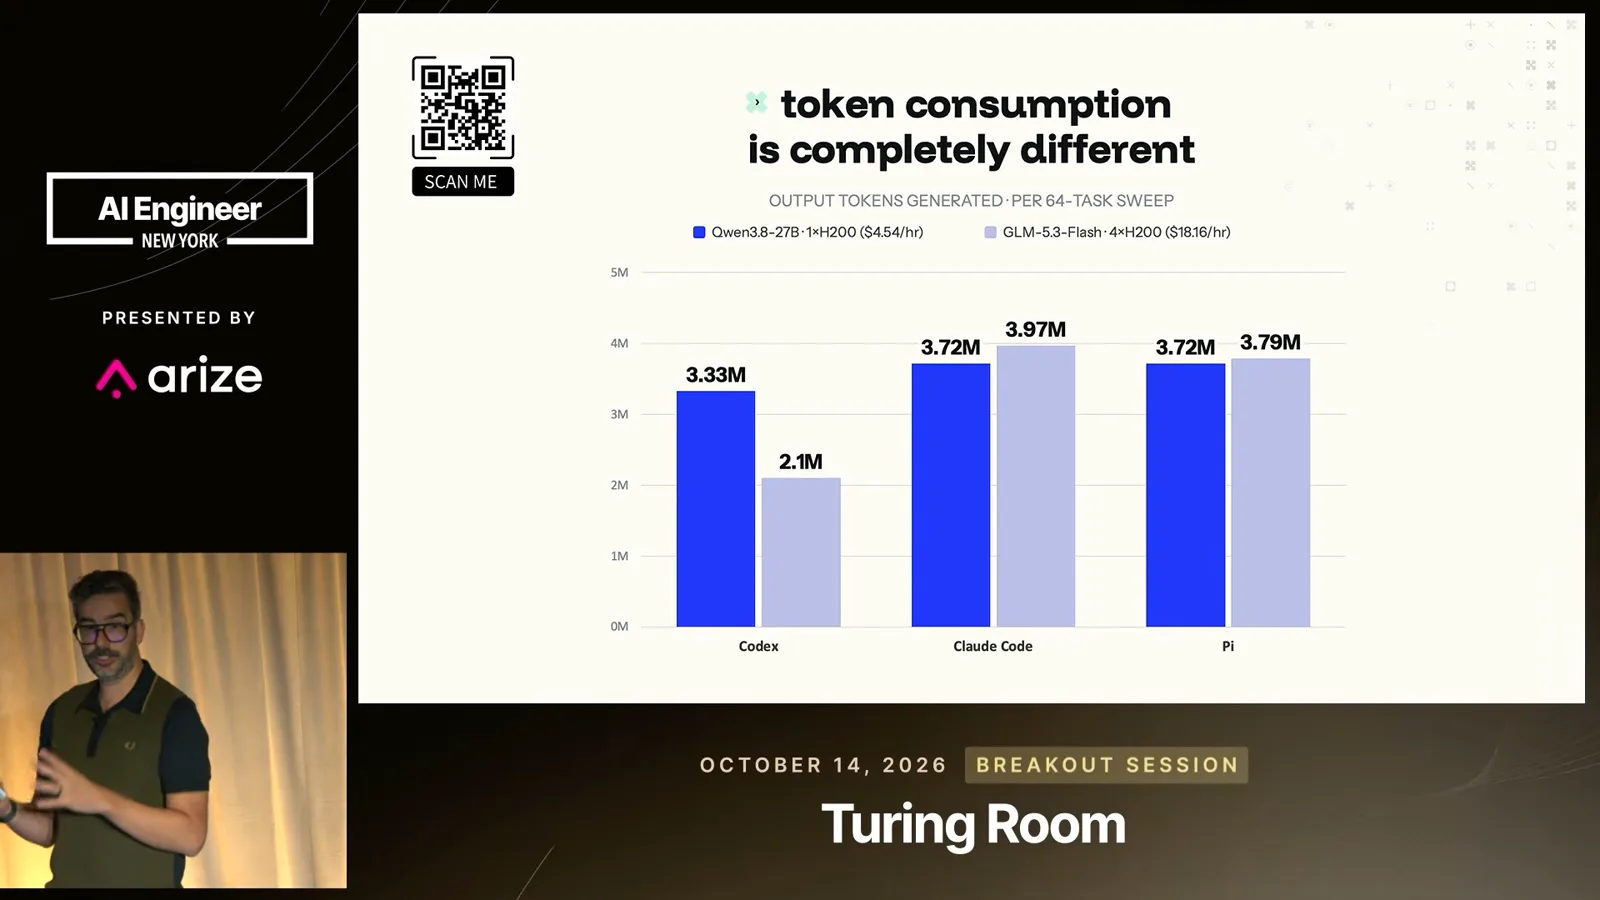
我们还改变了编程运行框架。乍看之下,给定模型时三个框架的任务表现变化不大。这似乎意味着框架影响有限,但在自己承担基础设施费用时,GPU 的实际占用时间就很重要。
不同框架消耗的 token 数量差异很大。在 GLM 的例子中,与比较中的其他框架相比,Codex 生成的 token 约为一半,GPU 实际运行时间也约为一半。因此,任务表现相近并不意味着 GPU 账单相近。
研究局限与下一步
团队计划建立公开基准数据集,并促进软硬件合作。
这只是针对一种应用的初步研究。真实企业会混合多种工作负载,使决策更加复杂。我们还没有充分展开量化以及推测解码等优化的影响,而且模型与硬件也在不断变化。
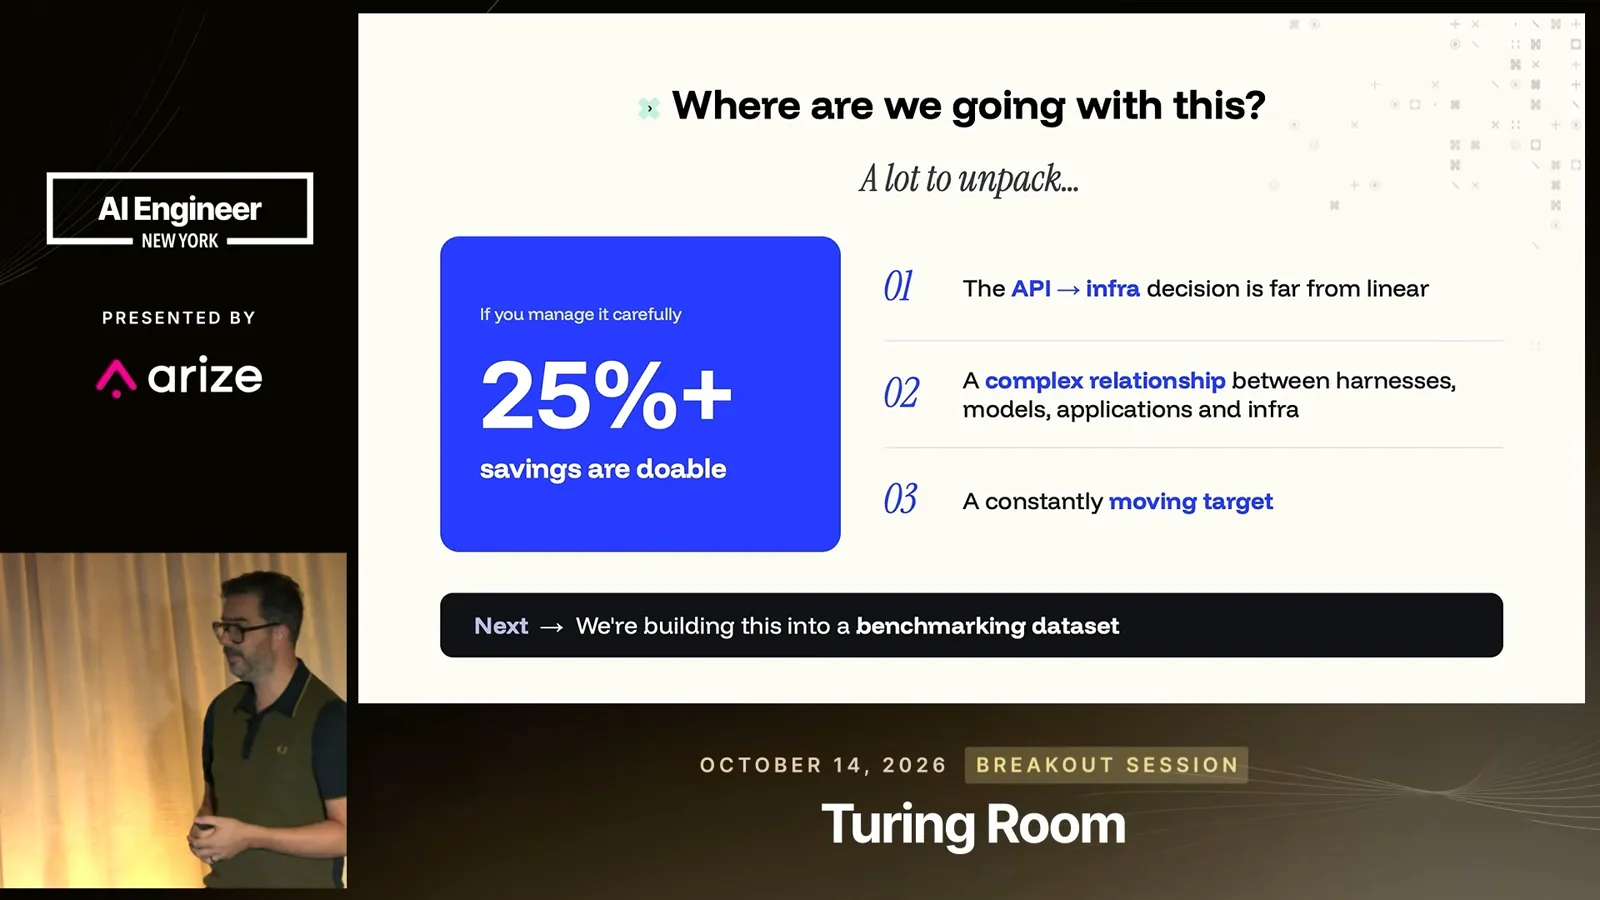
我们正在将基准测试流水线扩展为公开数据集,持续跟踪这一变化中的领域。作为非营利研究机构,imec 也在组建联盟,让软件从业者与芯片及基础设施提供商共同合作,因为双方需要更紧密地协作。
同频道的其他文章
 14:44EN → 简体中文
 AI Engineer· 2026年10月31日Supriya Subudhi:Bumble 测试 AI 功能的五个经验Supriya Subudhi · Bumble积极的测试结果只是开始:使用率、输出质量、模型成本和监管都决定 AI 功能能否扩大规模。
 17:02EN → 简体中文AI Engineer· 2026年10月31日如何评估受监管贷款电话中的语音智能体Brooke Hopkins, Shiv Indap · CovalShiv Indap 与 Brooke Hopkins 介绍持续评估中的人工审核、LLM 评判器和模拟。
 18:45EN → 简体中文AI Engineer· 2026年10月30日Jack Woodruff:AI 时代,选股仍需要人的研究Vinoo Ganesh, Jack Woodruff · KeplerCandlestick Capital 前首席投资官与 Kepler 首席执行官 Vinoo Ganesh 讨论研究、可审计数据,以及 AI 如何重塑投资团队。
 15:27EN → 简体中文AI Engineer· 2026年10月30日Rayan Krishnan:走出模型卡,评估真实任务表现Rayan Krishnan · Vals AIVals AI 联合创始人解释,任务准确率、总成本和企业专属评估为何会改变最合适的模型选择。
 19:06EN → 简体中文AI Engineer· 2026年10月30日Wojciech Pluta:如何决定 AI 智能体应该记住什么Wojciech Pluta · OracleOracle 的 Wojciech Pluta 介绍记忆提升、抵押贷款智能体演示,以及跨会话保留有用信息所需的控制。
 16:43EN → 简体中文AI Engineer· 2026年10月30日Ishween Kaur:如何保护智能体的 x402 支付Ishween Kaur · SoFi通过测试网案例,了解智能体支付流程中的价格变化、重放、提前交付、冒充卖家和提示注入。