30 秒看懂
Upstart 的 Shiv Indap 与 Coval 创始人 Brooke Hopkins 介绍贷款核验语音智能体,以及监测和改进它的控制措施。他们解释人工反馈如何提高合规评判器与审核者的一致率,以及如何测试和批准拟议改动。
- 1核验流程有明确边界智能体必须核验客户身份并提出正确问题。
- 2不断完善评估指标团队将通话中发现的问题转化为不断调整的评估标准。
- 3人工校准评判器据报告,LLM 评判器与审核者的一致率从 33% 提高到 92%。
- 4从多个维度监测评估涵盖结果、流程和对话表现。
- 5上线前进行模拟团队重现故障并审核候选改动。
要点建议
- 语音智能体必须遵守其具体核验流程的规则。
- 人工审核者既反馈智能体的表现,也反馈 LLM 评判器的结果。
- 从 33% 升至 92% 的数字是评判器与人工的一致率,并非合规率。
- 模拟可以重现已观察到的问题并测试候选修复。
- 发布改动的流程仍包含人工和合规团队的批准。
按章节阅读整理后的全文
从自动驾驶到语音智能体
两位演讲者介绍语音智能体评估与贷款场景。
Brooke Hopkins 介绍自己是 Coval 的创始人,公司为语音智能体构建评估系统。她此前在 Waymo 负责评估基础设施。她把语音智能体与自动驾驶汽车相比较:两者都必须在应对多种可能路径、协调多个模型的同时,可靠地从起点到达目标。
Hopkins 说,Coval 与企业合作,帮助其评估用于客户支持和物流等场景的语音智能体。Shiv Indap 随后介绍,自己负责 Upstart 的语音 AI 工作;Upstart 是一家专注贷款的金融科技公司。
Indap 说,Upstart 每天处理数千通电话。贷款是受监管领域,因此语音智能体出错不仅会损害客户体验,还可能造成监管问题。团队的首要要求是在适用规则范围内运行。
受监管的核验流程
身份核验、必问问题与流程限制。
他介绍的用例是信息核验电话。Indap 说,约 90% 的申请人会立即获得决定,其余人需要致电核验信息。智能体询问收入是否预计持续、资金将如何使用,以及是否存在未清偿义务。
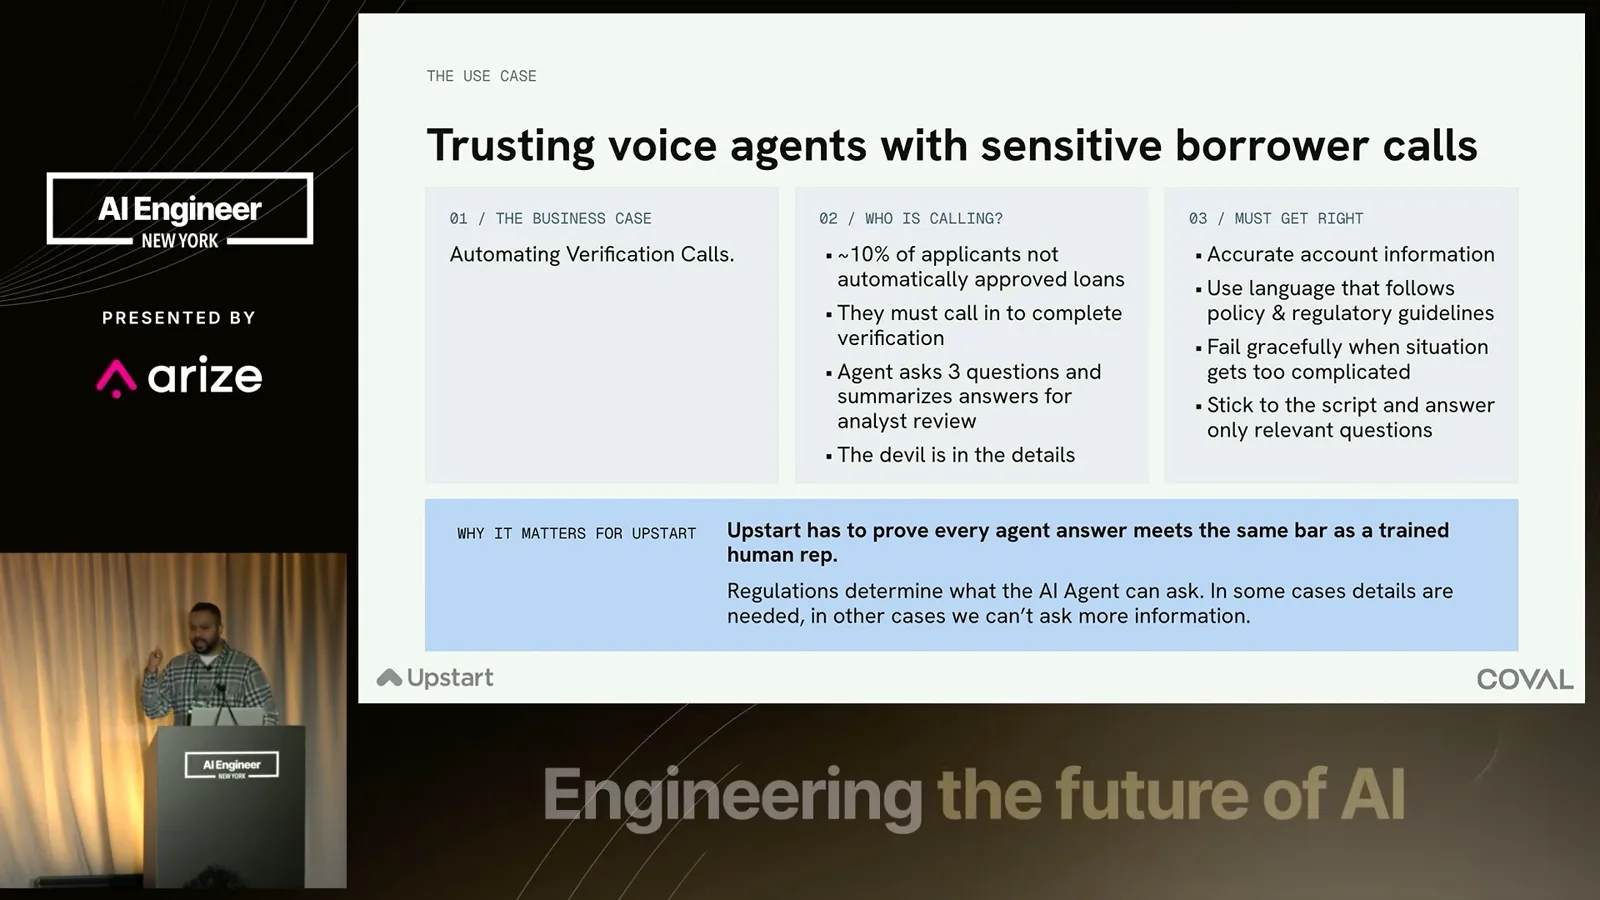
在询问这些问题之前,系统必须核验来电者身份,避免泄露其他人的申请信息。Indap 强调,一旦考虑追问规则,即使简短的话术也可能变得复杂。
他举出团队政策中的一个例子:如果申请人提到资金用于医疗,智能体不能追问金额。另一种回答,例如前往参加毕业典礼,则可能需要澄清是谁的毕业典礼。这些是他针对该工作流给出的例子,并非对贷款法律的一般性说明。
合规团队还要求智能体专注核验任务。Indap 说,如果申请人询问申请进度或何时收到资金,智能体应礼貌地避开自己无权作出的承诺。
把通话问题转化为指标
团队收集故障并完善衡量方式。
团队上线时,每通电话都需要人工审核。运营团队最初使用 Google 表格,但随着多人添加列、以不一致的方式录入信息,流程变得难以管理。Upstart 需要结构化的审核数据,既能改进智能体,也能改进绩效衡量方式。
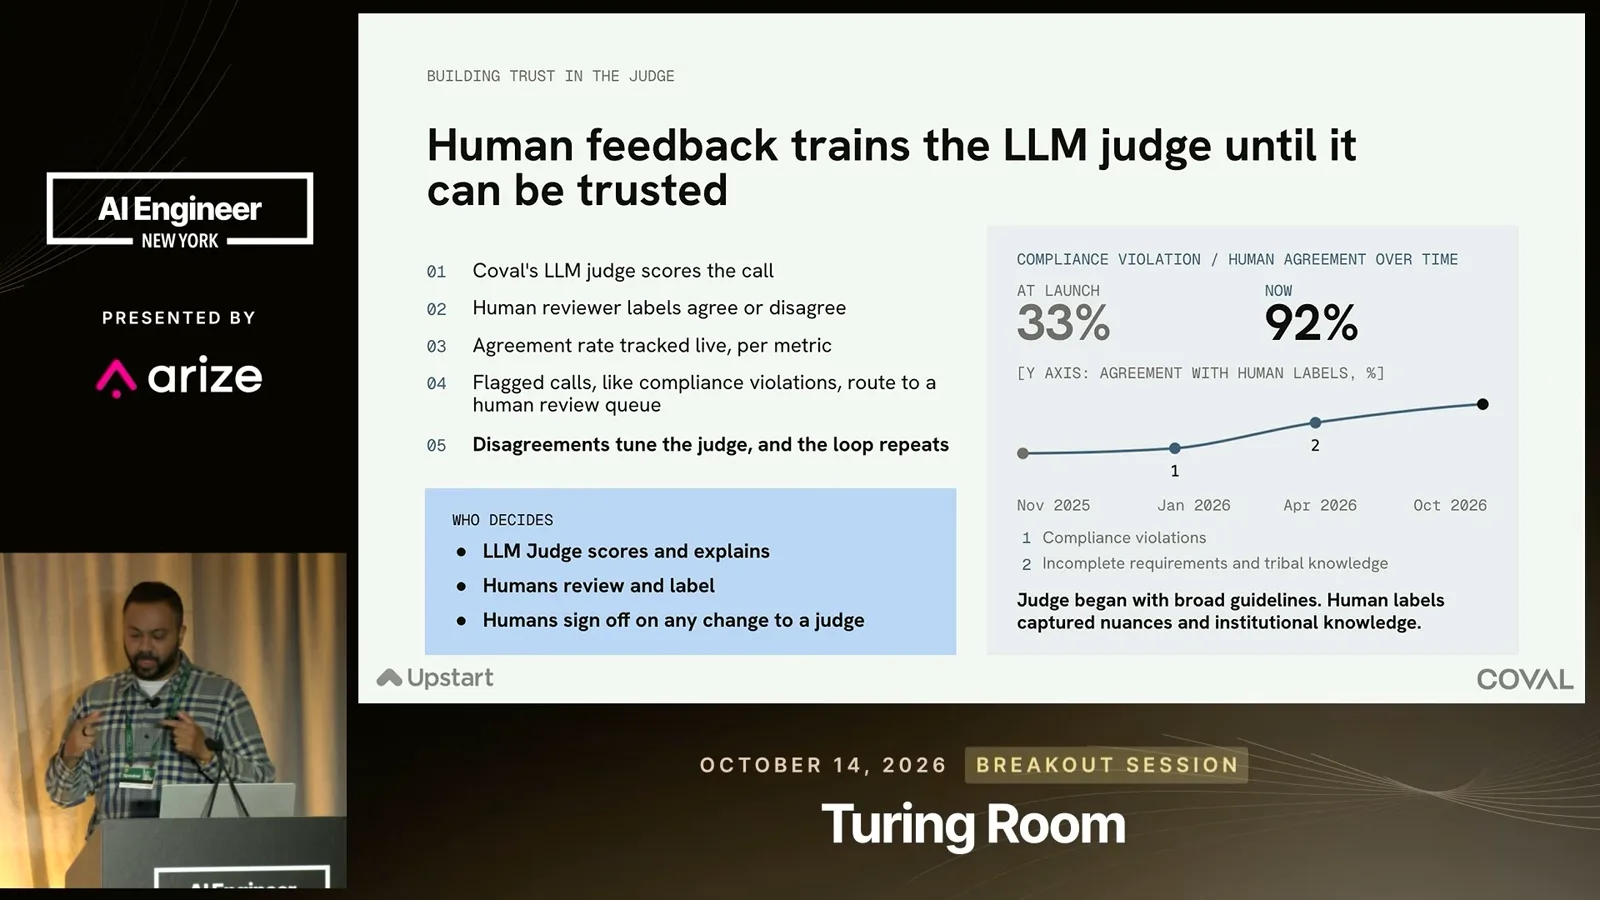
Indap 介绍了通话结束后运行的 LLM 评判器。例如,它可以判断是否满足合规要求并给出解释。随后由人工审核评判器的输出,检查自动评估是否与专家判断一致。
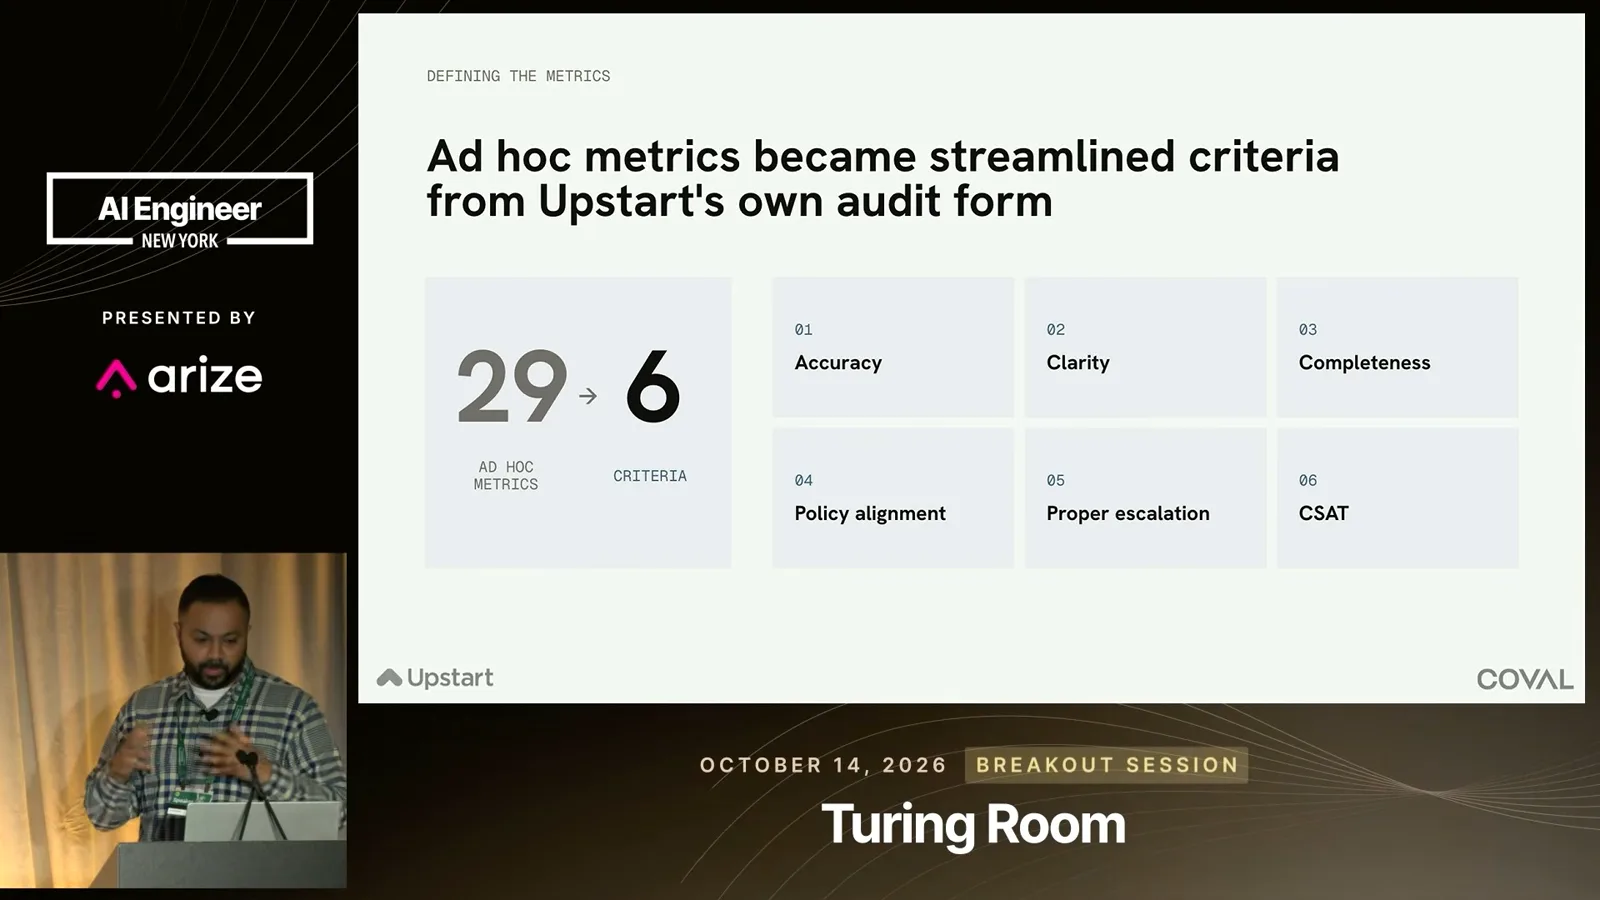
团队最初跟踪广泛指标,随后缩小到准确性、清晰度、完整性、政策一致性、升级处理和客户满意度等方面。Indap 建议团队不要执着于某个指标:先从合理的一组开始,再根据用例揭示的重要因素调整。
人工审核与 LLM 评判器
人工反馈帮助自动评估与审核者保持一致。
在合规评估中,通话被评分后进入队列,由人工审核并反馈。Indap 报告说,流程开始时 LLM 评判器与人工审核者的一致率为 33%,后来升至 92%。这里说的是该评估流程中的一致率,并不意味着每通电话的合规率或准确率为 92%。
团队发现,一些运营经验从未写入智能体或审核标准。由于存在未成文做法,人工审核者之间也有分歧。Indap 说,把这些知识明确写出来,并在更多案例出现时改进评判器,帮助缩小了一致性差距。
Hopkins 接着解释持续改进闭环。单靠发布门槛或许能支持一次上线,却可能让后续更改模型或提示词变得困难。她认为,系统需要持续监控对话、定义指标、标记电话并从审核中学习的流程。
监测、模拟和批准
从观察通话到测试改动的持续循环。
她把评估分为三个问题:智能体是否达成目标、是否遵循必要步骤,以及对话体验如何?团队把标准转为自动评估之前,应先通过人工标注弄清审核者真正关心什么。
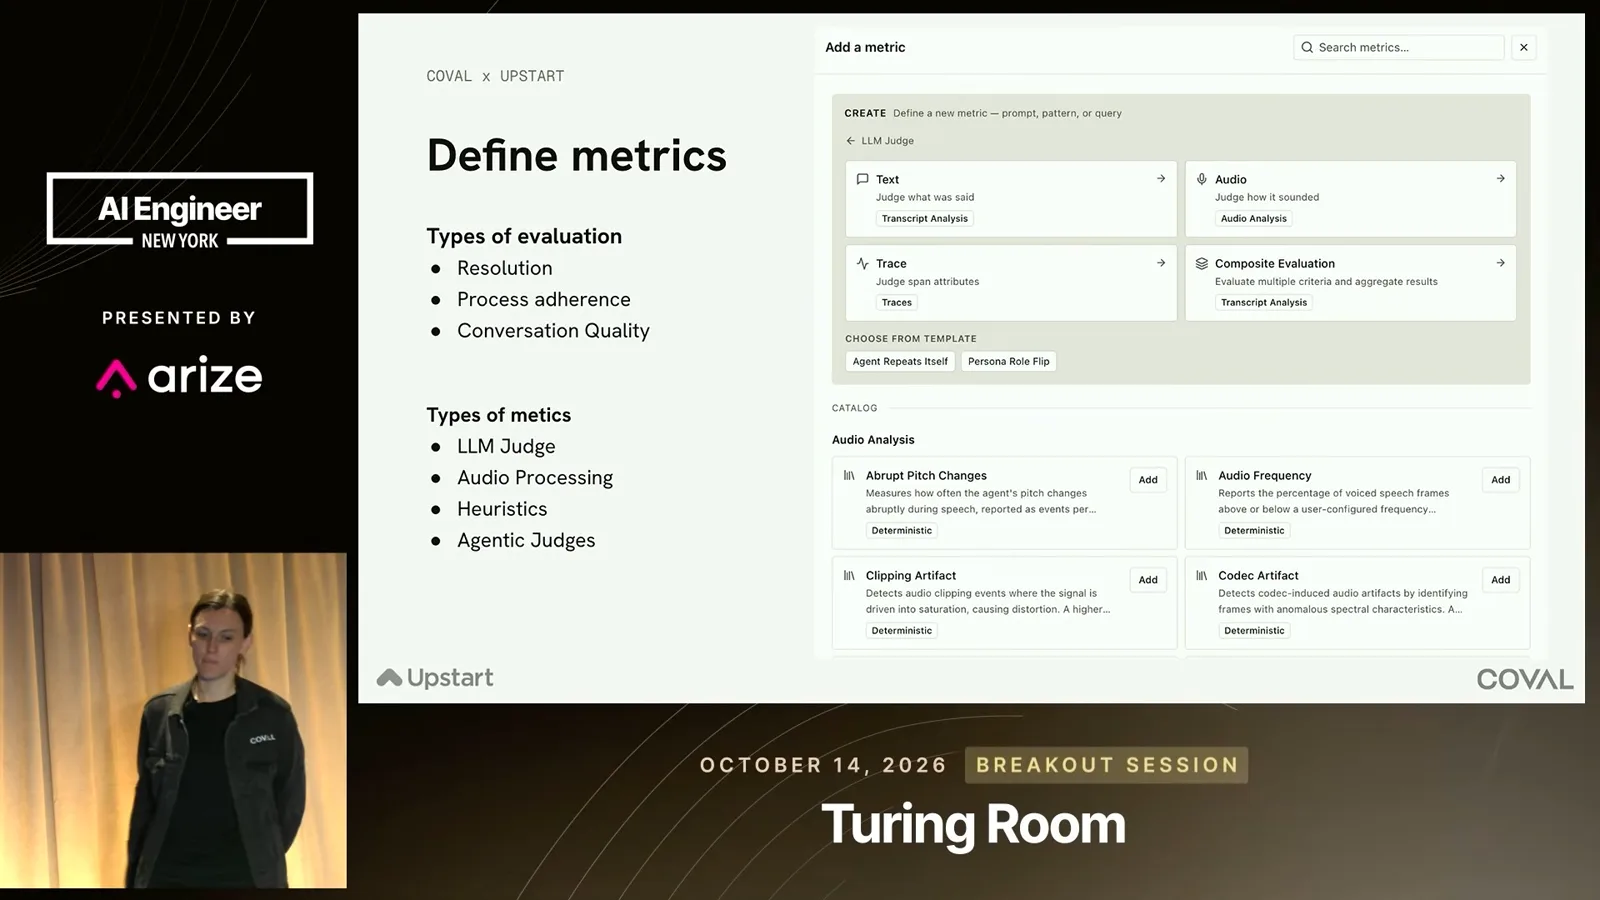
Hopkins 说,团队可以结合 LLM 评判器、启发式规则和音频处理来监控通话。已知模式可能包括漏掉必要核验或用词不正确;聚类和异常检测还可以帮助发现事先没有列出的意外模式。
被标记的通话可以进入人工审核队列,让审核者集中处理最可能重要的案例。Hopkins 强调,发现问题还不够:组织需要一套运营流程,把每个确认的问题分配给能够采取行动的人。
她举例说,错误回答可以交给智能体团队,而合规问题可以交给合规人员采取适当行动。她明确表示,示例中展示的百分比是虚构的,并非实测结果。
理解故障并提出修复后,团队可以在把变化暴露给用户之前重新模拟场景。Hopkins 说,Coval 的语音对语音模拟可以改变背景噪声、口音、语音质量和打断情况,帮助团队检查修复是否解决问题。
她将此称为把检测前移:尽可能在模拟中发现故障,而不是把已知问题再次发布到生产环境、冒险影响更多用户。闭环从依据产品定义指标开始,经过监控、审核、排序和模拟测试。
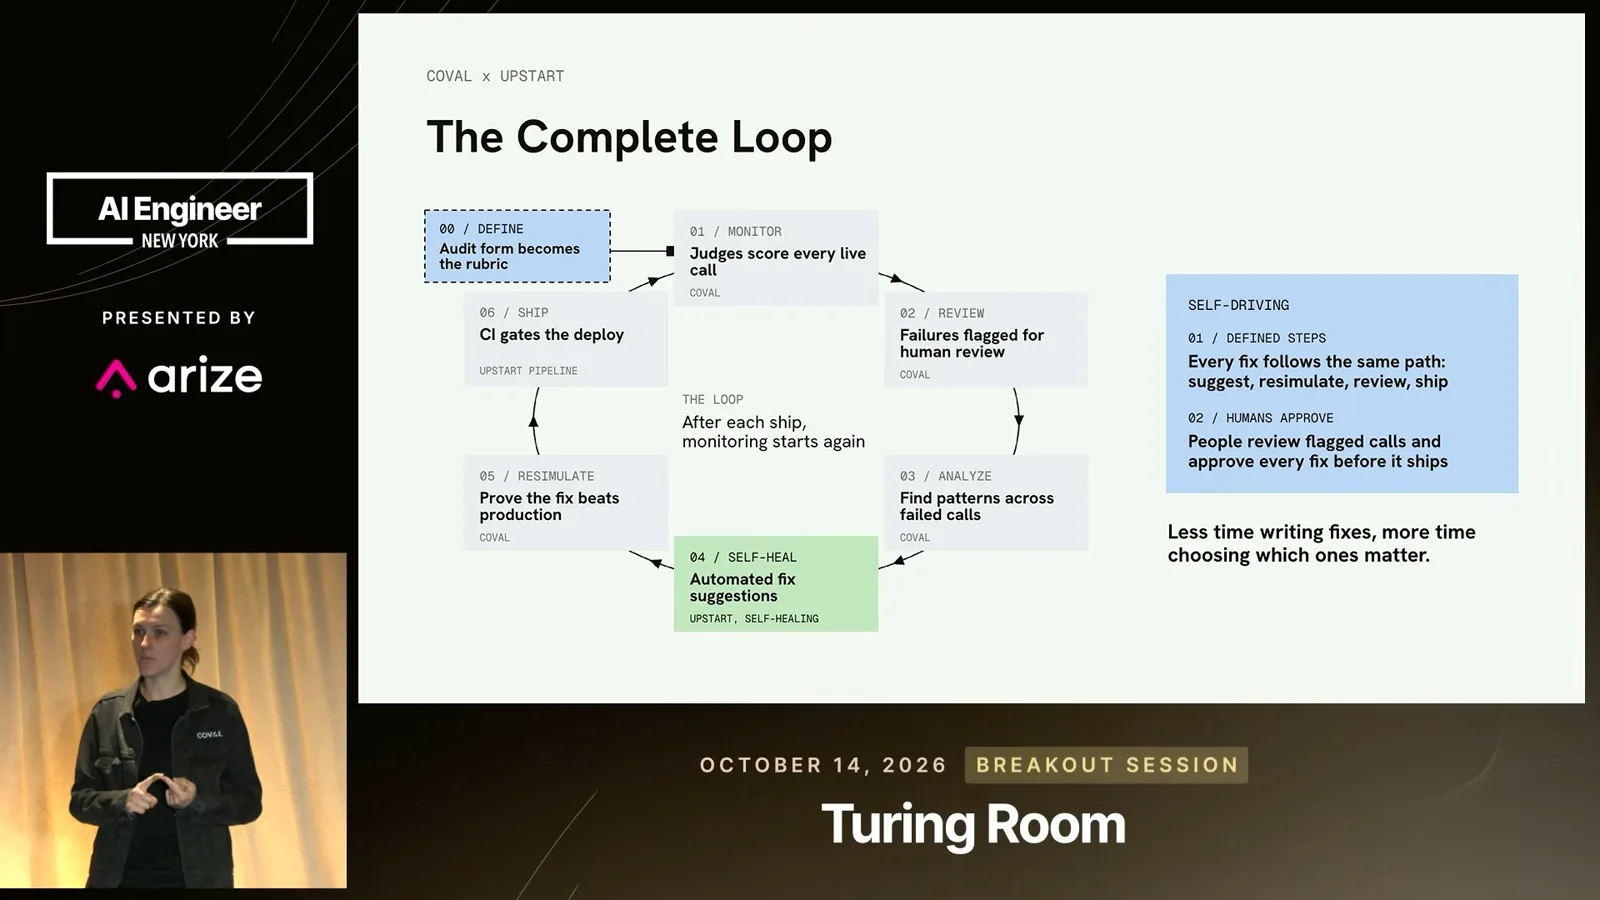
Hopkins 说,评估数据还可以支持自动提出建议、强化学习流水线或微调模型来提出改进。她将其描述为可能的自我修复闭环,但强调变更仍要经过人工审核。
Indap 总结说,当人工无法每天审核数千通电话时,评估可以帮助评分并识别需要关注的通话。审核者的标注可以改进 LLM 评判器,收集的数据也能帮助改进语音智能体。
变更仍受功能开关控制,并需要批准。Indap 说,评判器的更改通常由工程师批准;如果变化影响合规行为,合规人员也会参与。两位演讲者认为,在受监管工作流中改善表现,需要稳健评估和人工监督。
同频道的其他文章
 14:44EN → 简体中文
 AI Engineer· 2026年10月31日Supriya Subudhi:Bumble 测试 AI 功能的五个经验Supriya Subudhi · Bumble积极的测试结果只是开始:使用率、输出质量、模型成本和监管都决定 AI 功能能否扩大规模。
 18:45EN → 简体中文AI Engineer· 2026年10月30日Jack Woodruff:AI 时代,选股仍需要人的研究Vinoo Ganesh, Jack Woodruff · KeplerCandlestick Capital 前首席投资官与 Kepler 首席执行官 Vinoo Ganesh 讨论研究、可审计数据,以及 AI 如何重塑投资团队。
 15:27EN → 简体中文AI Engineer· 2026年10月30日Rayan Krishnan:走出模型卡,评估真实任务表现Rayan Krishnan · Vals AIVals AI 联合创始人解释,任务准确率、总成本和企业专属评估为何会改变最合适的模型选择。
 19:06EN → 简体中文AI Engineer· 2026年10月30日Wojciech Pluta:如何决定 AI 智能体应该记住什么Wojciech Pluta · OracleOracle 的 Wojciech Pluta 介绍记忆提升、抵押贷款智能体演示,以及跨会话保留有用信息所需的控制。
 16:43EN → 简体中文AI Engineer· 2026年10月30日Ishween Kaur:如何保护智能体的 x402 支付Ishween Kaur · SoFi通过测试网案例,了解智能体支付流程中的价格变化、重放、提前交付、冒充卖家和提示注入。
 17:45EN → 简体中文AI Engineer· 2026年10月30日Killian Carlsen-Phelan:引导与验证编程智能体Killian Carlsen-Phelan · SonarSonar 演示如何将项目上下文和确定性检查纳入编程智能体的工作流程。