30 秒看懂
Theo 讨论 Fable 限制的撤销,并结合发布数据、第三方基准及自己的游戏和滑板动作测试分析 Sonnet 5。他认为 Sonnet 有机会成为更强模型工作流中的工具,同时提醒读者,Token 消耗和任务选择可能抵消较低单价的优势。
- 1Fable 限制撤销Theo 根据商务部函件表示,Anthropic 作出承诺后,此前的管制已撤销。
- 2表现需要结合成本比较不同的搜索、电脑操作和编码基准呈现出不同的取舍。
- 3三次游戏重建Theo 更喜欢 Opus 的单次运行结果,并发现 GLM 和 Sonnet 版本存在问题。
- 4成本较高的滑板测试Sonnet 在他的私有测试中得分较低,Max 每题的消耗显著更高。
- 5按难度路由任务Theo 建议将较小任务分配给 Sonnet,将更难的任务升级给更强模型。
- 6拒绝率的取舍系统卡中的恶意和良性请求结果显示出这项评估里的过度拒绝问题。
要点建议
- 每 Token 单价更低,不保证完成任务的成本更低。
- 基准排名和成本取决于评估、推理强度与测试方法。
- 在 Theo 的单次游戏重建中,他更喜欢 Opus 的结果;Sonnet 广泛使用委派,但耗时更长。
- Sonnet 的子代理编排可能适合大型工作流,但 Theo 尚未验证他提出的路由策略。
- 视频讨论的发布期限制、价格和可用性具有时效性。
按章节阅读整理后的全文
Fable 管制与 Sonnet 5
Theo 讨论出口限制的撤销,并介绍 Sonnet 的代理能力。
Sonnet 5 发布了,我一直在测试它的优缺点。另一条消息对我更重要:商务部长撤销了对 Fable 5 的限制。录制时模型尚未恢复使用,但我预计很快会有变化。
Fable 发布三天后的 6 月 12 日受到限制,原因涉及黑客能力及外国行为者的使用。按照我对后续商务部函件的理解,Anthropic 同意主动发现安全风险、合作制定协议并报告恶意活动;此前的管制因此撤销,但决定仍可能重新评估。
我的理解是,撤销管制对通过 API 托管模型并向用户提供服务的平台也很重要,例如 T3 Chat。我此前担心这类访问仍会受限。这是我对当时公告的理解,具体规则仍需自行查阅。
Anthropic 称 Sonnet 5 是其代理能力最强的 Sonnet:它能规划、使用浏览器和终端,并自主运行。我认为数字“5”很重要,因为它处理代理工作的方式有变化。在我看来,产品线整体上移了:以前交给 Haiku 的工作现在交给 Sonnet,Sonnet 的交给 Opus,Opus 的交给 Fable。
基准测试与任务成本
他比较 Anthropic、Cursor 和 Artificial Analysis 的结果,并区分 Token 单价与任务成本。
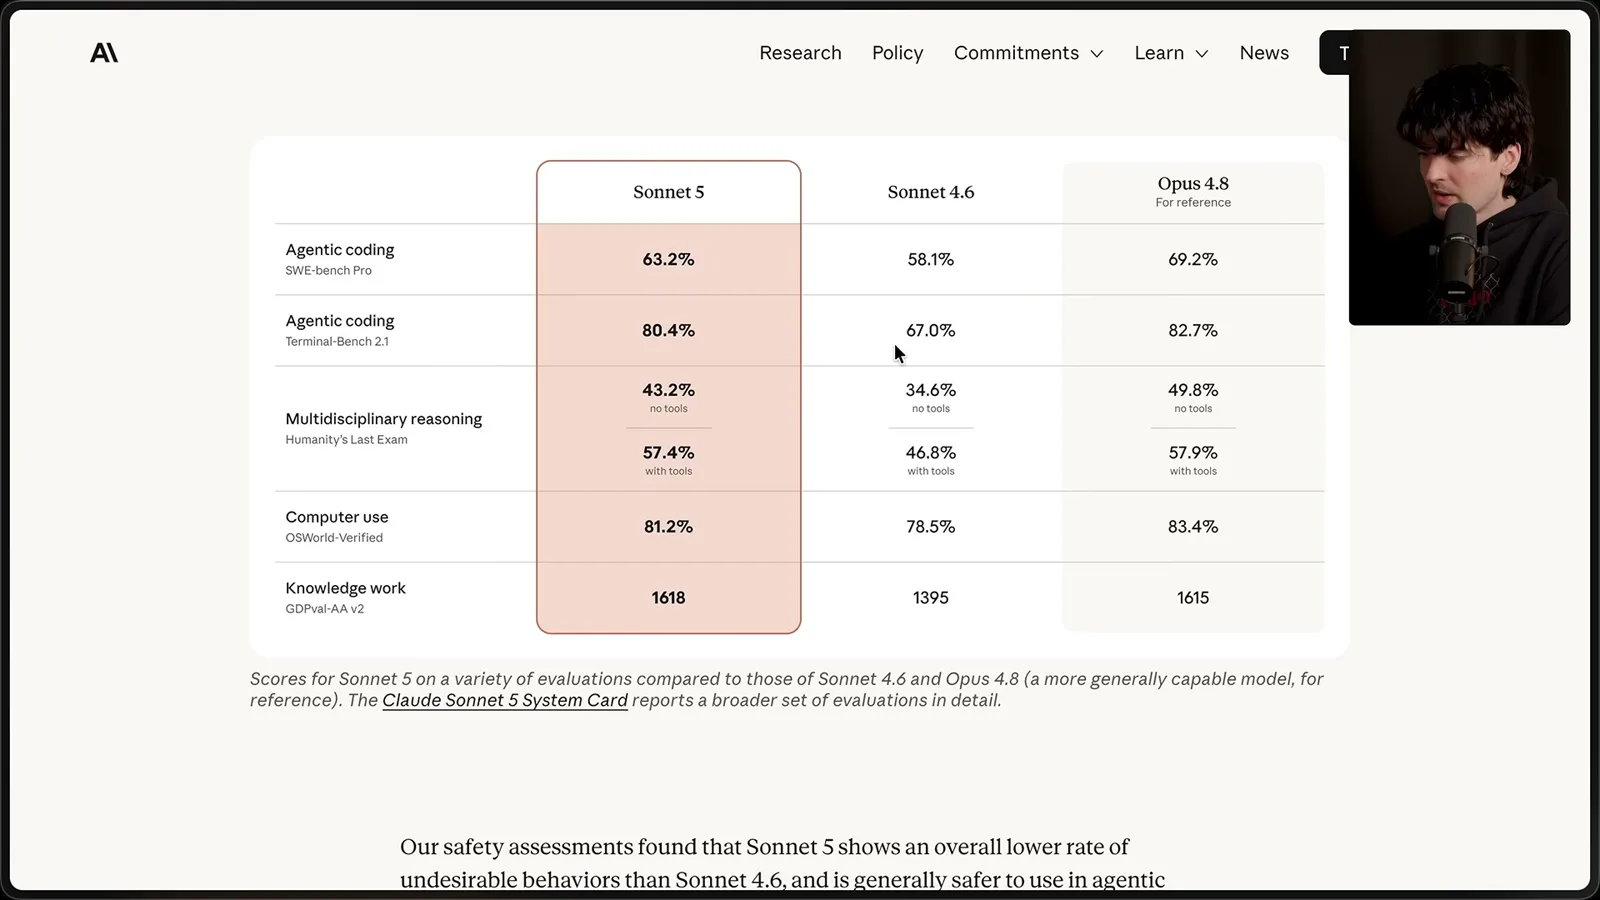
Anthropic 报告称,Sonnet 5 在推理、编码、工具使用和知识工作方面优于 Sonnet 4.6,表现接近 Opus 4.8。表格显示 Terminal-Bench 从 67% 升至 80.4%,电脑操作能力的增幅较小。我质疑 SWE-bench 分数的参考价值,因为我认为测试存在严重污染;这是我的担忧,并不能证明每个单独结果都受到污染。
公司的图表比较了不同推理强度下 BrowseComp 和 OSWorld-Verified 的表现与成本。我认为搜索结果有竞争力,尤其是在较低强度下;但电脑操作图表中,Opus 的性价比看起来更好。我查看的 Cursor Bench 结果也显示,Sonnet 的一些配置比相应的 GPT-5.5 配置更贵、表现更差。这些比较都限于各自的基准。
Artificial Analysis 的指数将 Sonnet 排在前列,但更吸引我的是成本数据。我引用的全套基准运行成本约为 Sonnet 6,000 美元、Fable 5,600 美元。我猜测每任务平均值和总成本对极端运行的处理方式不同,但尚未向研究人员确认计算方法。
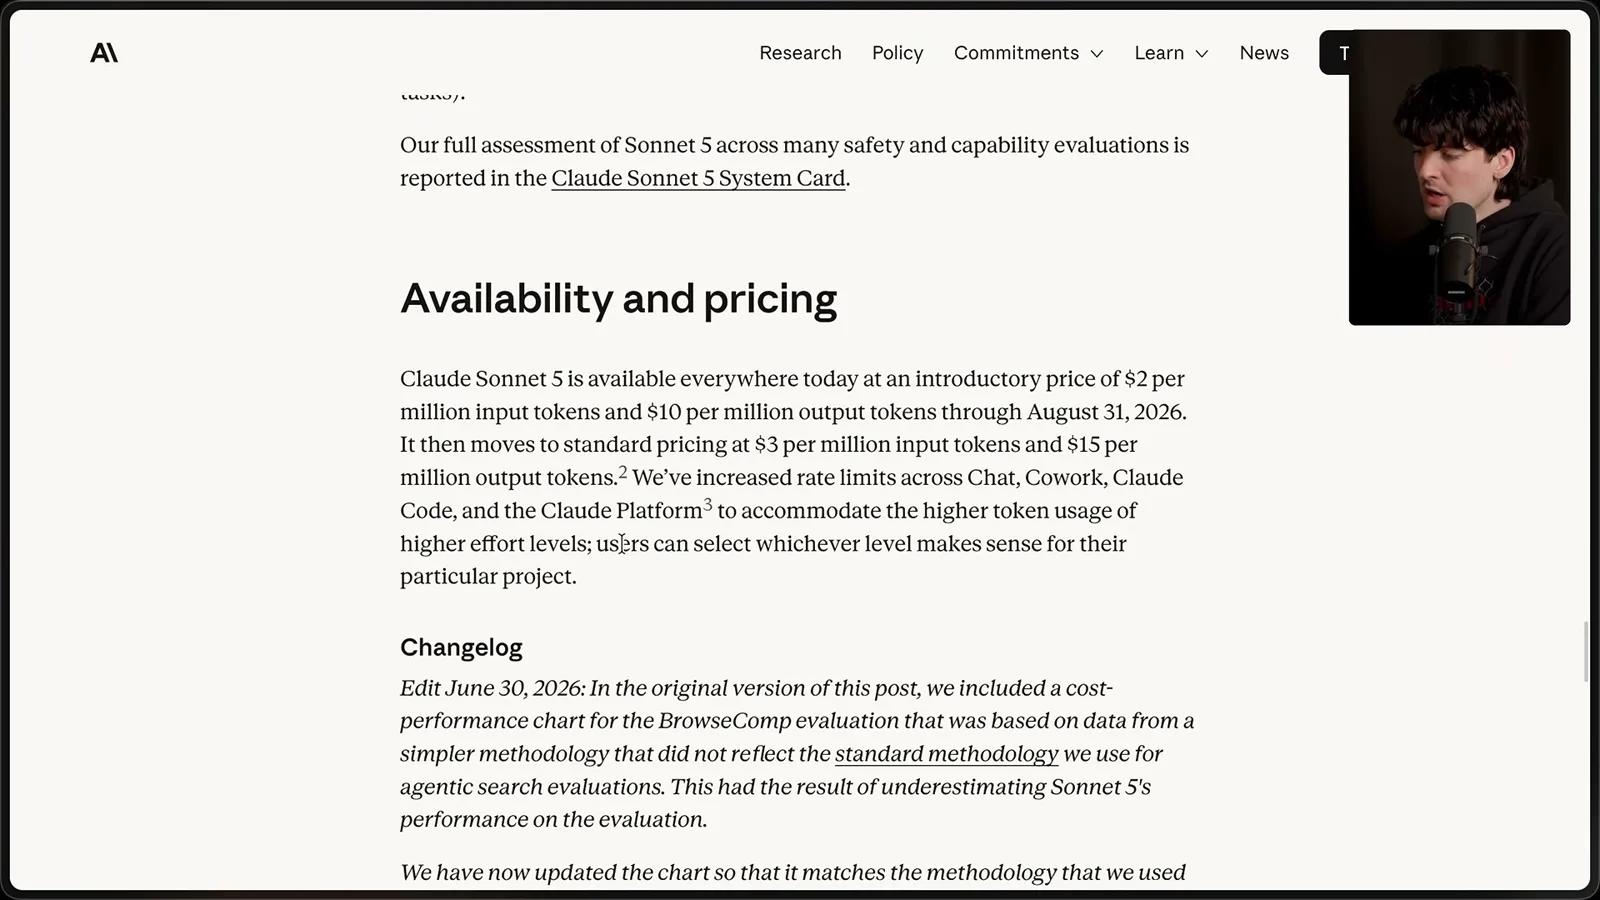
Anthropic 宣传的较低价格是每个 Token 的价格,并不一定意味着完成任务更便宜。发布公告称,优惠价截至 2026 年 8 月 31 日,每百万输入 Token 2 美元、输出 Token 10 美元;之后分别为 3 美元和 15 美元。我还提到订阅计划中单独的 Sonnet 限额已取消。这些都是发布时的信息,可能发生变化。
在我引用的 Token 用量图中,Sonnet 使用约 69,000 个 Token,接近 Opus 的两倍,也达到 xhigh 档 GPT-5.5 的数倍。在我的实际工作中,它也显得很慢。Token 用量和成本取决于任务、推理强度及测试设置,一张图无法说明所有用途。
重建游戏与 SkateBench
Theo 比较三次独立的游戏重建运行,并报告自己的滑板动作基准测试。
我让 Opus 4.8、GLM 5.2 和 Sonnet 5 从头重建我的鱼类网页游戏,允许它们参考原仓库和素材。Opus 大约用了 26 至 27 分钟。界面还有粗糙之处,也有我不喜欢的创意选择,但操控、核心循环和经济系统使它成为一个可玩的起点。
我使用的工具显示 GLM 版本花费 8.30 美元,耗时约 35 至 40 分钟。我觉得它的移动卡顿、经济系统糟糕,射击方向也不对。我还指出,所用的 GLM 配置没有视觉能力,限制了它通过浏览器画面检查结果。
Sonnet 的版本移除了购买快捷键,初始没有鱼,点击购买按钮时还会发射子弹。经济系统的体验也不好。我估计这次运行至少花了两小时,可能接近两个半小时;我没有精确计时。这些是单次运行的观察,并非受控研究。
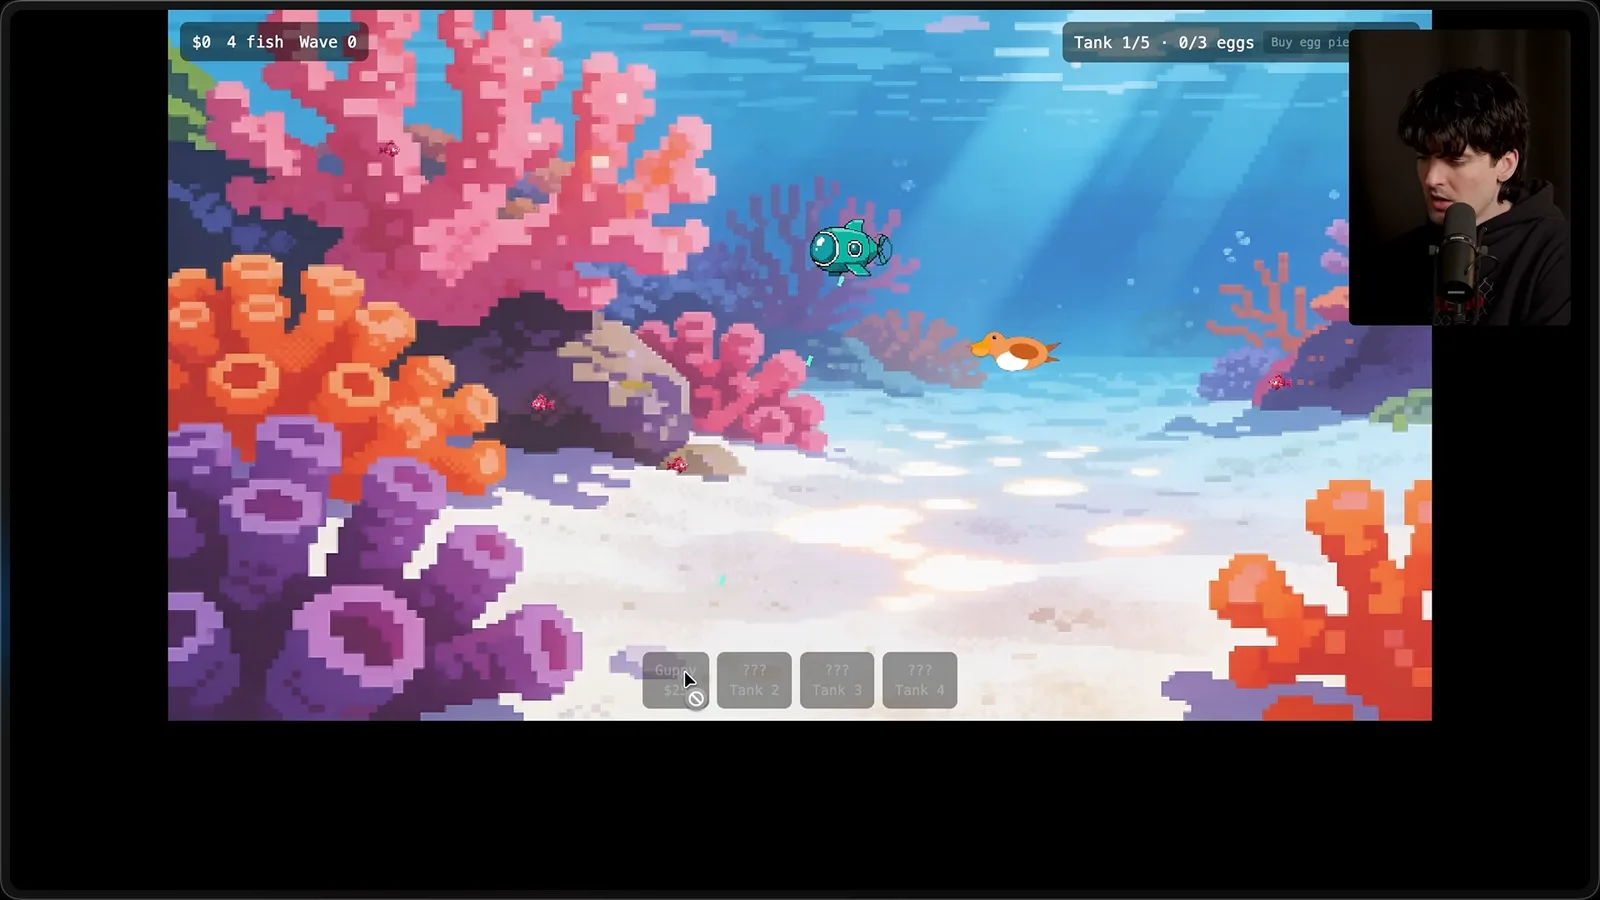
Sonnet 主动启动代理来检查旧代码、制定和审查计划,然后实施。它还提出了一些有助于界定范围的问题;相同提示下,Opus 没有提问,也没有启动子代理。我喜欢拆分和委派工作的能力,但我认为这次运行拆得过多,结果绕了不少圈子。
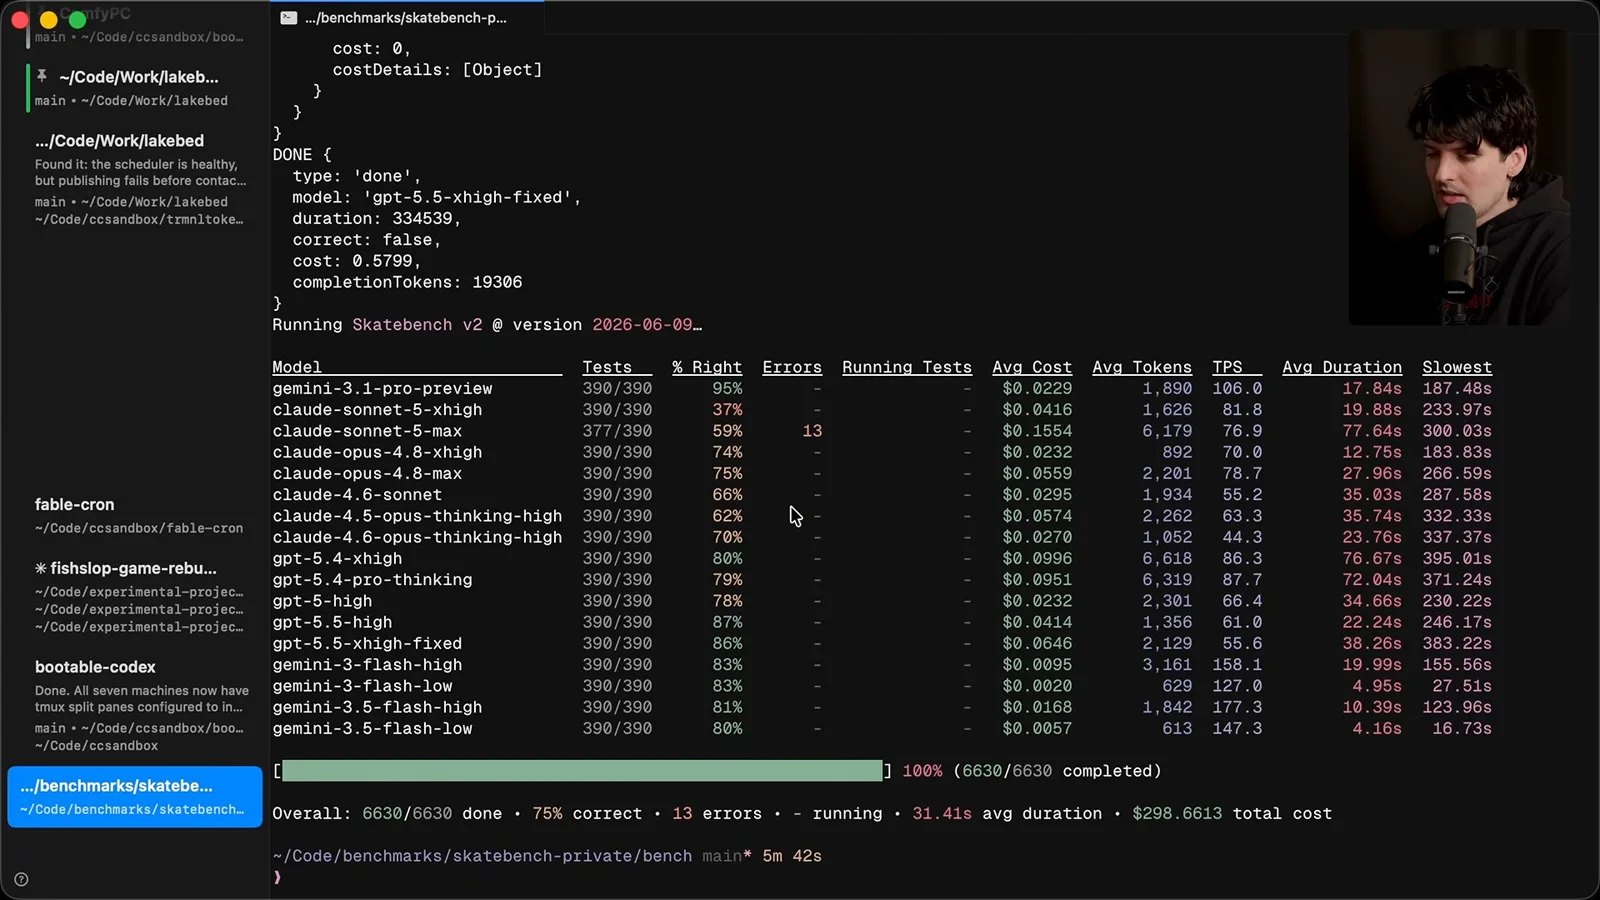
我还让 Sonnet 处理 SkateBench 的一些错误,但因为耗时太长而放弃。我的滑板动作命名基准此前受到污染,于是我增加了私有题目。在这次测试中,Gemini 3.1 Pro 得分 95%;Sonnet 5 xhigh 得分 37%,每题约 4 美分;Max 得分 59%,每题约 15 美分,部分错误答案甚至花了约 1 美元。
路由与编排
他用工程师薪酬的比喻解释为什么便宜模型处理难题时可能更贵。
可以用一位每小时 20 美元的初级工程师和一位每小时 100 美元的资深工程师作比喻。十小时的任务分别花 200 美元和 1,000 美元;但如果初级工程师用了 100 小时,就要花 2,000 美元。困难任务耗时过长时,较低单价可能失去优势,尤其是在没有人决定何时升级处理的情况下。
因此,模型路由成了工程问题。更强的编排模型可以把适合的小任务交给 Sonnet,把更难的任务升级给 Opus 或 Fable。平衡得当或许能省钱;选错时,单价更低的模型反而可能造成更高的总成本。
系统卡的 FrontierCode 图表中,Sonnet 的测量成本从低强度时每任务不到 1 美元升至 Max 的约 12 美元,成功率也随之提高。我认为低档和中档可能有性价比,但在这项特定评估中,其他模型在较高强度下看起来更有效率。
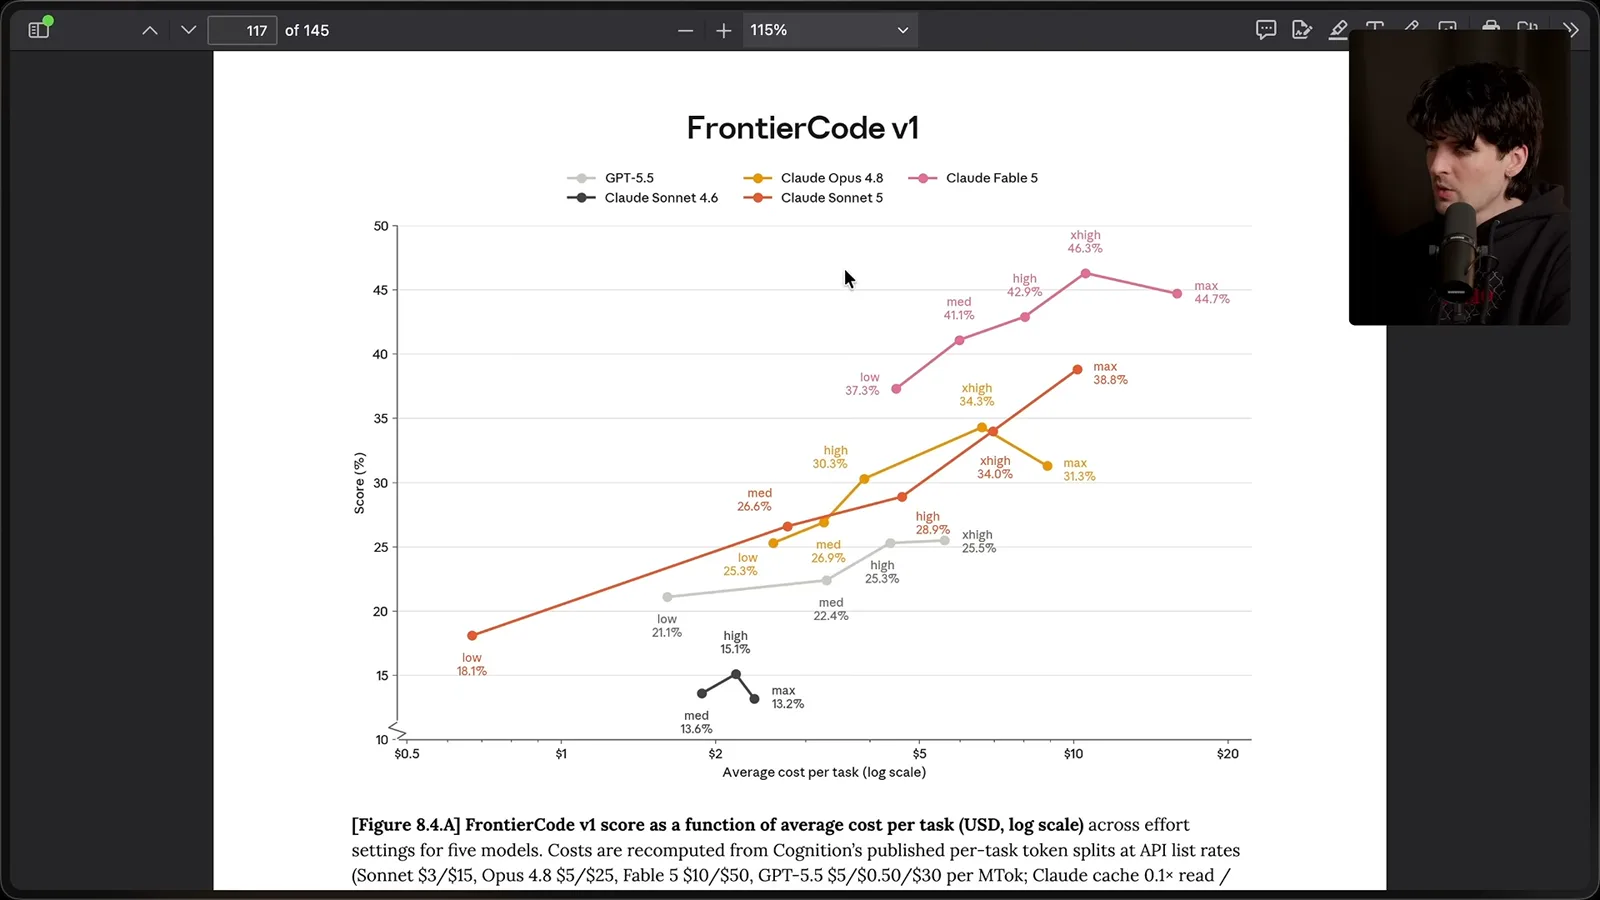
在 Cursor Bench 中,我认为 GPT-5.5 和 Fable 位于表现与成本曲线上较有吸引力的位置。日常工作里,能用 GPT-5.5 完成的任务我会交给它,更难的任务则交给 Fable。我更愿意把 Sonnet 看成大型工作流中可供代理调用的工具,而不是自己的默认编程模型。
设想 Fable 将复杂工作分成多个流程,Sonnet 处理其中一个子任务,并在适当时进一步委派。我对这种可能性感到兴奋,但这还是设想,并非已经验证的结果。我对于 Anthropic 为何发布这个模型而不是 Opus 5 的猜测也只是推测。
安全与行为报告
他查看拒绝率表和一位观众关于思考过程暴露的报告,并区分观察与推测。
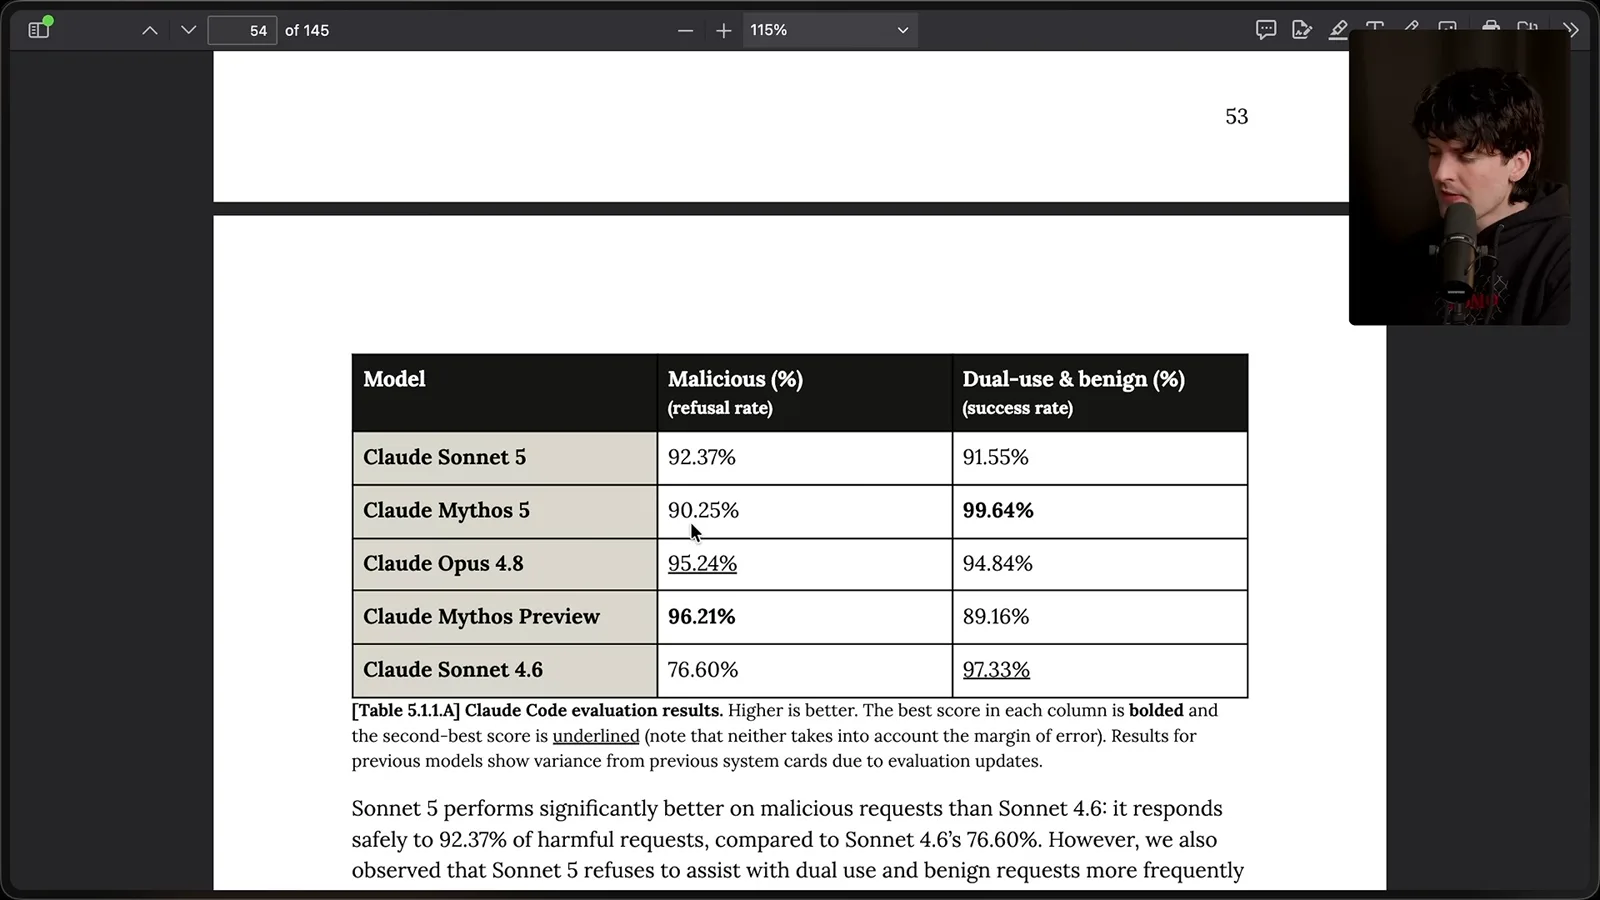
系统卡对比了模型拒绝恶意请求的比例,以及处理良性或双重用途请求的成功率。其中 Sonnet 5 的恶意请求拒绝率为 92.37%,良性或双重用途请求成功率为 91.55%;Mythos 5 在后一项上为 99.64%。我担心不必要的拒绝,但这张表只是有限的评估,并非完整安全结论。
一位观众报告称,某个 Claude.ai 账号出现了疑似思考过程泄露。我查看了模型反复讨论是否搜索或如何回答简单问题的例子。我觉得这种行为很别扭,并猜测它与 Token 浪费有关,但单个账号的报告无法证明原因或影响范围。
污染与结论
Theo 质疑基准污染问题,并提出 Sonnet 在大型代理工作流中可能发挥的作用。
系统卡讨论了生物、数学和 BrowseComp 等多项评估的污染问题。我认可这种讨论,但批评它对 SWE-bench 的处理:该基准基于公开的历史拉取请求,我认为这使训练数据污染成为严重问题。不过,公开可获得并不证明某个模型看过每一道答案。
我的播客搭档 Ben 对 Sonnet 的并行代理行为感到兴奋,但他发表评论时还没有检查完成的工作。我已经测试过,对它替代 Opus 的表现没那么满意。我希望更强的模型能用 Sonnet 处理独立任务,或许它还能在需要时提示升级处理,但这个想法我尚未验证。
目前我会继续使用 GPT-5.5 和 Opus,等 Fable 恢复访问后再切回去。我对能够拆解复杂工作的模型感到兴奋,但我认为 Sonnet 还不足以独自稳定发挥这一能力。它仍可能在精心编排的工作流中找到有用的位置。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。