30 秒看懂
Matthew Berman 演示 Stanford 的开源项目 STORM:它围绕主题开展研究,生成带参考资料、结构类似维基百科的文章。他安装了该工具的 2024 年版本,配置 OpenAI 和 You.com 凭据,并运行 Streamlit 演示。 生成的犬类文章包含章节和来源链接,但演示并未独立验证文中的主张。Berman 还讨论了本地模型选项,但没有展示成功的完全本地配置。
- 1带引用的研究草稿Berman 展示了一篇按主题组织、附有参考资料的 AI 概览。结果是一篇类似维基百科的草稿,并非发布到维基百科上的文章。
- 2本地界面,外部服务应用在他的电脑上运行,但演示使用 OpenAI 进行模型调用,用 You.com 搜索。
- 3安装项目他克隆 STORM 仓库,创建 Python 3.11 conda 环境,并安装 2024 年教程中列出的依赖。
- 4研究犬类演示中,工具识别研究视角、浏览网页,并生成带章节和链接的文章。读者应核查来源及其是否支持各项主张。
- 5本地模型选项尚未测试Berman 指出一个使用 vLLM 和 Mistral 的示例,但表示自己尚未配置,也没有让 Ollama 成功运行。
要点建议
- STORM 通过研究和检索来源,为选定主题生成结构化、带引用的文章草稿。
- 演示界面在本地运行,但调用 OpenAI 和 You.com 时会使用外部服务。
- 引用链接是核查主张的起点,并不能证明主张正确。
- 2024 年 7 月视频中的配置步骤和服务条款可能已经变化。
- Berman 提到了 vLLM 和 Mistral 的示例,但没有展示其在本地成功运行。
按章节阅读整理后的全文
STORM 及其研究成果
Berman 介绍这个 Stanford 项目,并展示一篇附参考资料的人工智能概览。他解释了界面可以在本地运行,但演示使用了 OpenAI。
Stanford 的一个项目 STORM 能够接收一个主题,开展研究,并生成一篇类似维基百科的文章。在我生成的人工智能示例中,它将内容分为商业、医疗、教育和安全等领域,并在正文旁附上参考资料。结果是一份研究草稿,并非发布到维基百科上的页面。
项目是开源的,我在自己的电脑上运行界面。但这次演示仍会调用 OpenAI API,网页搜索也使用外部服务。安装之前,你可以试用在线版 STORM 演示,查看它已经生成的文章。录制时,网站还展示了一种即将推出的人机协作模式。
试用演示并安装 STORM
他访问在线演示,然后克隆仓库。他创建 conda 环境并安装 Python 依赖。
STORM 的全称是 Synthesis of Topic Outlines through Retrieval and Multi-perspective Question Asking,意为通过检索和多视角提问综合主题大纲。它的研究过程会考虑不同视角,然后组织并撰写文章。我之前遇到过需要修改代码的错误,但这次演示中的安装无需该修复也能运行。
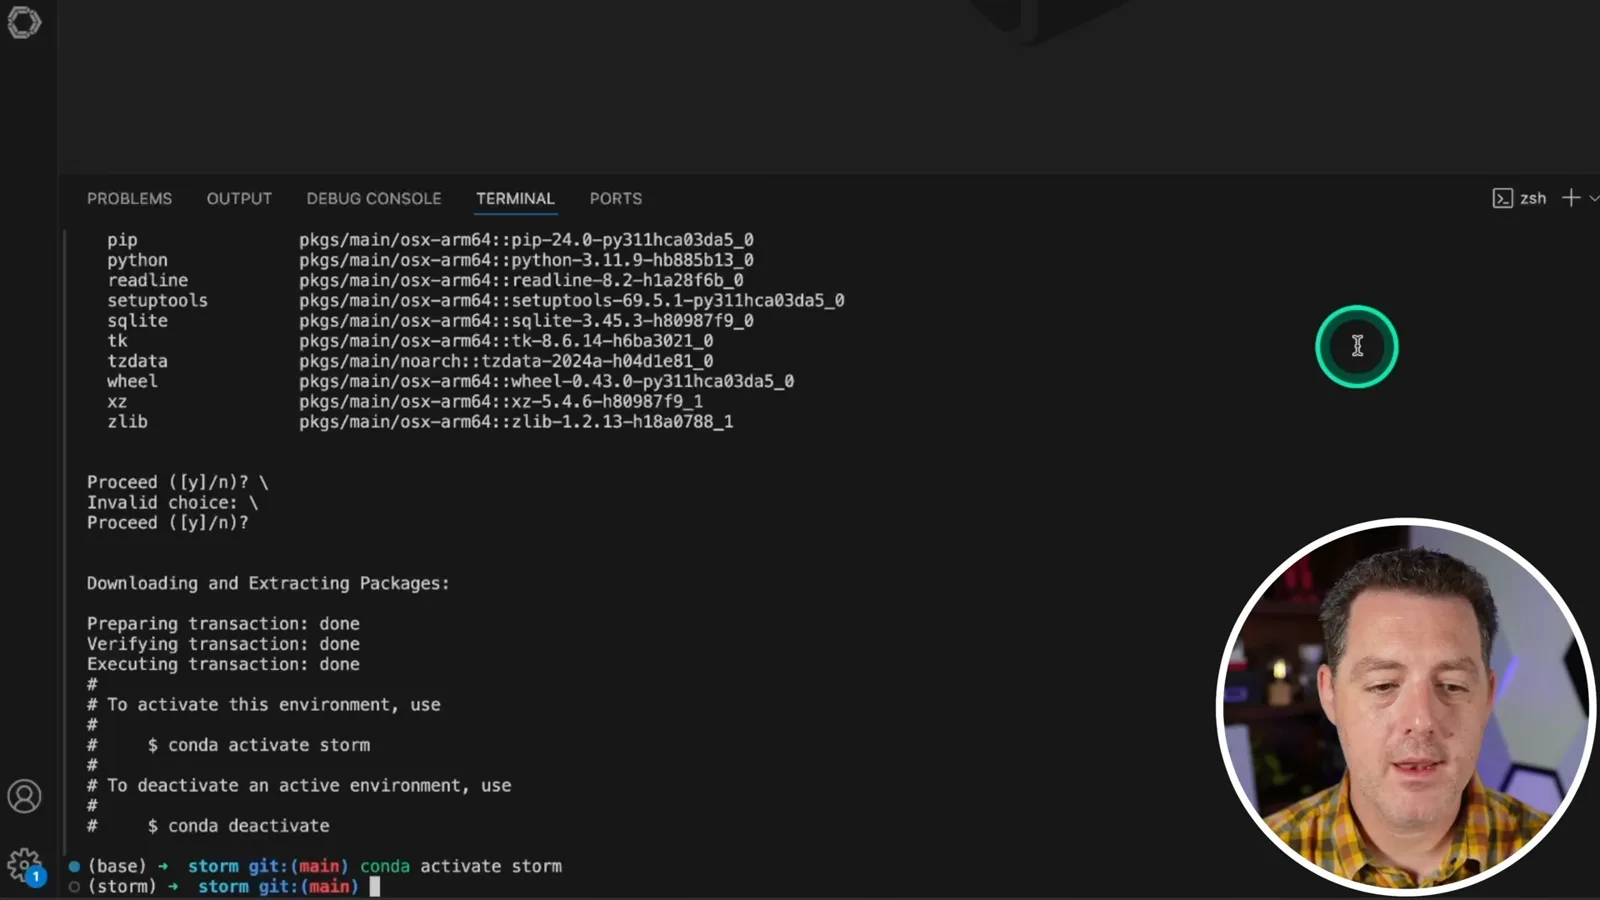
要安装这期 2024 年 7 月教程中展示的版本,可以在选定目录打开终端,克隆 [STORM 仓库](https://github.com/stanford-oval/storm),然后进入其文件夹。我用 conda 创建名为 `storm`、使用 Python 3.11 的环境,激活后运行 `pip install -r requirements.txt`。项目文件和配置步骤自录制以来可能已经变化。
配置 API 密钥并启动界面
他创建密钥文件并配置 OpenAI 和 You.com 的访问。接着他为 Streamlit 复制配置并启动演示。
在编辑器中打开项目文件夹,如果终端重置就重新激活环境,然后根据仓库的入门模板创建 `secrets.toml` 文件。本次演示中,我配置 OpenAI 而不是 Azure,然后添加 OpenAI API 密钥。请妥善保管凭据,并查阅仓库的最新说明以了解支持的配置。
我还创建一个 You.com 网页搜索 API 密钥,并将其加入配置。Berman 表示,当时该服务提供试用,除此之外需要付费;价格和可用性可能变化。项目也支持命令行使用,但这次演示我更喜欢简单的网页界面。
对于 2024 年的 Streamlit 界面,我将密钥文件复制到前端的 `.streamlit` 文件夹,进入 `demo_light` 目录,运行 `streamlit run storm.py`。本地服务器启动后打开研究界面。这些是视频中展示的步骤,复现前请查看最新文档。
运行研究任务
工具研究犬类并生成带参考资料的结构化文章。Berman 随后讨论自己尚未成功演示的本地模型替代方案。
我启动一个关于犬类的研究任务。日志显示系统正在构思不同视角并向 OpenAI 端点发送请求,随后开始浏览网页。任务完成后生成了一篇结构化文章,涵盖分类、进化、身体特征和行为等主题。
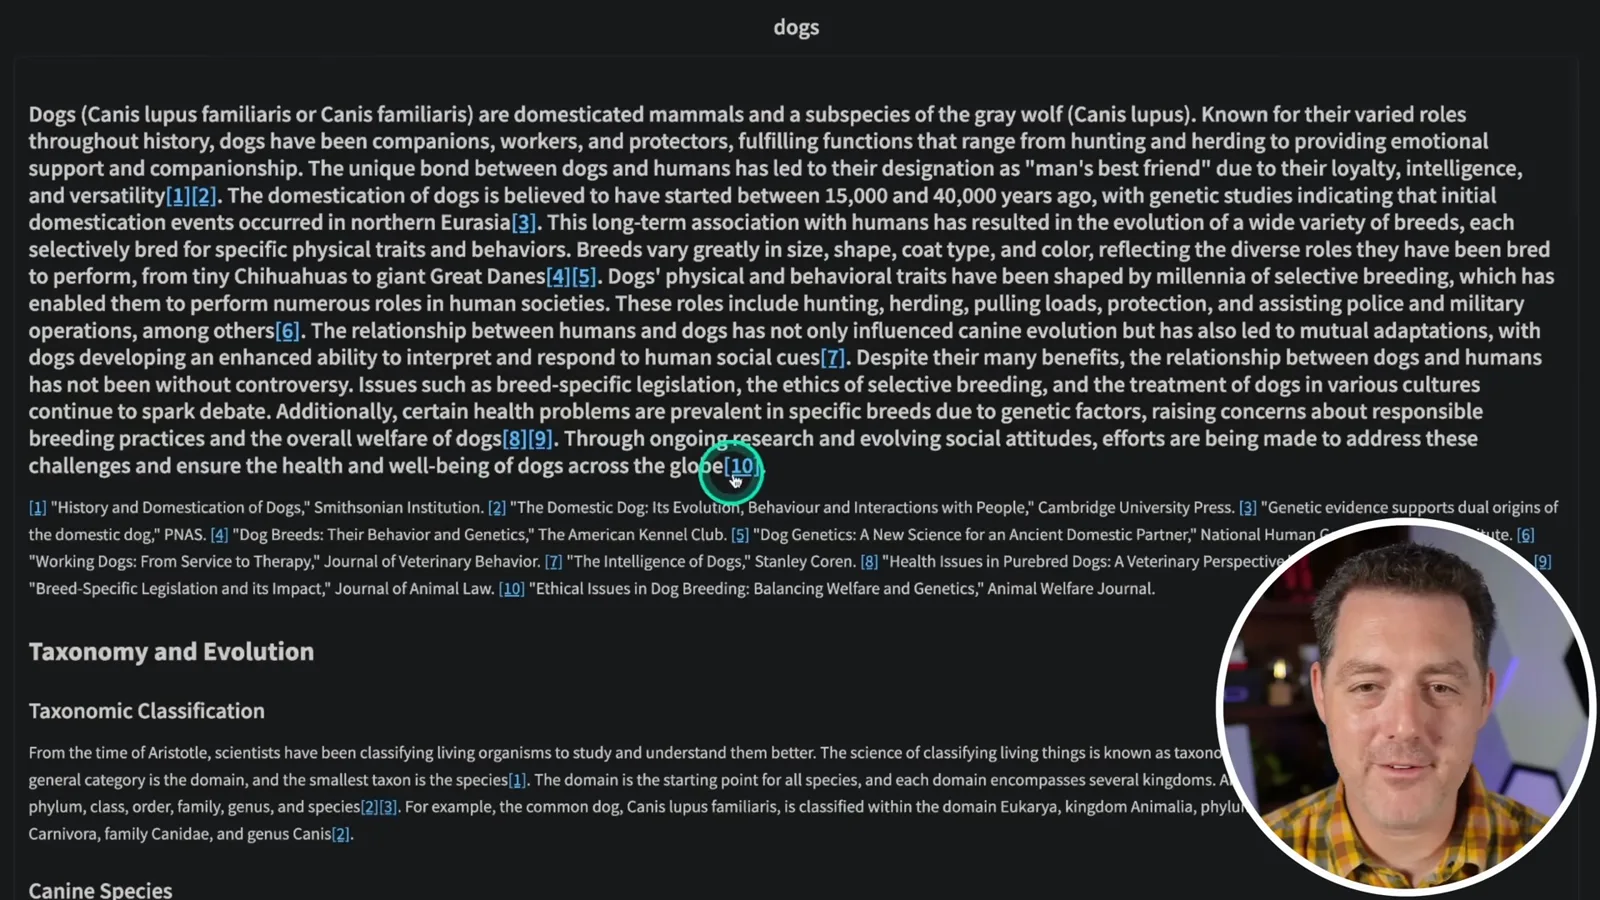
文章中有编号参考资料,点击后可以打开原始来源并查看高亮内容。这方便了研究核查,但引用本身并不能证明来源准确,也不能证明来源确实支持附近的主张;依赖草稿前,读者应核实这两点。
如果不想使用 OpenAI API,我指出了一个在模型环节使用 vLLM 和 Mistral 的示例,不过我自己还没有配置。除非自行构建替代方案,网页搜索仍需要外部信息源。我还看到有人讨论 Ollama,但我没有让它成功运行,也没有花很多时间尝试。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。