30 秒看懂
Theo Browne 讨论 Typesafe AI 的 Jev,这款模型旨在快速返回结构化决策。他查看公司的性能说法和演示,尝试了跳棋例子,还展示了自己如何分类编程智能体的历史记录。他也提醒,不应让快速分类模型代替深入的代码审查或上下文压缩。所称速度、价格、置信度和准确率取决于测试工作负载,并不意味着预测不会出错。
- 1System 1 的定位Typesafe 将其描述为快速决策模型,用于补充较慢的审慎推理。
- 2格式与内容Theo 区分受约束的输出结构与其中非确定性、可能出错的内容。
- 3基准比较的局限公司的比较采用选定的工作流和模型生成的参考答案,因此报告的大幅提升不能普遍套用。
- 4上下文压缩的疑虑Theo 认为,用小型分类模型筛选消息,与综合生成上下文摘要并不相同。
- 5分类会话历史他的实验分析了 1,118 条会话,并展示阈值如何改变统计比例。
要点建议
- 结构化输出便于将模型接入软件,但格式有效并不保证判断正确。
- Jev 面向快速分类和排序,而非通用文本生成或长时间推理。
- 速度和成本比较取决于任务、配置以及当时的价格。
- 在用置信度分数自动作出决定前,需要结合真实结果进行校准。
- Theo 质疑用小型快速分类模型处理复杂的代码评判或对话上下文压缩。
- 大规模分类可以揭示模式,但阈值和标签质量会影响结论。
按章节阅读整理后的全文
一种不同的模型
Theo 将 Jev 介绍为分类模型,并解释公司对快速决策的定位。跳棋演示展现了速度,也暴露了策略能力的不足。
Jev 与我通常讨论的编程助手不同。Typesafe AI 设计它来分类、整理数据并返回结构化决策,而不是编写代码或取代通用推理模型。它的速度为软件集成提供了不少可能,但任务仍需要适合这个模型。
公司把 Jev 定位为“System 1”模型:它用于快速、直觉式的决策,与较慢、审慎的推理相对。名称来自杰文斯悖论,即效率提高可能增加总使用量。它的机会在于让现有分类任务足够便宜和快速,从而更经常地使用。
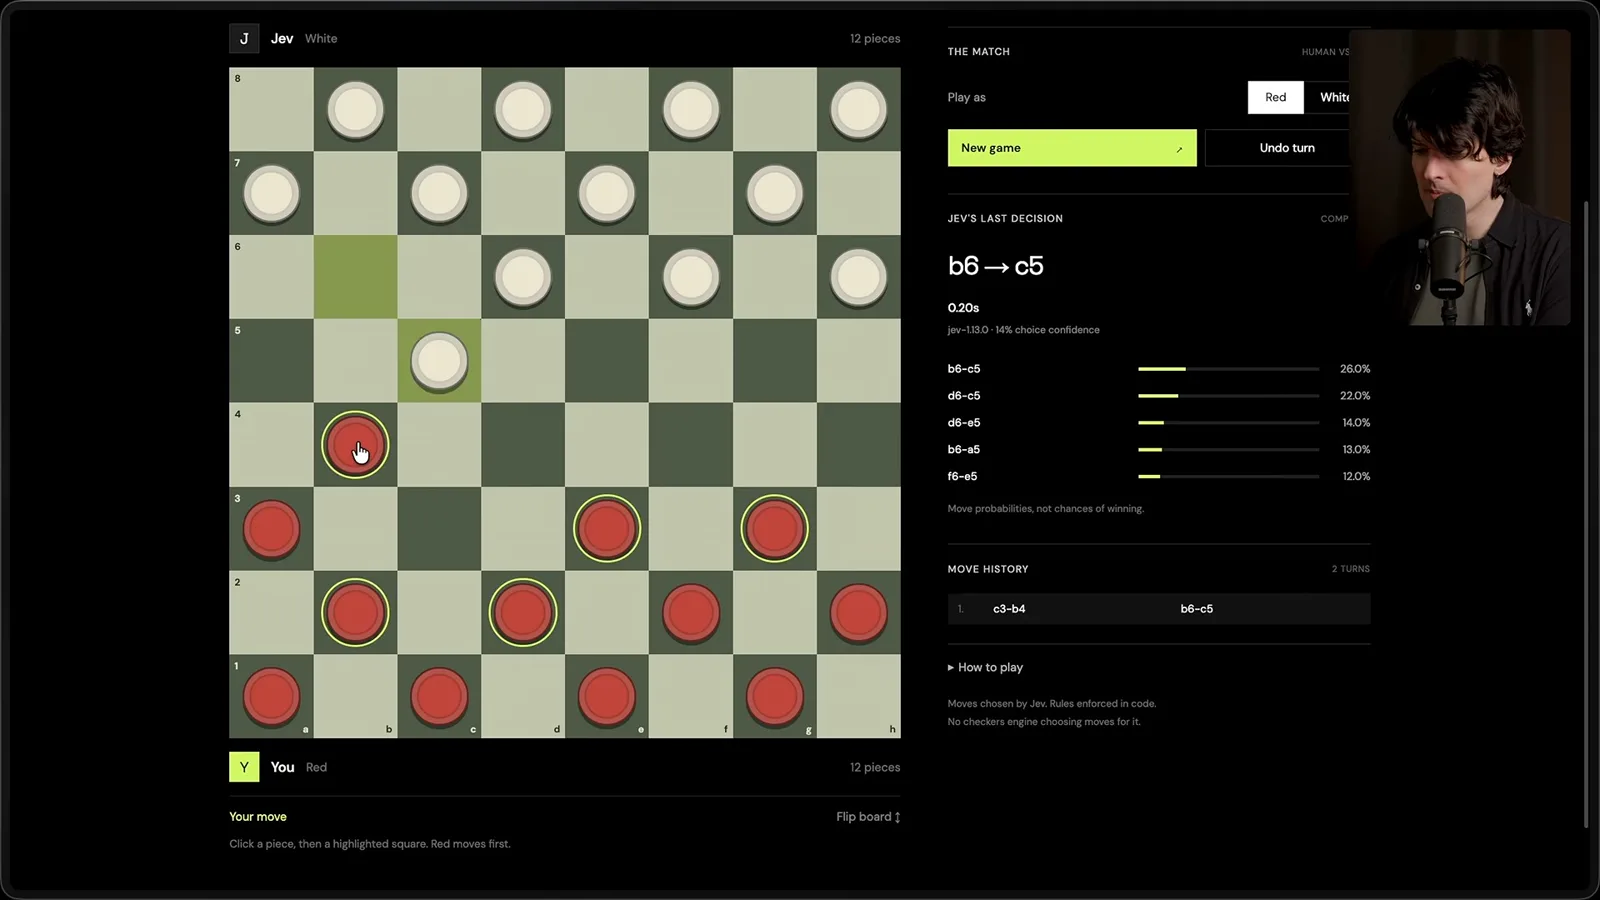
例子包括视频分类、邮件分拣和审核内容分类。我展示了跳棋:输入的是结构化棋盘状态,而非图像,因为视频中的版本没有视觉能力。它几乎立刻就能走棋,但策略很差:速度不等于强大的游戏推理能力。
结构化输出与集成
他将 Jev 与帮助语言模型输出符合软件类型的工具进行比较,并区分输出结构和概率性内容。
Typesafe 将 Jev 描述为软件组件,由程序传入数据和所需的输出结构。公司介绍了专门的模型架构、并行采样和为校准决策设计的训练方法,并称首个版本处于早期访问阶段。可用性和支持的功能可能变化。
其他工具也能帮助模型与带类型的代码衔接。例如,BAML 让开发者定义带结构化返回值的函数,比如包含情感标签和置信度的结果,然后在应用中调用。我遇到过底层模型输出格式错误的 JSON,BAML 的运行时可以修复输出,对我很有帮助。
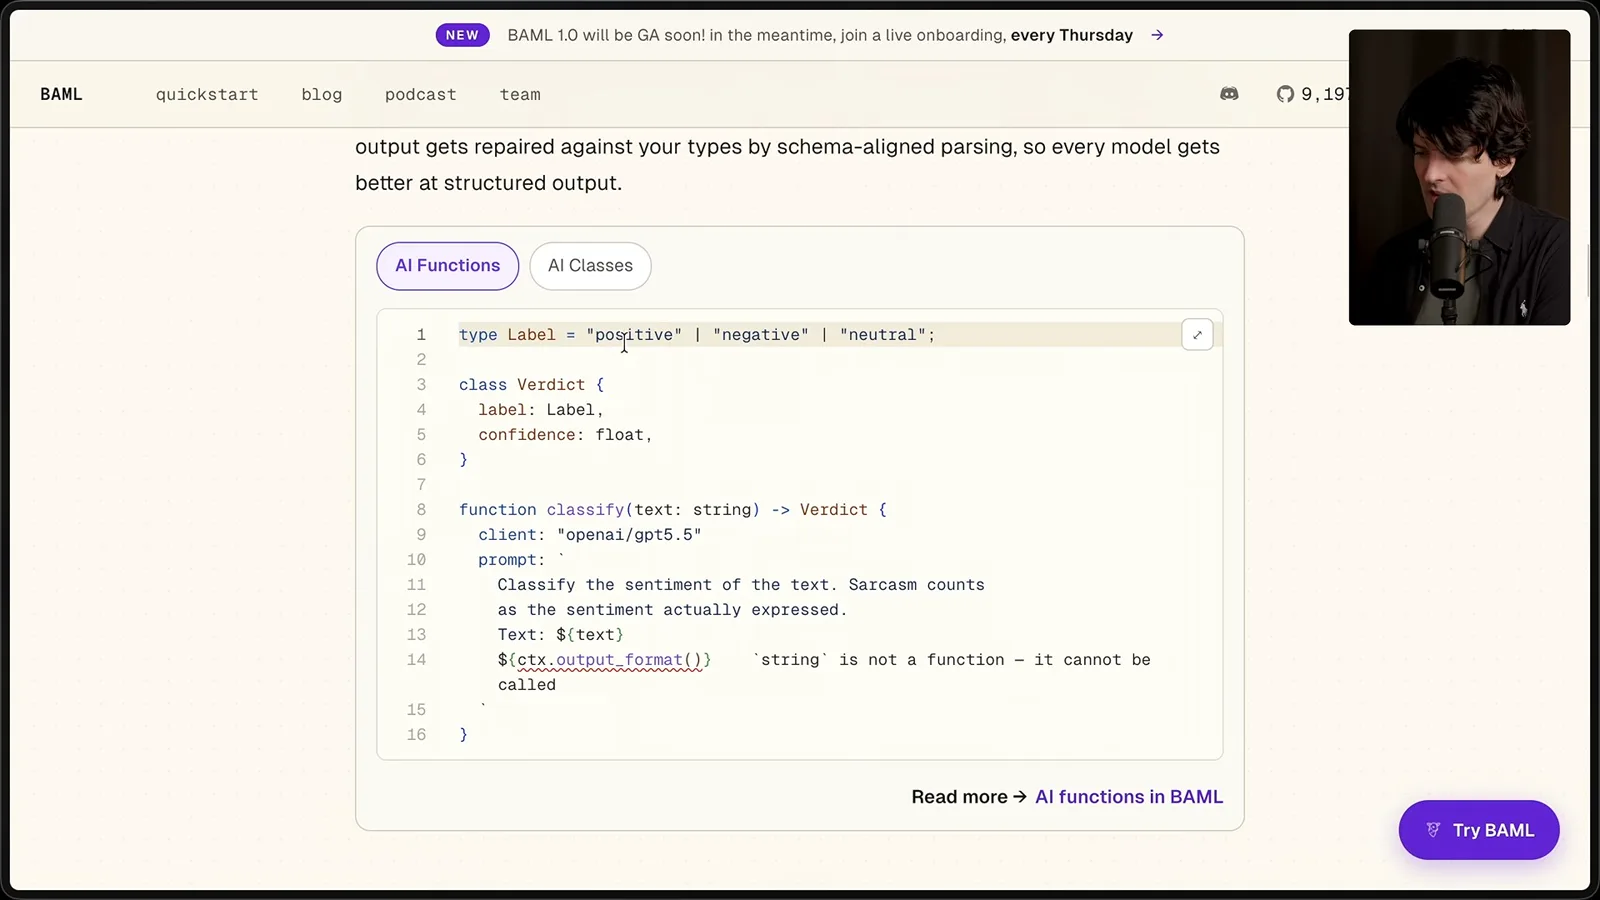
目的在于连接非确定性的模型行为和期待特定结构的软件。我说 Jev 的设计目标是遵守所需格式,但实际分类仍带有概率性。符合结构的结果仍可能包含错误标签或不可靠的置信度分数。
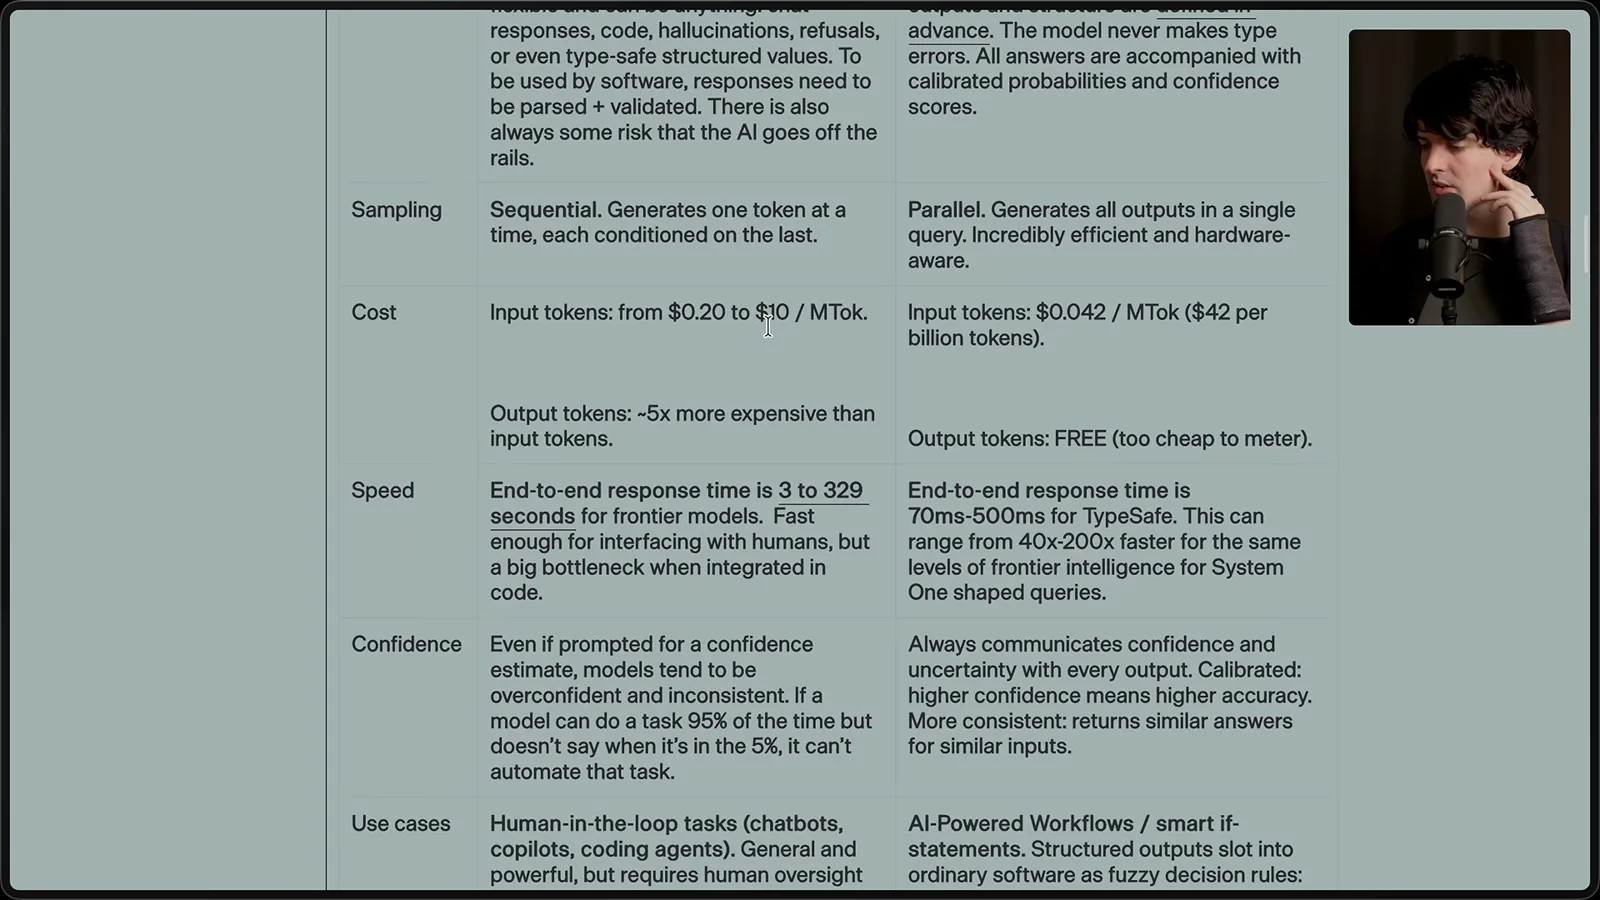
录制时,我引用的价格是每百万输入 Token 约 4 美分,输出 Token 免费,而 Fable 的输入价格高得多。这是不同产品和能力的报价,不是同一任务总成本的直接比较。我还引用了公司的低延迟比较,那也只针对其测试的工作流。
性能、演示与局限
Theo 讨论公司报告的延迟、成本和基准,以及游戏和界面示例。这些数字对应特定演示与配置。
公司称模型会为每项决策提供置信度或不确定性。这有助于设置阈值,但要用于自动化,还需要用真实案例检查并校准置信度。我喜欢把它比作智能 if 语句:传入数据,再根据分类选择工作流。
低延迟让交互式用途很有吸引力。我展示了一个调色板演示:输入一个词后颜色会快速变化。但快速分类模型不一定适合评判多个复杂代码实现;那可能需要它所不具备的代码库上下文、调查过程和推理。
我提到该版本的上下文限制为 32,000 个 Token,并把它比作 switch 语句,帮助理解它的定位。这只是类比,并非对智能程度的精确测量。要求智能体检查代码库并推敲不同方案,与根据已有数据选择标签,是非常不同的任务。
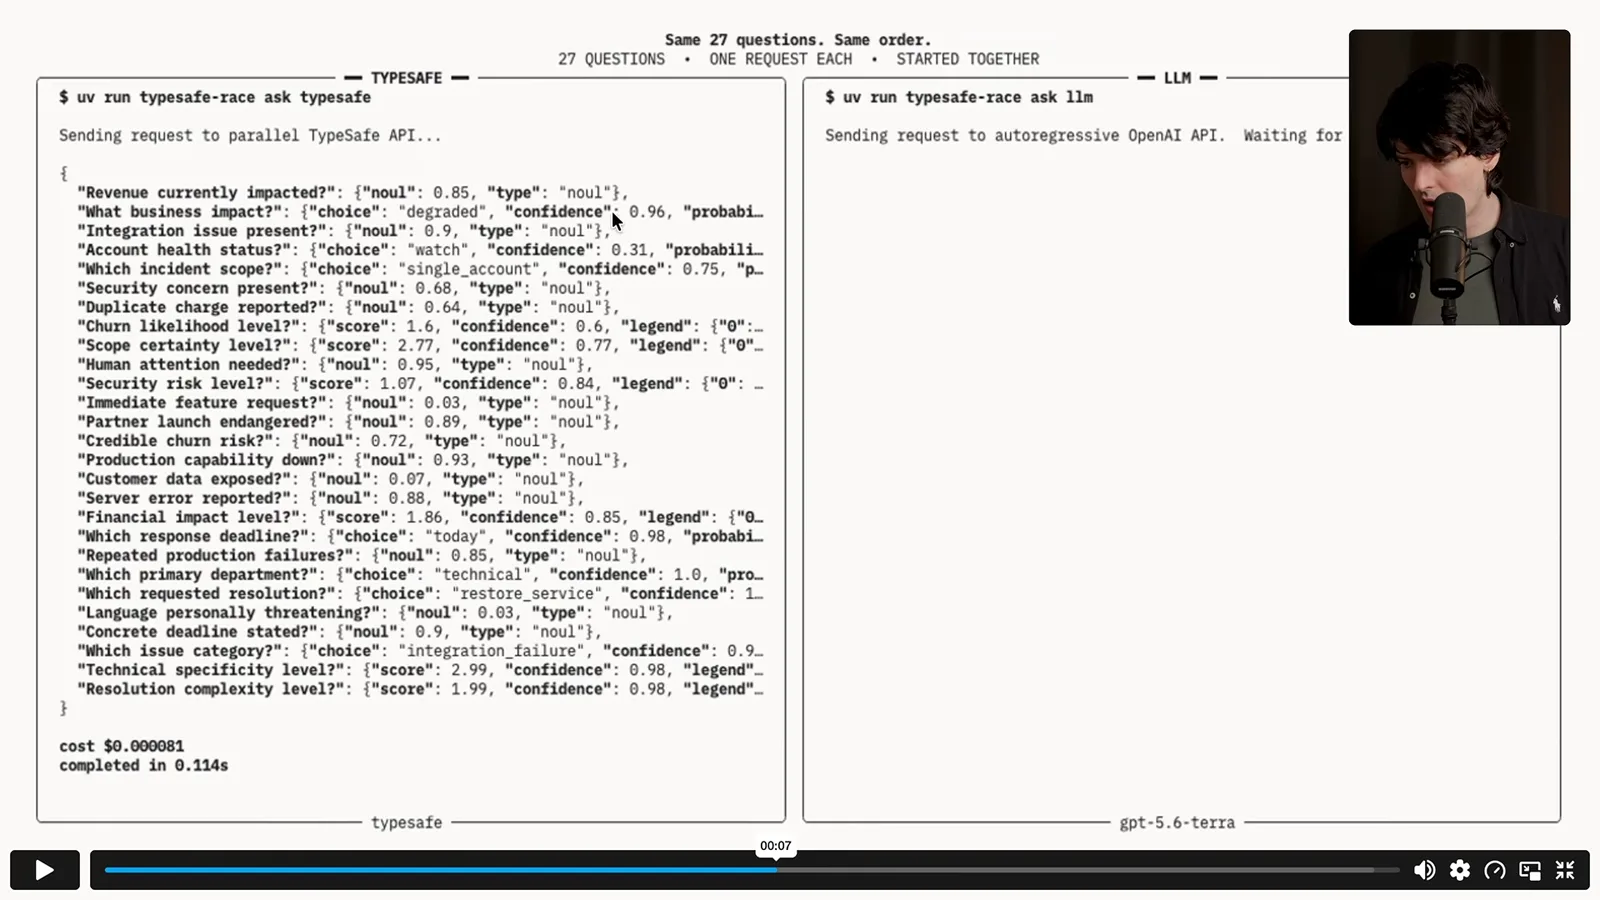
公司的一项演示对一组数据提出 27 个问题。我报告说,Jev 在约 0.114 秒完成,而比较模型花了约 9 秒。这些数字只描述那次演示,不能代表用户在所有输入、服务或工作负载下的延迟。
公司还展示了选定的分类工作流,并报告大幅的速度和成本优势。它表示首页数字可能处于实际收益的较高端。比较使用了特定封装方式和配置;评估本身没有完全公开,因此结果存在局限。
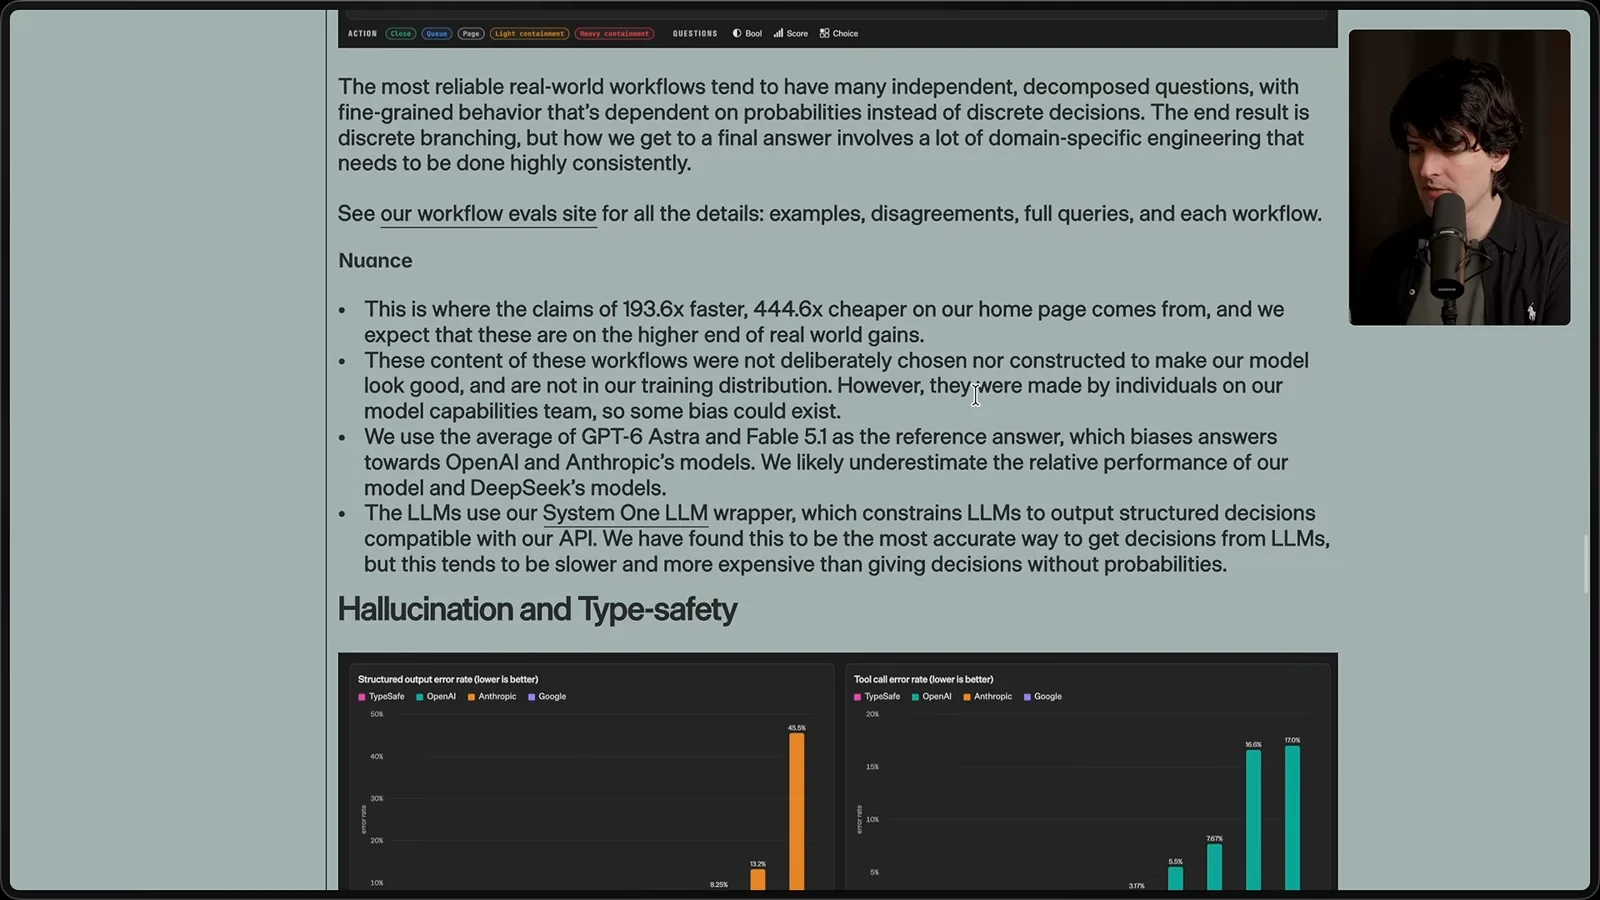
参考答案来自 Astra 和 Fable 5.1 的平均结果,并非不会出错的标准答案;这些模型也可能出错。Typesafe 的封装要求比较模型返回结构化决策和概率;公司称这是准确的方法,但可能比不返回概率更慢、更贵。
Typesafe 强调格式安全,并将虚构字段视为问题。我同意,无效的结构化输出可能破坏下游系统,尤其是在有延迟保证或依赖链很深时。但幻觉也包括内容错误:符合结构并不能保证判断为真。
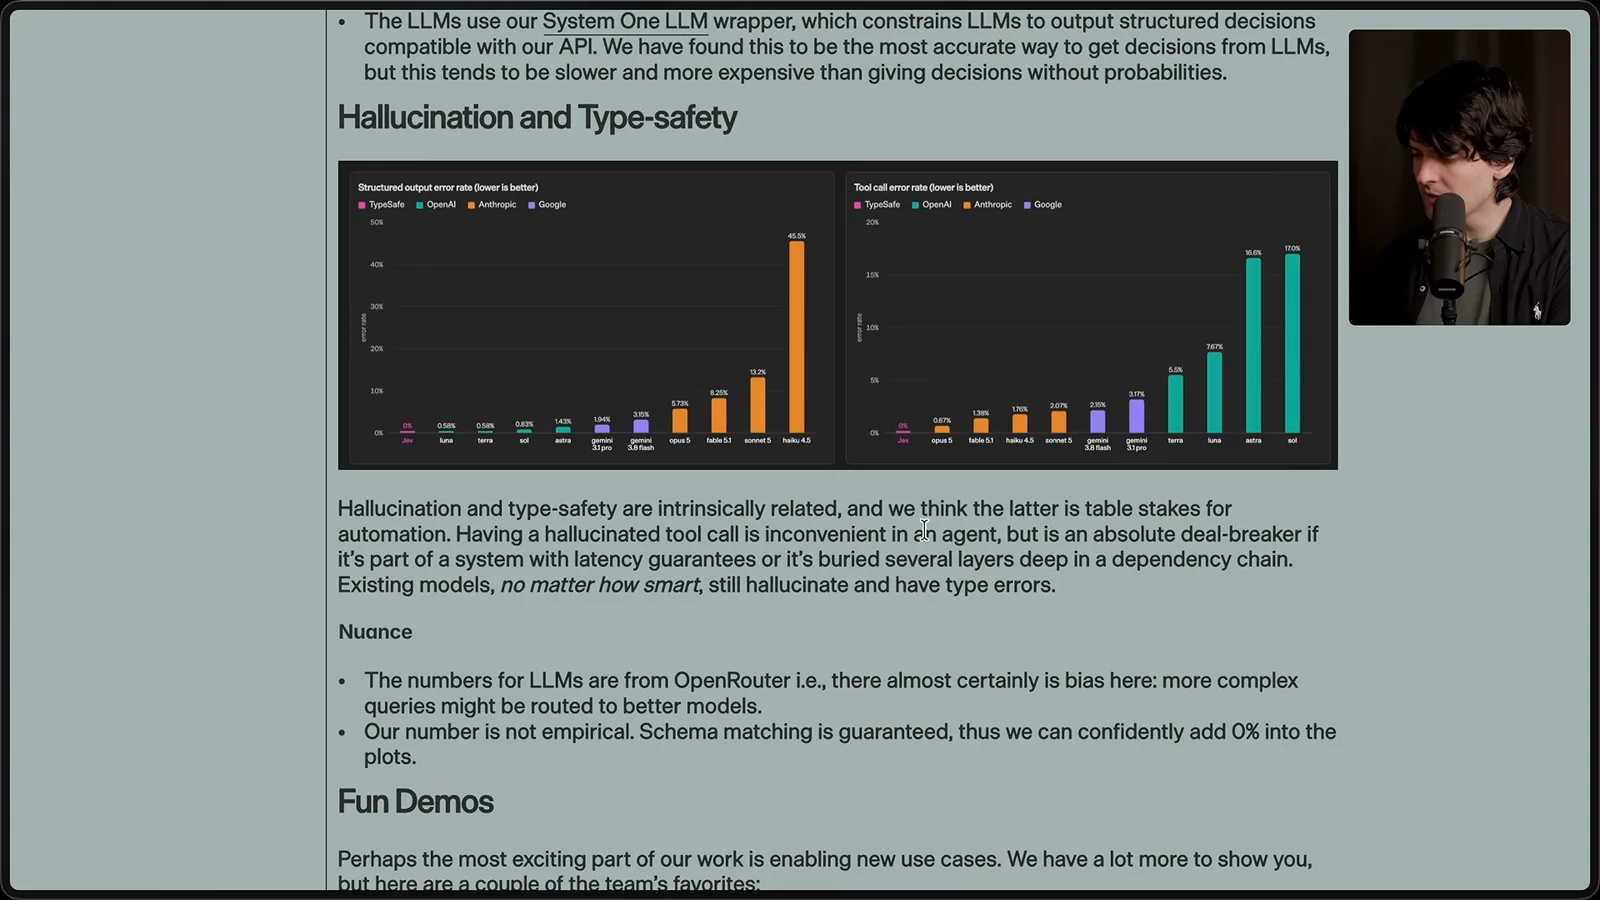
展示的图表比较了不同模型的结构化输出和工具调用错误率,并将 Jev 标为零。公司说明,这个零不是实测结果,而是基于其所称的结构匹配保证;它还指出其他模型的 OpenRouter 数据可能存在偏差。这些数字都不能证明分类判断正确。
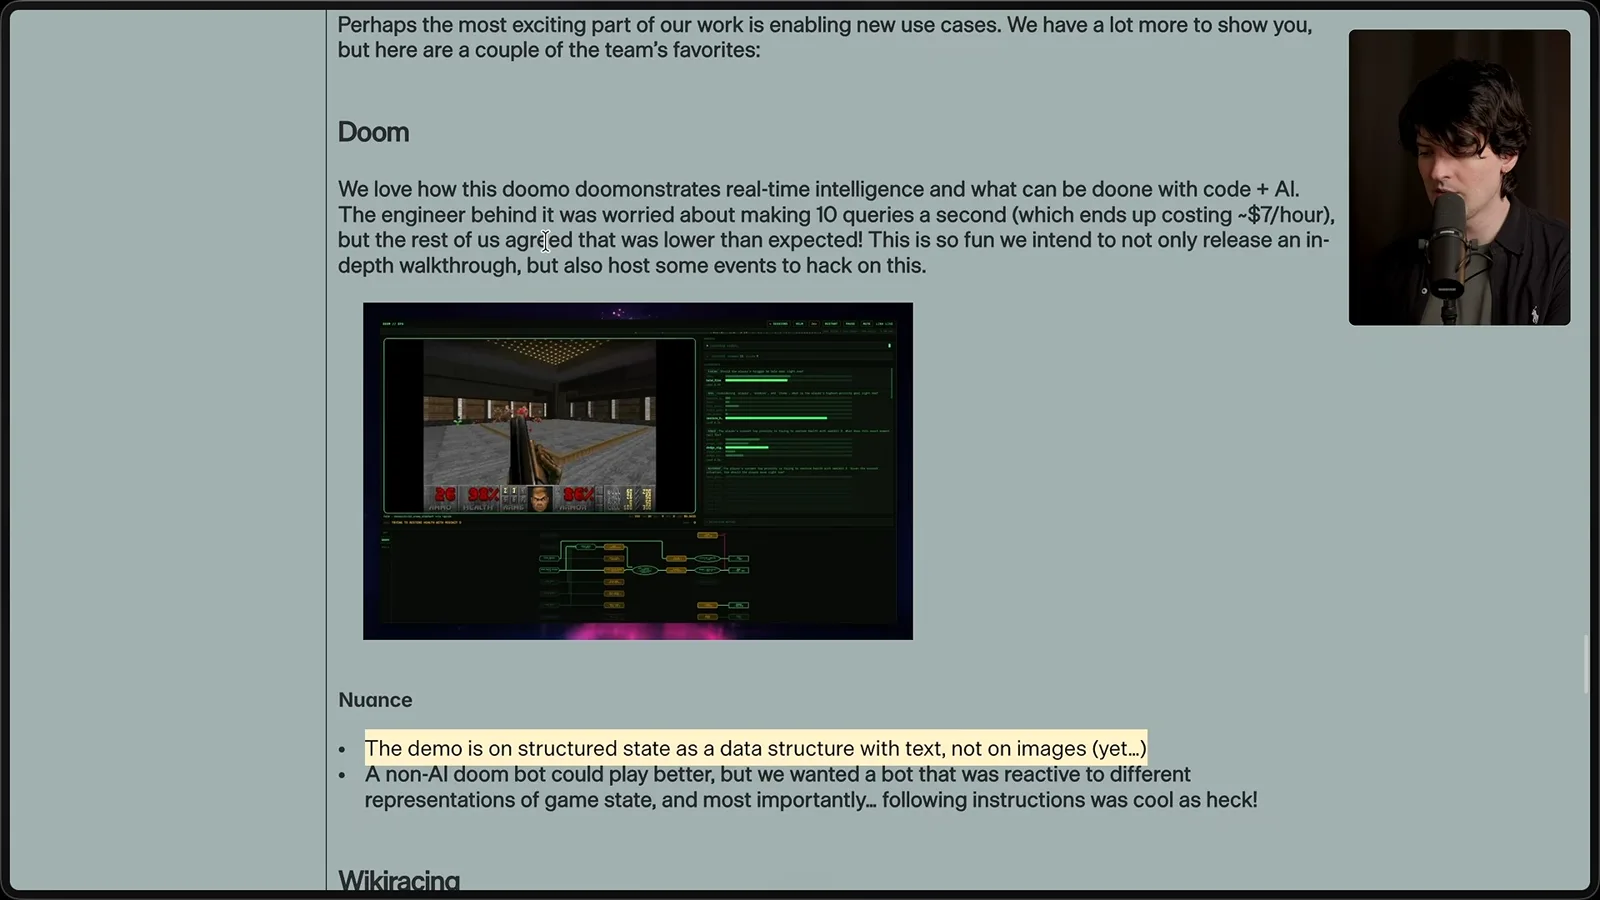
Doom 演示根据结构化游戏状态反复作出决定,而非读取图像。开发者估计,在该配置下每秒调用 10 次的成本低于每小时 7 美元。角色有时会不规律地转向,因为每次决策可能缺少之前动作的有用信息;演示既展示了速度,也说明状态信息的重要性。
一个维基竞速示例快速根据页面内容选择链接;另一个演示利用结构化 JSON 更新界面,而不必等待较长的文本流。这些例子展示了可能的集成方式,但速度本身不能证明它在所有网站或任务上都可靠。
在邮件示例中,一位开发者用 8 个工作进程处理 100 封邮件,报告平均延迟约 200 毫秒、第 95 百分位约 240 毫秒,每秒处理 38 封。我认为这适合做简单分拣的第一轮筛选。这些数字来自特定批次,而非独立的通用基准。
如果以后支持图像,我希望在发布视频前用它识别画面中的敏感信息。这是未来可能的应用,并非视频中该版本展示的功能。同样的思路也可用于网站导航:模型接收相关 HTML,而不是像素。
评判与上下文压缩
他质疑用分类模型做复杂的模型评判或上下文压缩,并讨论上下文缺失、摘要综合和缓存问题。
我担心大家因为速度兴奋,就在所有地方用分类模型取代推理模型。我尤其不赞成未经检验地用它评判复杂智能体回复。一个评判器是否有用,取决于证据和评估任务,而不仅是返回分数有多快。
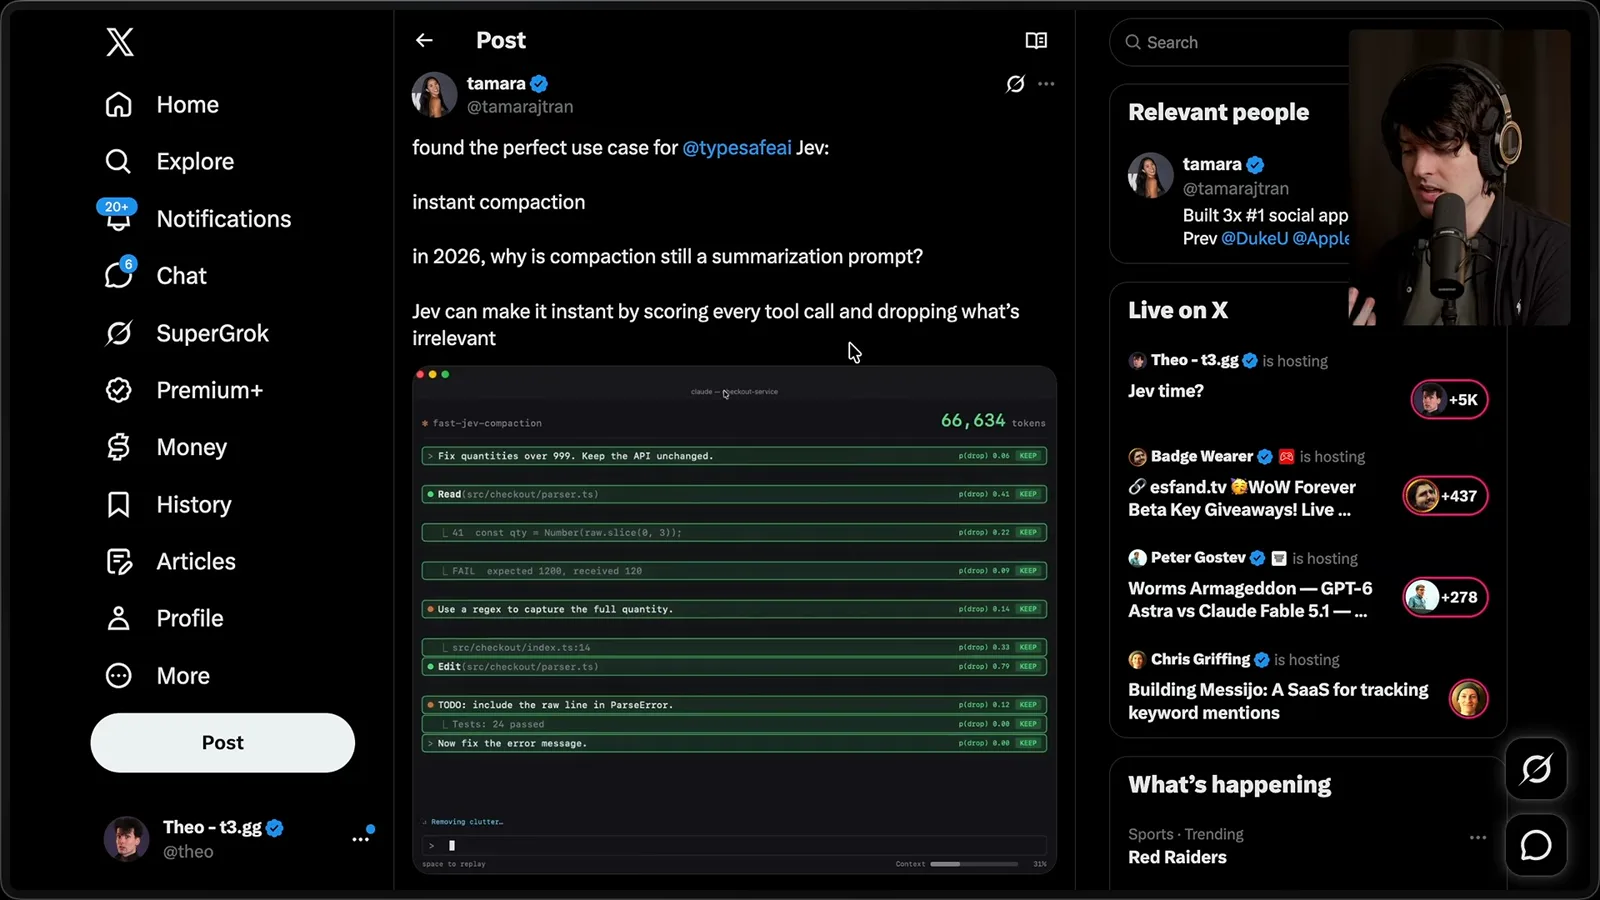
我也批评了一个用分类方式压缩智能体上下文的演示。有用的压缩摘要需要综合已经发生的事、决策、约束和未完成工作,不只是筛掉单条消息。在我看到的例子中,分类模型的上下文有限,也没有全部工具输出。
外部工具未必能看到推理轨迹,而编辑对话历史可能影响服务商保留的内容。我还指出,模型及其运行框架可能围绕特定压缩方式进行训练或设计。这些实现细节因服务商而异,应针对实际系统核实。
成本也是问题:修改对话早期内容可能使缓存前缀失效,带来更多缓存写入。重新执行丢弃的工具调用也不一定无害,因为有些工具会产生副作用。我提到其他人报告过该演示的测试结果不佳,但不把它当作全面的基准。
分析智能体历史
他分类自己的 T3 Code 会话,并展示置信度阈值如何影响结果。他最后将模型定位为软件组件,而非通用推理模型的替代品。
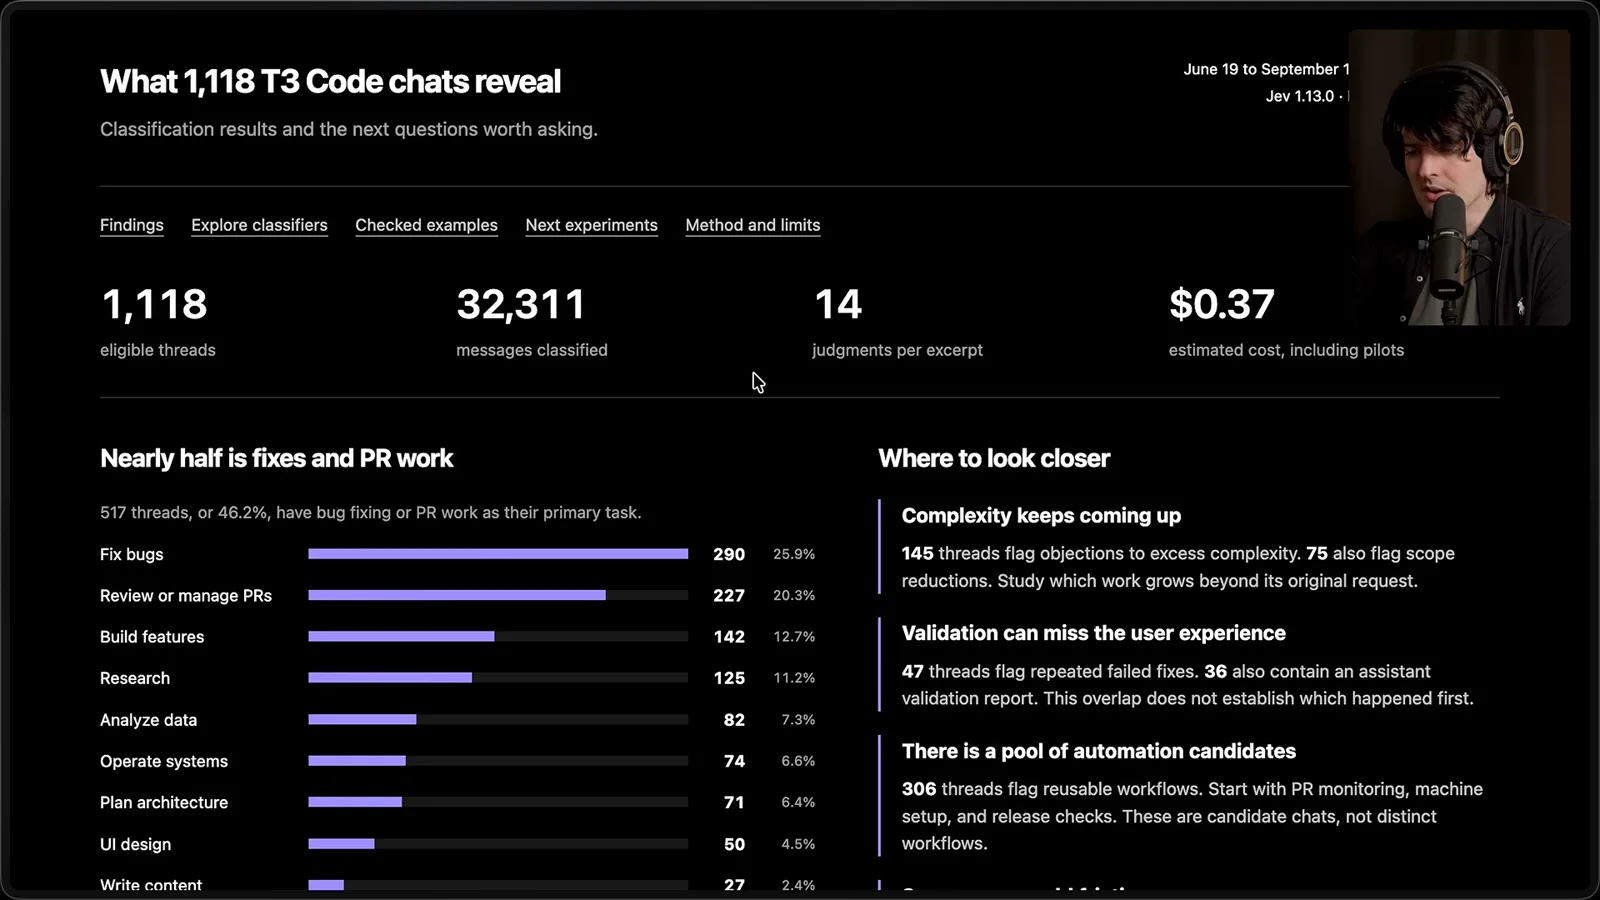
对我来说,更有前景的用途是分析大量现有数据。我用 Jev 分类了这台机器上 1,118 条 T3 Code 会话中的 32,311 条消息。我报告这次运行估计花费 37 美分,并发现修复错误和 PR 审查或管理占了相当一部分工作。
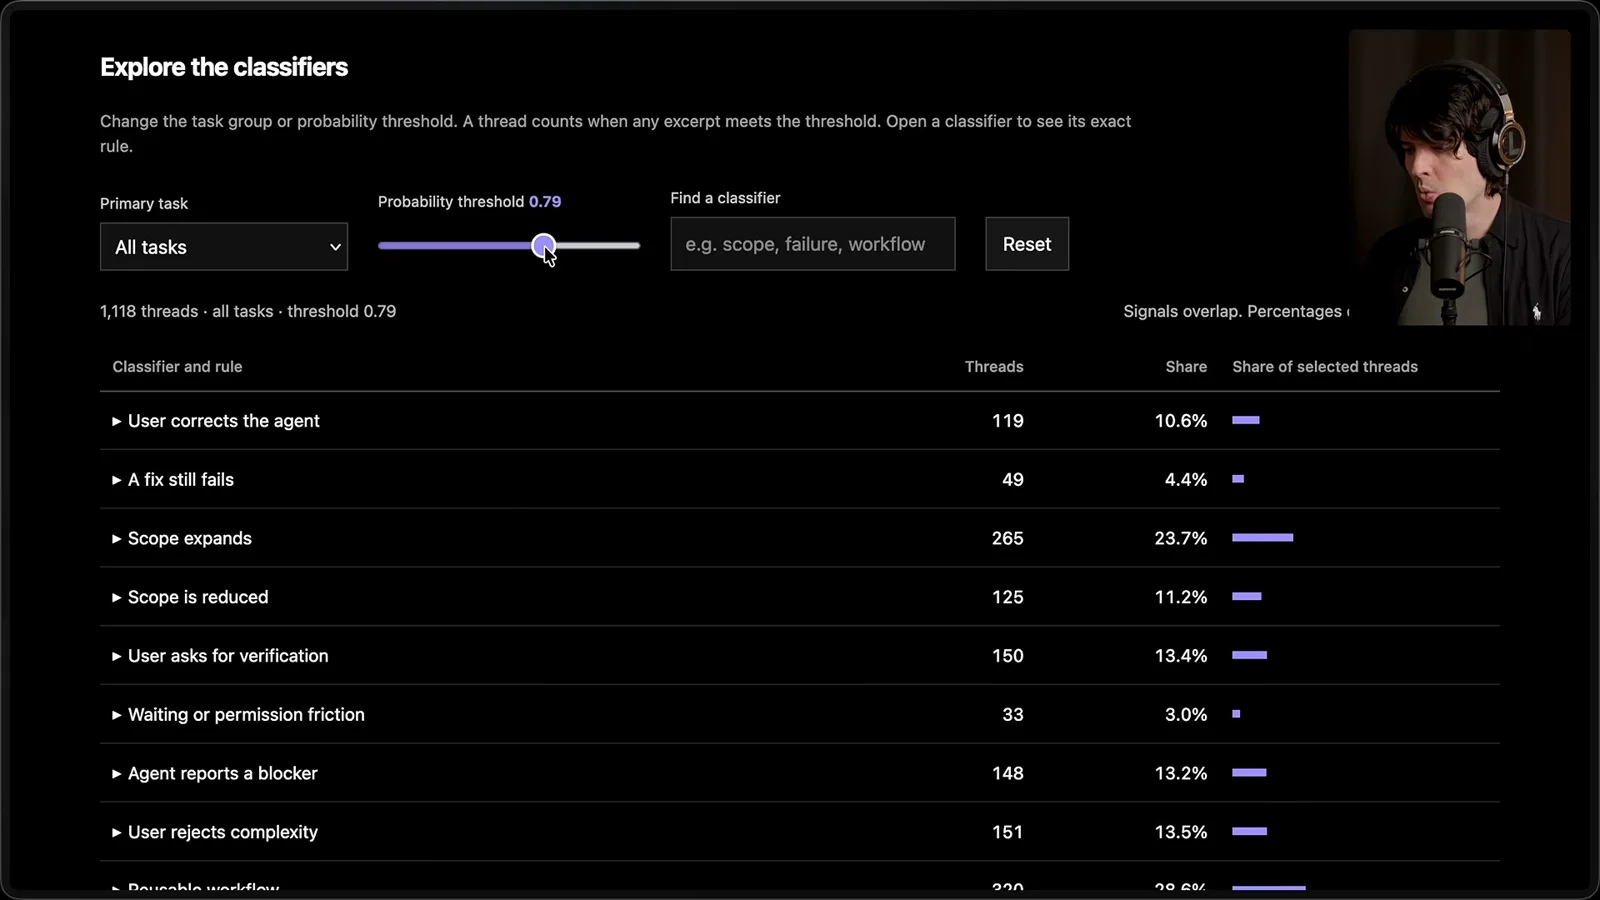
模型为各类别提供分数,而不是只返回标签列表。在我的界面中,将范围扩张的阈值从 80% 提高到 90%,被计入的会话比例从 22% 降至 6.8%。分数阈值并不自动等于校准后的概率,也不等于经过验证的真实标签。
Astra 还尝试找出适合做视频素材的会话,多次修改提示词后,结果仍认为约一半会话值得使用。我觉得这并不实用。有些分类需要的判断,模型和已有上下文未必能够提供。
我的粗略经验是,想一想一个人在看到所有相关信息后需要多久才能回答:快速归类可能适合,持续思考的工作可能不适合。这只是经验法则,不是经过验证的界限,仍应在实际任务上测试表现。
主要区别是快速结构化决策与长时间推理。我把 Jev 看作集成进应用的函数或库,而不是 Fable 的直接替代品,也不是生成代码和文章的工具。应在它的取舍有价值的地方使用,并验证重要结果。
同频道的其他文章
 36:07EN → 简体中文
 Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。
 31:47EN → 简体中文Theo - t3․gg· 2026年10月18日Theo:向智能体请求结果,再构建它需要的工具Theo Browne · Ping Labs从工具耗时报告、排障手册到数据连接,看提示如何改变产品工程。