30 秒看懂
2025 年 2 月,Matthew Berman 讨论了一项 llama.cpp 代码贡献,其作者称大部分代码由 DeepSeek R1 编写;他还介绍了低成本视觉计数实验 R1-V。他将这些视为 AI 快速进步的迹象,并推测可能出现智能爆发;不过,展示的结果涉及特定任务,并非自主、通用的自我改进。
- 1针对性的加速一个 llama.cpp 拉取请求报告 WebAssembly SIMD 点积速度有所提升,作者称大部分代码由 DeepSeek R1 编写。
- 2人类引导的迭代开发者编写提示词和测试,提供失败的尝试,并与模型反复迭代。
- 3可能的起飞Berman 推测自动化研究可能带来快速改进,同时也提到与之竞争的渐进观点。
- 4R1-V 计数Liang Chen 介绍了在视觉语言计数任务中使用可验证奖励的强化学习。
- 5有限范围的比较展示的计数评估报告称,训练后的 2B 模型达到 99%,72B 模型达到 94%。
要点建议
- 一名开发者表示,他提供提示词和测试,使用 DeepSeek R1 编写了 llama.cpp 优化的大部分代码。
- 报告的两倍速度提升针对特定的 WebAssembly SIMD 运算,并不代表所有 DeepSeek 推理都能加速。
- Berman 认为递归改进和可能出现的智能爆发近在眼前;这些是他的解读和预测。
- R1-V 研究者报告称,通过 100 步强化学习改进了一个 2B 视觉语言模型在特定计数评估中的表现,成本不到 3 美元。
- 可验证奖励可以为答案可检验的任务提供自动信号,但计数结果不能证明模型在一般情况下更优秀。
按章节阅读整理后的全文
自我改进与速度提升的说法
Berman 介绍自己对 AI 进步的解读和两个例子。第一个例子是据称对特定推理代码的优化。
我认为最近的一个 DeepSeek R1 编程例子是 AI 自我改进的迹象。在我看来,能够参与 AI 研究的系统最终可能推动递归改进和智能爆发。这是对未来的预测;我展示的例子涉及一名开发者指导并测试特定代码改动。
我认为 o1、o3 和 DeepSeek R1 等模型正接近能够贡献新知识的水平。我还想展示另一个团队的实验:在一个范围较窄的任务上,他们以不到 3 美元的成本引出了类似推理的“顿悟时刻”。此前我讨论过另一项成本为 30 美元的实验。
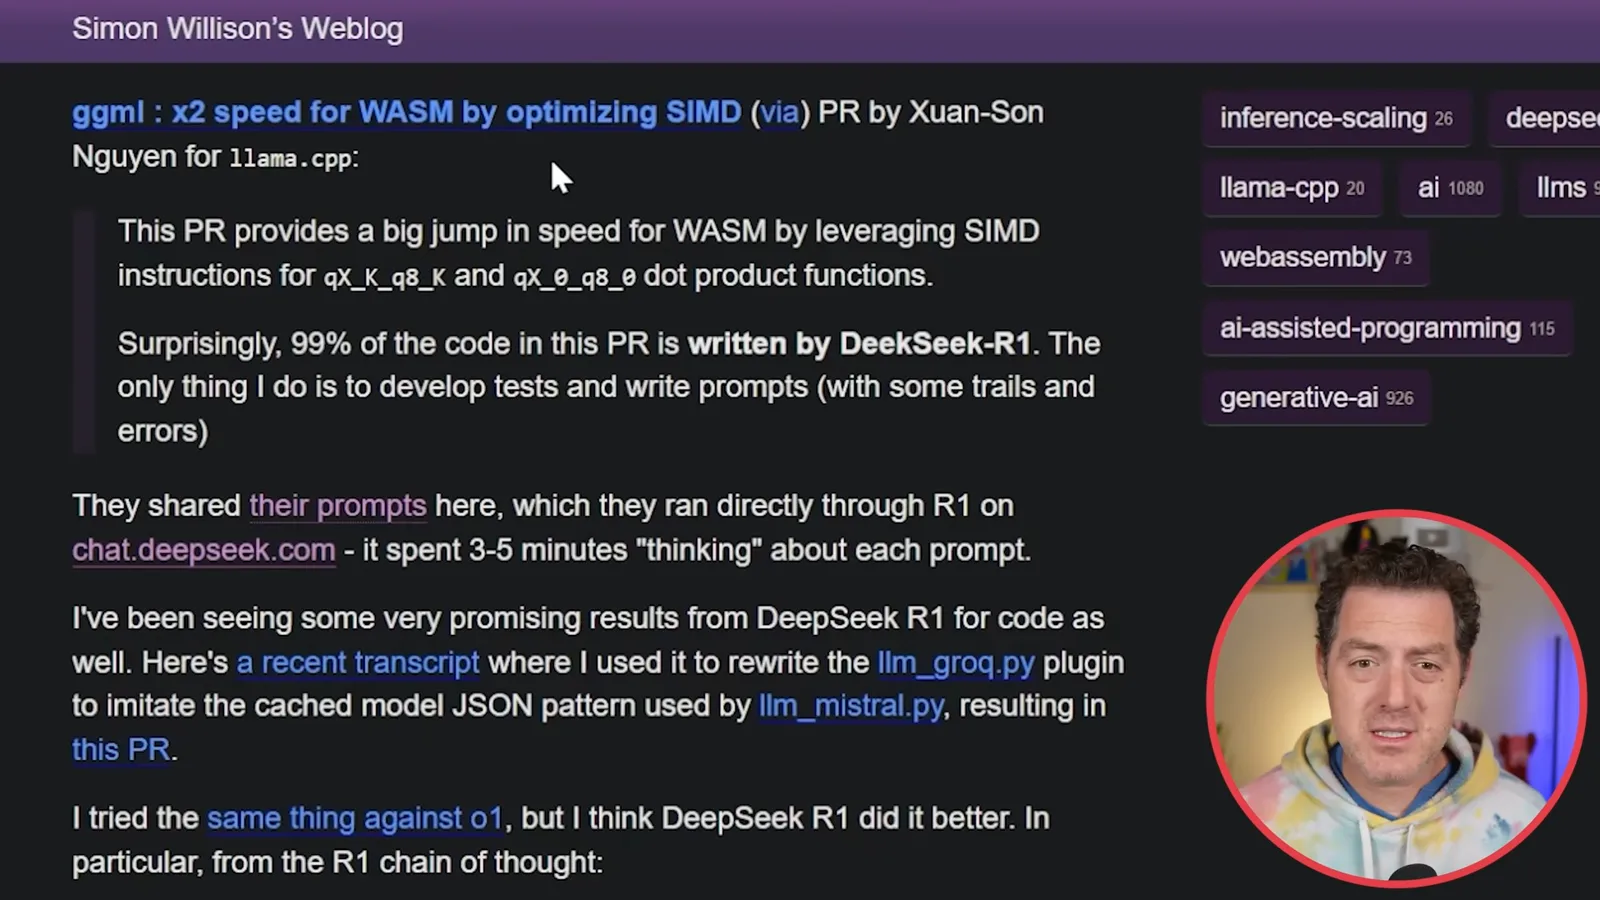
Simon Willison 的博客重点介绍了 Xuan-Son Nguyen 提交的一个 llama.cpp 拉取请求:据称通过 SIMD 优化,特定 WebAssembly 点积函数的速度提高了约一倍。Nguyen 表示,DeepSeek R1 编写了 99% 的代码,而他通过反复尝试开发测试并编写提示词。这是对推理软件的改动,并不表明模型自主改变了自己的权重。
Willison 还描述了如何使用 R1 重写 llm_groq.py 插件,使其遵循 llm_mistral.py 中缓存模型的 JSON 模式。他说自己也用 o1 尝试了同一任务,认为 R1 做得更好。这是一项个人编程体验,并非广泛的基准测试比较。
开发者使用了免费的 chat.deepseek.com 界面,据称每次回答约需三到五分钟。迭代提示词描述了问题,附上上一次失败的尝试,并要求模型改进。其中一个例子要求将 C++ ARM NEON SIMD 转换为 WebAssembly SIMD,同时提供现有代码作为上下文。
提示词、测试与推测
他展示了人类引导的编程流程和另一个编程例子。随后,他讨论了人们对 AI 起飞速度的不同预期。
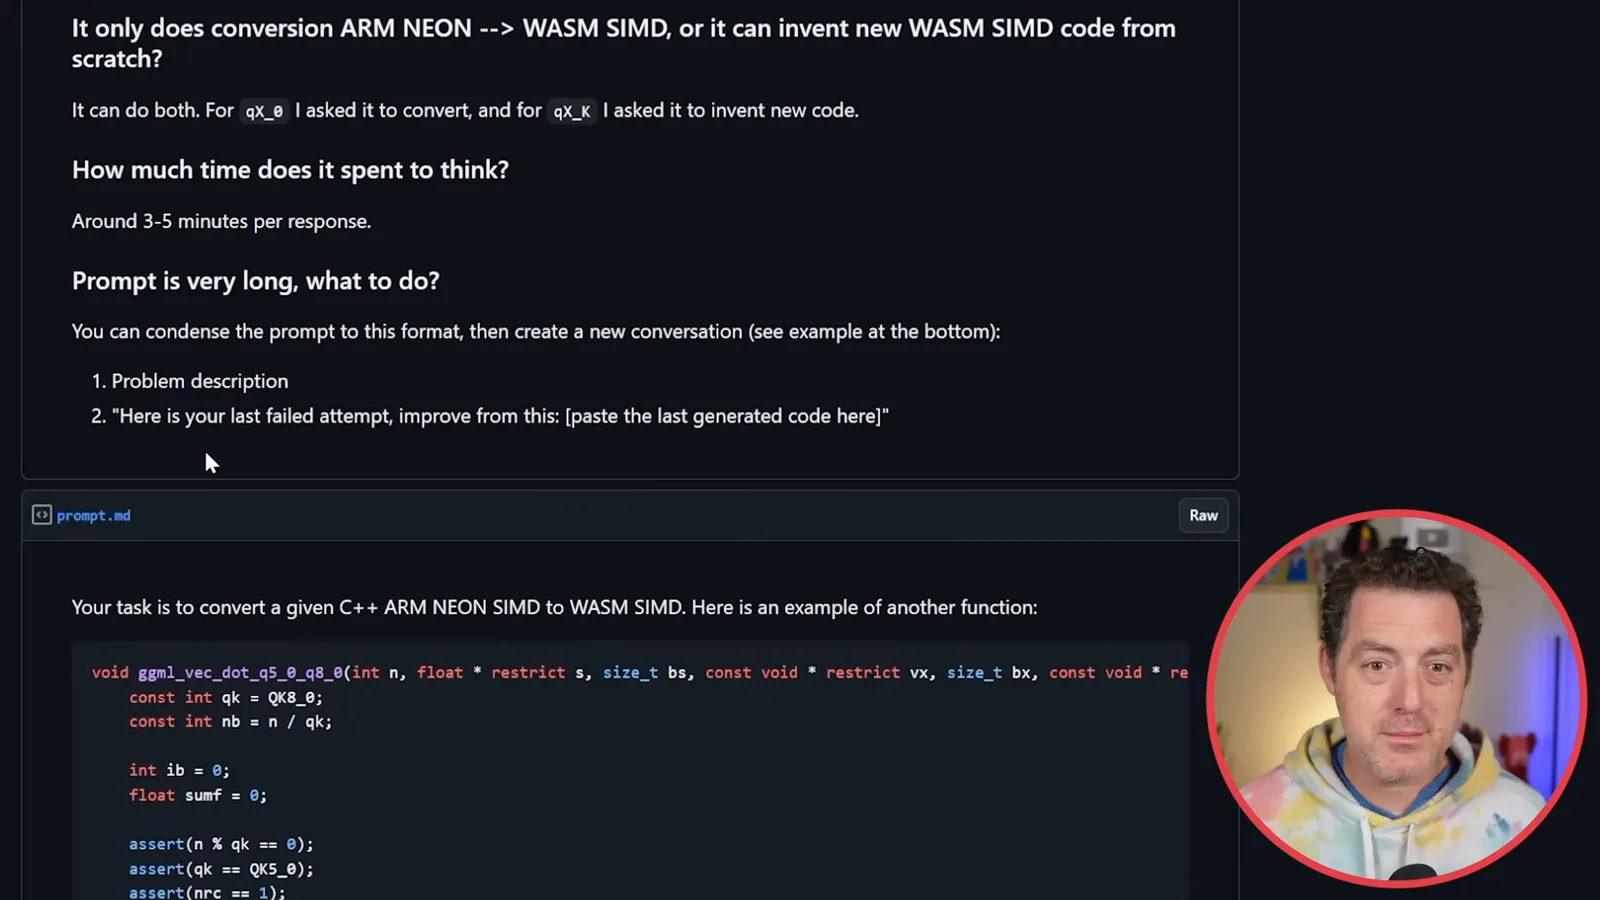
这些提示词让模型寻找代码优化方法;另一个例子展示了模型如何思考把 Mistral 插件中的模式应用到 Groq。我觉得这很惊人,并想象许多智能体持续寻找改进方法。这种想象中的自主过程超出了这里展示的人类引导例子。
我再次展示智能爆发图表,并提出自动化 AI 研究可能让我们接近超级智能。我对进步究竟会突然起飞还是更加渐进感到矛盾。例如,Yann LeCun 认为 AGI 将逐步出现,并在出现后较快地被其他人复现。
我认为开源发布能加快成果传播,而 DeepSeek R1 是一个重要例子。我还引用了 Sam Altman 在 Reddit 问答中的说法:R1 是一个非常好的模型,OpenAI 会推出更好的模型,但领先优势将小于前几年。
低成本视觉强化学习
Berman 介绍 R1-V,解释可以根据答案验证的奖励。他讨论了报告中的计数结果及未来可能的用途。
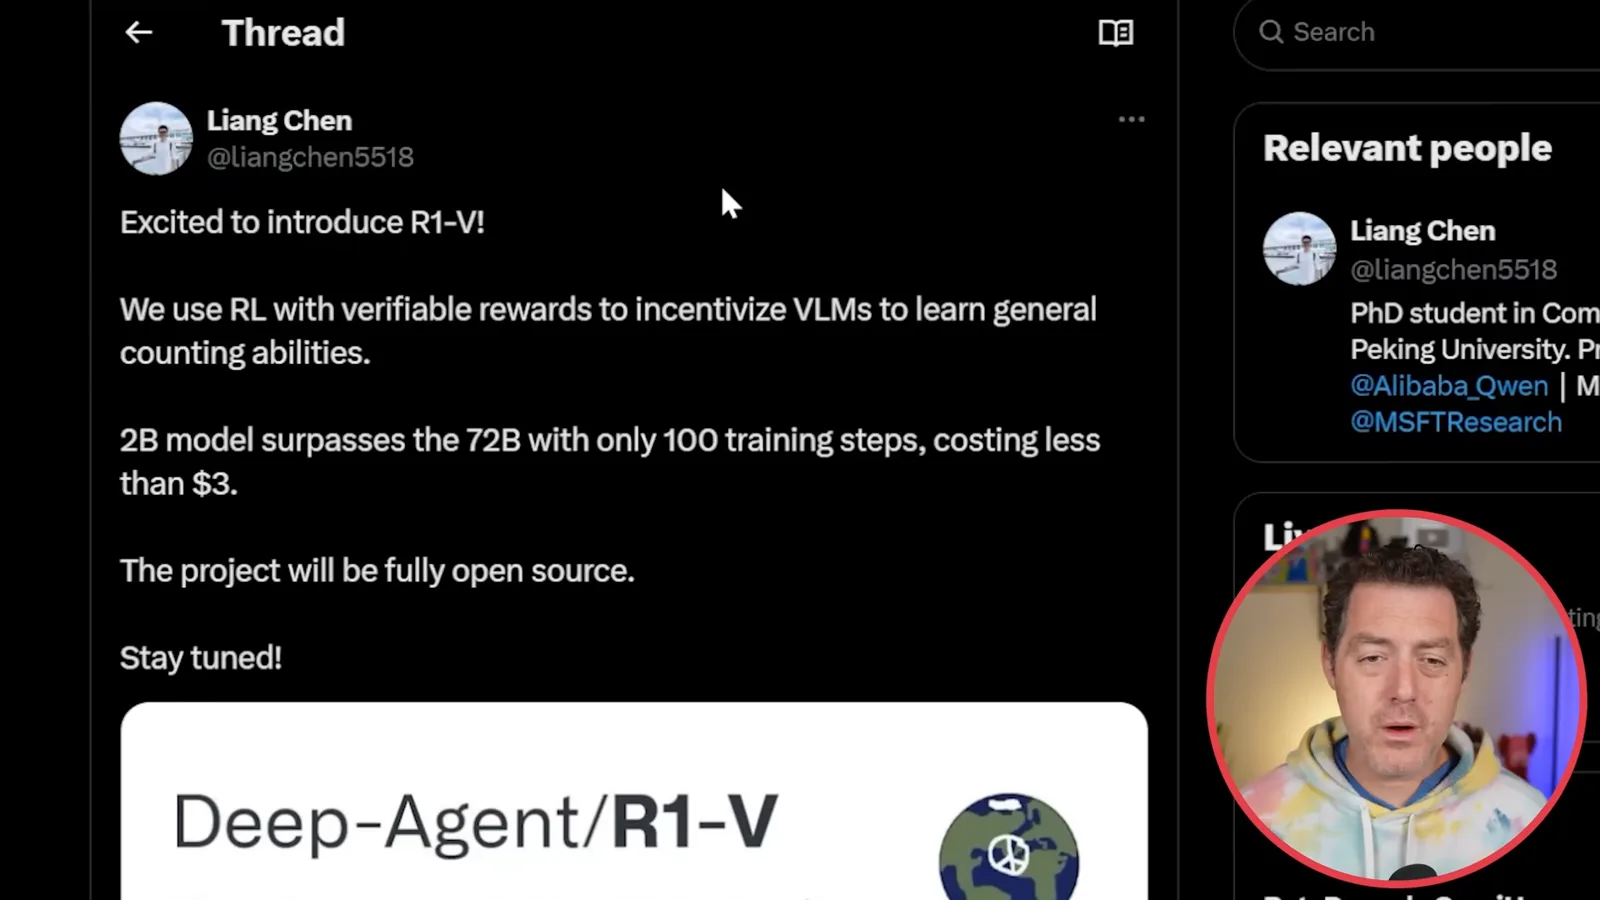
第二个例子是 Liang Chen 介绍的 R1-V。团队使用可验证奖励强化学习,促使视觉语言模型学习计数。我将其与此前成本为 30 美元的窄范围实验及 DeepSeek R1 的方法进行比较,不过这里的具体任务和设置有所不同。
可验证奖励为训练提供了检查答案的方法:算术有确定答案,而最喜欢什么颜色则取决于个人喜好。我认为,这使该技术特别适合科学、技术、工程和数学中定义明确的问题。这里讨论的是奖励可检验的任务,并不是说强化学习不能用于其他领域。
Chen 报告称,一个 20 亿参数模型经过 100 步训练、花费不到 3 美元后,在计数任务上超过了一个 720 亿参数模型。这是范围有限的比较,并不能证明较小的模型总体上更好。我推测,未来路由器可能根据用户请求,从许多小型专用模型中选择合适的模型。
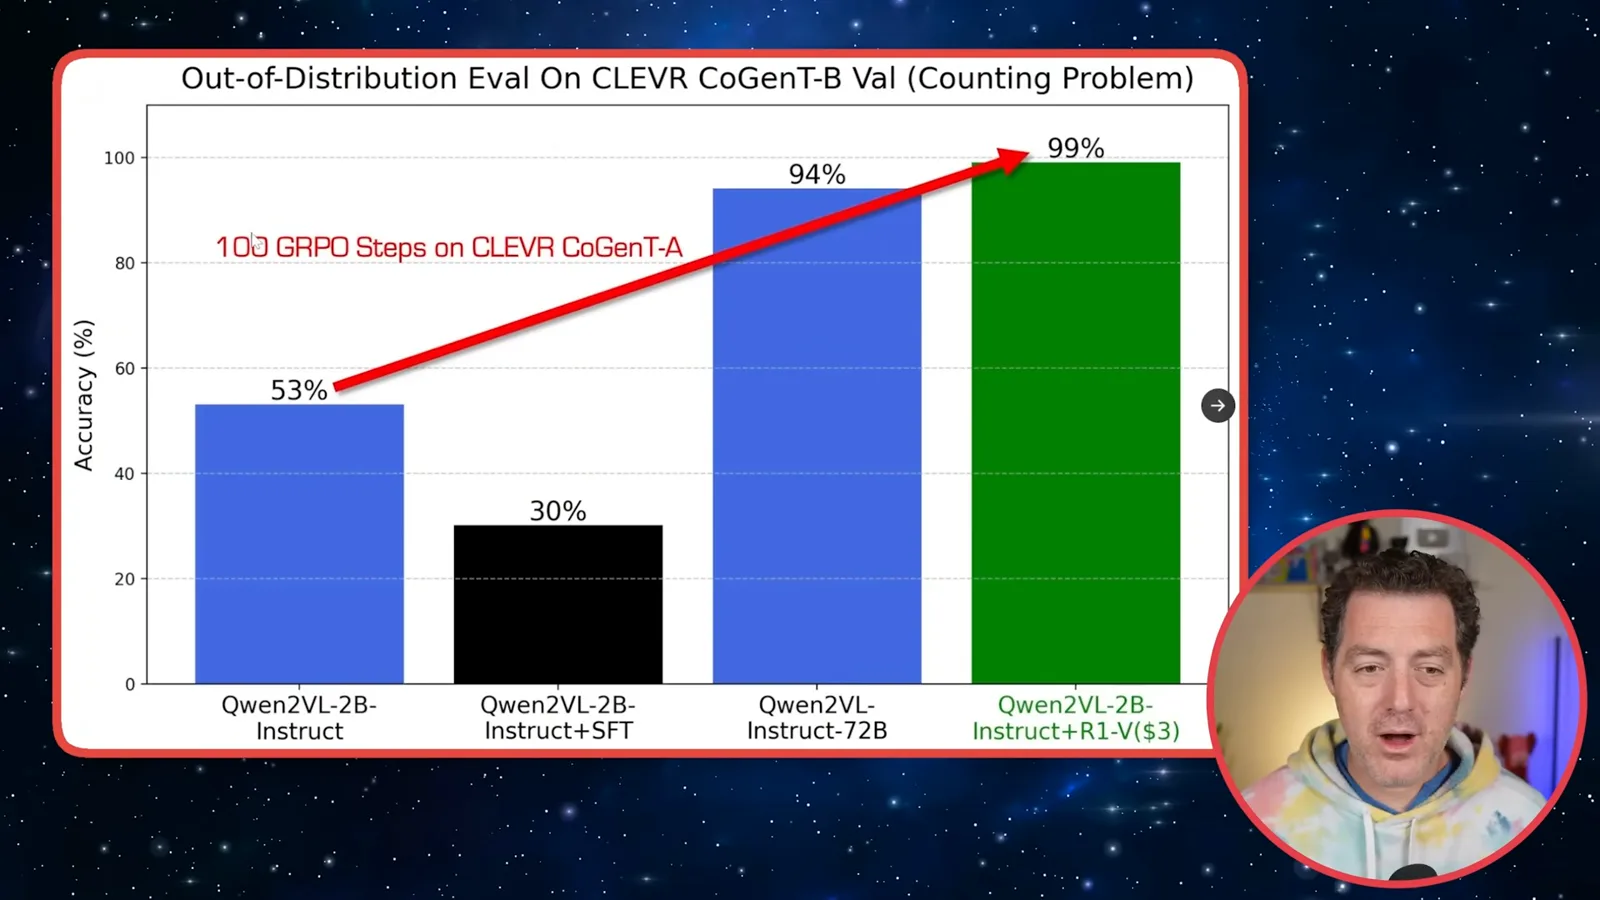
展示的 CLEVR CoGenT-B 计数分布外评估显示,原始 Qwen2-VL 2B 模型的准确率为 53%,经过 R1-V 训练后为 99%;Qwen2-VL 72B 为 94%。图表还显示,监督微调版本的准确率为 30%。这些数字描述的是所展示的评估及其特定训练设置。
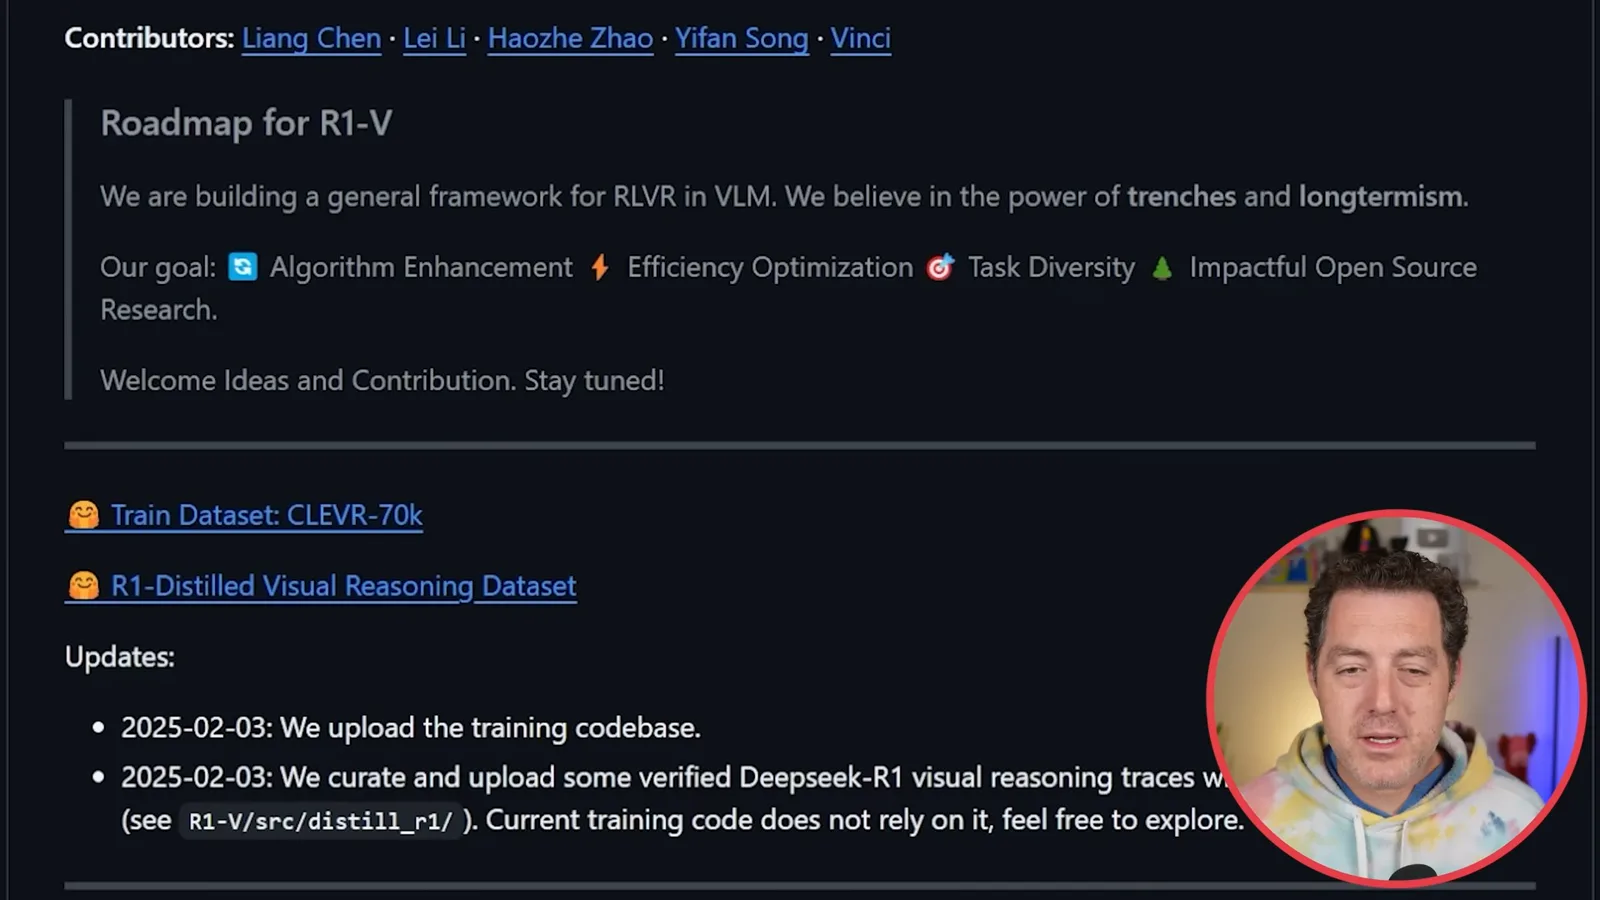
R1-V 团队表示,其目标是为视觉语言模型构建一个使用可验证奖励的通用强化学习框架。我设想将此类工具应用于其他奖励可检验的任务,并认为社区能够复现和扩展想法是开源的一项优势。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。