30 秒看懂
Matthew Berman 介绍 WizardCoder 15B,这是一款专注于代码、基于 StarCoder 微调的模型,并在 text-generation-webui 中演示其本地 GPTQ 版本。他进行了几道 Python 编程挑战,还尝试生成一个 Snake 游戏。 在他展示的例子中,小函数通过了练习网站的检查,而生成的游戏无法运行。他的基准比较和配置反映的是 2023 年 6 月的情况,不应视为当前排名或普遍限制。
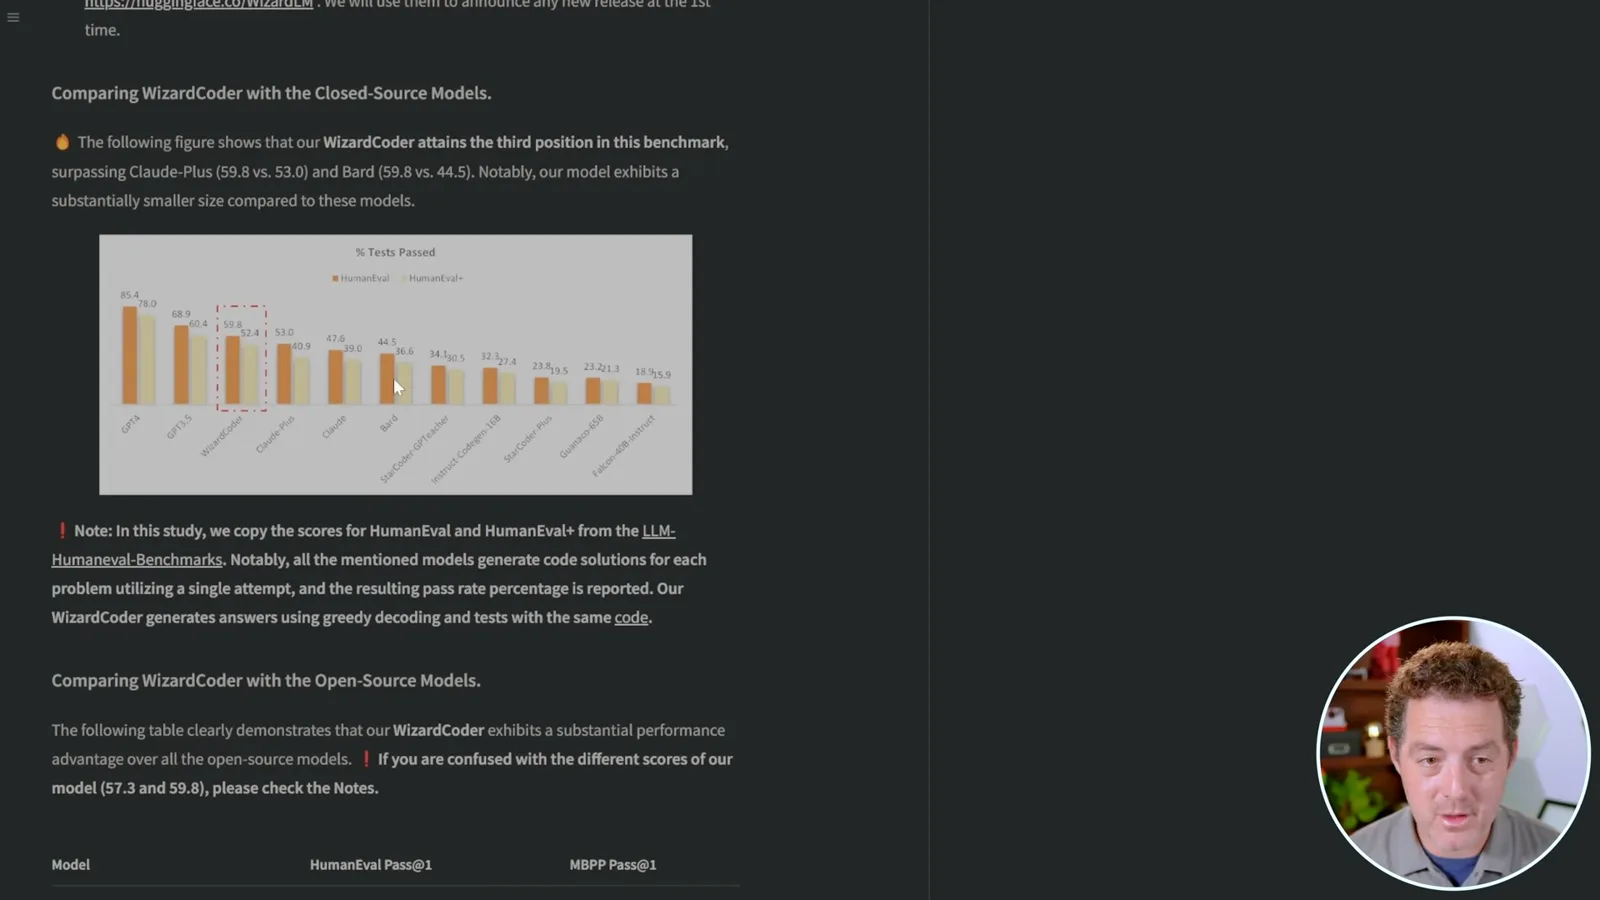
- 1面向代码的微调模型说明称,团队针对代码指令调整了 Evol-Instruct,并微调了 StarCoder。基准图表反映的是作者在当时进行的比较。
- 2本地运行模型Berman 启动已有的 text-generation-webui 环境,并选择 TheBloke 提供的 WizardCoder 15B GPTQ 版本。
- 3提示词的影响一次输出以意外的 token 标记结束;Berman 表示,在他的测试中删除示例有时可以解决这个问题。
- 4小型 Python 练习演示展示了整除判断、参数计数和数字格式化的解法,其中一些例子通过了检查。
- 5较长的游戏程序失败Snake 程序需要继续生成,测试时却无法运行;Berman 没有进一步调试。
要点建议
- 根据模型说明,WizardCoder 15B 基于 StarCoder,使用面向代码的 Evol-Instruct 训练数据。
- Berman 使用已安装的 text-generation-webui 在本地运行 GPTQ 版本。
- 几道小型 Python 练习通过了网站检查,但生成的 Snake 程序无法运行。
- 删除示例在 Berman 的测试中有所帮助,但这不能构成普遍的提示规则。
- 展示的模型比较和界面设置反映了 2023 年演示时的情况。
按章节阅读整理后的全文
WizardCoder 及其训练
Berman 介绍一款可以本地运行、拥有 150 亿参数的编程模型。他讨论了它的 StarCoder 基础、训练方法和 2023 年的模型比较。
WizardCoder 是一个可以在本地运行的编程助手。在这次 2023 年 6 月的演示中,我介绍模型的背景、加载本地版本,并用 Python 编程挑战测试它。这些结果只是一套配置下的非正式观察,不代表当前编程模型的排名。
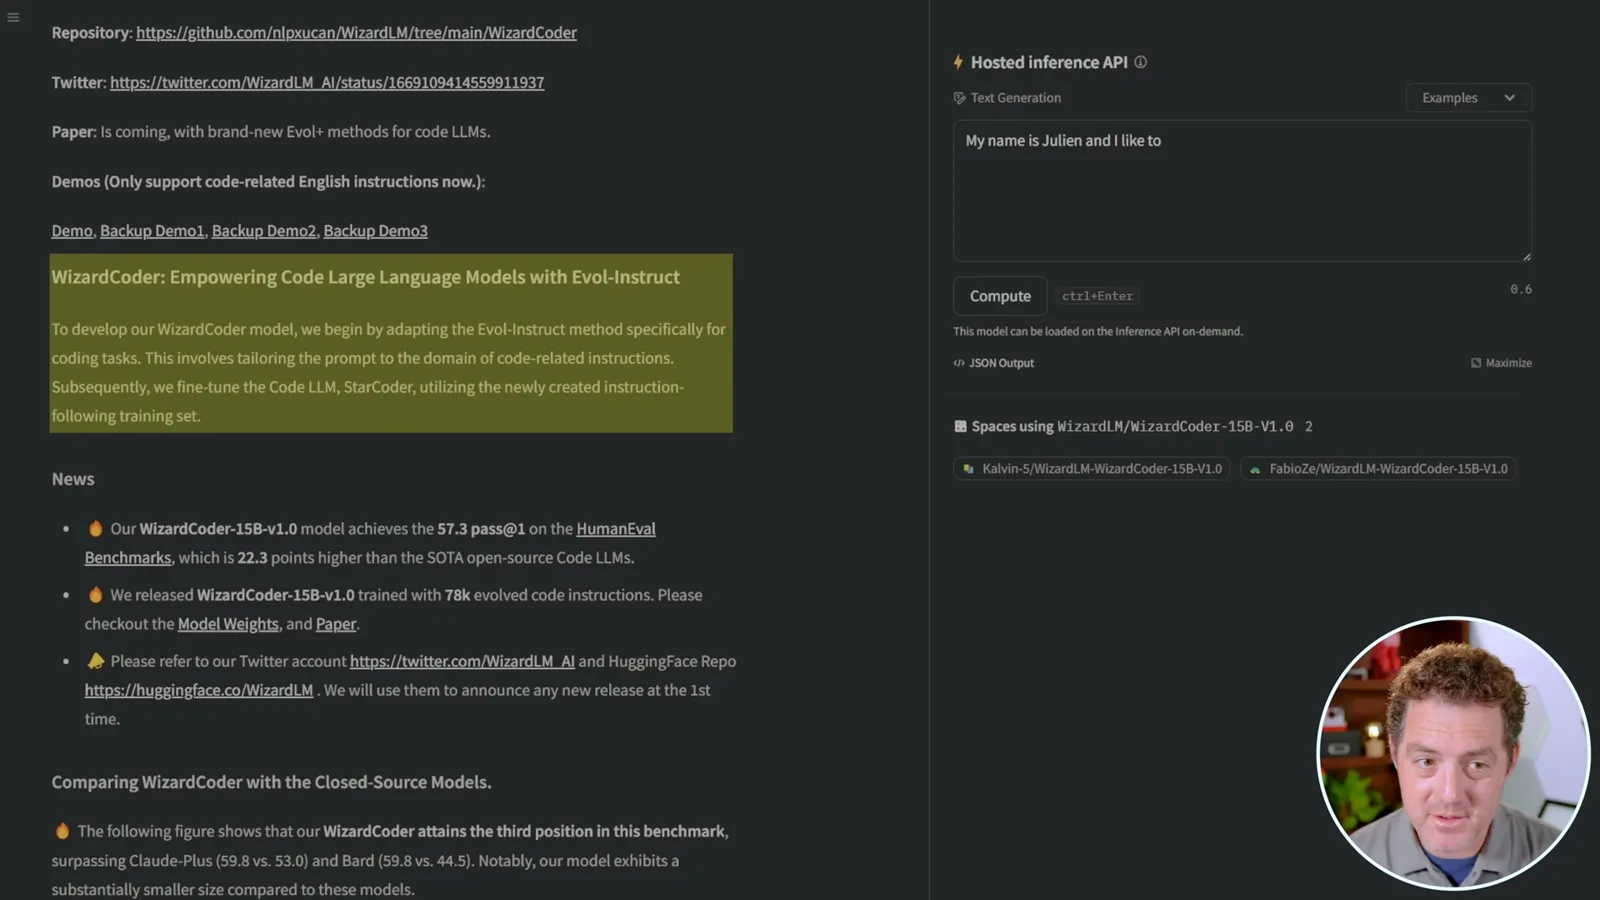
WizardLM 团队介绍,他们将 Evol-Instruct 方法调整为适用于代码相关指令,然后使用得到的指令跟随数据集微调 StarCoder。模型拥有 150 亿参数。作者展示的基准测试显示,它与当时的其他模型相比表现出色,但在展示的测试中低于 GPT-3.5 和 GPT-4;这类结果取决于基准和设置。
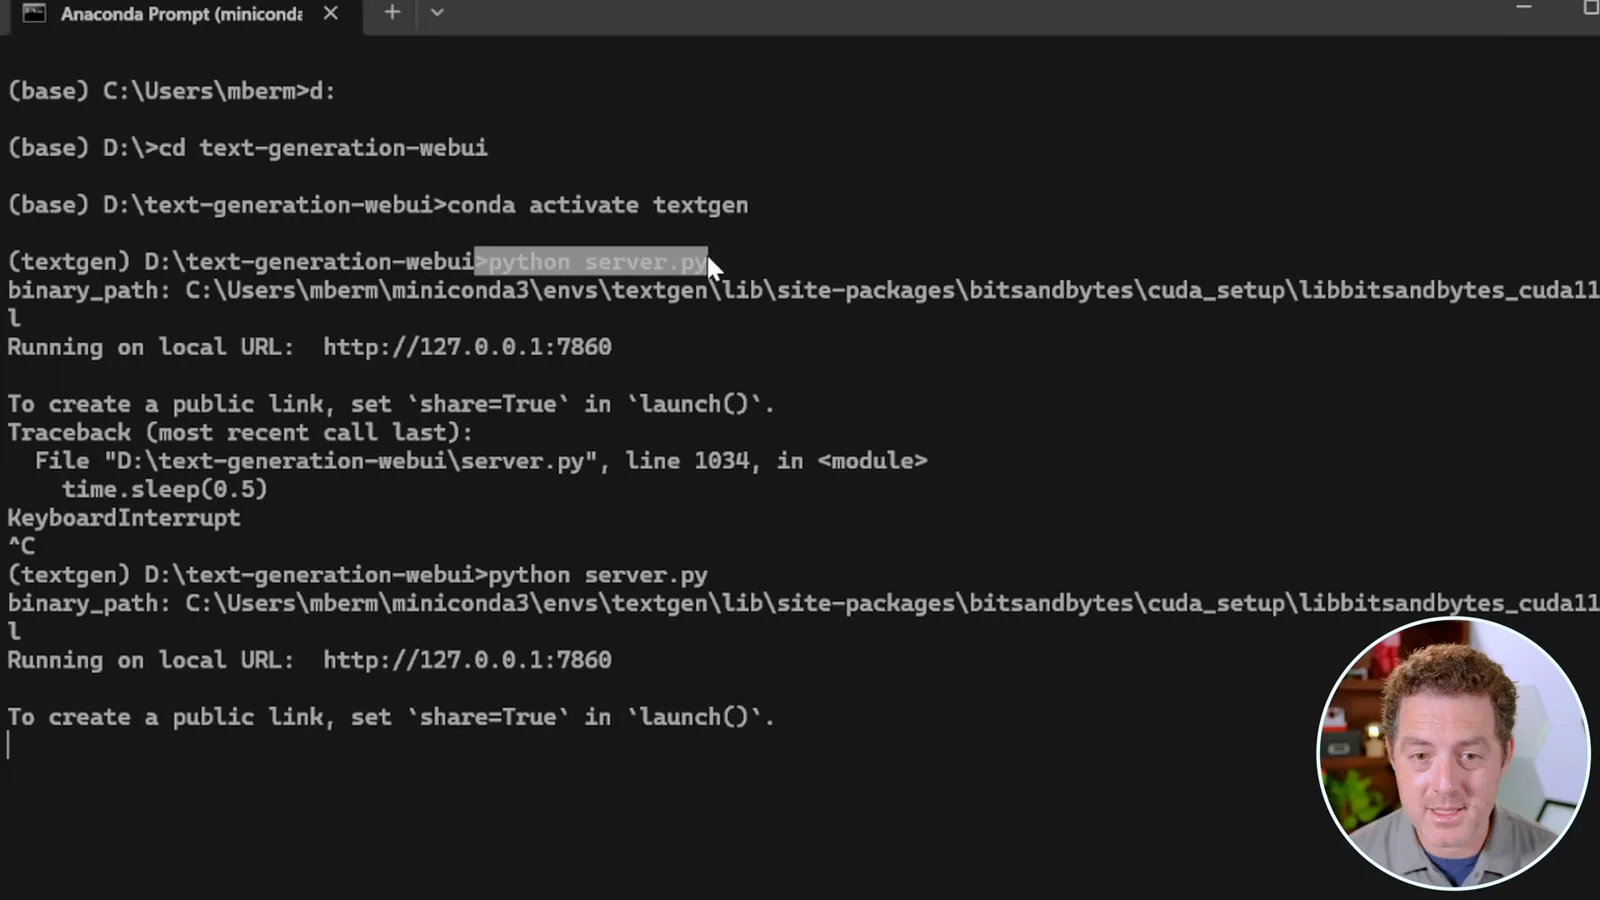
我使用的是 TheBloke 提供的 GPTQ 版本。这份简短教程假设已经安装 text-generation-webui:在我的 conda 环境中,我用 `python server.py` 启动服务器,然后在界面中选择 WizardCoder 15B 模型。具体命令和硬件要求取决于安装方式和模型格式。
加载本地模型
他启动预先安装的 text-generation-webui 服务器,并选择 GPTQ 版本。随后,他介绍了用于非正式测试的 Python Principles 练习。
我使用 Python Principles 进行测试,该网站按难度列出编程练习。第一题要求找出字符串中大写字母的索引。我将指令复制给模型,并将最大新生成 token 数设为 2,000。在我的配置上生成速度很快,但速度会因机器而异。
小型编程挑战
演示包括奇怪的输出标记、整除判断、参数计数和千位分隔符函数。结果随提示词和练习的不同而变化。
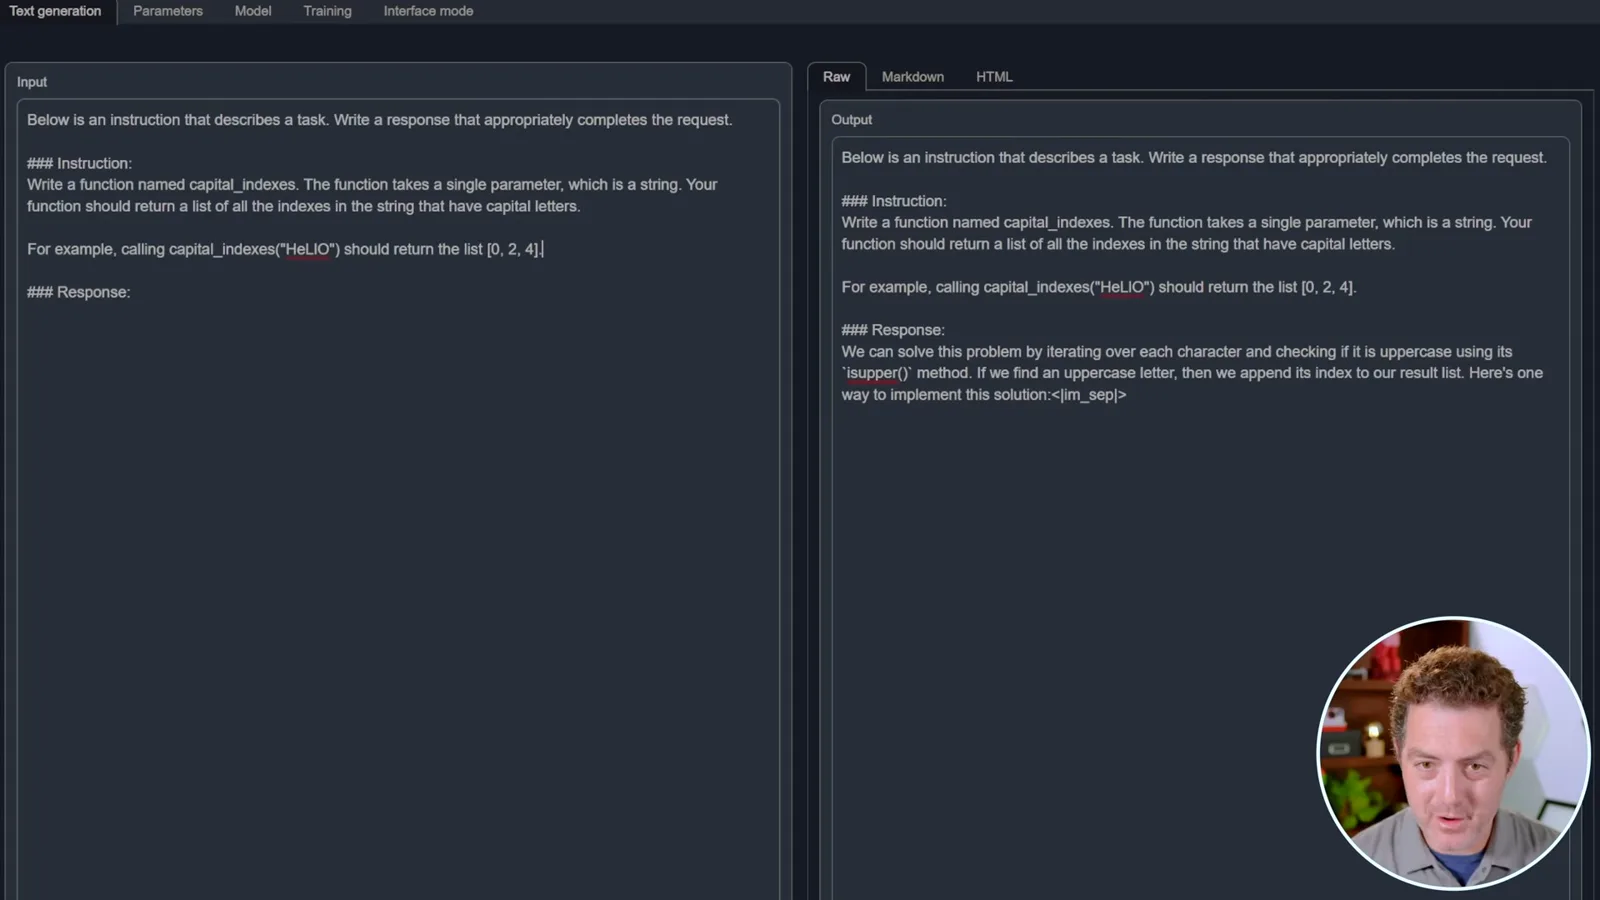
有时回答会意外地以一个特殊标记结束,而没有输出代码。在我的实验中,从提示词中删除示例并重新运行有时能解决问题。这是我在这套配置下观察到的一种变通方法,并不意味着总应该省略示例。
下一题要求编写 `div_3` 函数,返回一个整数是否能被 3 整除。练习网站判定生成的答案正确。我还展示了一道参数计数题:函数接受数量不定的参数,并返回收到的参数个数。
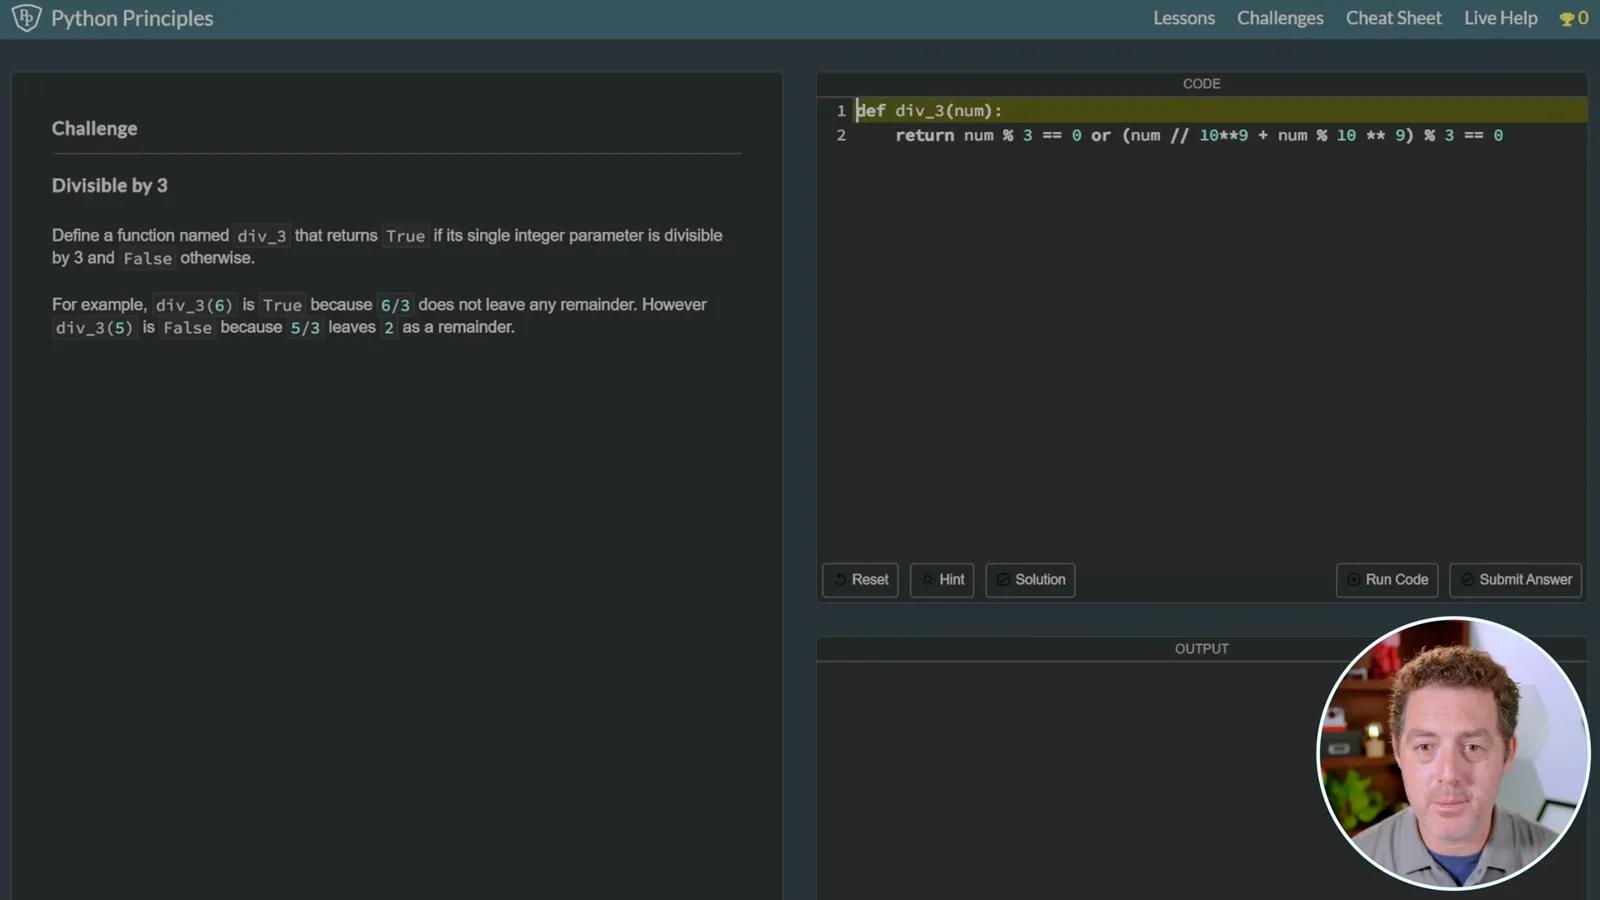
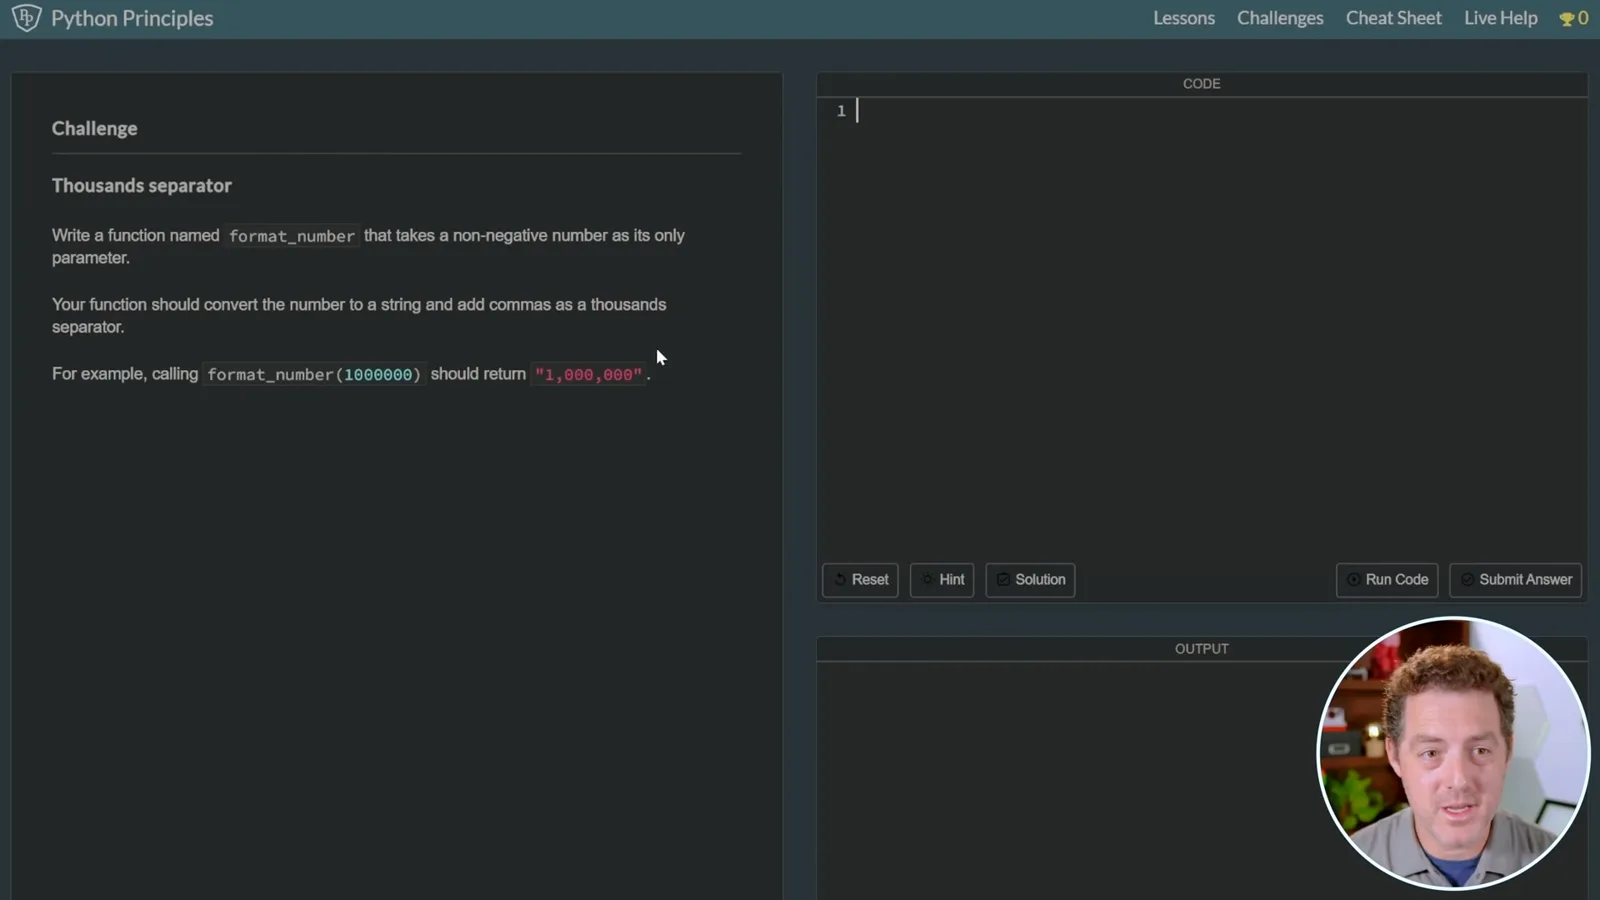
一道更难的练习要求 `format_number` 将非负数转换为字符串,并用逗号作为千位分隔符。我在提示词中省略示例,将生成的函数粘贴回练习,网站判定答案正确。另一次我加入示例后,回答变得更复杂,并产生了错误。
较长的 Snake 程序
Berman 尝试用界面的继续生成功能编写 Python 版 Snake 游戏。生成的程序无法运行,这影响了他对模型局限性的评价。
接着我要求模型编写 Python 版 Snake 游戏。在这个界面中,我将生成设置为 2,000 个 token,有时可以使用 Continue 按钮延长输出;这是本次演示的设置,并不是本地模型的普遍限制。继续生成似乎成功了,但我在 VS Code 中保存代码后,程序无法运行。
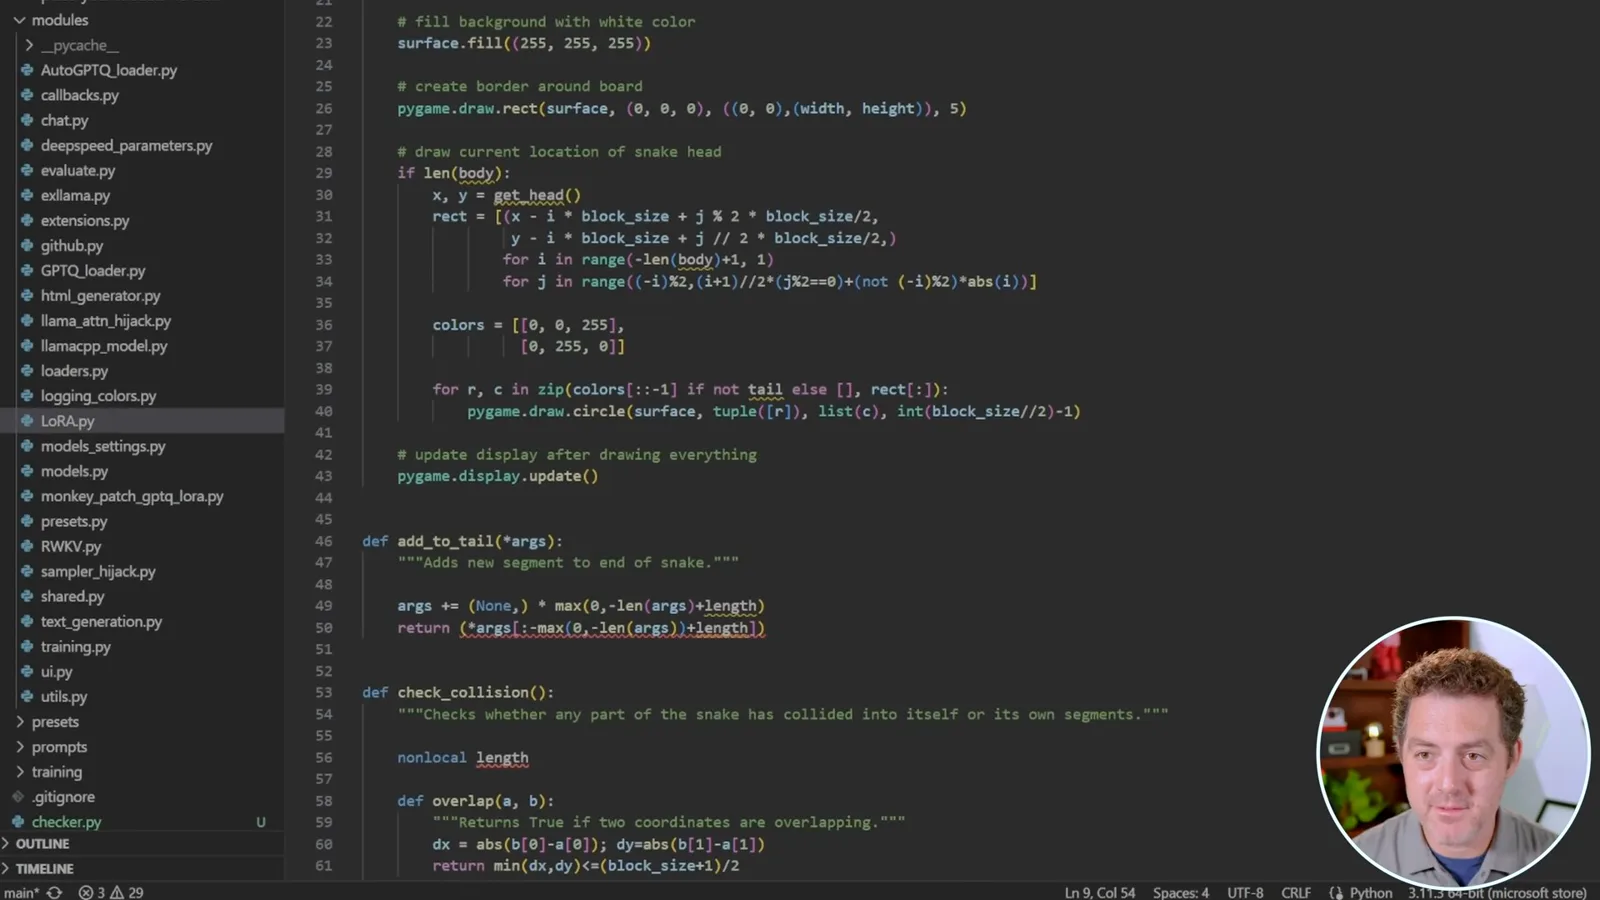
我决定不再进一步调试这个游戏。从这些有限的测试来看,我认为模型适合编写相对较小的函数,包括一些较复杂的函数,但按照我当时的评价,它还达不到 GPT-3.5 或 GPT-4 的水平。它的实际吸引力在于可以本地运行。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。