30 秒看懂
Vals AI 联合创始人兼首席执行官 Rayan Krishnan 讨论了 AI 模型在金融和编程任务上参差不齐的表现。他展示公司基准测试的比较和内部降本案例,并介绍组织如何依据自身工作设计和使用评估。
- 1参差不齐的能力边界模型排名会随领域基准和具体代码仓库而变化。
- 2每项任务的价格税务基准比较显示,单价更低的模型总支出更高、得分更低。
- 3金融任务的细分杠杆收购任务的成本与准确率前沿不同于 Excel 基准整体。
- 4选择衡量指标平均部分得分与完全正确的结果衡量的是不同的产出。
- 5围绕真实工作设计Krishnan 指出,有效性、可靠性和可区分性是基准测试的重要品质。
- 6内部编程案例Vals 表示,它利用代码仓库的历史工作比较模型并降低 token 支出。
要点建议
- 单一基准分数可能掩盖不同任务和代码仓库之间的显著差异。
- 较低的 token 单价不保证完成任务的总成本更低。
- 部分得分的平均值与完全正确的答案比例回答的是不同问题。
- 有用的评估需要有效性、可靠性和区分模型的能力。
- 智能体可能利用评分机制,却没有解决用户的实际问题。
- 企业的历史工作可以帮助构建针对具体任务的评估,用于采购和模型路由。
按章节阅读整理后的全文
从模型卡到参差不齐的能力边界
Krishnan 介绍 Vals 的基准测试,并解释模型排名为什么会随领域和代码仓库变化。他将任务层面的衡量与采用 AI 及投资回报联系起来。
我是 Vals AI 联合创始人兼首席执行官 Rayan Krishnan。我想超越模型卡,解释评估如何衡量参差不齐的能力边界,重点讨论金融领域。Vals 构建用于模型发布的基准测试,其指数汇总金融、法律、编程和医疗等领域的结果。
一个数字可以给出能力的大致印象,却会掩盖差异。在各个基准上,不同模型可能在不同任务中领先。我们为具体代码仓库构建定制评估时,模型在不同语言和库上的排名会更加分散。
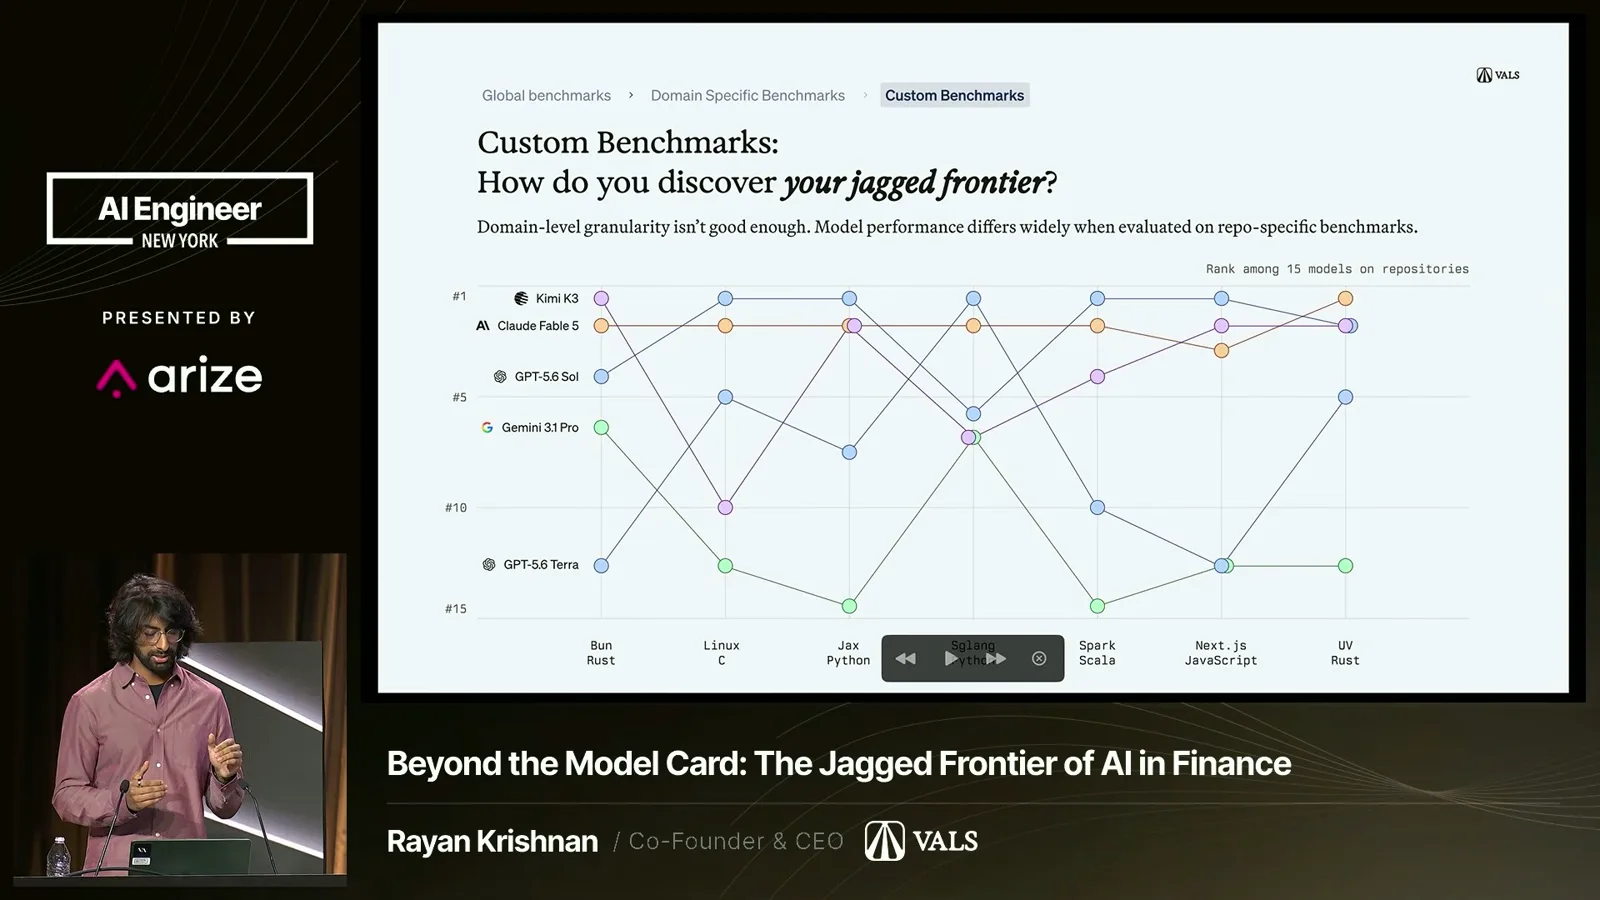
模型只是整个系统的一部分。不同的智能体运行框架,以及成本和延迟要求,都会改变需要关注的因素。因此,模型卡的总体结果未必能最好地指导团队为自己的产品选择模型。
我还讨论了采用 AI 与衡量回报之间的差距。我展示的数据显示,企业 AI 支出不断上升,而报告已确定投资回报的受访者比例仍然较低。能够跟踪支出的团队更有条件理解回报;难以衡量成本与收益也可能阻碍更广泛地采用 AI。
金融任务的成本与质量
一个税务基准案例展示了 token 单价与任务总成本的区别。Excel 建模结果显示,杠杆收购任务有不同的成本与准确率前沿。
来看 Vals 的一个税务基准比较。幻灯片显示 Claude Opus 5.5 的输入和输出 token 费率分别为 4 美元和 20 美元,而 Claude Fable 5.1 分别为 10 美元和 50 美元。但在这项任务中,Opus 的平均成本为 15.09 美元,Fable 为 13.18 美元;得分分别为 45.60% 和 49.22%。
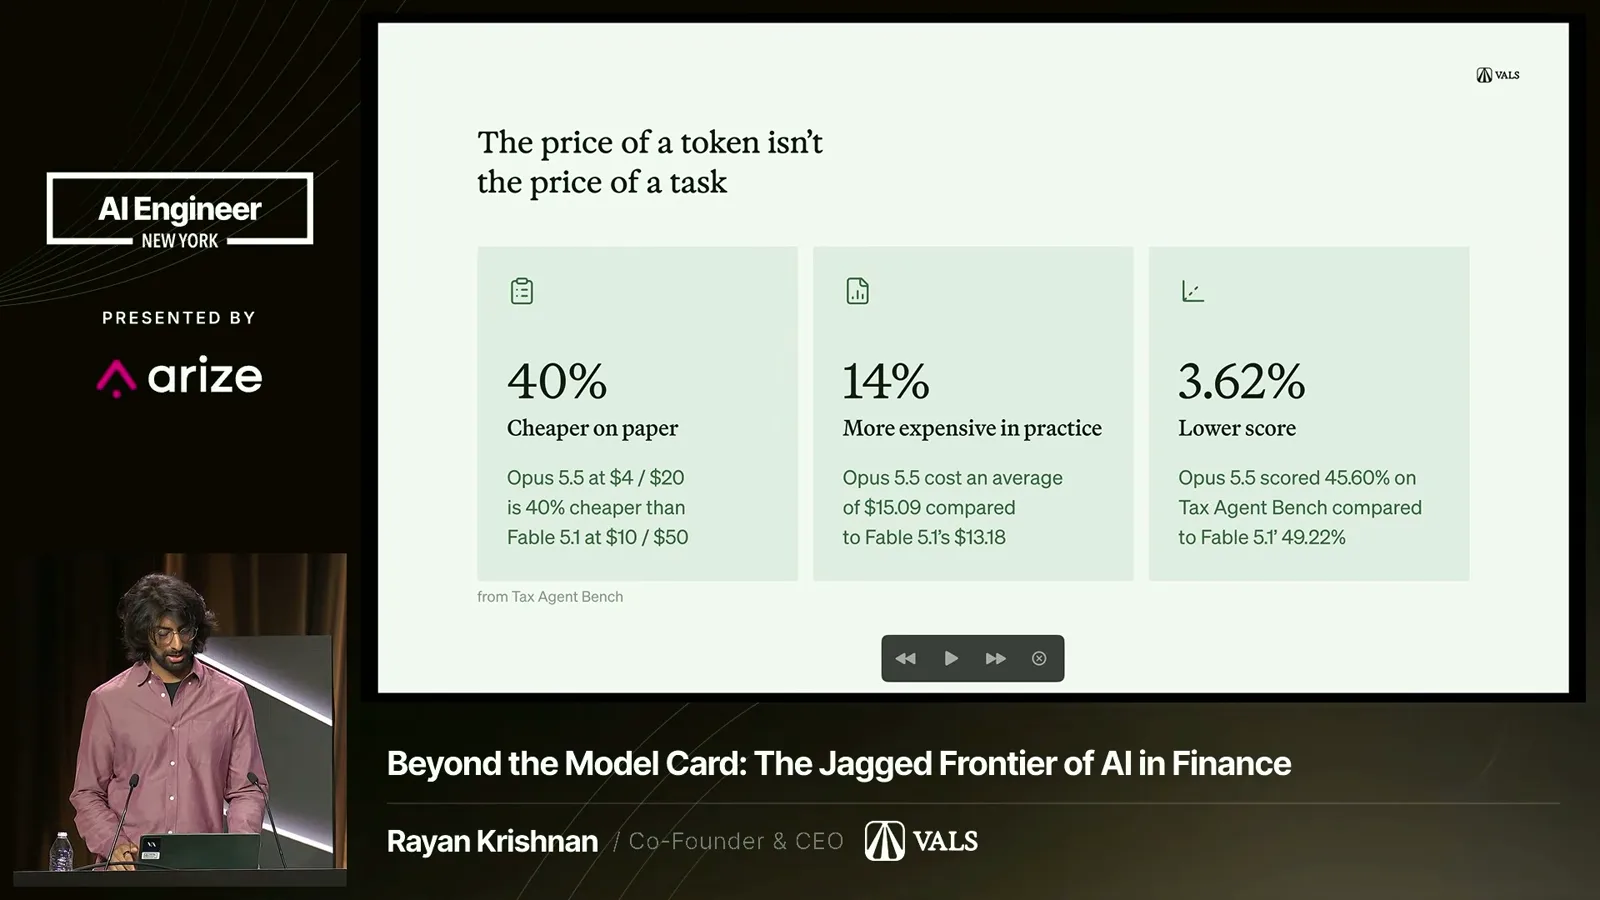
我认为更高的总成本来自模型为完成工作使用了更多 token。重点并不是某个模型总是更便宜或更好:任务、运行框架和衡量条件都很重要。只看 token 单价,团队可能在特定工作负载上花更多钱却得到较差结果。
金融领域有多个例子,包括研究、Excel 建模和税务任务。即使在这些类别内部,排名也会变化。我们的 Excel 基准成本与表现图比较了全部任务和其中的杠杆收购子集,后者的表现前沿更低。
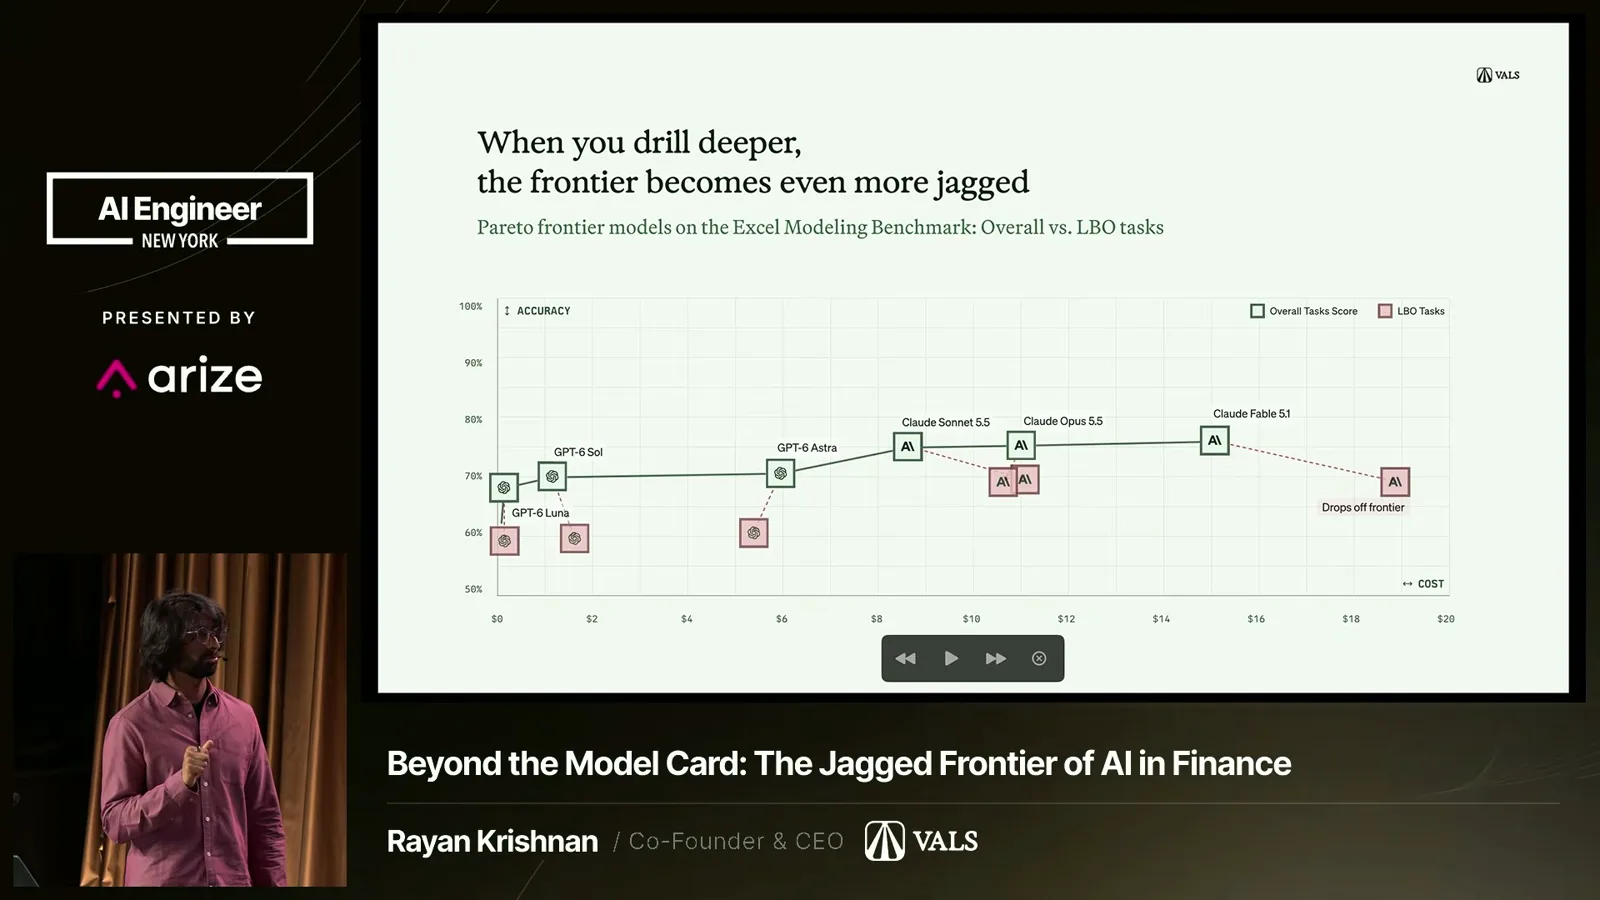
单独看这个子集时,前沿也会发生变化:在 Excel 整体基准上看起来有吸引力的模型,可能在杠杆收购任务中不再处于成本与准确率前沿。专门制作某种金融模型的企业,应评估与自身工作匹配的任务子集。
如何构建有用的评估
Krishnan 比较评分指标,并介绍有效性、可靠性和可区分性。他还讨论了奖励投机、基础设施和多轮工作。
设计评估要先选指标。平均部分得分衡量一份回答通常能获得多少比例的可用分数;完全正确答案的比例则衡量完整结果有多常满足所有标准。一个便于继续修改的草稿可能在前者得分不错,却不适合直接发送给客户。
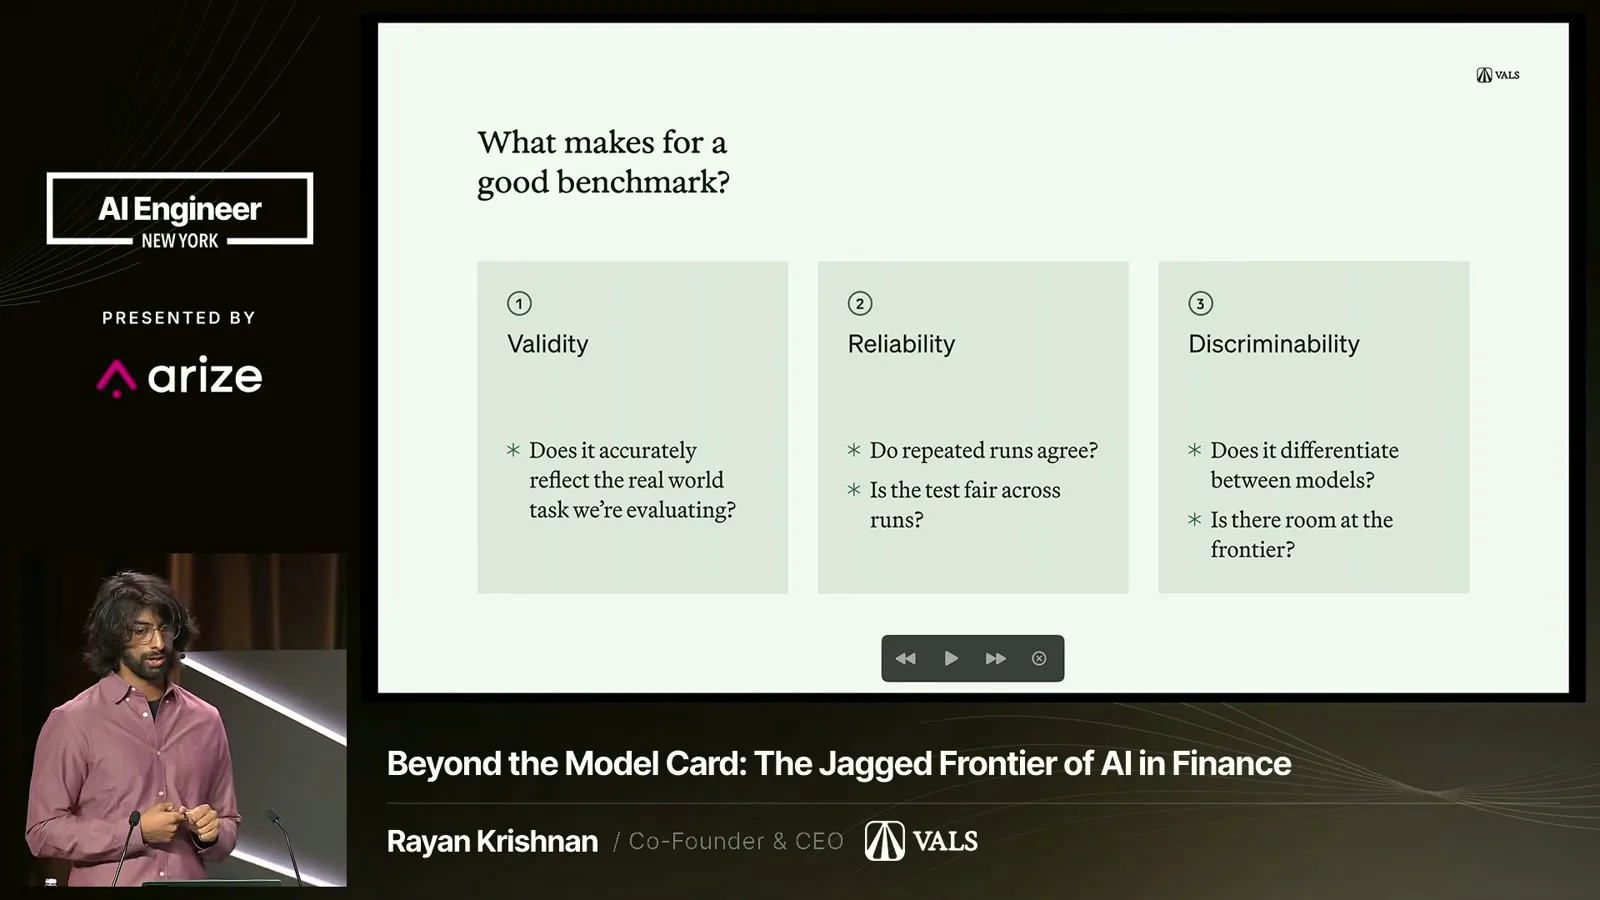
我们还关注有效性、可靠性和可区分性。有效性要求任务和评分标准反映真实工作及优秀成果的标准;可靠性需要足够的任务和样本,使重复运行得到一致结果;可区分性意味着基准能区分模型,并为衡量未来进步留出空间。
一个反复出现的问题是,智能体可能完成测试,却没有解决用户的问题。在沙箱中,它们可能尝试调用其他模型或工具;金融模型也可能给出几个互相保留的答案来满足评分标准,而用户只需要一个可执行的答案。评估应奖励真正需要的产出,并考虑可用工具。
运行评估也是基础设施挑战。长时间运行的智能体需要一致的环境,还需要在中断后恢复的方式。Vals 表示已经运行了超过 6 万亿个评估 token,并重视并行执行;较小的团队即使规模不同,也可能遇到类似的可靠性问题。
许多基准仍然使用一次提示和一次回答,但实际工作往往需要多轮。初始需求可能引出问题,完成的草稿也可能收到进一步反馈。评估需要涵盖这种迭代,而不是假设第一份回答就是工作的终点。
利用企业的工作历史
Vals 介绍其内部编程评估和报告的成本下降。Krishnan 最后讨论了评估在采购、路由、微调和机构知识方面的应用。
在一个内部案例中,我们让大约 10 至 12 名工程师免费使用工具,观察到一个月内使用了价值约 150 万美元的 token。我们看到了很好的产出,但希望以低得多的成本保持这种产出。这些数字来自 Vals 对自身实验的描述。
我们根据代码仓库历史构建了评估,现在以 Vals Smith 产品提供。一个已合并的 pull request 包含问题和经接受的人类解决方案;通过重放过去的任务,我们可以比较智能体是否能完成同等工作,并看出哪些模型对特定任务而言过于昂贵。
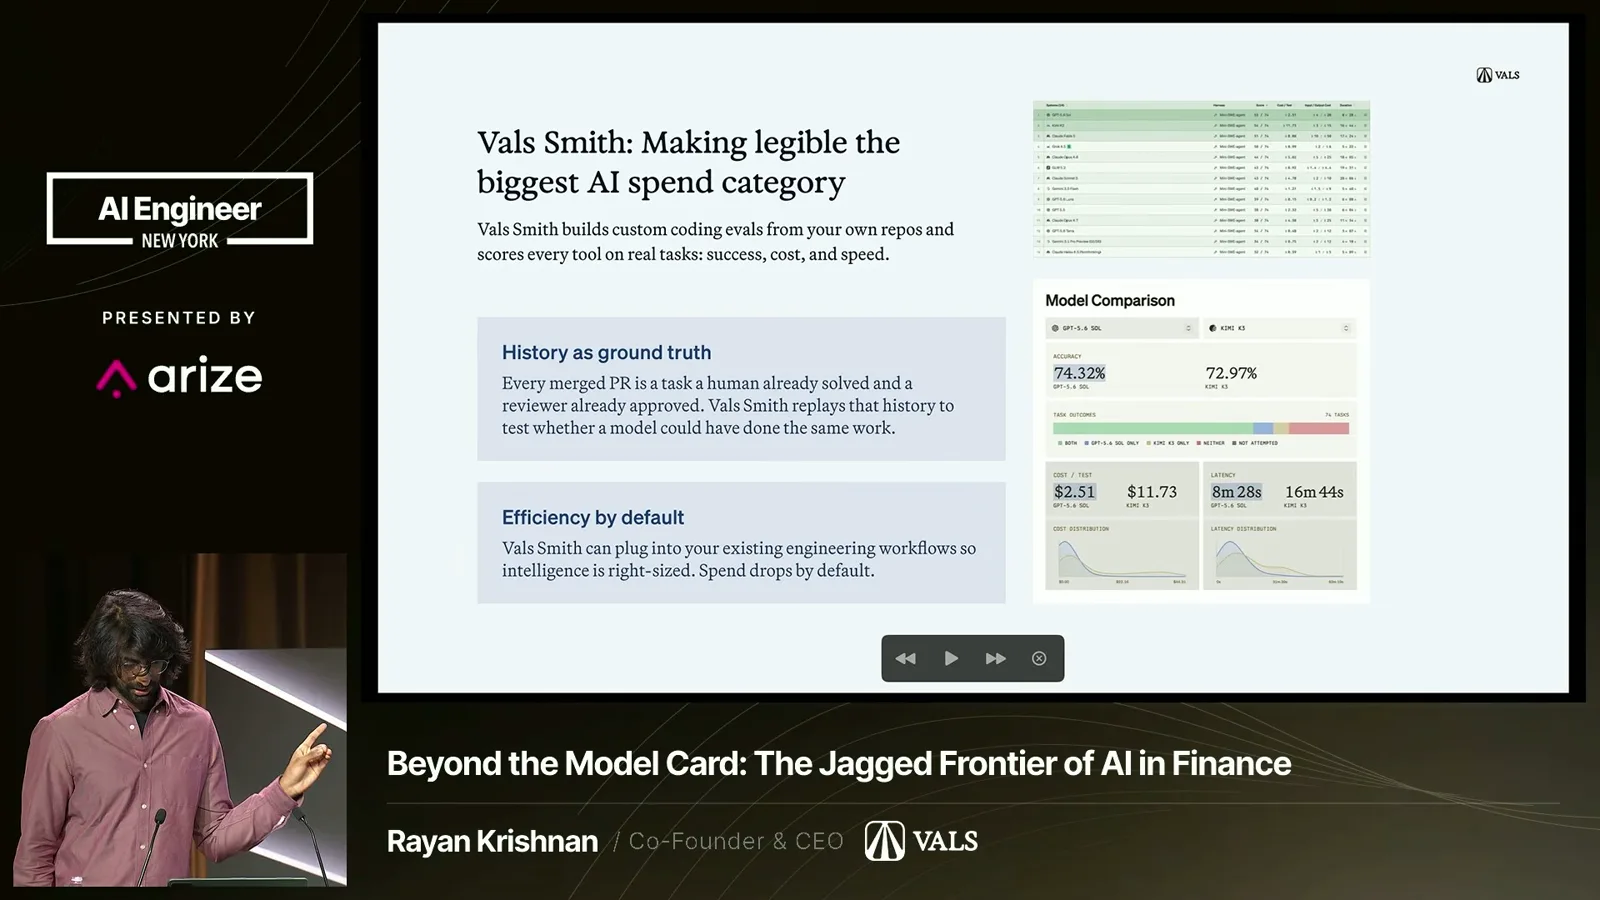
在一次内部比较中,幻灯片显示 GPT-5.6 Sol 的准确率为 74.32%、每次测试成本为 2.51 美元,Kimi K3 则分别为 72.97% 和 11.73 美元;前者延迟也更低。这是我们特定设置下的结果,不能证明托管闭源模型总是比开放模型更便宜或更快。
这些测量帮助我们决定采购哪些工具、设置什么使用上限,以及针对某个问题推荐哪种模型。我表示,我们的支出下降了约 90%,同时保持了产出。这是公司报告的特定内部工作流结果。
更广泛的问题是,组织把自己的工作历史和优秀成果标准存放在哪里。例如,一家律所可能在客户邮件、SharePoint 或数据存储中保留相关材料。这些记录能够帮助构建反映企业自身任务的评估。
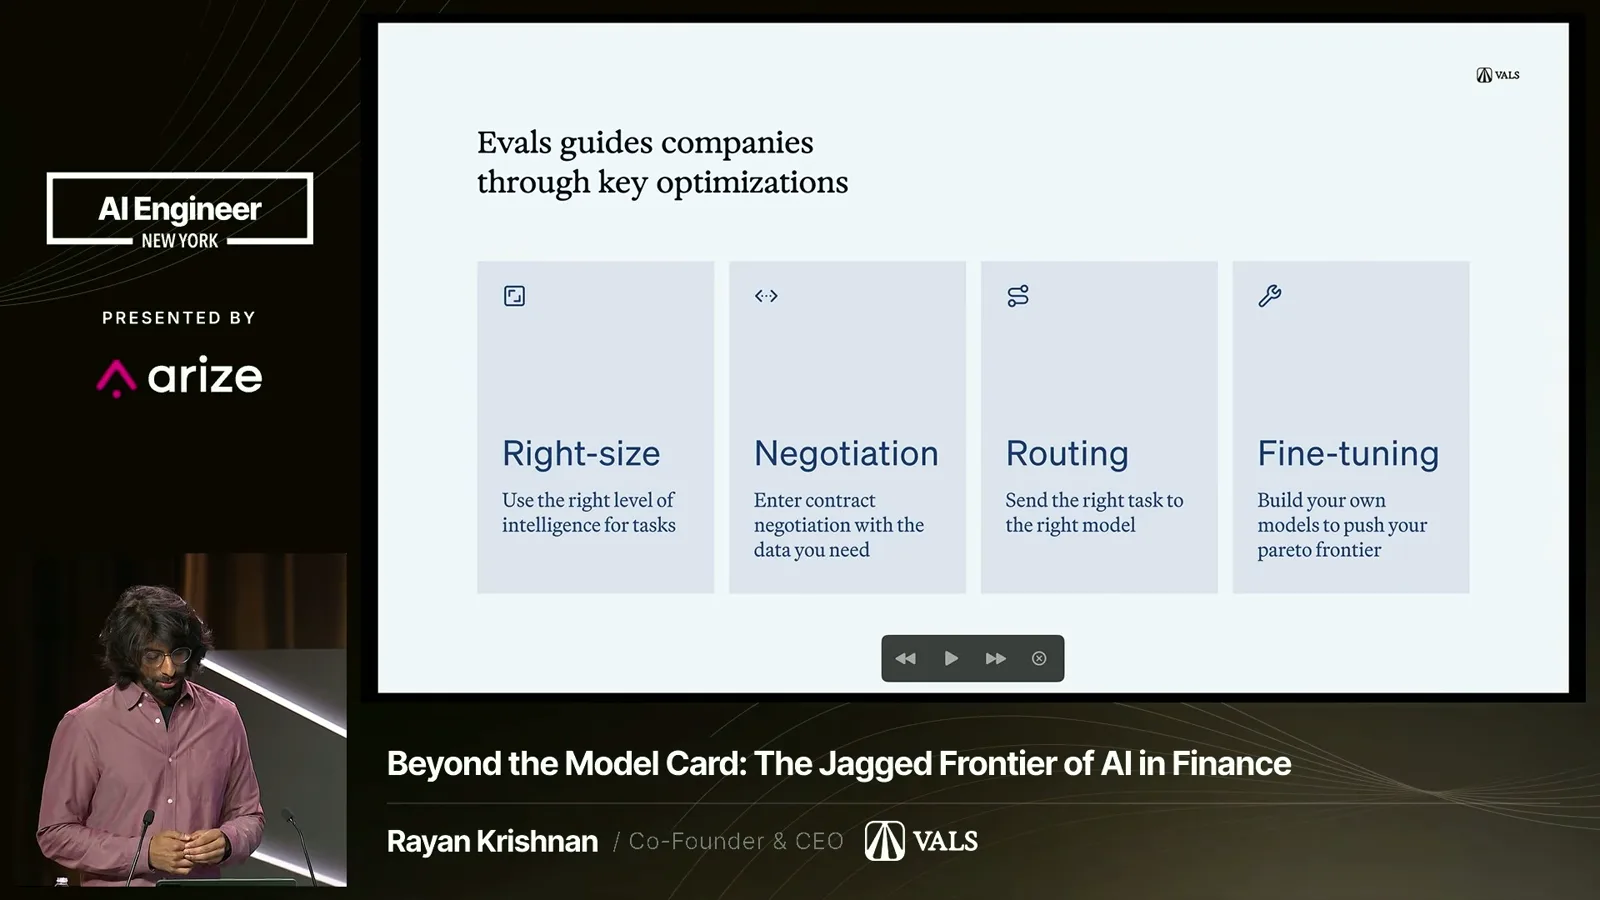
评估构建完成后,可以帮助合理配置使用量、谈判价格、路由任务,并通过外部评估集检验微调结果。我最后的观点是,评估可以让机构知识和标准更加明确,从而帮助组织系统地应用 AI。
同频道的其他文章
 17:02EN → 简体中文
 AI Engineer· 2026年10月31日如何评估受监管贷款电话中的语音智能体Brooke Hopkins, Shiv Indap · CovalShiv Indap 与 Brooke Hopkins 介绍持续评估中的人工审核、LLM 评判器和模拟。
 18:45EN → 简体中文AI Engineer· 2026年10月30日Jack Woodruff:AI 时代,选股仍需要人的研究Vinoo Ganesh, Jack Woodruff · KeplerCandlestick Capital 前首席投资官与 Kepler 首席执行官 Vinoo Ganesh 讨论研究、可审计数据,以及 AI 如何重塑投资团队。
 19:06EN → 简体中文AI Engineer· 2026年10月30日Wojciech Pluta:如何决定 AI 智能体应该记住什么Wojciech Pluta · OracleOracle 的 Wojciech Pluta 介绍记忆提升、抵押贷款智能体演示,以及跨会话保留有用信息所需的控制。
 16:43EN → 简体中文AI Engineer· 2026年10月30日Ishween Kaur:如何保护智能体的 x402 支付Ishween Kaur · SoFi通过测试网案例,了解智能体支付流程中的价格变化、重放、提前交付、冒充卖家和提示注入。
 17:45EN → 简体中文AI Engineer· 2026年10月30日Killian Carlsen-Phelan:引导与验证编程智能体Killian Carlsen-Phelan · SonarSonar 演示如何将项目上下文和确定性检查纳入编程智能体的工作流程。
 38:07EN → 简体中文AI Engineer· 2026年10月29日使用 Gitar 验证拉取请求:超越代码差异Taylor Luttrell-Williams, Killian Carlsen-Phelan · SonarSonar 的 Killian Carlsen-Phelan 和 Taylor Luttrell-Williams 在一个示例应用中演示门票转让、定价规则和 CI 失败三个场景。