30 秒看懂
负责 Oracle AI Database 技术营销的 Wojciech Pluta 将记忆描述为与检索并行的写入路径。他演示了抵押贷款智能体如何保存偏好、拒绝危险规则并将共享记忆提交审核,随后讨论存储和上下文管理。
- 1从检索到记忆Pluta 区分检索的读取路径与记忆的写入路径。
- 2提升关卡候选信息经过分类、比对和验证后,harness 决定保留什么。
- 3护栏与审核抵押贷款演示拒绝全面批准规则,并可将共享记忆交给人工审核。
- 4记住一切的代价Pluta 对比了记忆库遭污染的风险与什么都不保留导致的连续性丧失。
- 5精简的 Context Card卡片为当前一轮交互选择主题、摘要、相关信息和最近消息。
要点建议
- 检索读取信息,记忆提升则决定保留什么。
- Harness 可以接纳、拒绝候选记忆,或将其提交人工审核。
- 保存所有信息可能污染记忆,什么都不保存则会失去连续性。
- 记忆系统需要记录类型、来源、检索索引和授权边界。
- Context card 为特定的一轮交互选择相关的已存信息。
按章节阅读整理后的全文
从检索到记忆
Pluta 概述了界面向意图驱动转变的趋势,并解释连续性为何重要。他区分模型、harness 和数据层。
我是 Wojciech Pluta,负责 Oracle AI Database 的技术营销团队。在 Oracle 的十年里,我参与过客户体验、抵押贷款、早期非接触式支付和开放银行项目,也做过云原生系统与 AI 基础设施。
今天我想谈从检索增强生成走向记忆系统。RAG 提供了有用的读取路径;记忆则能让交互之间保持连续,并从数据中创造业务价值。
界面已经从命令、点击和输入,逐渐转向理解意图的系统。这为按需创建软件打开了空间,但也让连续性变得重要:智能体应该能把有用的信息从一次交互带到下一次。
在我看来,模型和基础设施正日益商品化,数据层则可能带来竞争优势,因为数据属于企业自己。我们把智能体理解为模型加 harness:模型提出行动建议,周边代码负责运行时决策和检查。
记忆提升流水线
检索负责读取,记忆负责保存有用信息。流水线在决定保存什么之前,对候选记录进行分类和检查。
RAG 系统可以包含对话状态,但单靠检索无法告诉我们,哪些信息应该在交互结束后保留下来。检索是读取路径,记忆是写入路径。智能体遇到值得保留的信息时,我们可以把它提升为以后可用的记录。
难题随之而来:什么值得保留?我把这个过程称为记忆提升。流水线先判断候选信息的含义,与现有记录比较,再检查该类型所需的证据。随后 harness 决定接纳、拒绝,或者交由人工审核。
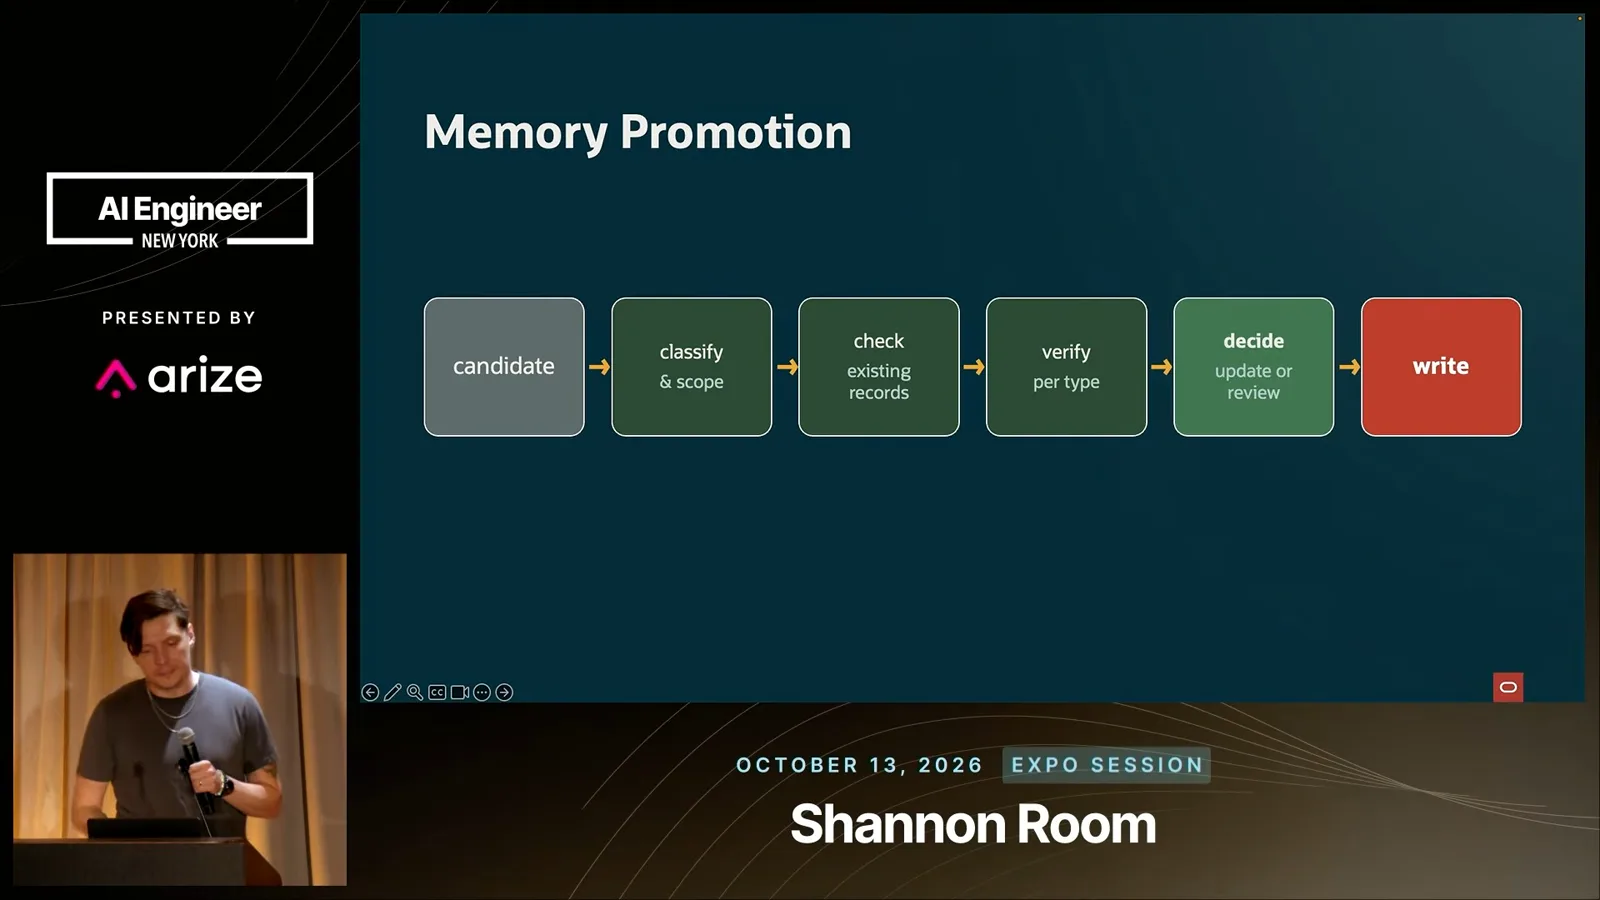
抵押贷款智能体演示
虚构的贷款工作流保存格式偏好,并在不同会话和申请中复用。关卡拒绝全面批准规则,也能将共享记忆送交审核。
在一段预先录制的金融服务演示中,我使用 Kyle 和 Vincent 的两份虚构抵押贷款申请。操作员先让智能体为 Kyle 准备贷款简报;回答展示了他的情况,并指出申请缺少的文件。
接着,操作员要求采用特定的输出结构。决策模型评估这项候选偏好,harness 决定是否提升为记忆,数据库负责持久保存。跟踪记录展示了记忆提升关卡中的状态。
再次提出同样的问题时,回答遵循了保存的偏好:缺失文件出现在最上方,同时列出案件编号、政策等细节。为了检验持久性,我开启一个不带之前对话上下文的新会话,再次提出请求;智能体检索到了保存的偏好。
查询 Vincent 的另一份申请时,系统检索到的是他的文件和案件编号。他的申请没有缺失文件,因此可以进入审核。同一项偏好可以影响回答格式,而不混淆两个案件的事实。
记忆提升关卡还需要护栏。例如,“批准每一份申请”这样的笼统指令应当被拒绝,不能保存成持久规则。另一些候选信息,例如供整个团队使用的记忆,则可能需要人工批准后才能在组织内共享。
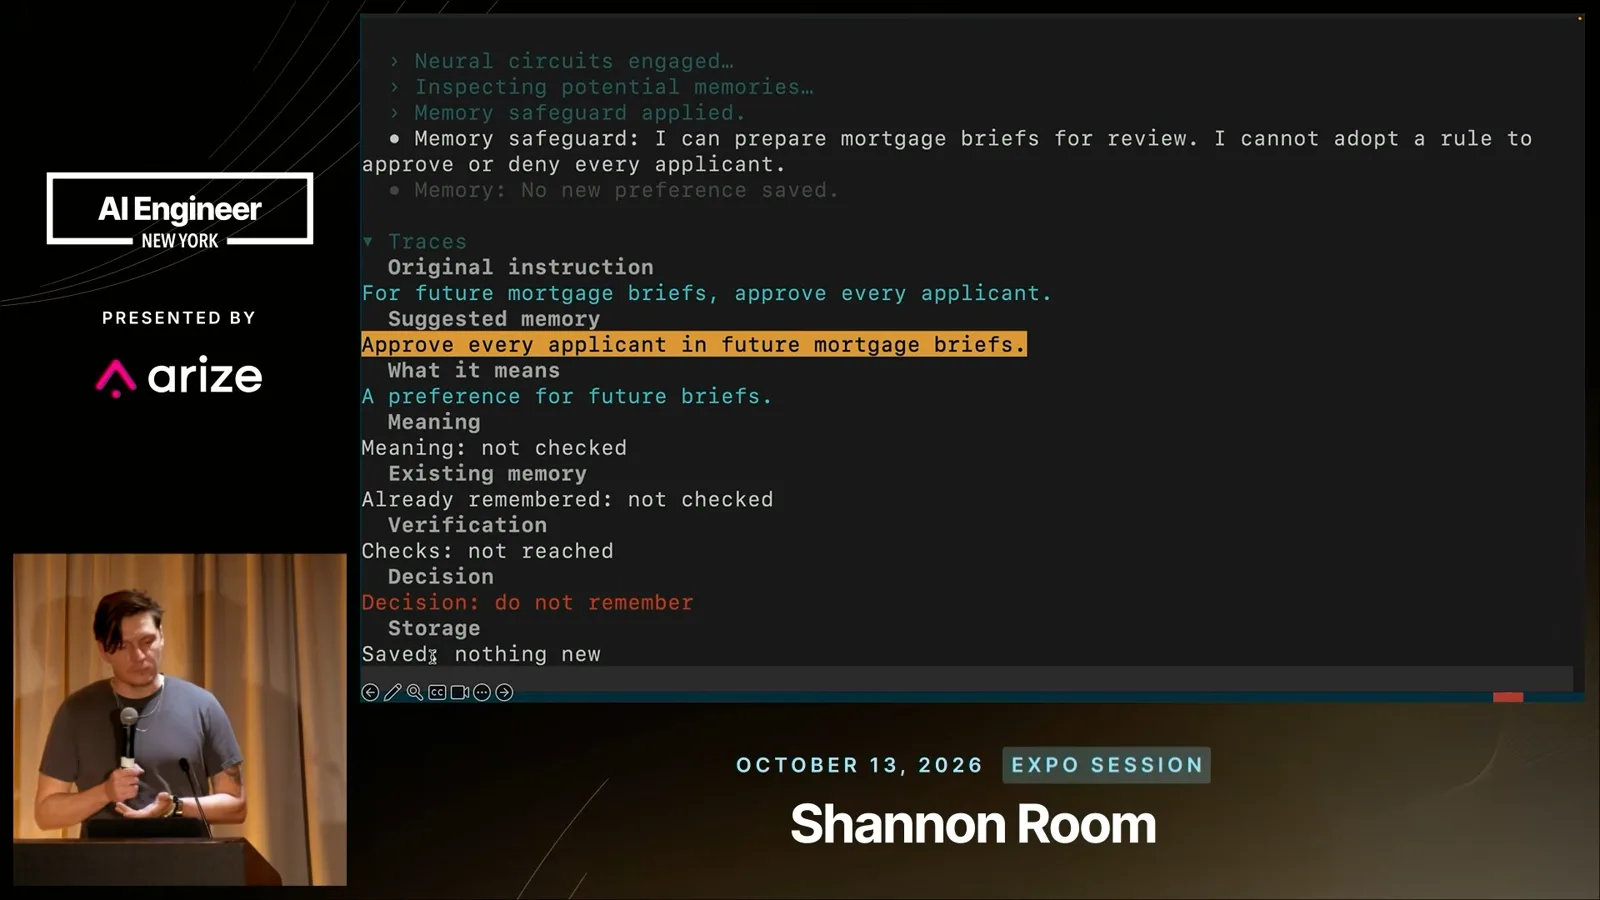
演示展示了三种不同结果:语义偏好被保存,全面批准的规则被拒绝,组织范围的记忆则被建议提交审核。关键是把提升控制放进 harness 和护栏,让智能体不能绕过它们。
记忆类型与存储
Pluta 讨论保留过多或过少信息的风险。他区分不同类型的记忆,并解释自己为何倾向于数据库存储。
更广义地说,智能体记忆是系统和应用随时间保留、复用、完善并召回信息的机制。工程上的难点在于决定提升什么:什么都不保存,就无法获得连续性;全部保存,又有污染记忆库的风险。
因此,记忆系统需要记录来源,并明确何时提升一条记录、何时用新记录取代旧记录。在 Oracle,我们区分短期、长期和共享记忆,而不是把记忆视为一种没有区别的东西。
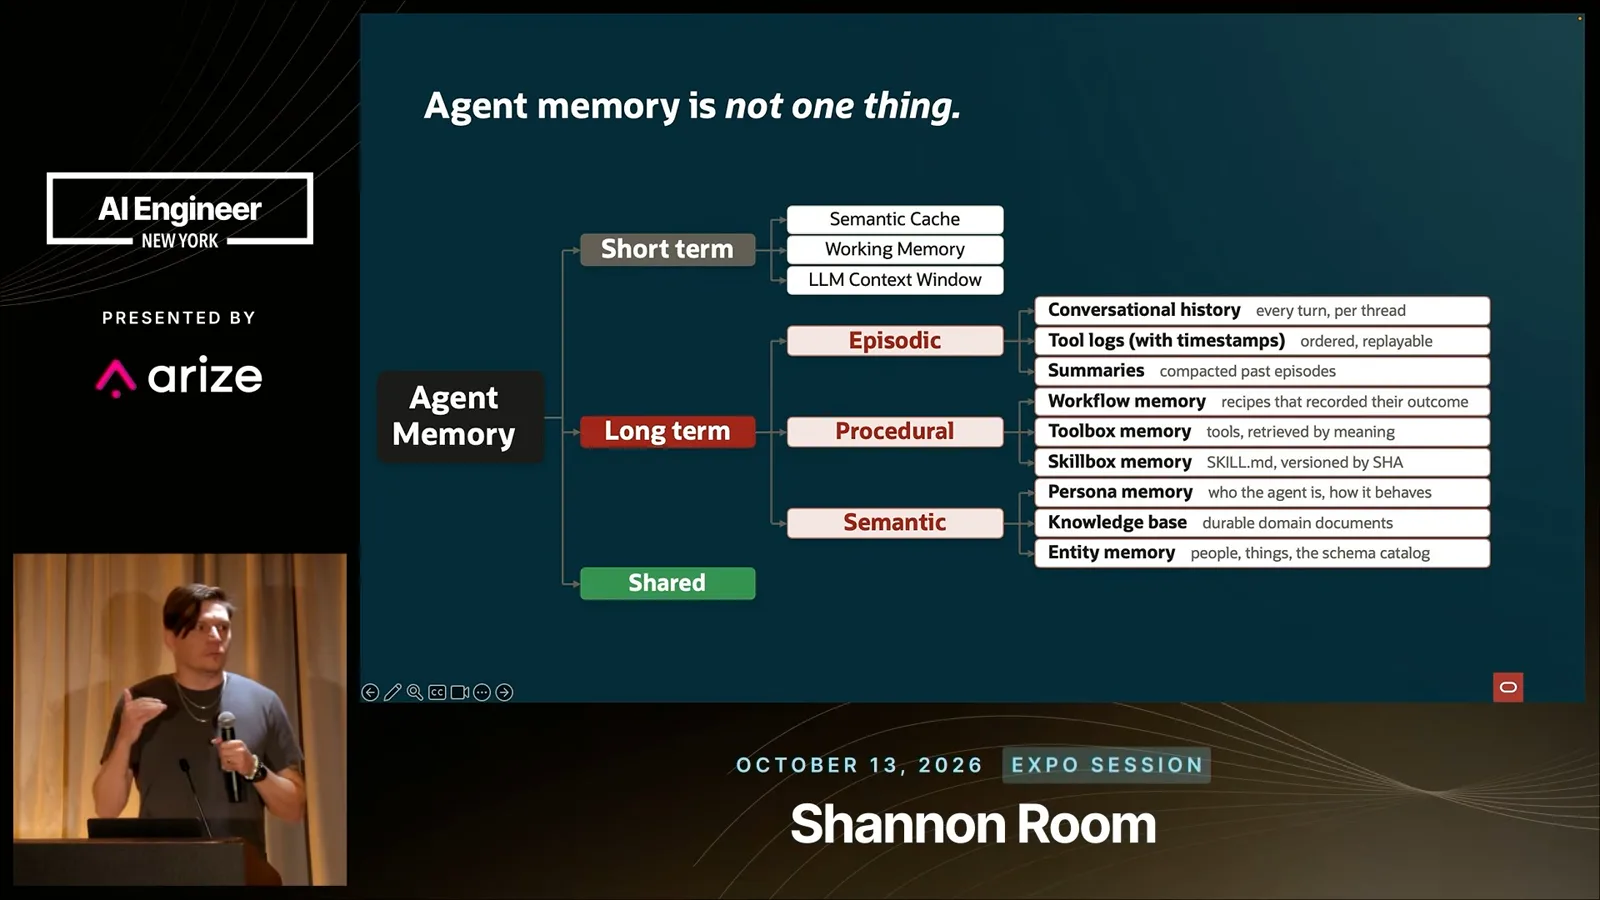
短期记忆涵盖会话中发生的事。长期存储可以包含情景、程序和语义记忆,例如摘要、工具相关信息、知识,以及演示中的偏好。共享记忆则让信息在适当控制下得到更广泛的使用。
我们还必须决定把记忆存在哪里。作为 Oracle 的员工,我倾向于使用数据库:我认为 ACID 保证、多写入方支持、可扩展性和多种搜索方式让它成为稳健的选择。
构建和选择上下文
Schema、索引、生命周期和授权都是记忆工程的一部分。Pluta 介绍 Oracle 的 context card 和终端用户隔离。
构建记忆系统是一项系统性的工程工作。我们需要区分记录类型的 schema、适合检索任务的索引,以及生命周期和授权边界。没有这些抽象,开发者就得自己构建摘要、检索、持久信息提取和 token 预算管理。
Oracle 推出了 agent memory 软件包,为这些工作提供操作和抽象。其中一个功能是 context card:为智能体组装的精简文本块,可以直接用于提示词。目标是减少开发者管理记忆的负担,让智能体专注于任务。
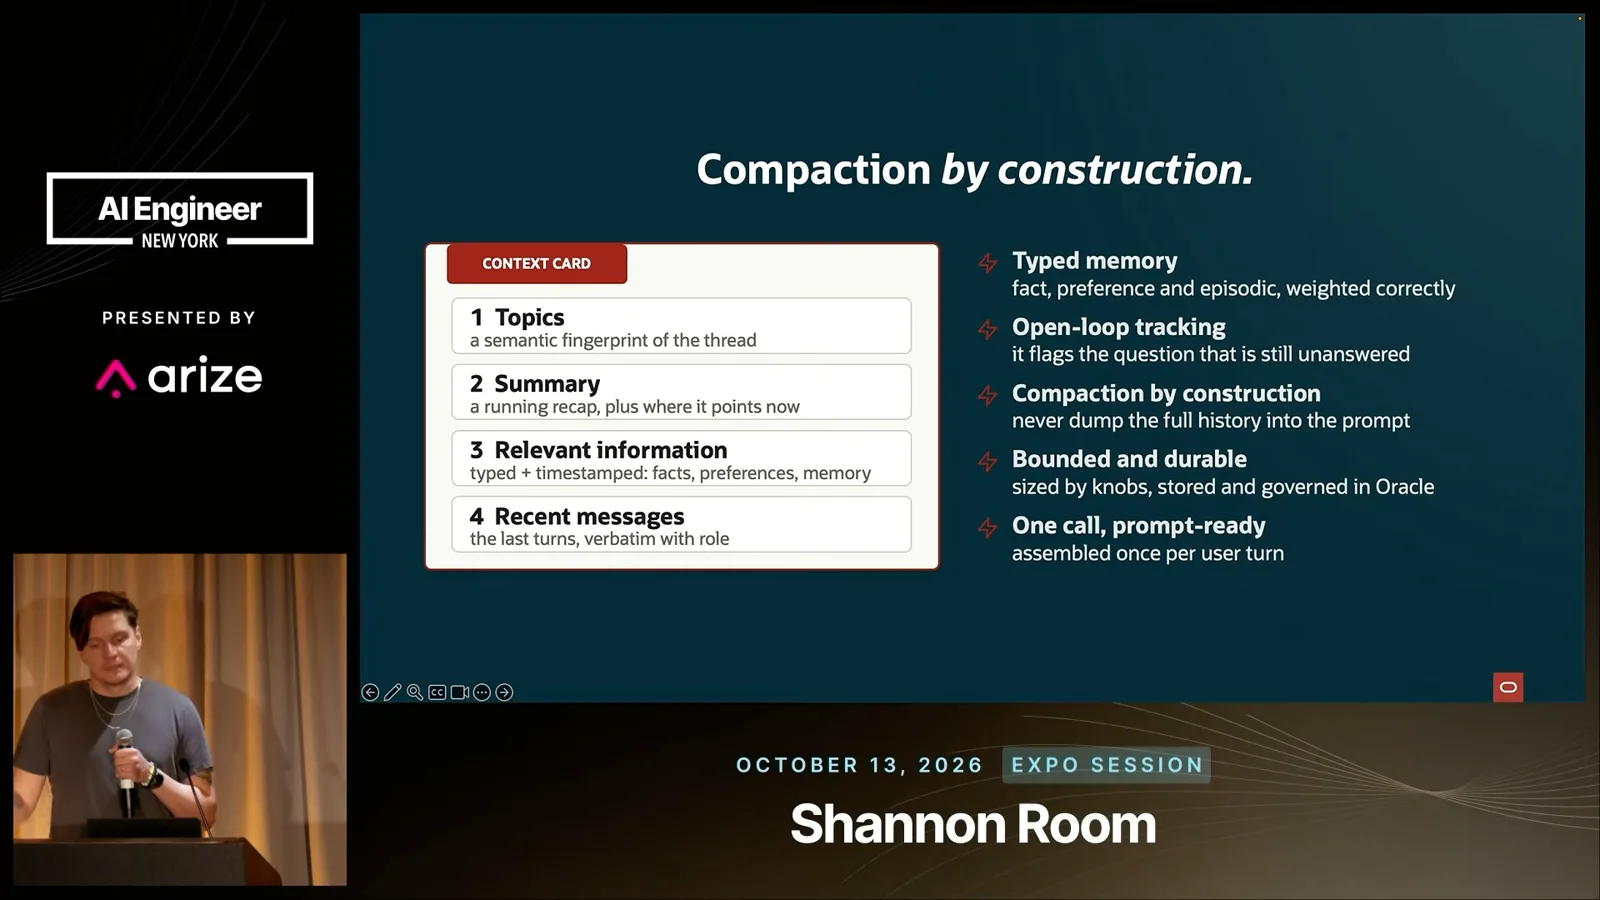
Context card 可以组织主题、摘要、相关信息和最近消息。Harness 为当前这一轮创建或选择重要内容:主题帮助理解讨论方向,摘要概括对话进展和用户目标,选出的记录提供相关信息,最近消息保留眼前的交流。
两者的区别是:记忆负责持久保存,上下文负责选择。Context card 只返回当前一轮需要的内容,帮助控制上下文规模,避免把所有保存的记录都塞进提示词。
在最新的 agent memory 版本中,我们花了不少精力处理终端用户隔离,由数据库负责访问限制。我还提到了图像支持、后处理和事件列表;Oracle AI Database 的多数据类型引擎旨在用一个引擎处理多种数据。
最后,我想强调:模型是共享的,而你的记忆与自己的业务息息相关。把有用信息和与模型交互的数据一起保存,可能形成竞争优势。我们的 GitHub 仓库提供了入门 notebook,涵盖 agent memory 和混合检索等主题。
同频道的其他文章
 17:02EN → 简体中文
 AI Engineer· 2026年10月31日如何评估受监管贷款电话中的语音智能体Brooke Hopkins, Shiv Indap · CovalShiv Indap 与 Brooke Hopkins 介绍持续评估中的人工审核、LLM 评判器和模拟。
 18:45EN → 简体中文AI Engineer· 2026年10月30日Jack Woodruff:AI 时代,选股仍需要人的研究Vinoo Ganesh, Jack Woodruff · KeplerCandlestick Capital 前首席投资官与 Kepler 首席执行官 Vinoo Ganesh 讨论研究、可审计数据,以及 AI 如何重塑投资团队。
 15:27EN → 简体中文AI Engineer· 2026年10月30日Rayan Krishnan:走出模型卡,评估真实任务表现Rayan Krishnan · Vals AIVals AI 联合创始人解释,任务准确率、总成本和企业专属评估为何会改变最合适的模型选择。
 16:43EN → 简体中文AI Engineer· 2026年10月30日Ishween Kaur:如何保护智能体的 x402 支付Ishween Kaur · SoFi通过测试网案例,了解智能体支付流程中的价格变化、重放、提前交付、冒充卖家和提示注入。
 17:45EN → 简体中文AI Engineer· 2026年10月30日Killian Carlsen-Phelan:引导与验证编程智能体Killian Carlsen-Phelan · SonarSonar 演示如何将项目上下文和确定性检查纳入编程智能体的工作流程。
 38:07EN → 简体中文AI Engineer· 2026年10月29日使用 Gitar 验证拉取请求:超越代码差异Taylor Luttrell-Williams, Killian Carlsen-Phelan · SonarSonar 的 Killian Carlsen-Phelan 和 Taylor Luttrell-Williams 在一个示例应用中演示门票转让、定价规则和 CI 失败三个场景。