30 秒看懂
在这期 2024 年 2 月的教程中,Matthew Berman 使用 CrewAI 为简报链接制作抓取与写作原型。在 CrewAI 创始人和一位协作者的帮助下,他修正 URL 插值并构建自定义抓取工具,但遇到了页面拦截、上下文限制和最终结果为空等问题。视频由 Lightning AI 赞助;Berman 披露自己是 CrewAI 的投资人。
- 1简报应用场景设想中的智能体团队获取 AI 新闻链接,并为编辑撰写简短摘要。
- 2将 URL 传入任务CrewAI 创始人指出需要使用 `self.urls` 和 f-string 插值,并解释网站搜索工具的作用。
- 3构建自定义抓取工具Berman 将使用 requests 和 Beautiful Soup 的函数改造成智能体工具。
- 4上下文限制暴露提取噪声宽泛抓取获取了过多文本,因此 Berman 尝试使用网站专用的 HTML 选择器。
- 5部分成功的结果日志中出现了摘要,但获取错误和打印结果为空的问题依然存在。
要点建议
- 将获取文章内容与撰写摘要分开,并明确向任务提供输入。
- 网站检索工具和整页抓取工具有不同用途。
- 逐阶段检查错误:导入、智能体工具、URL 插值和团队执行都可能分别出错。
- 宽泛的 HTML 提取可能包含大量无关文本,超出模型上下文限制。
- 网站专用选择器可以让一次测试成功,但不能因此成为通用抓取工具。
- 原型在日志中生成了摘要,但最终返回结果仍为空,需要进一步改进。
按章节阅读整理后的全文
设置与预期用途
Berman 在 Lightning AI 中安装早期 CrewAI 版本,并介绍简报工作流程。视频由 Lightning AI 赞助。
我想用 CrewAI 构建一个 AI 智能体团队,边演示边处理配置和错误。这次尤其关注工具:早期版本提供的内置工具、LangChain 工具,以及我们自己编写的自定义工具。这场 2024 年 2 月的演示使用 Lightning AI 的云端 IDE;Lightning 是视频赞助商,我也在简介中披露自己是 CrewAI 的投资人。
我从浏览器中的开发环境开始,这里有终端和 Python 3.10.1。安装 CrewAI 后,我从文档复制一个入门示例,边做边修改。视频简介中有代码链接。
我先使用 OpenAI 模型,为演示创建一个 API 密钥,并表示会在视频发布前撤销画面中显示的密钥。Lightning 也能提供 GPU 来运行开放模型,不过这不是第一个例子要做的事。
我第一次安装的是稳定版,但我想用当时的 0.14.0 候选发布版,因为它包含更多工具。我卸载后重新安装目标版本,然后查看工具列表,其中有搜索文档、CSV 文件、网站和 YouTube 视频的工具。这是当时的配置,软件包名称和 API 可能已经发生变化。
实际用途是我的简报:我在一周内收集 AI 新闻链接,希望一个智能体团队抓取每篇文章并写出简短摘要。这不是泛泛的搜索演示,而是希望为一项具体的编辑工作节省时间。
定义智能体和任务
他尝试设置抓取与写作角色、任务描述及工具分配。
我开始把示例中的研究员改成网站摘要员,为它设定角色、抓取并总结网页的目标,以及清晰简洁地解释 AI 话题的背景。我保留详细输出以观察运行情况,并暂时关闭这个智能体的委派功能。
我尝试分配 WebsiteSearchTool,以为它能抓取网站;接着设置一个写作智能体,让它撰写简短的 AI 内容。我为写作者保留委派功能,因为我认为它可能会把抓取任务委派给另一个智能体。此时我仍在试验这些组件如何配合。
编写任务时,我调整了分工:第一个智能体应抓取全文并传递给写作者,后者再将文本整理成简短有趣的摘要。我给两个智能体分别分配任务,创建包含两者的团队,并开启详细日志。
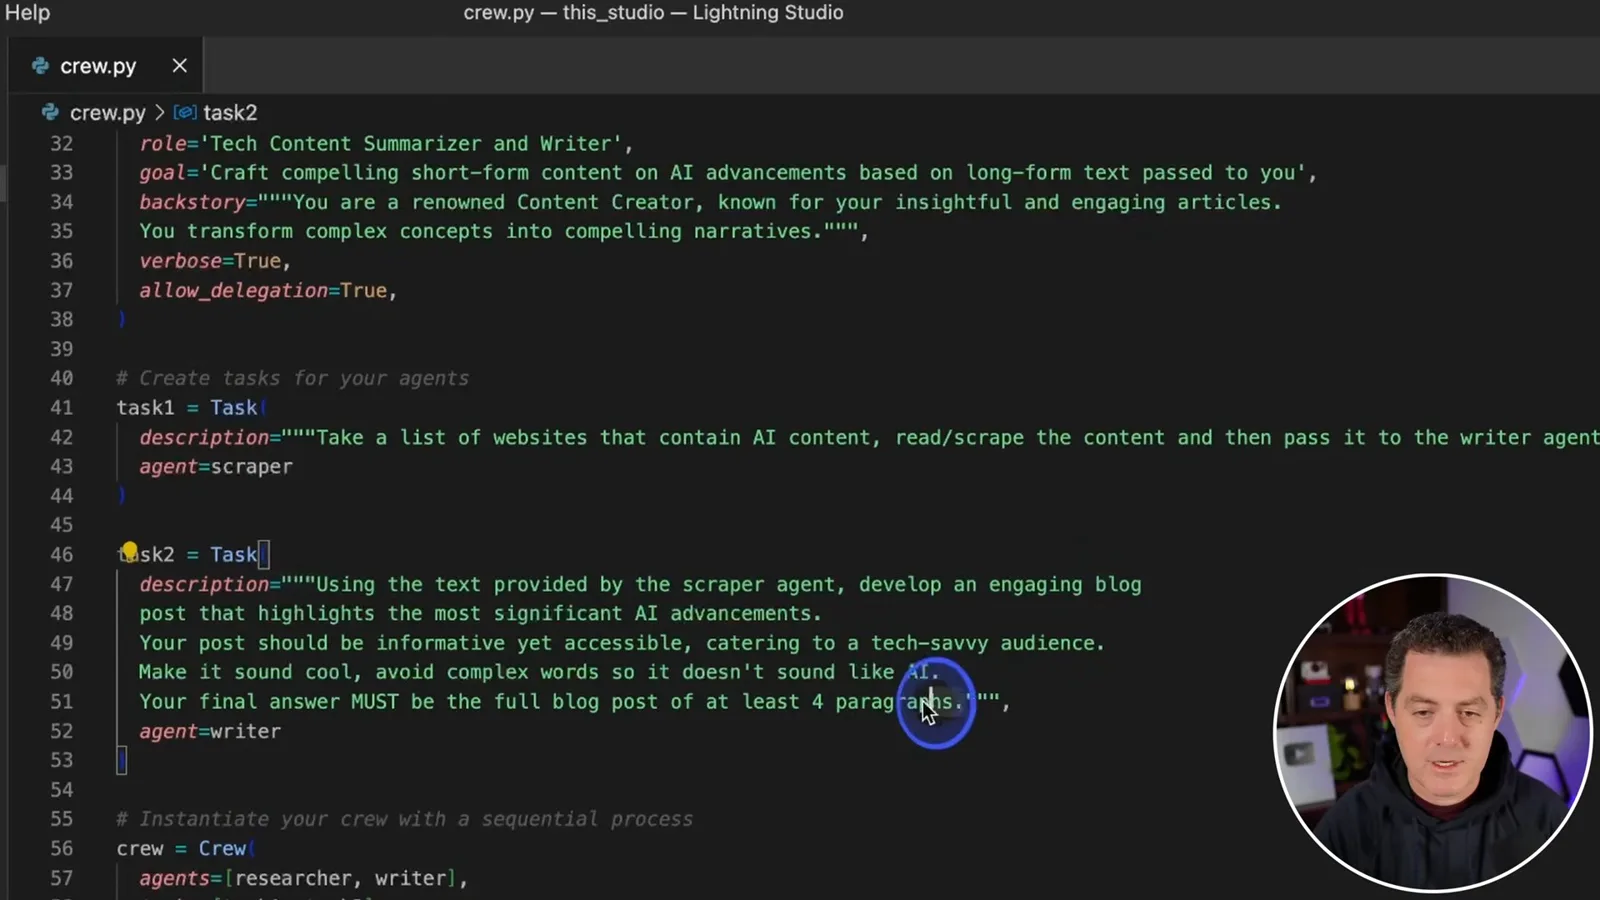
团队需要一份 URL 列表。第一次尝试时,我让智能体自己请求列表,但不确定应用是否必须明确传入 URL。我运行程序看看哪里会出错,而不假定任务描述已经足够。
调试导入和 URL 输入
错误促使他研究示例,创建团队类,并向其传入用户输入。
第一个错误提示网站工具尚未定义。我尝试导入并实例化它;从 CrewAI 导入的尝试失败后,我改为从工具包导入。随后智能体请求提供 URL,但反复生成不符合预期工具调用或最终答案格式的输出。
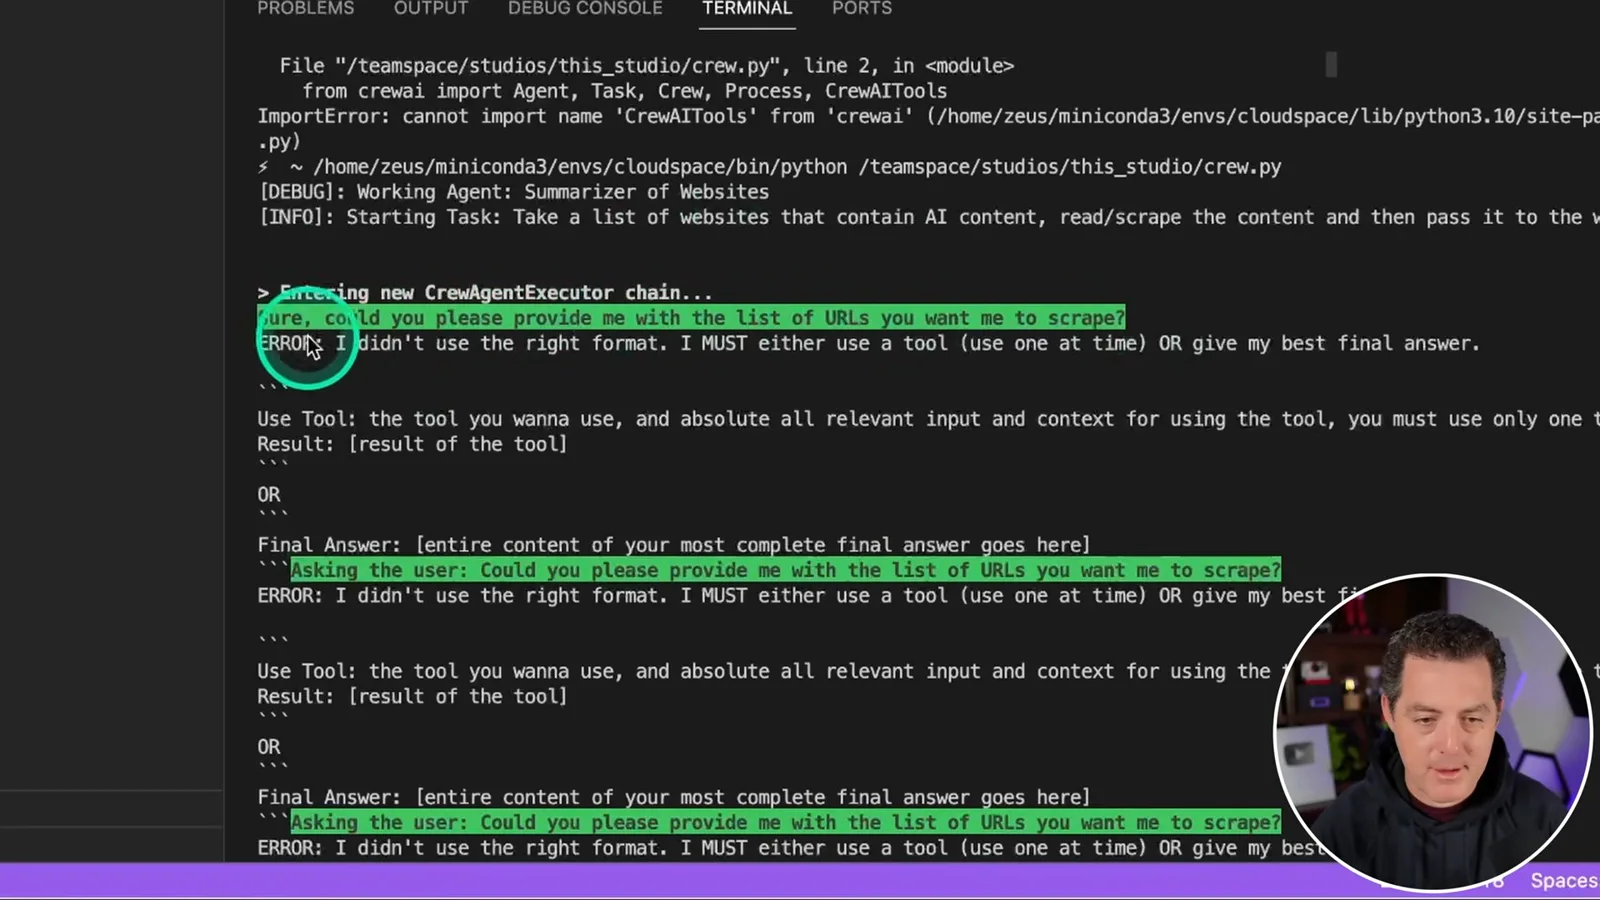
我查看一个股票分析示例,弄清输入如何传给团队。它的 Python 入口先向用户询问公司名称,保存答案,再传给一个类。我决定将这种模式改用于网站 URL,同时让最初的实验仍放在一个文件中。
我创建简报团队,将提示改为询问要总结哪个 URL,并把智能体和任务放进一个带有 run 方法的类。我按照示例调整缩进,把 URL 传进类,再寻找将其插入任务描述的合适位置。
我把 URL 加入任务文本并再次运行程序。缺少 `dedent` 导入导致了一个错误;修复后,我先用一篇关于 Runway 的文章测试,而不是直接测试最终希望支持的多个 URL。
接下来的尝试暴露了名称不一致和重复调用 `kickoff` 的问题。删除重复代码后,程序返回 `None`:团队虽然定义好了,却没有真正启动。我在 run 方法内加入 `kickoff` 调用,再次测试。
创始人解释插值与工具
创始人帮助找出缺失的 f-string,并解释网站搜索与抓取的区别。
智能体现在启动了,却说自己无法浏览或抓取网页。我明确要求它使用网站工具;它却再次请求 URL,说明我的输入可能仍未进入任务。我联系 CrewAI 的创始人寻求帮助,向他展示代码和遇到的错误。
创始人解释说,任务需要在 Python f-string 中引用实例变量 `self.urls`。这样才能插入传入团队的实际值,而不是在任务中留下字面占位符。他还澄清,WebsiteSearchTool 会检索网站内容来回答搜索问题,并不是我原以为的整页抓取工具。
因为我需要的是文章文本,而不是相关搜索片段,所以决定自建抓取工具。创始人提到他以前使用过 HTML 清理库,我则决定请 ChatGPT 帮忙编写初始 Python 代码。
构建并集成抓取工具
Berman 使用 requests 和 Beautiful Soup 创建自定义工具,并在协作者帮助下修正集成。
我查看股票示例的工具文件夹,新建一个独立的抓取工具文件。我定义了一个接收 URL、应该返回文本的抓取函数。ChatGPT 建议使用 `requests` 和 Beautiful Soup;我安装或确认这些依赖,并修改生成的代码。
我最初要求抓取标题,但实际需要网页文本,于是要求修改代码。新代码获取并解析 HTML,收集文本元素。我将它改为返回合并后的文本,而不只是打印出来,同时注意到它可能也会收集无关内容。
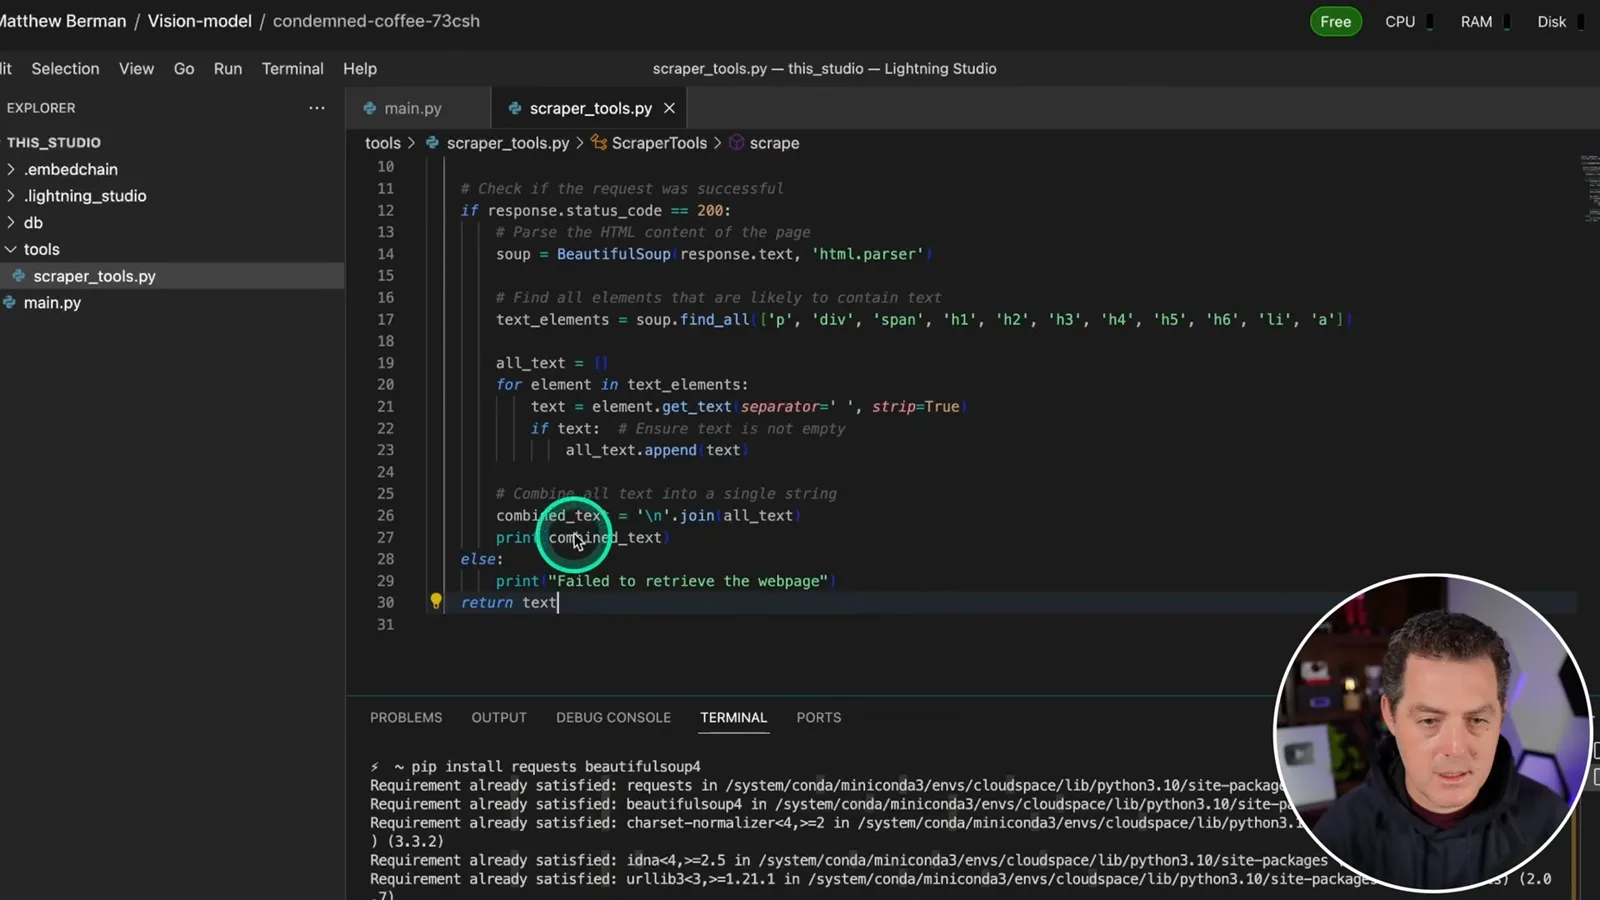
我把抓取工具导入主程序,尝试将它分配给智能体。缺少工具装饰器以及随后的 `tools` 错误表明,第一次集成并不正确。我邀请一位协作者进入共享云端会话,实时帮助检查和修改代码。
请求拦截与上下文限制
测试发现网站拦截和提取文本过多的问题。他将抓取范围缩小到某个网站特定的元素。
在协助下,我导入 LangChain 的工具装饰器,用它定义抓取工具。下一个障碍是目标网站:请求失败。ChatGPT 建议添加类似浏览器的请求头,但在这次测试中,同一个页面仍无法获取。
我改试 CrewAI 网站。只输入域名时出现无效 URL 错误,于是我输入完整 URL;抓取工具随后在该网站上运行成功。这将观察到的问题缩小到原来的请求,但不能证明抓取工具适用于任意网站。
ChatGPT 提出了其他可能的方法,包括不同的 user-agent 字符串和第三方服务,但为了继续推进,我选择另一篇文章。抓取工具获取了该网站的内容,模型却拒绝请求,因为累积的文本超过了约 8000 个 token 的上下文限制。
宽泛的抓取方式收集了太多材料,包括目标文章之外的内容。我询问 ChatGPT 如何提取正文,检查网页的 HTML,并找到一个该网站特有的元素。我修改 Beautiful Soup 的选择逻辑,只抓取这个元素,而不是收集所有文本元素。
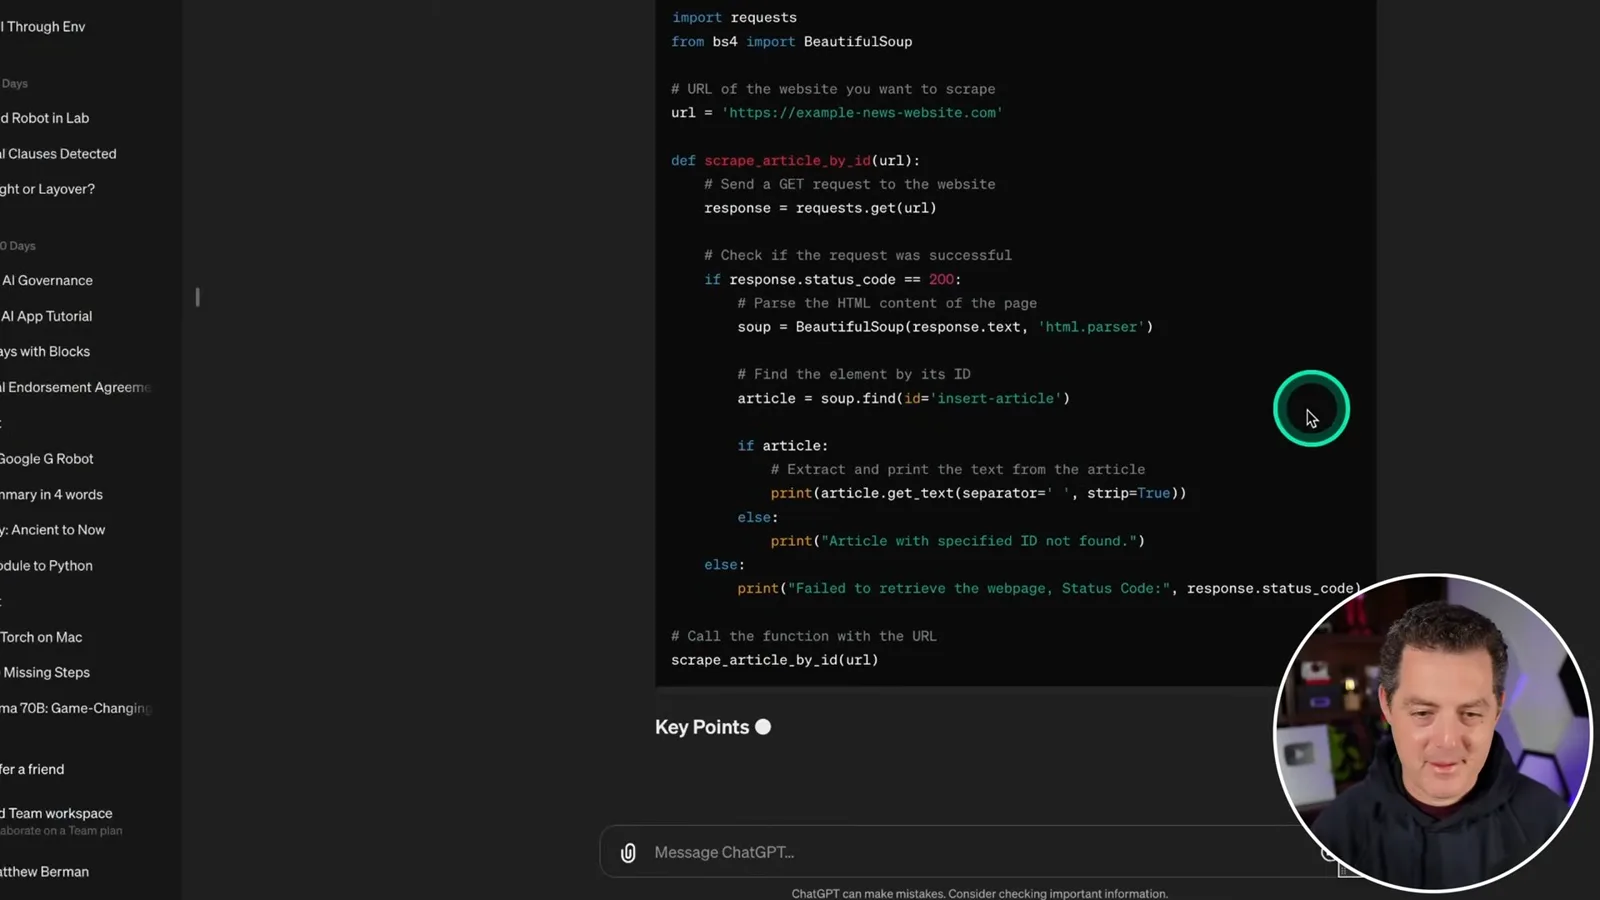
这个选择器针对的是正在测试的网站,因此并不是通用方案。我知道抓取其他网站还需要进一步开发,但先尝试缩小提取范围,看看智能体能否完成这一个例子。
测试结果与剩余工作
日志中出现摘要,但最终结果为空。Berman 计划在后续视频中增强可靠性。
下一次运行提取了文本,并在智能体日志中生成了简短摘要。写作者委派了工作,之后一次获取尝试失败,最终答案也出现了,但打印出的结果为空。我认为这个实验是一个有希望的开端,还不是可靠的端到端工作流程。
我先在这里结束,计划在后续视频中增强工作流程的可靠性。演示还留下多个问题:多个 URL、跨网站的可靠提取、被拦截的请求、上下文限制,以及正确返回最终结果。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。