30 秒看懂
Theo Browne 介绍他如何用 Fable 5 协调其他模型、配置技能并分类积压的拉取请求。他说明了个人推理强度与成本选择、对合并至预发布环境的明确授权,以及之后由人和智能体进行的验证。
- 1成本取决于具体条件Theo 估算了一次长期运行及委派工作的价值,但他使用的是当时特定限额和条款的订阅。
- 2子智能体与工作流他区分边界清楚的委派任务和协调多个阶段的脚本。
- 3PR 分类他要求对 16 条拉取请求分类审查,再决定保留或重写哪些内容。
- 4明确边界他在自己的项目中授权合并,并保留人对生产部署的控制。
- 5验证工作进入预发布环境后,他报告自己亲自测试,并让其他智能体进行额外检查。
要点建议
- 推理强度和模型路由应根据任务选择,并结合实际用量衡量。
- 指令文件与技能可以根据实际失败和项目偏好持续改进。
- 独立审查结果仍需对照实际工作验证。
- 大型 PR 积压可以通过明确检查点分类并拆成边界清楚的工作。
- Theo 在自己的项目中授权合并,同时保留人对生产部署的控制。
- 智能体工作快慢是了解复杂性的线索,而不是正确性的证明。
按章节阅读整理后的全文
不同的模型使用方式
Theo 介绍自己的热情,以及推进的一批积压工作。他把视频定位为个人工作流的讲解。
使用几天后,Fable 5 给我的印象比第一天更深。恢复访问后,我用它推进了积压的未完成工作。这是个人体验,而不是受控生产力测量,但它改变了我对应该让智能体做什么的想法。
我不只是把它看作更聪明的 Opus。对我而言,区别在于它能把实现、测试和验证推进多远,尤其是在把工作分给子智能体时。完全沿用过去的提示可能无法体现这种优势。
我想展示自己使用的提示、指令文件和技能,以及工作方法如何改变。这是对一个不断演进的工作流的介绍,不是让所有人照搬的配置,也不是对自主工作正确性的保证。
Lakebed 积累了许多部分完成的拉取请求。我不信任其中一些实现,也不喜欢部分 SDK 改动;清理所需的工作让项目停滞。借助 Fable,我在几天内处理了大量请求,包括在一个线程中完成的一系列合并。
推理强度和模型路由
他讨论估算成本、推理设置及向其他模型委派工作。价格和限额取决于他的配置和当时的条件。
在展示大型工作流之前,我想先谈成本。我估计一次五个半小时的运行及其委派模型的用量约值 150 美元,而我原本预计会是数千美元。我使用的是订阅,并没有收到 150 美元的 API 账单;经济性取决于当时的方案和条件。
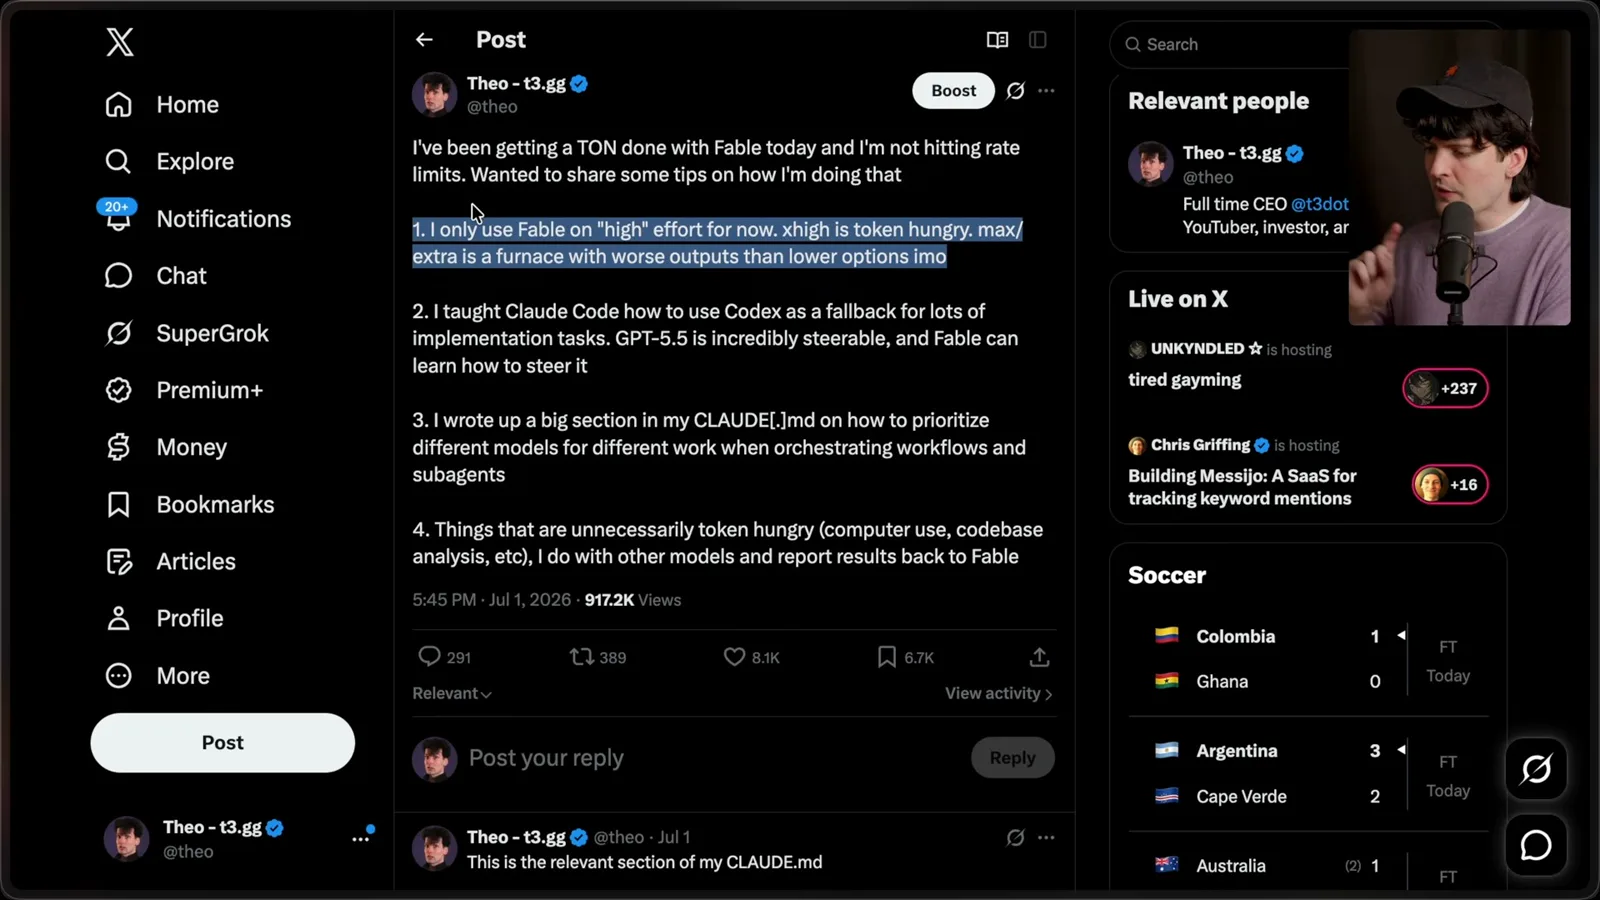
我的第一条建议是先试 high 推理强度,而不是自动选择 xhigh、max 或 Ultra Code。根据我的体验,更高设置消耗大得多,有时还会产生过度复杂的改动。这是我针对该模型和工作负载的个人默认值,不适用于所有任务。
我区分每一步的推理强度和智能体任务的总时长:较低设置仍然可以参与一长串工具调用。每一步都想得更多,不一定意味着完成更多有用工作;我发现这还可能导致过度推理。
我还教 Claude Code 在合适的工作中调用 Codex,包括计算机操作和消耗大量 token 的调查。例如读取大型日志或文档、检查大量截图。目标是让负责协调的模型在有用时调用另一个工具,再把结果带回来。
对我当时的订阅来说,这种路由减轻了使用成本压力。我的限额和优惠不代表其他人也有相同额度,订阅政策也可能变化。应衡量自己的用量,而不是假定委派工作免费。
指令与技能
Theo 介绍模型选择术语表,以及用于审查、实现和计算机操作的独立技能。他强调根据实际失败调整指令。
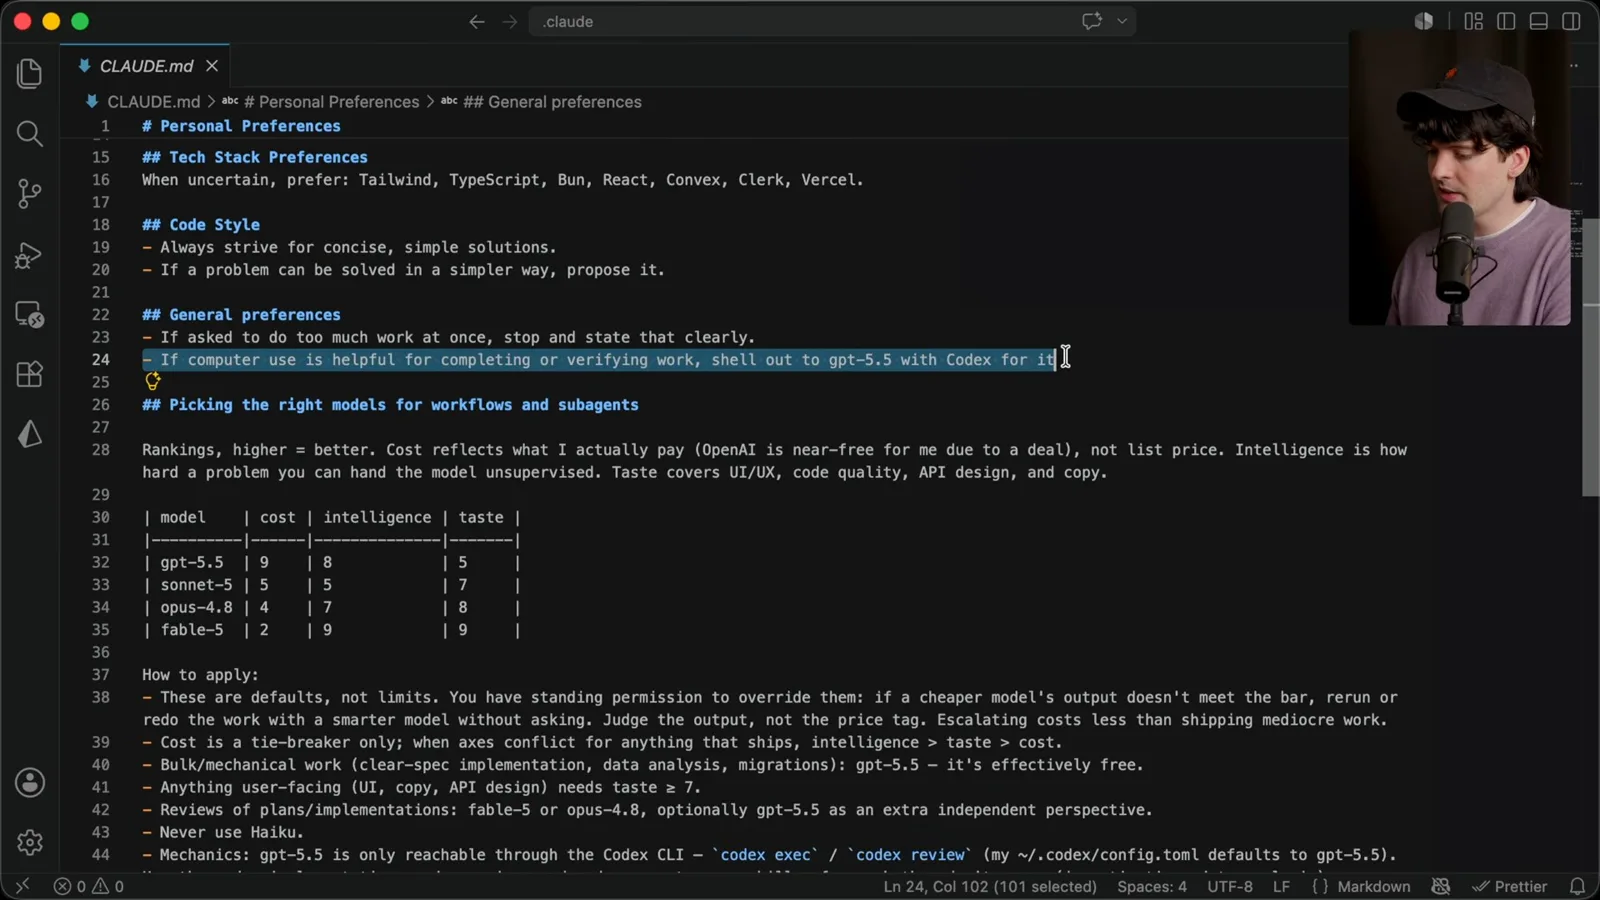
我把路由指导写进全局 CLAUDE.md,同时保留技术选型和代码风格等常规偏好。其中一条指示让智能体在计算机操作有助于完成或验证工作时使用 Codex。它可以通过 shell 调用另一个工具,再把发现带回主会话。
我区分子智能体和工作流:子智能体可以调查一个边界清楚的任务;工作流则通过程序协调多个阶段及其结果。例如,第一阶段检查多个文件或 PR,再将选定发现交给下一阶段的审查者。
这对 Lakebed 积压的 PR 很有用。智能体可以先分类改动,再把它们送到不同的审查阶段。我喜欢让模型根据任务调整审查角色,但这并不免除检查结果或设定合适边界的责任。
模型不会自动了解我当前的订阅,也不知道我观察到的其他工具的优势。屏幕上一行写着 OpenAI 对我“因为优惠几乎免费”;我澄清自己没有特殊个人协议。这是智能体对当时优惠的理解,而不是价格承诺。
我做了一张关于成本、智能和品味的主观评分表。品味指界面、代码质量、API 设计和文案等;智能指我认为模型能处理多难的问题。这些分数表达的是我的偏好,并非客观基准。
在指令文件中写术语表有助于智能体理解你使用的词。说明“品味”“智能”或项目专用术语对你意味着什么,再解释这些概念应如何影响任务。这样比单独给出模糊排名更容易执行。
我告诉智能体,模型选择是默认值而非硬限制,应根据输出判断。读文件时我发现模型写的成本规则不符合我的偏好,于是现场修改:利用较便宜的选项收集信息或尝试,但需要时仍使用合适的模型。
我的路由把规格清楚的机械性工作交给 GPT-5.5,把面向用户的设计或计划审查交给我更偏好的模型。这些选择取决于我的体验和成本。其他团队应按照自己的质量标准、预算和可用模型调整。
在我展示的配置中,智能体通过 CLI 访问 Codex,并使用针对实现、审查和计算机操作的技能。我还介绍了一个适配方式,让 Claude 工作流启动 Codex 任务并带回结果。看清哪个智能体在做什么,以及处理超时,都成为实际问题。
我不是一次就设计出了完整配置。我先让第一版运行起来,遇到失败后回到线程,询问如何防止再次发生,然后把有用指导精简后补进去。应把这些指令看作需要根据经验持续修改的东西。
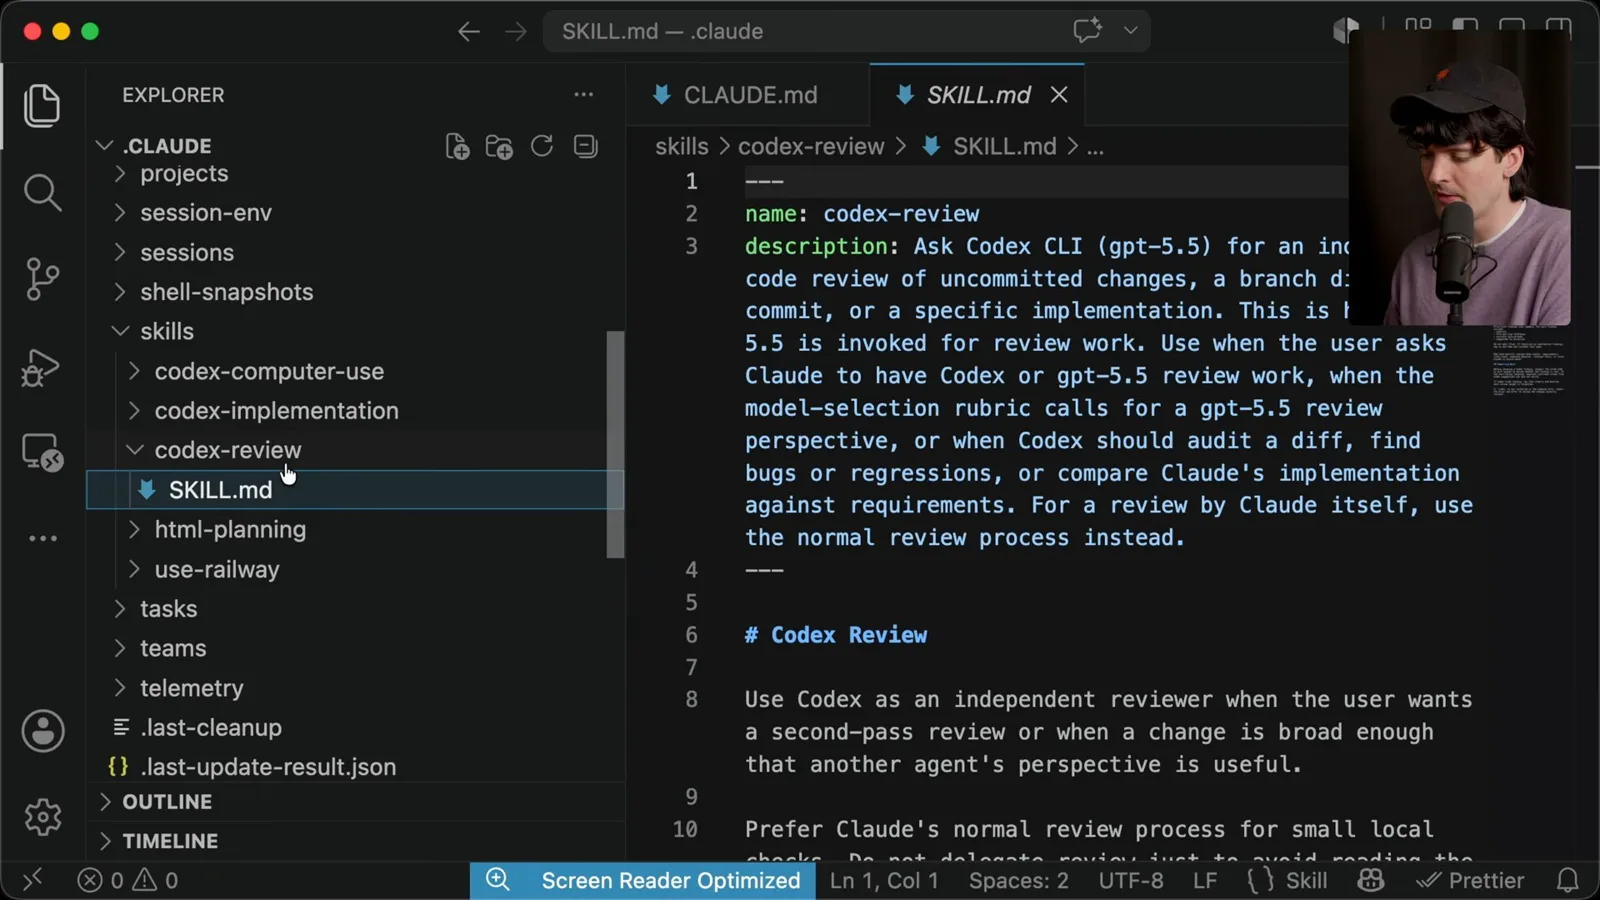
我的审查技能让 Codex 检查明确的目标、生成报告,再由主智能体对照代码验证重要结论。独立审查对范围较大的改动有帮助,但第二个智能体的说法仍是需要核实的证据,不是自动批准。
我把命令细节记录在技能中,因为即使偶尔调用出错也很烦人。我还补充了对无发现审查的处理:明确说明没有发现问题,并指出检查了什么,避免主智能体困惑地重复同一任务。
不要盲目复制我的文件。为自己的工具建立合适的版本,发现问题时再修改。理解并调整配置,比害怕碰别人粘贴过来的一大段指令更有价值。
我还有单独的实现技能,用于边界清楚的改动,通常在 worktree 中进行;另一个技能负责计算机操作验证。技能描述很重要,因为模型最初看到的是描述,选择技能后才加载更完整的指令。
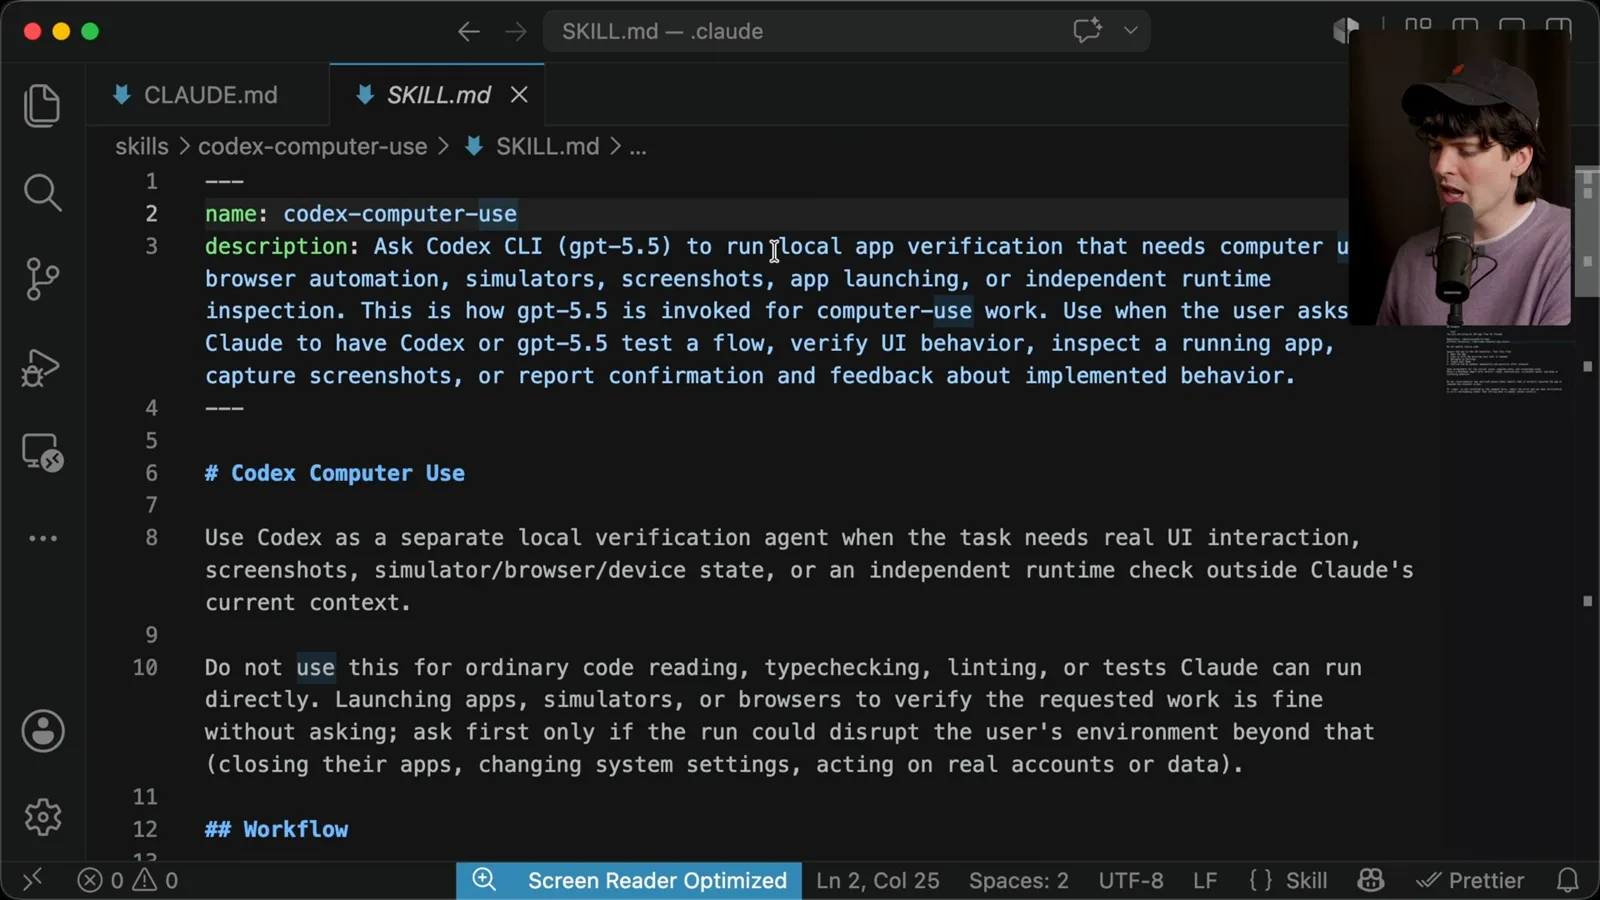
计算机操作技能涵盖检查运行中的应用、验证界面行为、使用浏览器或模拟器以及截图等任务。我在视频中修改了触发描述,让智能体根据所需验证选择它,而不是只有在我点名某个模型时才调用。
整理积压 PR
他展示对 16 条 PR 的多智能体审查,并阅读生成的计划。工作被拆成有检查点、边界清楚的改动。
在 Lakebed 例子中,我让智能体调查 16 个未关闭的 PR,并分类为可以合并、需要小修、已被取代,或想法有价值但更适合重写。我还要求多个审查者帮助稳固判断。
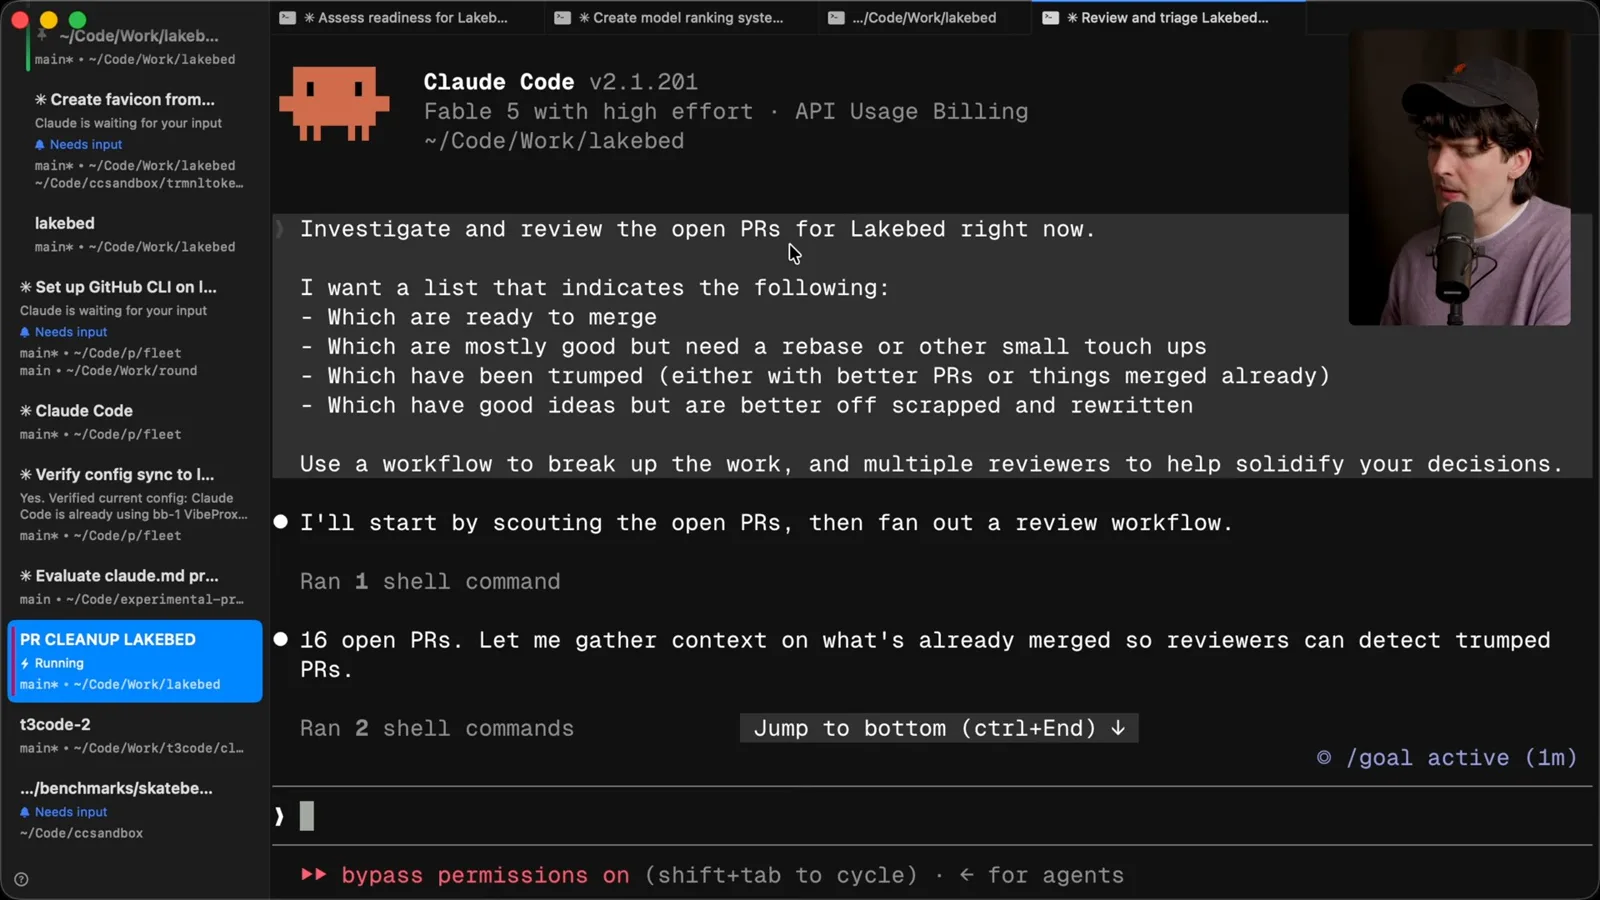
据会话报告,该工作流使用了 48 个智能体,包括每个 PR 一名调查者和一个审查小组。它返回分类清单和建议顺序。我阅读了建议并自己做决定;智能体数量来自会话报告,并不能独立证明每个结论都正确。
接下来我明确要求它关闭已被取代的工作,并为值得保留的想法准备新计划。我要求计划链接原始 PR,并解释现有实现。进入下一阶段前,计划先返回给我审阅。
我阅读计划、查看启发这些计划的 PR,并询问剩余工作。提问帮助我和智能体对计划达成一致。最终方案把准备好的 PR 与新实现分开,也把较大的改动拆成边界清楚的部分。
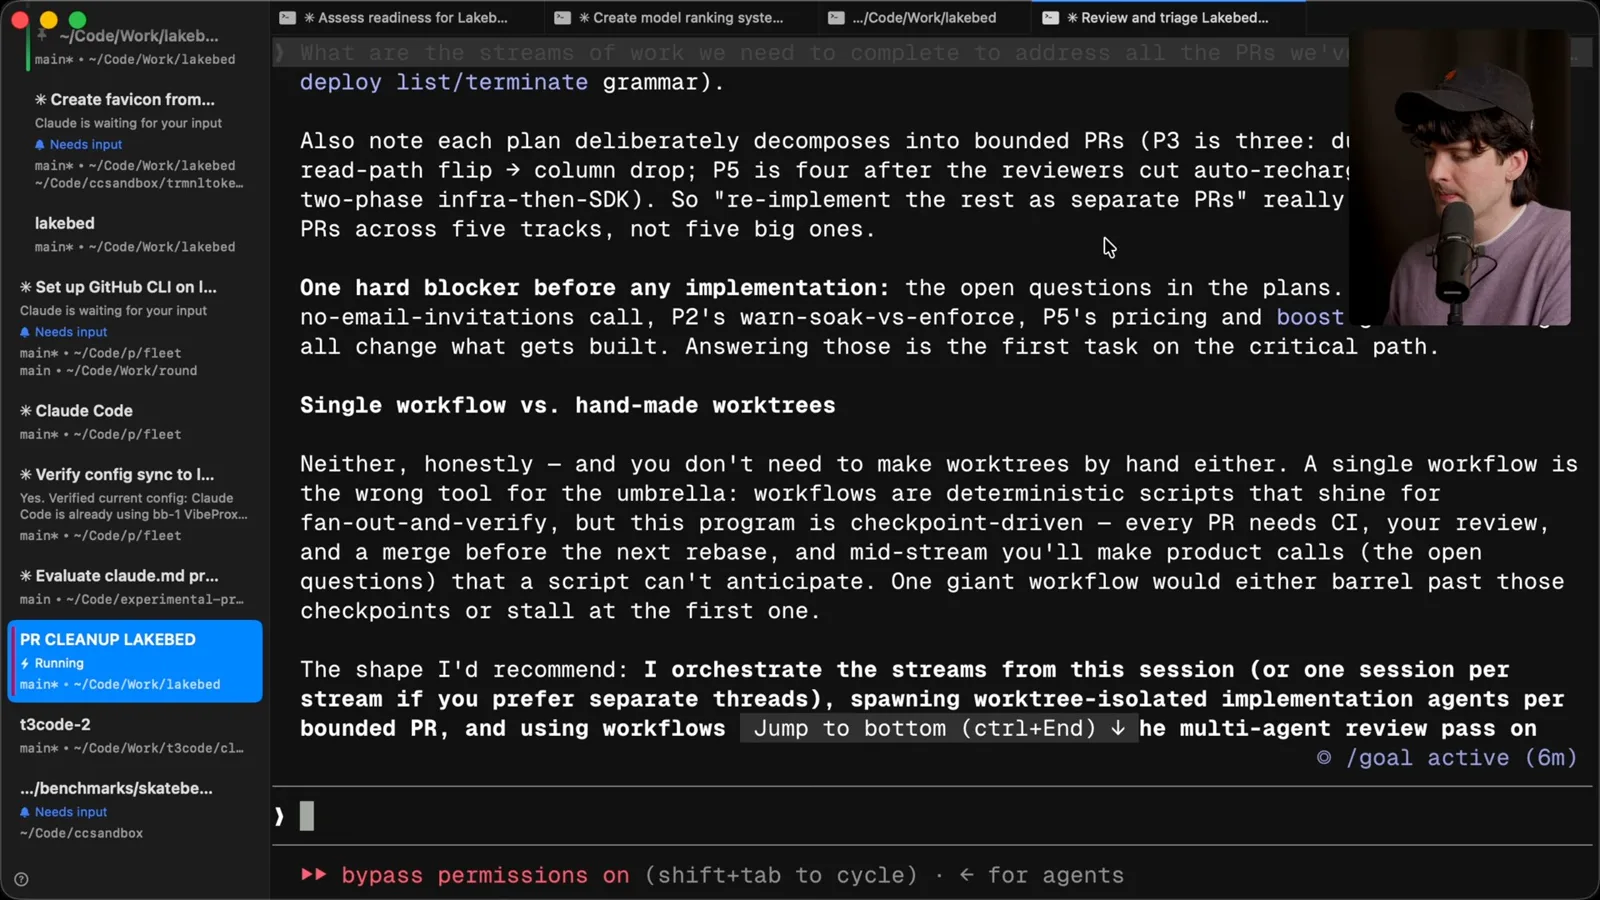
智能体建议不要用一个巨大的确定性工作流处理整个项目。每条 PR 都需要 CI、审查和合并等检查点,后续 rebase 依赖这些步骤,而一些产品决策需要我参与。它建议在会话层编排,用隔离的 worktree 实现,并在适合时用工作流并行审查。
授权、预发布与验证
他明确授权合并、要求自动审查,并保留人对生产部署的控制。随后他介绍预发布环境中的测试。
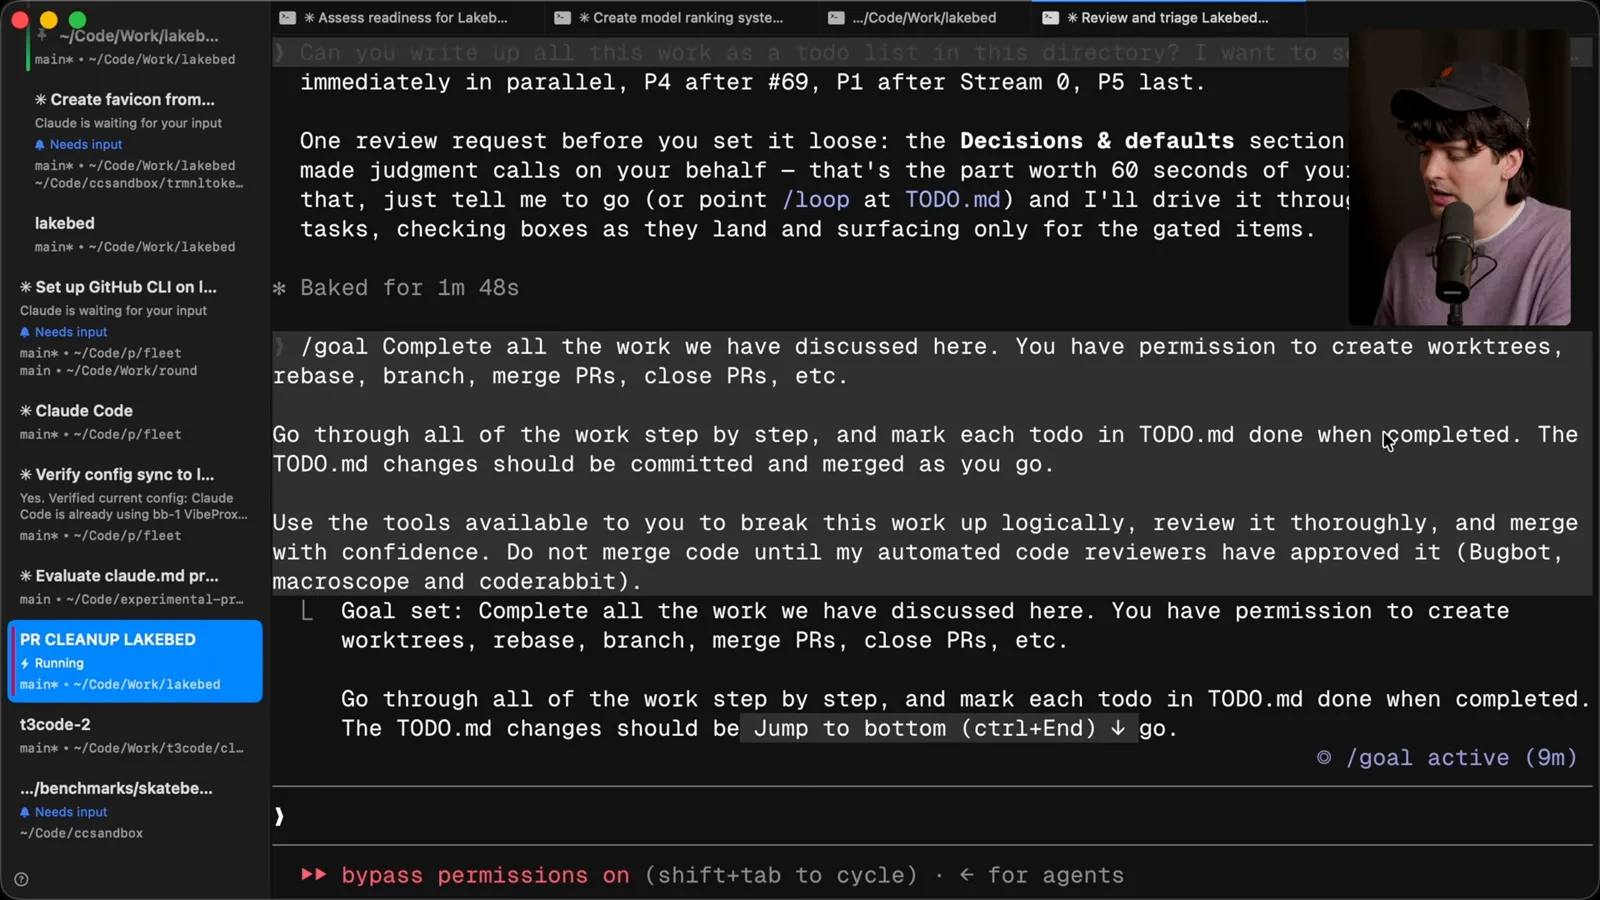
讨论计划后,我设置目标完成约定的工作,并明确授权创建分支、worktree 和合并 PR 等操作。这项授权适用于我的项目和这次运行,不是说智能体无需相关项目负责人的授权就可以合并改动。
我要求它在 TODO.md 中跟踪已完成事项,并在合并前取得我设置的自动审查工具的批准。它运行了大约五小时。自动审查只是流程的一部分,其批准不能代替理解风险和独立检查重要结果。
重要边界在于部署:合并到 main 会部署至预发布环境,而生产部署仍由人控制。我也先修复了预发布环境。正因为有这个区别,我才更愿意让智能体处理合并顺序。
之后我亲自对预发布环境做压力测试,让其他智能体尝试新旧功能,并检查与生产环境的差异。我报告说这轮检查几乎没有需要修复的内容。这是我对该项目的叙述,不证明自动审查能发现所有缺陷。
跨机器工作
Theo 展示远程智能体工作、调查偶发测试失败和合并 worktree。最后他提醒不要盲目合并实验性输出。
为了继续其他工作,我连接了更多机器。普通 SSH 难以满足我想要的交互功能,于是我用 T3 Code 管理远程智能体。桌面、网页和移动界面让我可以从不同设备查看工作。
我用私有网络连接这些机器,并尝试移动应用。这让我遇到想法或小问题时,可以方便地启动独立 worktree。T3 Code 是我自己的项目,因此我对它的热情有这层明显的关联。
当一个 PR 的测试偶发失败时,我截图、选择机器和仓库,并让 worktree 中的智能体结合失败运行的链接进行调查。单独启动调查后,我可以继续其他工作。
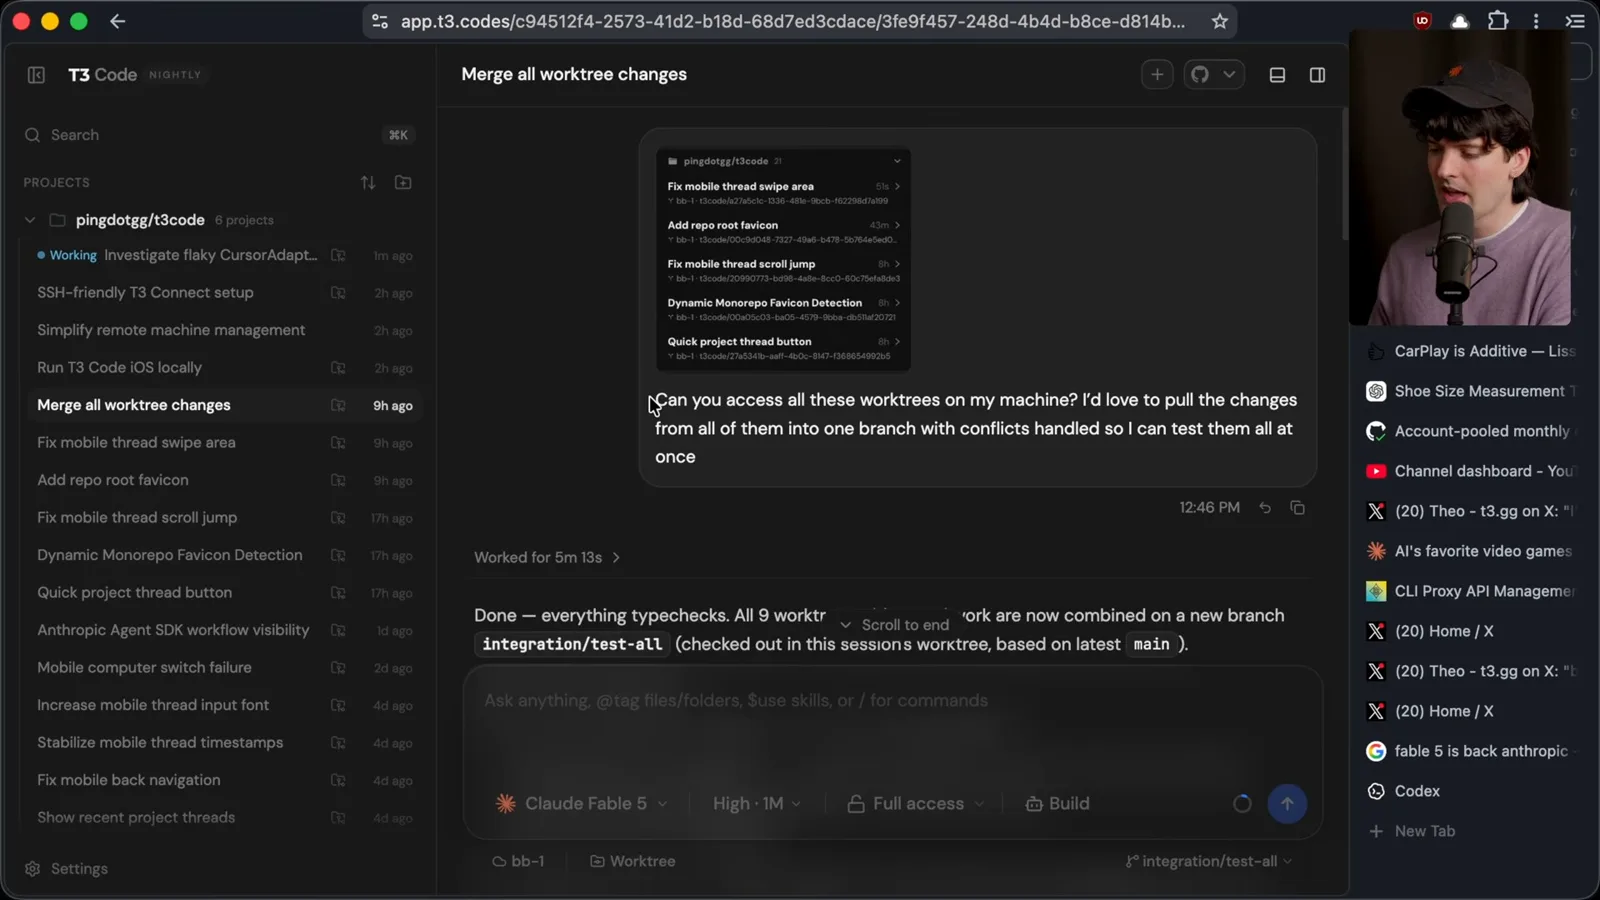
我还让智能体把多个 worktree 的改动合到一个分支,处理重叠部分,以便一起测试。智能体报告约五分钟完成。但在考虑提交 PR 之前,这个合并分支仍需测试和审查。
我不指望大多数实验性改动都会被合并。尝试修复所需的时间和改动范围可以提供线索:短改动可能很简单,长时间调查可能揭示架构复杂性。这只是经验线索,不能证明快修复一定正确或慢修复一定不好。
移动端滚动问题比滑动问题耗时长得多,因此我希望进一步审查,而不是盲目合并。即使快速修复也提到了一个让我疑惑的抽屉,我于是追问。要考虑架构、需求和代码差异;有不明白的地方就问。
我还提到自己试用过一个管理多个账户的代理,并指出这种配置会改变部分产品功能。应核对相关服务的兼容性和账户规则。更广泛的经验是:持续改进工作流,同时审查它产出的工作。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。