30 秒看懂
Matthew Berman 展示 Soundraw 如何编排器乐曲目,在 Synthesizer V 中实验歌声,并播放 Google Research 的 MusicLM 样本。文中可用性与价格属于历史信息,人声演示也保留了错误和局限。
- 1生成编曲Soundraw 提供情绪、曲风和段落能量控件。
- 2可编辑的合成演唱Berman 为声库分配歌词和音符,并调整声音特征。
- 3文字生成音乐研究MusicLM 示例包括文字、连续提示和旋律条件。
要点建议
- 演示中的 Soundraw 控件包括情绪、编排、速度和乐器。
- Synthesizer V 可以编辑音符、歌词和歌声特征。
- 主持人的首次人声示例存在发音和音乐质量问题。
- 视频录制时,MusicLM 以研究样本形式展示。
- 这些工具提供不同的控制方式,并非相同的工作流。
按章节阅读整理后的全文
Soundraw 编曲
Berman 探索器乐生成和当时的价格。
在这段 2023 年 2 月的视频中,我探索三种 AI 音乐方式:编排生成的器乐曲目、合成歌声,以及根据文字描述生成音乐的研究。提到的产品和价格均反映当时情况。
Soundraw 根据选择的情绪和曲风生成器乐选项。我选择几个情绪标签并试听曲目,再调整不同段落的能量,制造逐步增强的效果。
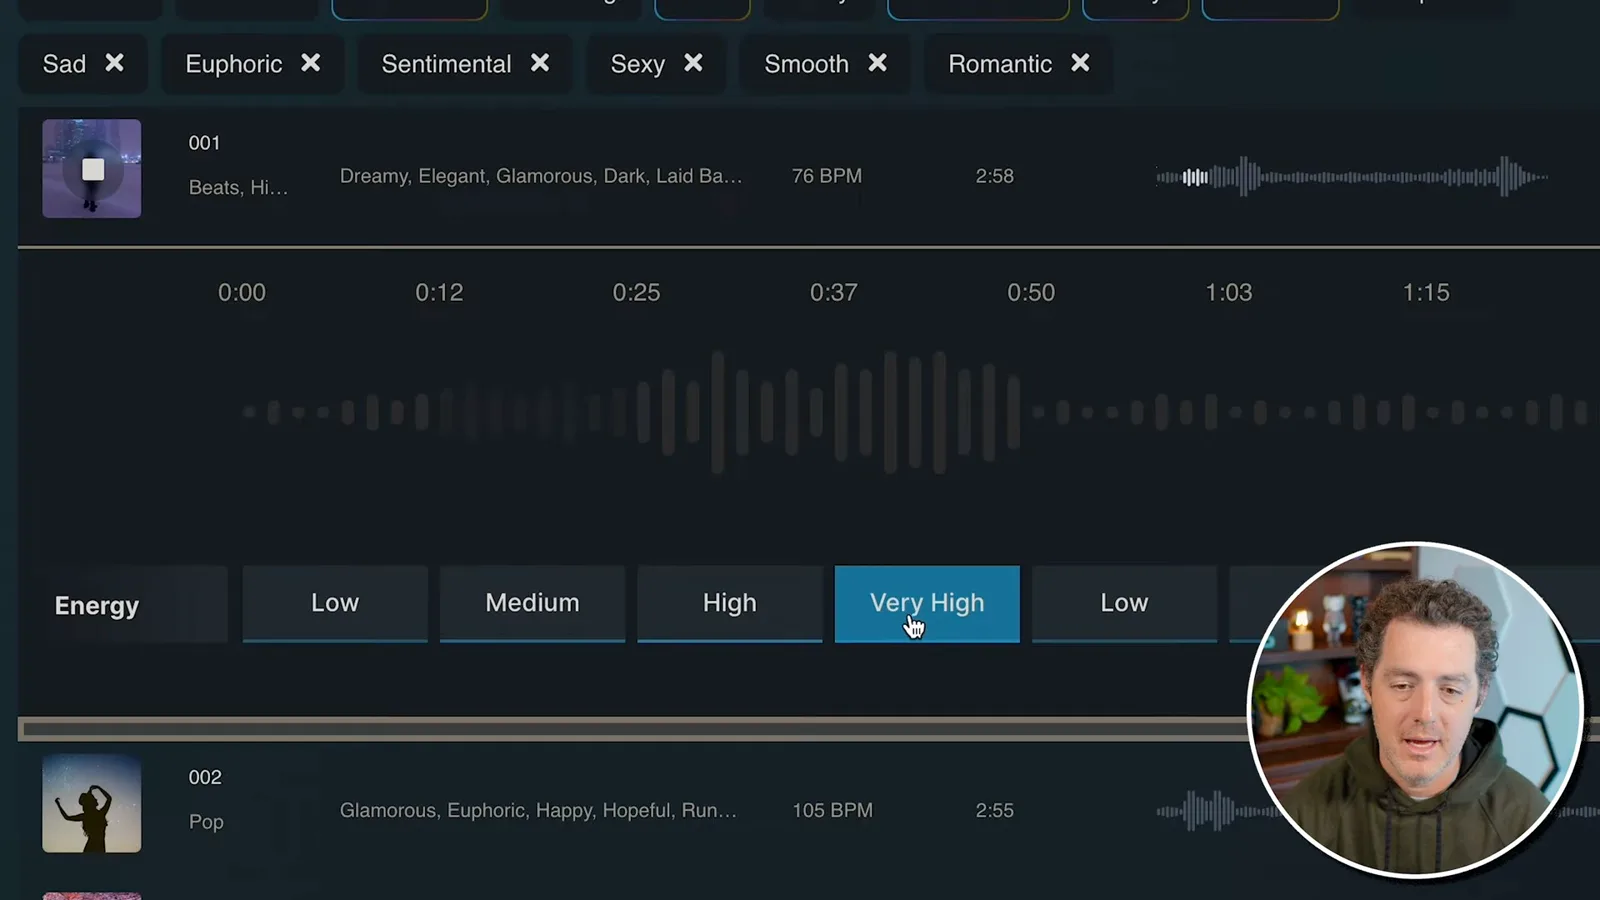
演示中的专业模式可以分别调整旋律、伴奏、贝斯、鼓和过门等部分。速度、时长、调性和乐器也可以进一步控制结果。
我尝试不同曲风和主题,包括教程和科技,展示不同选择如何产生不同曲目。界面还提供查找相似音乐,以及在视频下方预览配乐的方式。
我介绍了当时的免费生成与收藏功能,以及标价约每月 16.99 美元的付费下载方案。这些是 2023 年的历史条件,不能假定现在仍然适用。
Synthesizer V 人声
他尝试音符、歌词和合成声音设置。
接着我演示 Dreamtonics 的桌面应用 Synthesizer V,它可以把歌词和音符分配给合成歌声。我用 ChatGPT 起草歌词,并选择 Natalie 声库进行实验。
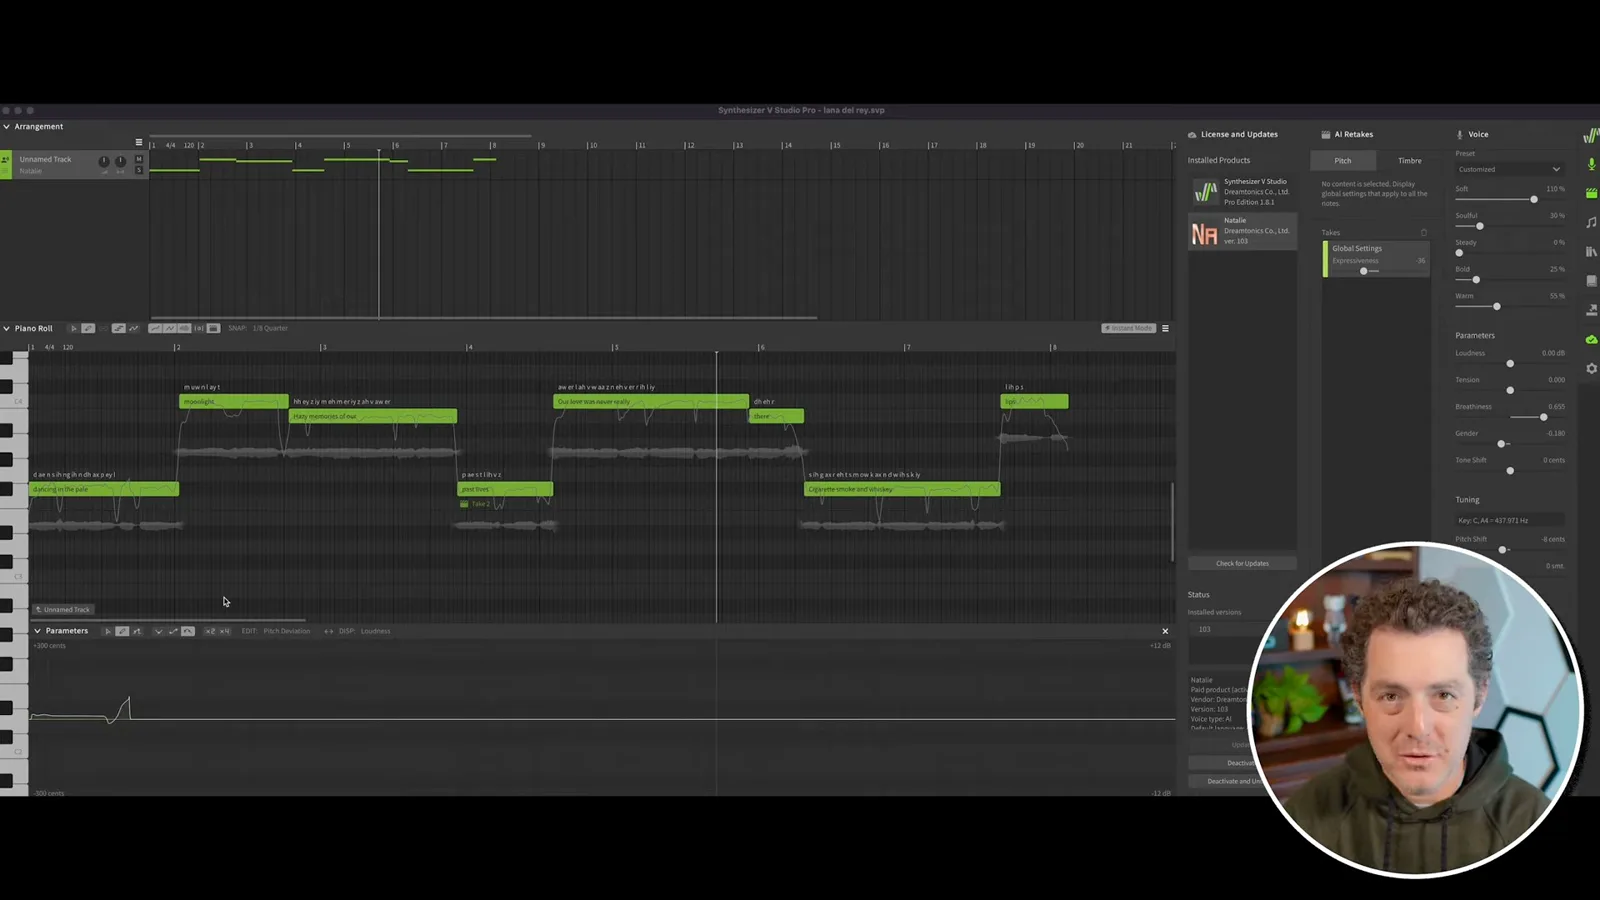
我承认自己的音乐知识有限,对第一次结果也不满意,并注意到歌声中的发音问题。这个例子既展示了可能性,也说明仍需要编辑。
编辑器允许我放置音符、输入歌词,并调整柔和度、气声、音高和调性等声音参数。移动音符、对齐音节会改变合成的演唱效果。
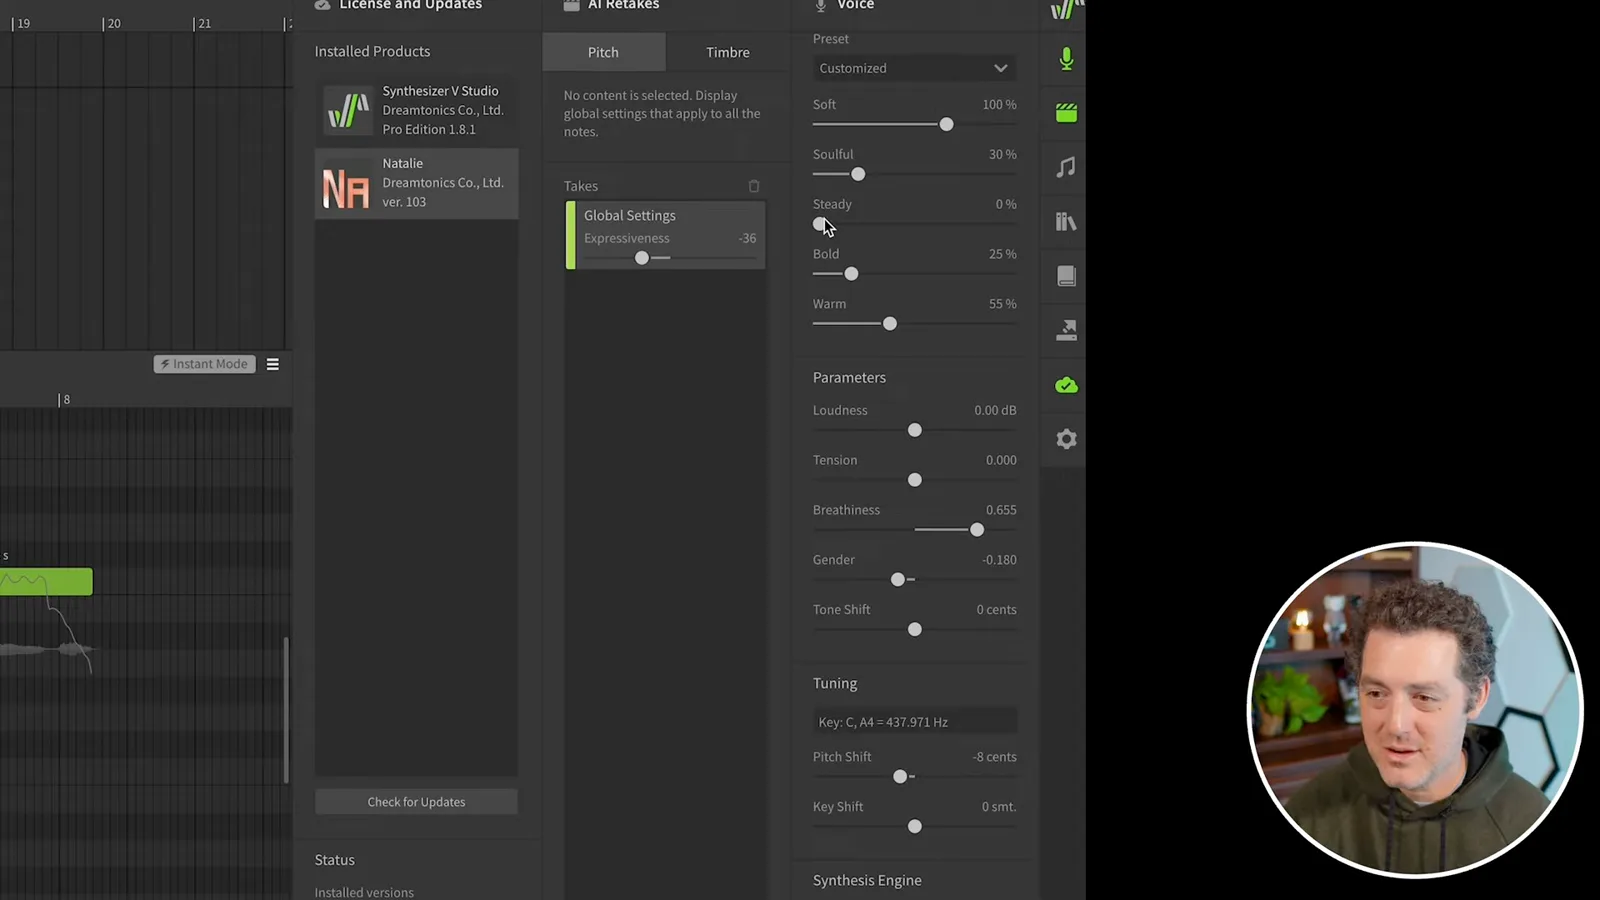
我建议把器乐曲目与合成歌声叠加,并展示 Dreamtonics 提供的声音选项。演示中部分声库和更完整的产品版本需要付费。
MusicLM 研究
他试听文字生成音乐样本,并展示不同的条件方式。
最后一个例子是 Google Research 的 MusicLM,它根据文字描述生成音乐。录制视频时,Berman 只能播放研究示例,不能把它当作公开可用的交互产品使用。
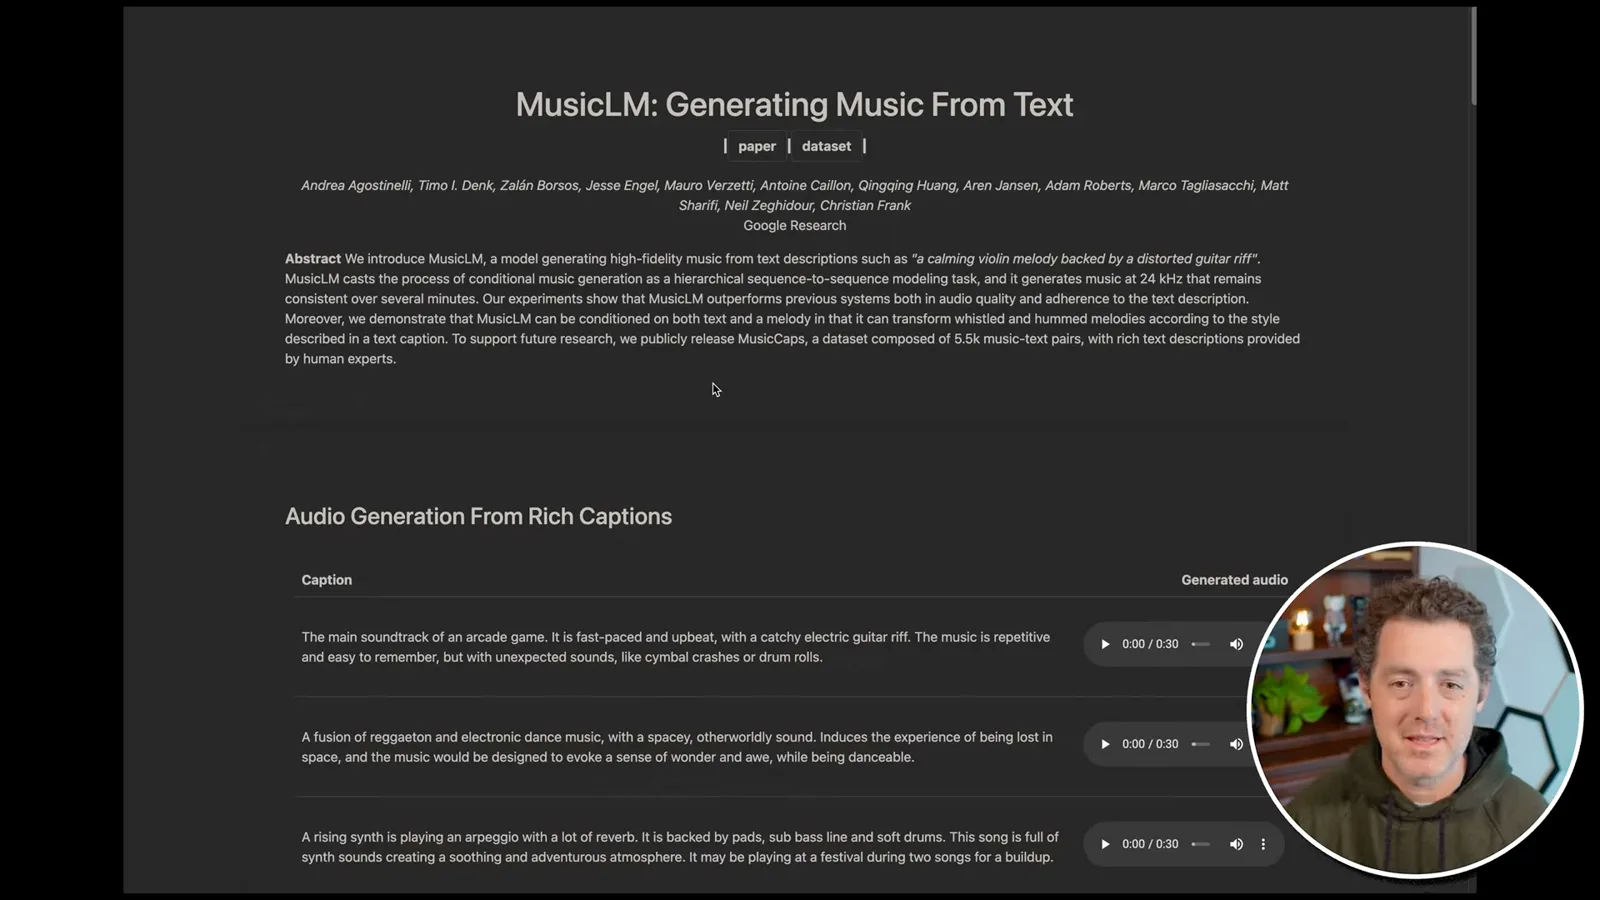
我试听了以街机配乐和雷鬼顿结合电子舞曲为提示生成的例子。这些样本展示了研究方向,但听少数片段并不能全面评估质量或原创性。
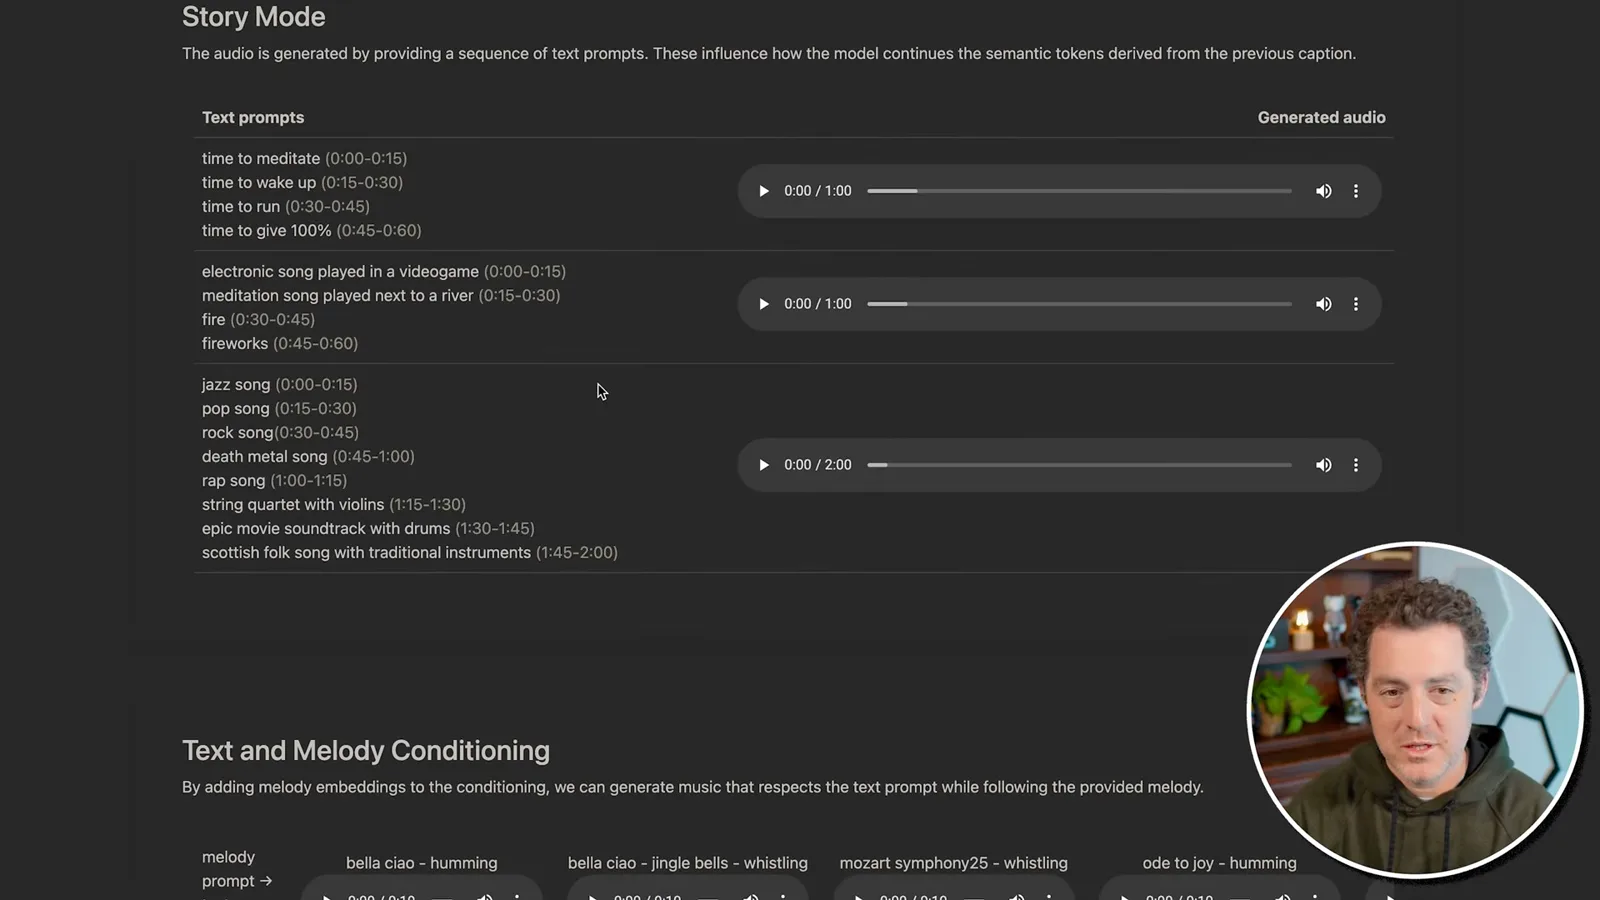
研究页面还演示了一系列随时间改变音乐的提示,以及同时使用给定旋律和文字作为条件。我展示了以哼唱或口哨作为旋律输入的例子。
我播放了一个与视觉艺术作品相关的例子,并查看特定乐器的样本。我预测文字生成音乐工具会更容易获得;这是根据 2023 年可见研究状态作出的预测。
最后,我比较了当时可用的编曲和歌声工具,以及仍处于研究演示阶段的文字生成音乐。它们提供的控制程度不同,也需要不同的创作投入。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文