30 秒看懂
2025 年 8 月,Matthew Berman 介绍 OpenAI 的 gpt-oss 开放权重模型及其混合专家架构。他回顾公司报告的基准和安全工作;结果只适用于相关测试,不能保证使用时安全或准确。视频由 Together AI 赞助。
- 1两款开放权重模型发布包括 120b 和 20b 版本;与另一个传闻模型的联系尚未证实。
- 2混合专家架构OpenAI 报告称,较大和较小模型每个 token 分别激活 51 亿和 36 亿参数。
- 3部分基准测试视频在特定条件下比较编程和推理成绩,包括是否使用工具。
- 4安全评估的范围OpenAI 报告称,其微调测试模型没有达到特定高能力阈值;这并不证明风险为零。
要点建议
- gpt-oss-120b 和 gpt-oss-20b 以 Apache 2.0 许可开放权重。
- OpenAI 介绍了不同内存要求的本地部署选择,实际效果取决于硬件与软件。
- 混合专家架构每个 token 激活部分参数,但总内存和基础设施仍然重要。
- 基准比较取决于任务、设置和工具访问;HealthBench 不能保证诊断准确。
- OpenAI 的最坏情况微调评估有明确范围,并未证明滥用不可能发生。
按章节阅读整理后的全文
开放权重与部署
Berman 介绍模型、许可和报告的内存要求,并讨论推理设置与本地使用。
OpenAI 在 2025 年 8 月发布了采用 Apache 2.0 许可的开放权重模型 gpt-oss-120b 和 gpt-oss-20b。我猜测此前出现的一个神秘模型可能与其有关,但 OpenAI 没有确认这一联系。本视频由 Together AI 赞助。
开放权重让开发者可以自行运行和调整模型,但仍受许可和基础设施成本约束。OpenAI 报告称,较大模型可在一块 80 GB GPU 上运行,较小模型可在具有 16 GB 内存的设备上运行;实际表现取决于软件、硬件和工作负载。
公告在部分推理基准上将 120b 模型与 o4-mini、20b 模型与 o3-mini 相比较。我对本地部署的可能性感到兴奋,但这些报告中的比较并不能保证它们在所有任务上表现相同。
模型支持工具使用和可配置的推理强度。Berman 将低、中、高设置描述为速度与额外计算之间的权衡。健康基准是对模型回答的评估,不能作为依赖模型进行诊断的保证。
架构与训练
模型采用混合专家 Transformer 和注意力优化。视频包含 Together AI 赞助。
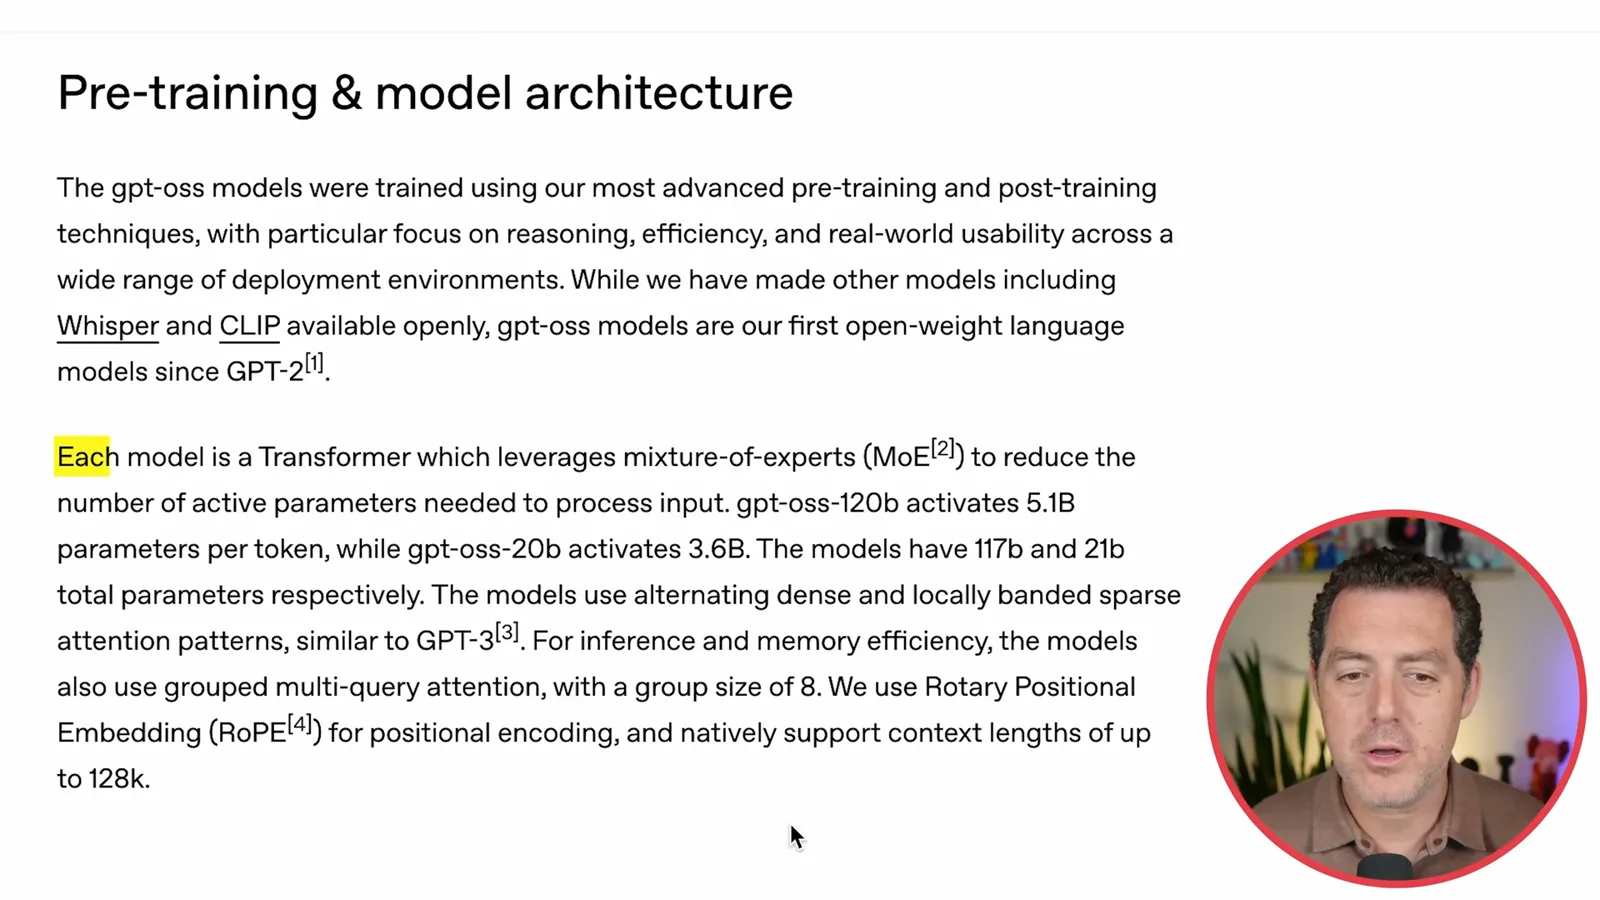
两个模型都采用混合专家 Transformer。OpenAI 报告称,120b 模型共有 1,170 亿参数,每个 token 激活 51 亿;20b 模型共有 210 亿参数,每个 token 激活 36 亿。激活参数只是部署成本和表现的一部分。
技术说明提到注意力优化、旋转位置编码和最长 128,000 token 的上下文。OpenAI 表示预训练数据以文本为主,包括 STEM、代码和常识;能够本地使用并不意味着模型输出自动准确。
Together AI 赞助本期视频并提供托管访问。随后 Berman 介绍后训练中的监督微调和强化学习,其目标是改善推理和工具使用。不应假定所有模型提供商采用完全相同的训练方法。
基准测试
Berman 回顾部分编程、健康和推理评估。成绩取决于测试设置。
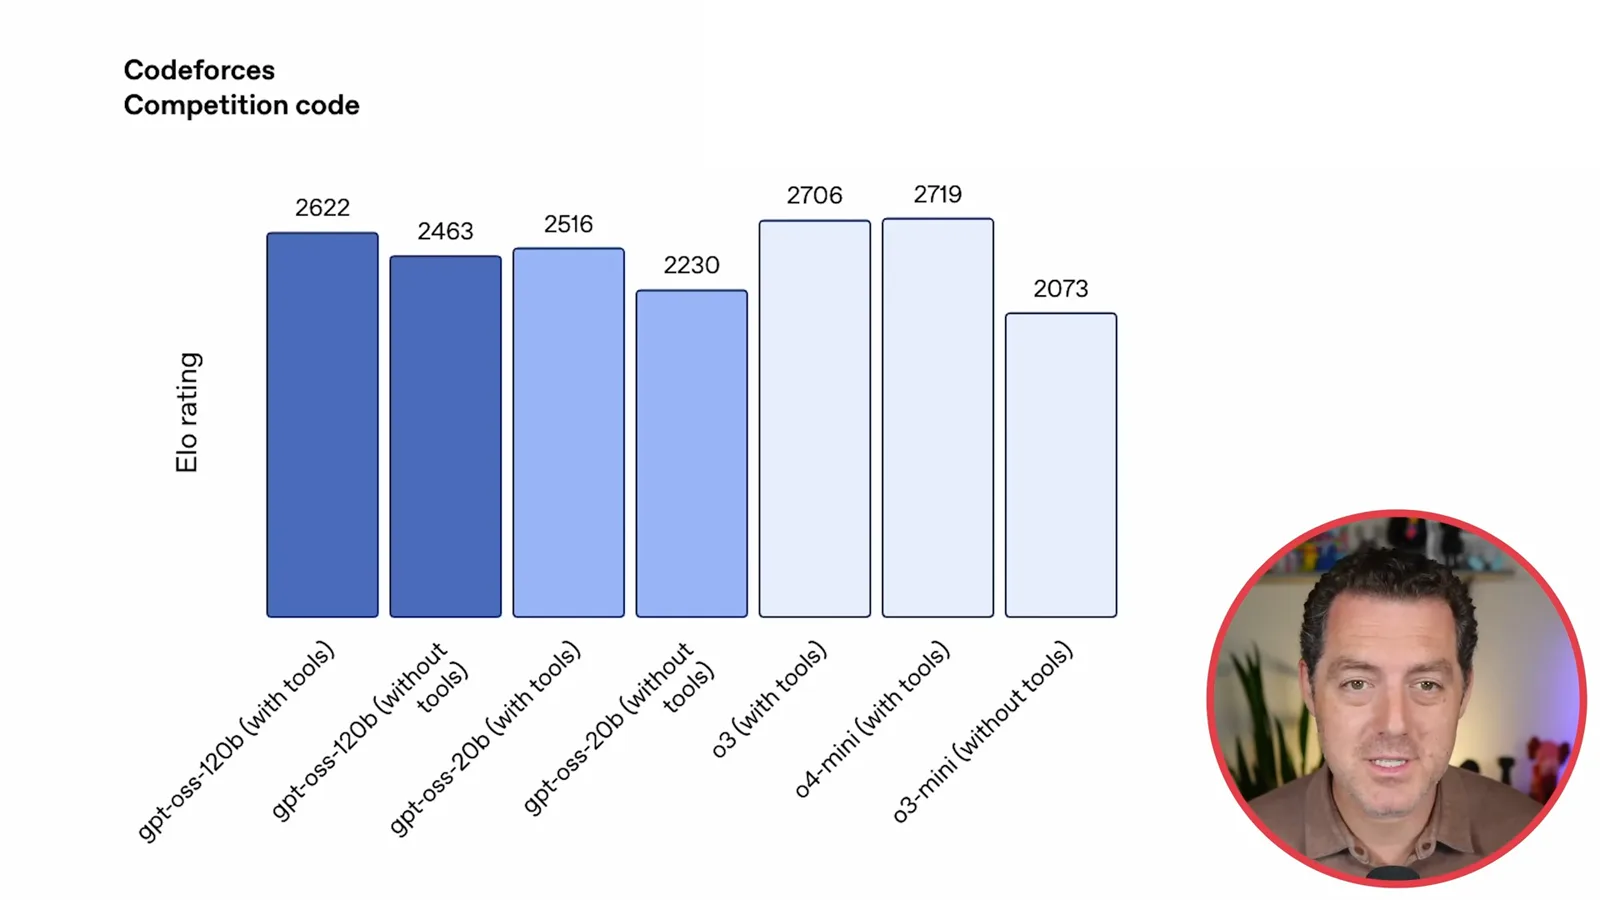
展示的 Codeforces 估计成绩中,使用工具的 gpt-oss-120b 为 2622,使用工具的 gpt-oss-20b 为 2516,使用工具的 o3 为 2706。这些是特定条件下的基准估计,不能直接证明模型在所有编程工作中都优于大多数人。
在展示的 Humanity’s Last Exam 和 HealthBench 比较中,Berman 引用的较大模型成绩低于 o3,尽管部分测试接近。他还回顾 AIME、GPQA、MMLU 和 TAU-bench;解读任何分数时都要考虑测试配置和工具访问。
安全与红队测试
OpenAI 讨论监测、微调评估和红队挑战。测试有明确范围。
OpenAI 表示,这些模型的思维链没有接受直接的对齐监督,并讨论了通过监测发现潜在异常行为。公司提醒开发者不要直接向用户展示原始推理,因为其中可能包含有害或不准确的内容;这类轨迹也不是完整或可靠无误的安全监测手段。
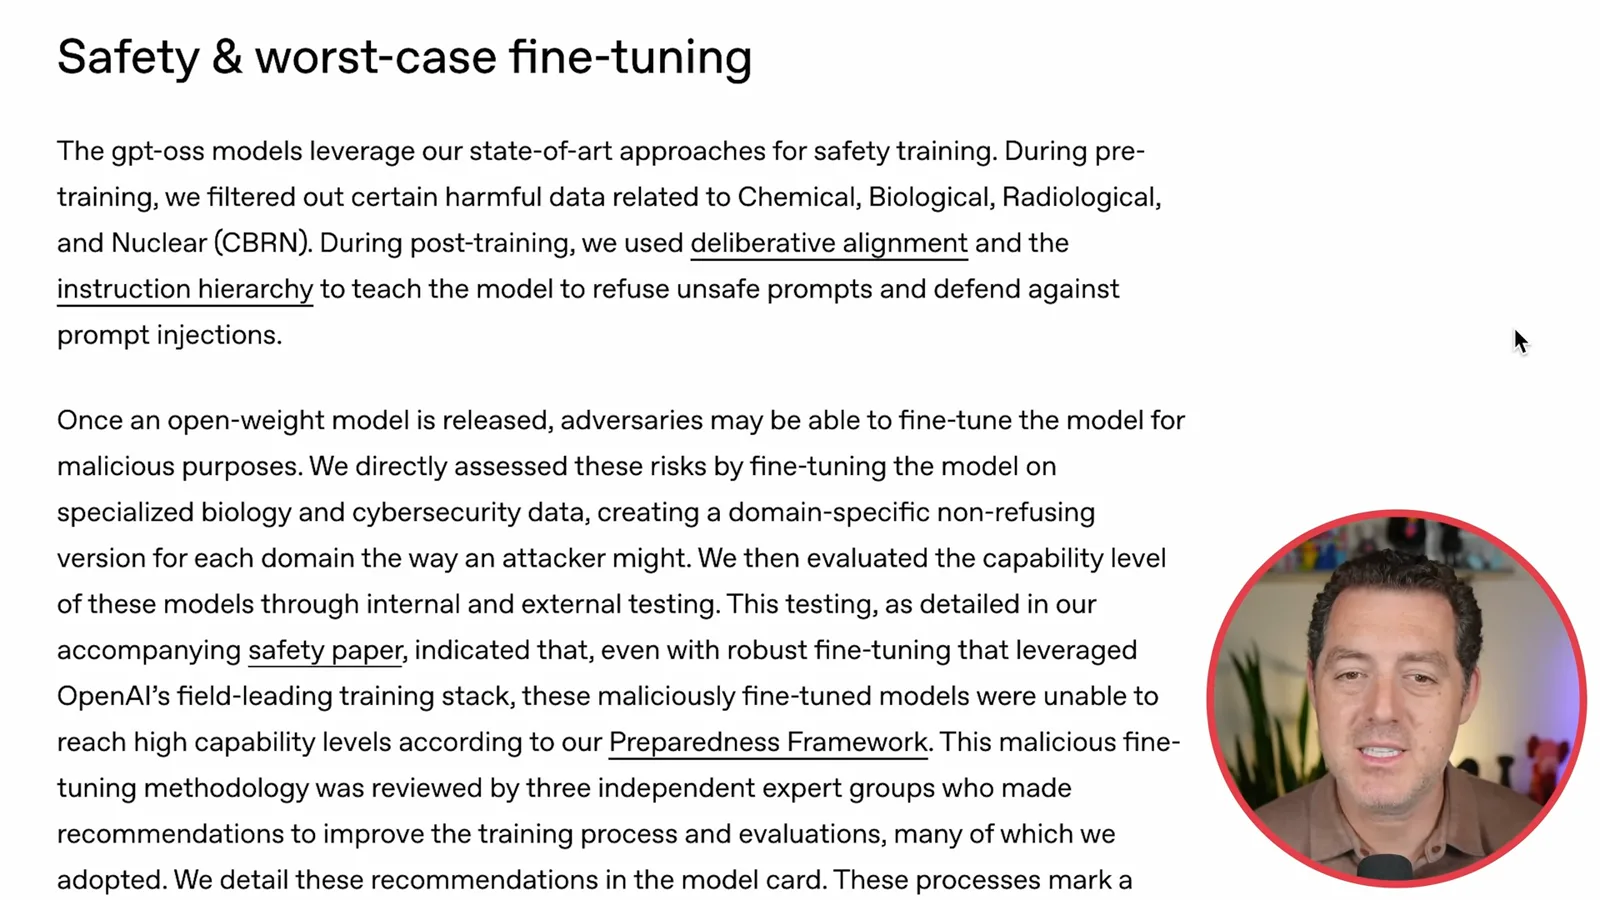
公司介绍了过滤部分有害预训练数据,以及在生物和网络安全领域评估最坏情况微调的工作。它报告称,在这些测试中修改后的模型没有达到其框架定义的高能力阈值。这一结果并不意味着有害微调或不安全输出不可能发生。
OpenAI 还宣布了带有奖励的红队挑战,以发现安全问题。我计划进行更完整的实际测试,并向观众介绍赞助商的托管选项。这里描述的数字和可用性均来自 2025 年发布时。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文