30 秒看懂
在 2024 年 8 月的视频中,Matthew Berman 讨论有关 OpenAI Q* 和 Strawberry 的网络推测,并介绍过程反馈、A* 搜索和 Tree of Thoughts 等思路。所提出的架构、消除幻觉的说法以及破解加密的担忧,都没有得到视频所展示证据的证实。
- 1传闻与证据来源帖子明确承认 Q* 尚未公开记录;其架构说法属于假设。
- 2加密方面的担忧视频讨论的是假设风险,没有证据表明报道中的模型破解了加密技术。
- 3搜索与学习Q-learning 和 A* 是不同的技术,仅凭名称无法确认内部实现。
- 4Tree of Thoughts所引用框架在中间候选步骤之间搜索,并在部分任务上报告了提升,而非保证普遍正确。
要点建议
- 视频制作时,传闻项目的技术细节尚未公开确立。
- 有关部分数学题的报道,比证明 AGI 或全面掌握数学要窄得多。
- Q-learning、A* 和自我对弈是研究概念;视频提出的它们与 Q* 的联系属于推测。
- 额外搜索或过程反馈可能帮助某些任务,但不能保证正确或消除幻觉。
- 数学表现更好,本身不是系统能够破解现代加密技术的证据。
按章节阅读整理后的全文
传闻与公开报道
Berman 介绍网络讨论和当时有限的信息,回顾有关数学表现的报道与相关推测。
2024 年 8 月,有关 OpenAI 传闻中的 Q* 和 Strawberry 项目的猜测在社交媒体上传播。我回顾了账号 Chubby 的一篇分析,区分公开报道与假设。当时 OpenAI 尚未公布项目的技术细节。
Sam Altman 发布的一张草莓图片和网络账号的评论推动了各种梗图。社交媒体线索不能证实特定架构、发布日期或能力。
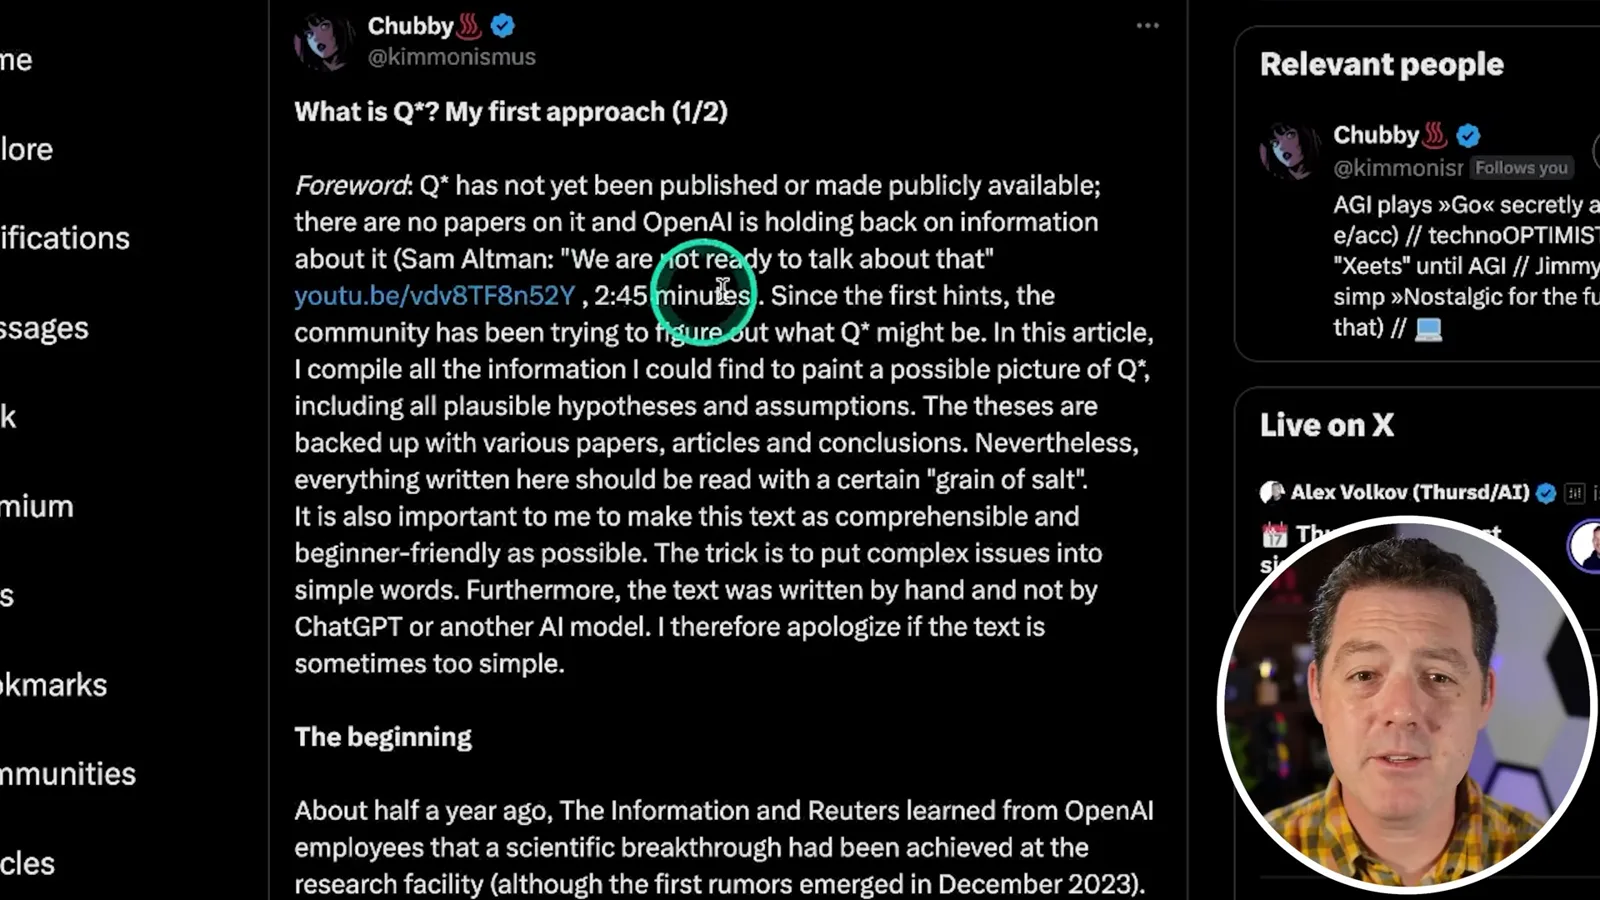
这篇分析指出 Q* 尚未公开记录,并从文章和研究中收集可能的解释。Altman 曾表示 OpenAI 有兴趣改进推理能力,但拒绝解释 Q*。本视频没有确立传闻名称与任何具体实现之间的关系。
报道描述了一项可能的数学解题进展。帖子进一步提出关于独立学习和 Transformer 局限的说法,但这些说法并未得到所引传闻证实。预测 token 本身不能证明模型完全不能推理,也不能证明它在训练中无法学习。
Berman 引用路透社报道,称一个模型在获得计算资源后能解决某些小学水平数学题。这一报道比证明一般数学能力或 AGI 要窄得多;即便 AGI 的定义也仍有争议。
Altman 关于研究进展的一段公开评论引发了更多猜测。Berman 也提到领导层变动和研究人员离职,但这些评论和事件都不能证明某个项目具体做了什么,或相关决定为何作出。
风险与审慎推理
讨论提出假设性的加密担忧,并将额外的推理阶段计算与人的审慎思考相比较。
帖子提出一种假设性担忧:数学能力更强的 AI 可能威胁加密技术。这是推测性风险,而不是 Q* 破解了加密的证据;更擅长学校数学不意味着能攻破现代密码技术。
Berman 对回答前投入额外计算来探索和检查问题的系统很感兴趣。他将其与审慎思考相比较,但这种类比不能证明模型像人一样思考。
帖子借用了 Daniel Kahneman 关于快速直觉思考和较慢审慎思考的区分,并将其作为不同 AI 工作流的类比;将某种模型架构直接等同于人类的任一思维系统,属于过度简化。
搜索、自我对弈与验证
Berman 解释候选研究思路及其可能成本。它们与传闻项目的联系仍未经证实。
自我对弈提供了另一种类比:AlphaZero 在设计好的训练流程和规则下,通过反复对局学习。这是真实的研究方法,但不能证明 Q* 使用同样的方法,或在没有训练数据的情况下学习数学。
分析推测了 Q-learning 和 A* 搜索的结合。A* 是图搜索方法,Q-learning 是强化学习方法;名称本身不能证明 OpenAI 在 Q* 中结合了它们。搜索也不能保证在所有情况下都得到最优解。
Berman 描述了探索候选路径、检查中间步骤和投入更多计算的过程。这些技术在某些任务中可能改善表现,但搜索和过程检查都不能保证答案正确,也不能消除幻觉。
帖子提出,更小的模型或许可以降低计算密集型推理过程的成本。Berman 将其标为假设;实际成本取决于模型大小、推理策略和部署方式。
他提到 OpenAI 的《Let’s Verify Step by Step》研究,以及要求模型将问题拆解成步骤的提示方式。过程反馈和结构化提示是不同技术;一个有用的提示词不能证明传闻模型的内部方法。
Tree of Thoughts 与结论
他介绍结构化搜索及其他研究概念,然后总结这些推测。
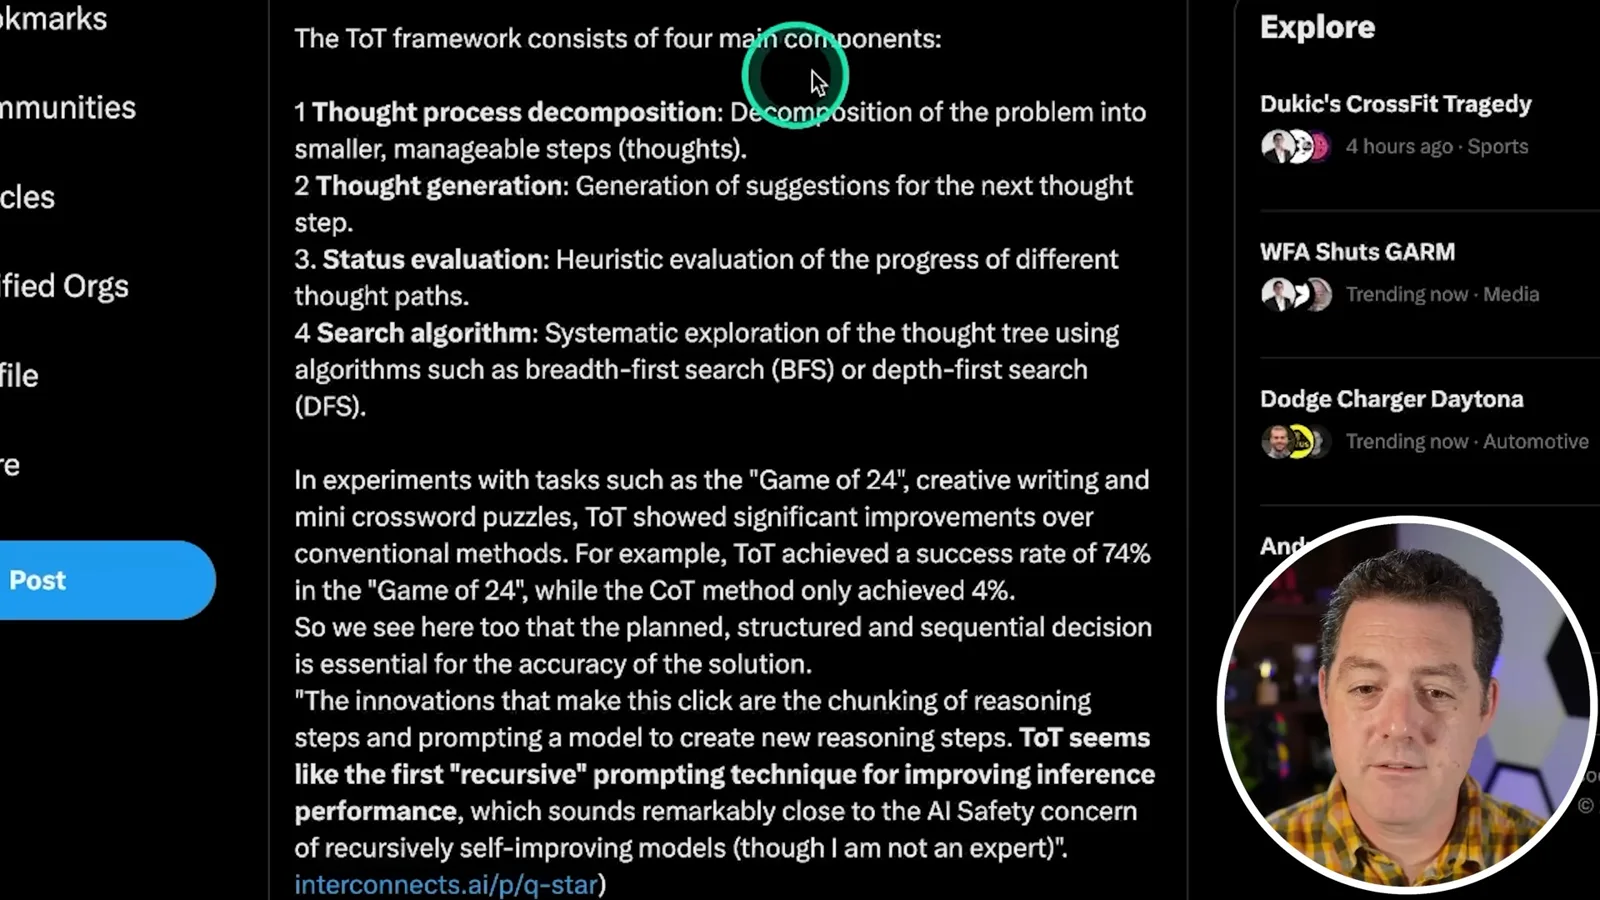
Tree of Thoughts 探索候选中间步骤、评估它们,再在不同选项之间搜索。相关研究在特定实验条件下报告了部分任务的提升,包括 24 点游戏、写作和填字游戏。
分析进一步推测了自我对弈、反馈和前瞻规划。这些是有用的研究概念,但所声称的组合及其与 Strawberry 或 Q* 的联系,并未得到展示证据的证实。
Berman 最后提到一套报道中的内部能力框架,并将讨论描述为对项目可能形态的分析。有用的区分是:哪些是已发表技术,哪些是当时的报道,哪些是未经证实的解释。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文