30 秒看懂
Matthew Berman 介绍 AI21 的 Jamba 1.5,并在 AI21 Studio 中用编程、算术、逻辑和语言任务测试 Large 模型。他的体验总体负面,但样本少且非正式,部分题目带有主观性或歧义,因此结论的适用范围有限。
- 1AI21 的发布声明公司声称 Mini 和 Large 模型在长上下文和速度方面有优势;这些说法取决于测试条件。
- 2耗时的编程尝试Berman 报告说等待俄罗斯方块程序生成的时间很长,生成结果在他的测试中未能运行。
- 3谜题结果有好有坏几道推理题未通过他的检查,但模型正确回答了 strawberry 和小数比较问题。
- 4评估的局限北极问题存在歧义,道德问题涉及价值判断,因此都不是干净的客观基准。
要点建议
- AI21 将 Jamba 1.5 描述为具有长上下文窗口的状态空间模型与 Transformer 混合架构。
- Berman 在一次托管服务会话中遇到长时间等待,生成的俄罗斯方块程序也未能运行。
- 模型答错了他的几道谜题,但正确回答了 strawberry 字母计数和小数比较。
- 道德题带有主观性,北极行走题需要更精确的假设。
- 一次小规模非正式测试不能证明模型或架构的总体表现。
按章节阅读整理后的全文
Jamba 1.5 与其架构
Berman 介绍 AI21 的模型家族和发布时宣称的功能。讨论反映 2024 年的产品情况。
我先介绍 AI21 的 Jamba 家族及其状态空间模型与 Transformer 混合架构,再测试 Jamba 1.5 Large。视频记录的是 2024 年的一次 playground 会话,并非对这一架构或后续版本的受控基准测试。
AI21 发布了 Mini 和 Large 模型,声称它们具有 256,000 token 上下文窗口、长上下文速度优势和特定基准成绩。公司还介绍了多语言、结构化 JSON、函数调用和引用功能。这些是公司的说法,取决于指定的测试条件。
模型通过 Jamba Open Model License 提供下载,也可通过若干云服务使用。我在这次测试中使用 AI21 Studio。可用性、条款和模型能力都可能变化,因此应结合当时的背景理解发布信息。
俄罗斯方块与推理测试
他测试代码生成、信封问题和几道逻辑谜题,并报告了会话中的长延迟。
我选择 Jamba 1.5 Large,让它用 Python 编写俄罗斯方块。输出约等待 20 至 30 秒才开始,我说它持续生成了约七分钟。一次会话无法证明总体吞吐量,也无法确定延迟来自模型、服务还是界面。
生成的代码使用 Pygame,但我将其复制到编辑器并运行时,什么也没有发生。我把这次尝试判为失败,并因等待时间过长而没有继续迭代。这反映了这一次的结果,并不能证明每个编程提示都会失败。
下一道题问一个 200 × 275 毫米的信封是否符合给定邮寄尺寸限制。模型回答不符合;我认为旋转信封后可以放进允许范围。结论取决于具体尺寸规则和各边的对应方式。
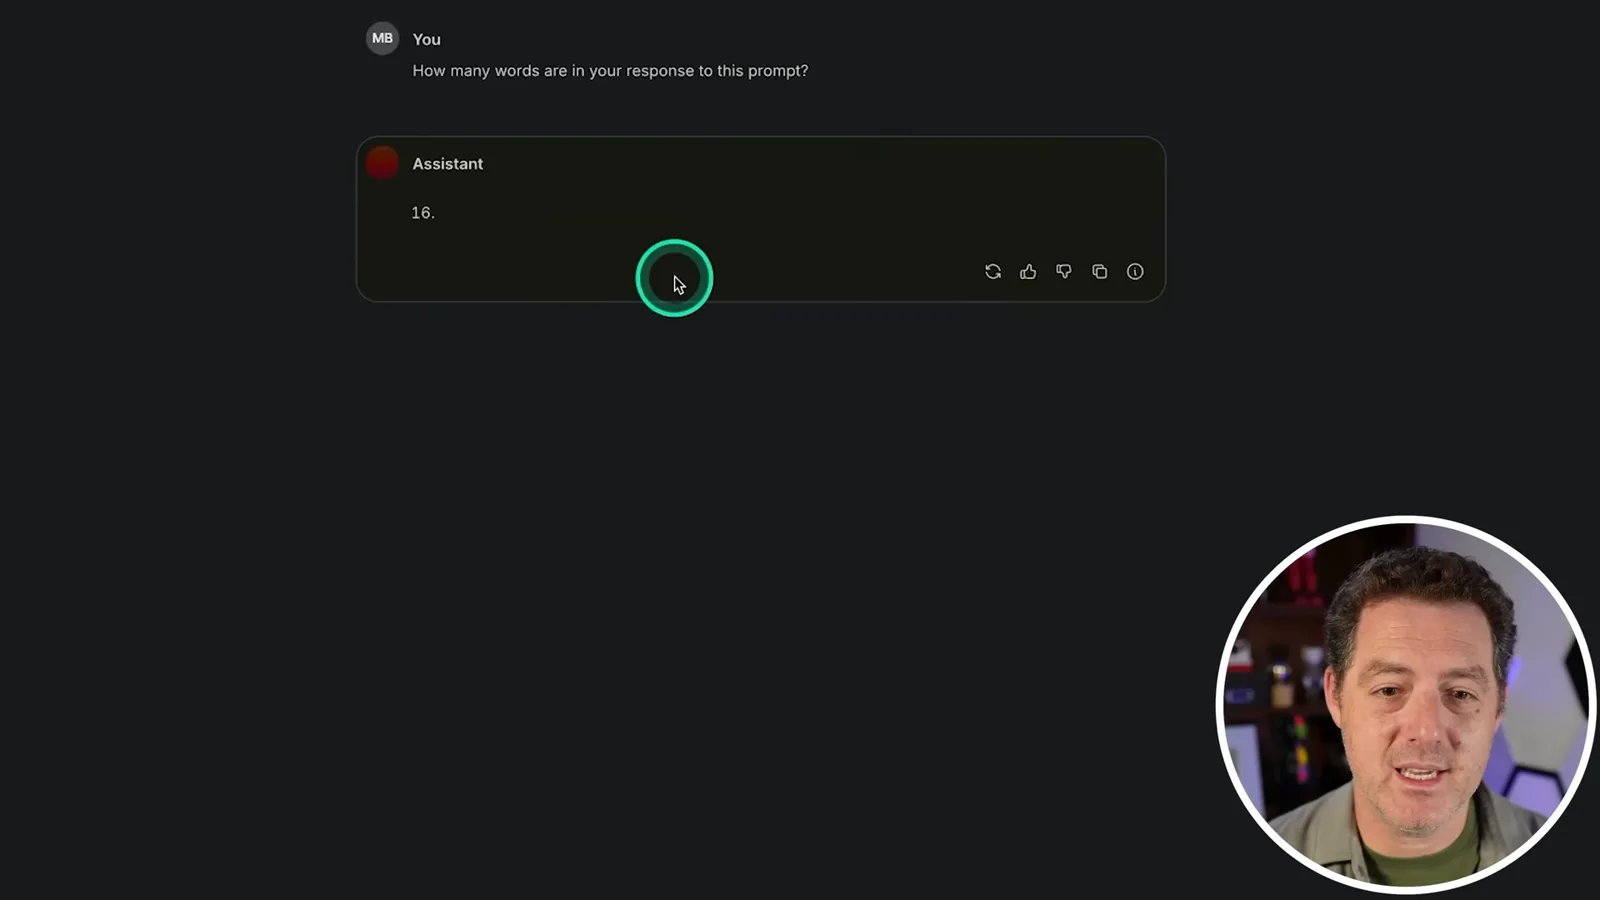
被问到自己的回复有多少个词时,模型回答“16”;在三名杀手的房间里又有人进入并杀死一人的谜题中,它说剩下两名杀手。我认为两个答案都不对:按照通常理解,后一题中进入者也成为了杀手。
在弹珠谜题中,模型推断倒扣的杯子被拿起后,弹珠仍在杯子的上方。我不接受这个答案:按照通常的设置,弹珠落到桌面,杯子被拿起后它仍留在桌上。
我还问了一道北极行走题,并不同意模型的答案。题目中的直线路径和经过起点有不同解释;如果不说明这些假设,这次交锋就不是明确的客观评分。
语言、算术与判断
模型答对了部分简短任务,也答错了其他任务。Berman 最后对这次非正式测试作出负面评价。
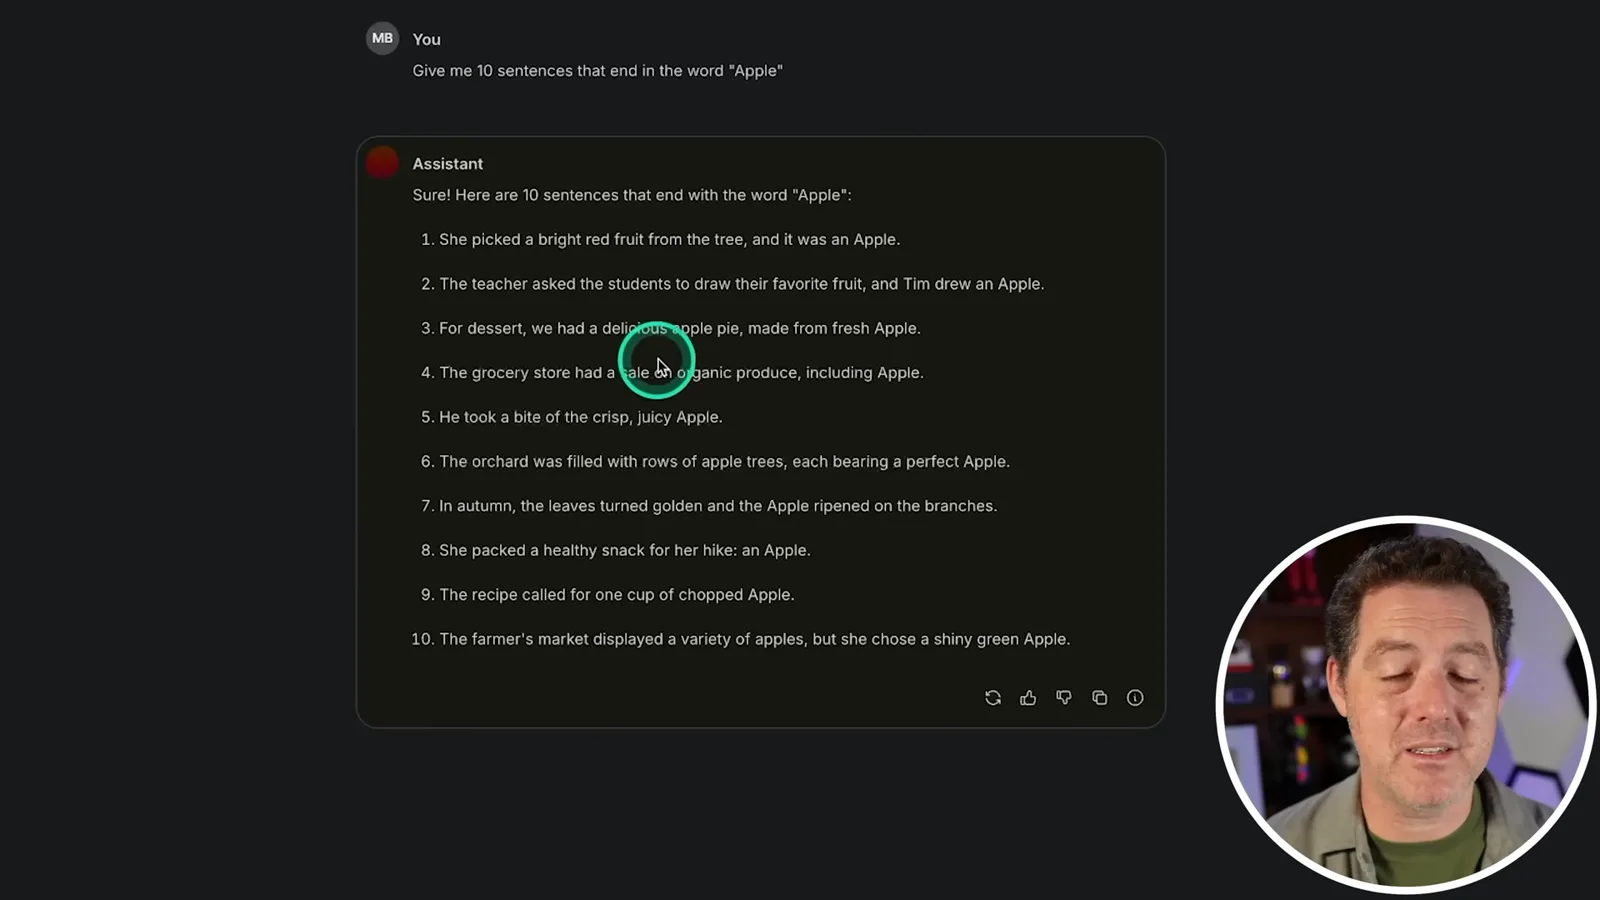
要求模型给出十个以“Apple”结尾的句子时,九个符合要求,一个不符合。它正确指出“strawberry”中有三个“r”,也正确回答 9.9 大于 9.11。
在一个关于轻推某人以拯救全人类的道德假设中,模型最终回答不可以。我不同意,但承认评分反映了我自己的伦理判断;这不是客观的通过或失败测量。
我认为这次测试令人失望,同时欢迎不同模型架构之间的竞争。少量提示词和一次托管会话只能支持有限的观察,不能对 Mamba 或所有 Jamba 部署作出普遍结论。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文