30 秒看懂
2024 年 4 月,Matthew Berman 在 LMSYS 界面测试了一个名为 gpt2-chatbot 的匿名模型。他报告了几个小型编程和推理题目的良好结果,同时也遇到输出缓慢、格式问题和一道物理推理错误。他推测模型来源,但没有证实它是 GPT-5 或任何特定 OpenAI 模型。
- 1匿名模型Berman 讨论了关于 gpt2-chatbot 身份的猜测,但表示不知道它究竟是什么。
- 2能运行的贪吃蛇游戏模型生成 Python 游戏,Berman 成功运行,但输出缓慢且冗长。
- 3推理与算术在展示的示例中,模型处理了晾衬衫问题和简单算术,但存在一些格式问题。
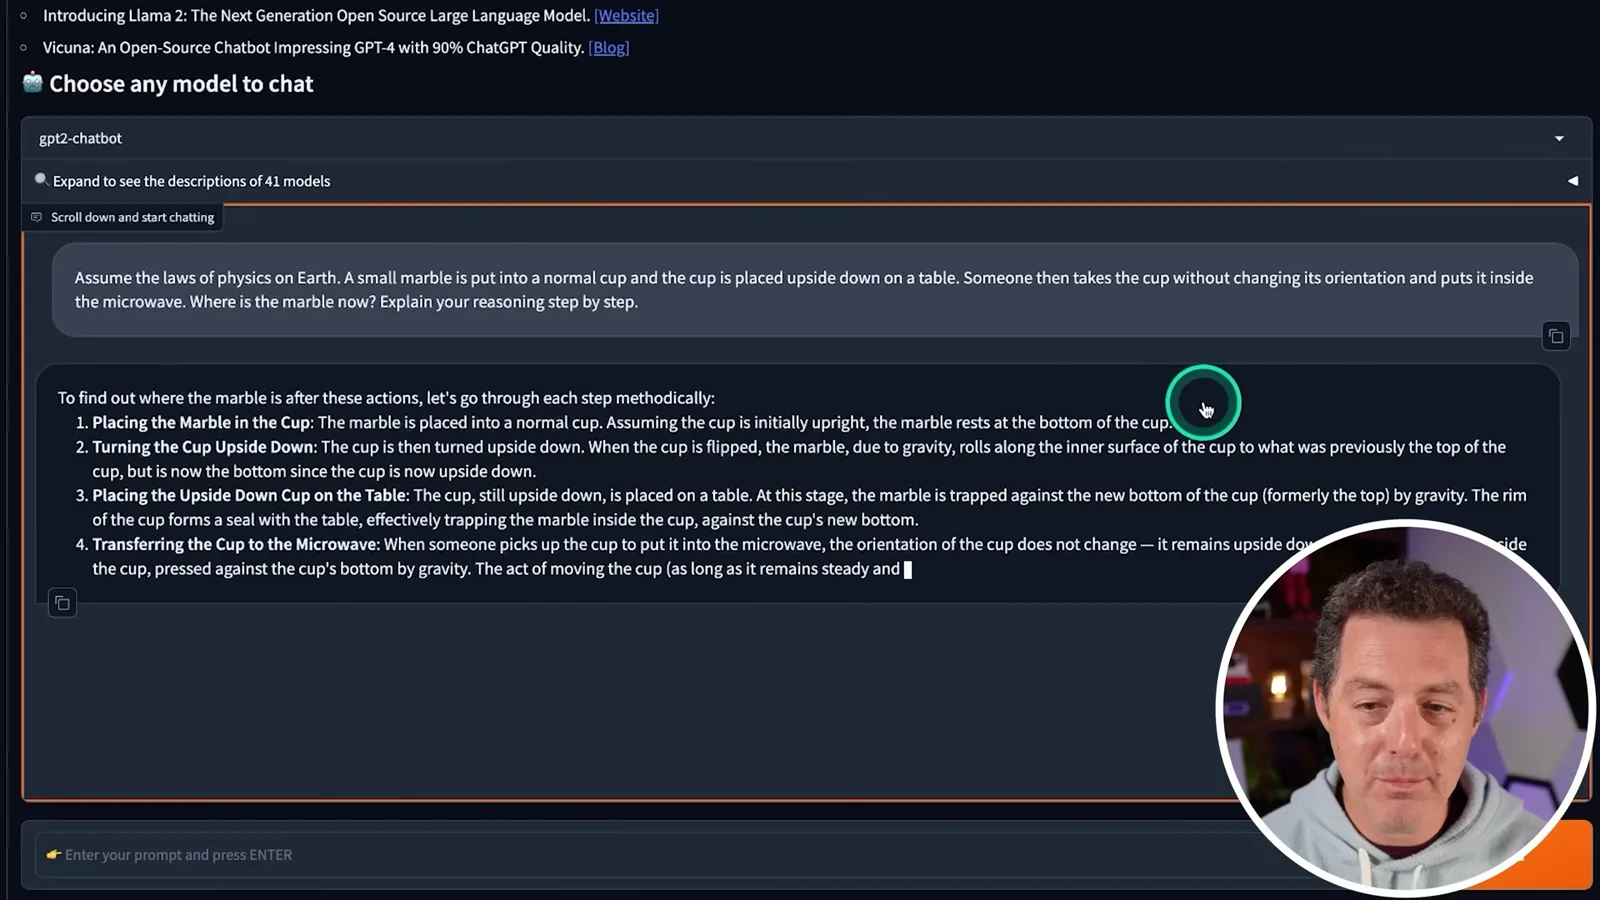
- 4物理推理错误它错误地说拿起倒扣的杯子时弹珠会留在杯内;通常弹珠会留在桌上。
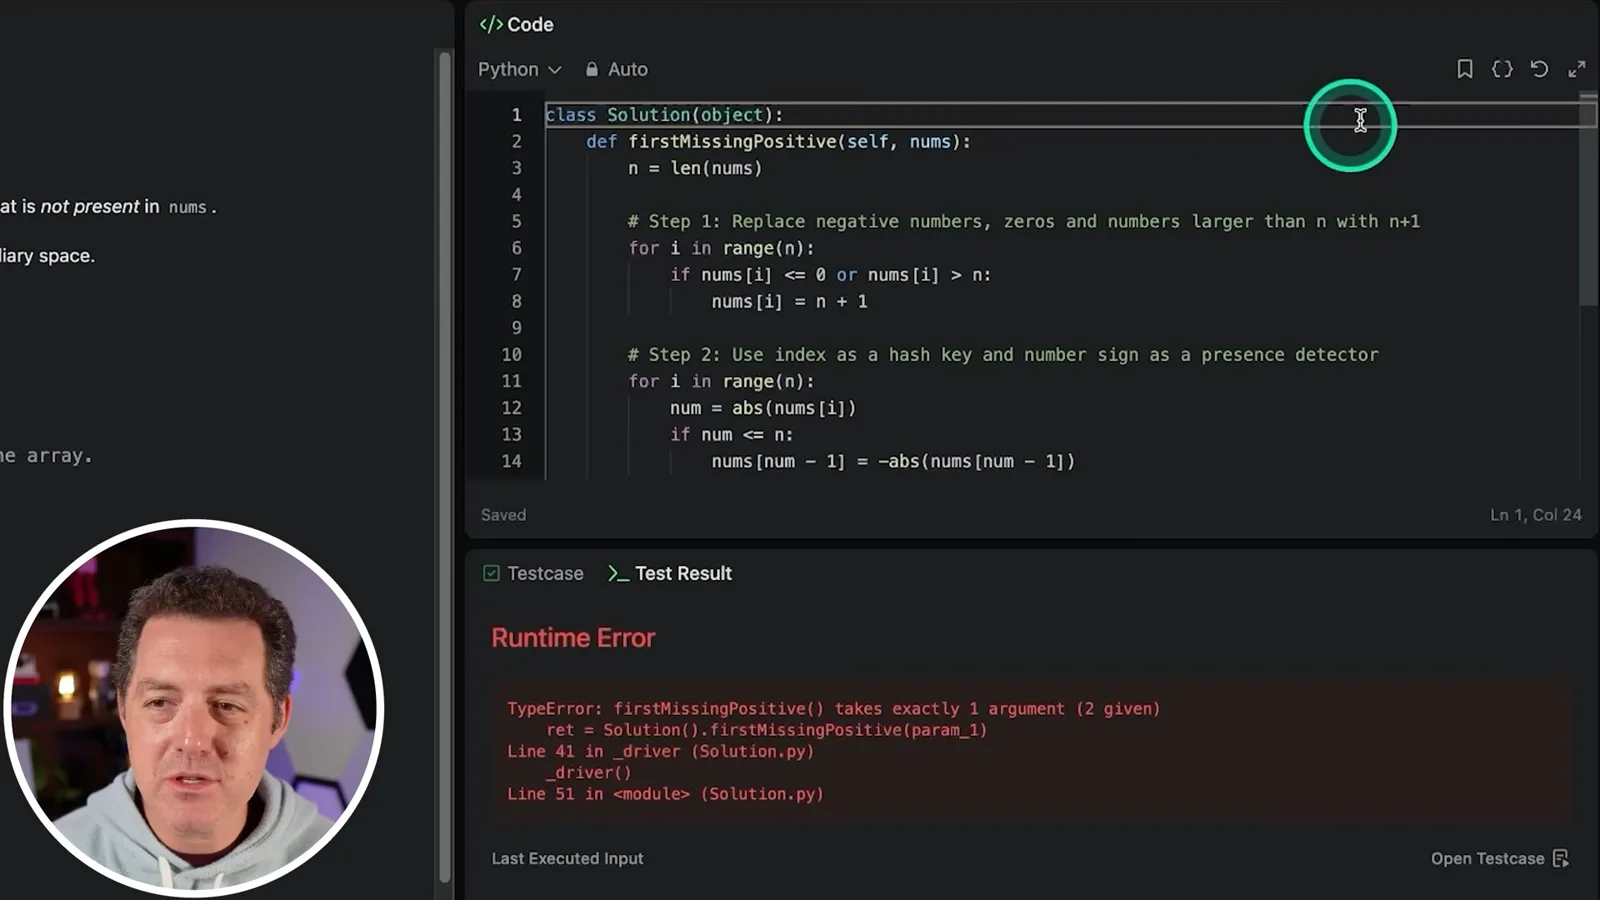
- 5经过修改的编程题Berman 为方法添加 self 参数后,LeetCode 解答获得通过;最初接入时需要调整。
要点建议
- Berman 当时不知道模型身份;名称或模型的自我介绍不能证明其来源。
- 生成的贪吃蛇游戏在演示中运行成功;一道编程题在他调整代码以适配测试环境后通过。
- 模型回答了几个简单推理和算术问题,但答错了倒扣杯子问题。
- 少量非正式提示不能确定模型的整体质量、训练历史或基准排名。
按章节阅读整理后的全文
LMSYS 上的神秘模型
Berman 回顾对模型身份的猜测,并开始基本编程测试。
2024 年 4 月,Matthew Berman 在 LMSYS 聊天界面发现了一个名为 gpt2-chatbot 的匿名模型。网上有人猜测它与 OpenAI 有关,并猜测未来模型名称,但 Berman 表示不知道其身份。名称和模型自身的说法不能证明是谁开发了它。
他先要求用 Python 输出 1 到 100。回应缓慢且比预期复杂,但他认为代码有效。他提醒,生成缓慢可能与服务硬件或模型特性有关,单凭界面无法确定。
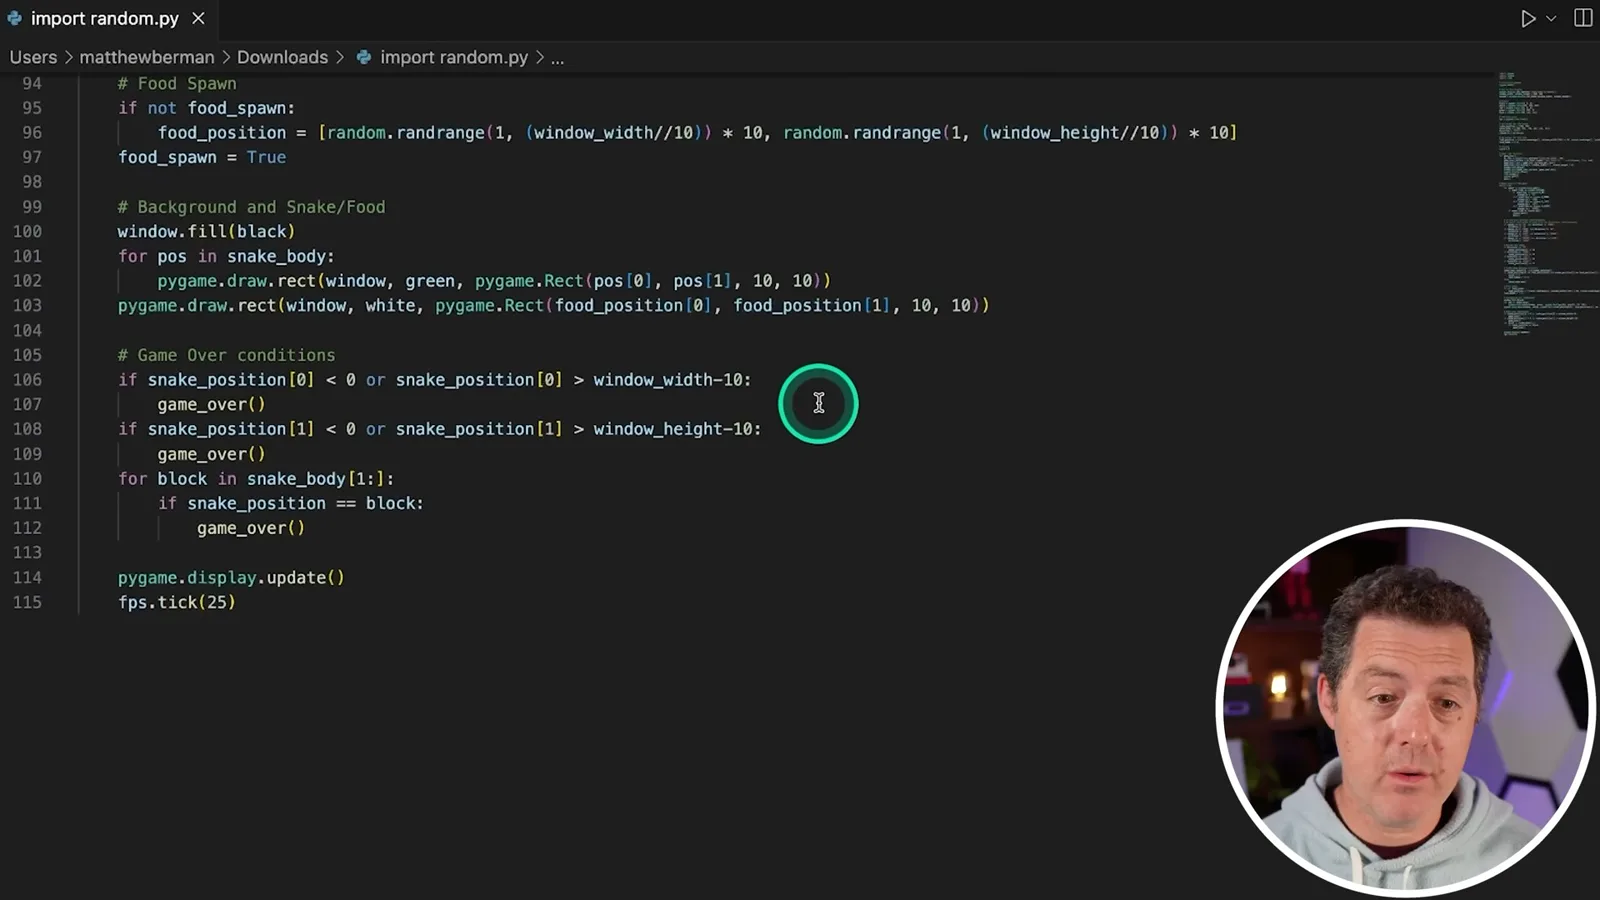
接着他要求用 Pygame 编写贪吃蛇游戏。输出很长,生成时显示也有些异常。Berman 将代码粘贴到编辑器后第一次就成功运行;游戏记录分数,并在蛇碰到边界或自身时结束。
安全与推理提示
模型拒绝有害请求,然后回答关于晾衬衫和相对速度的问题。
Berman 用一个涉及闯入汽车的请求测试拒答,然后尝试以虚构情节包装。模型拒绝了直接请求,后来给出叙事情节而非他要求的细节。这个范围很窄的测试无法识别开发者,也不能描述模型完整的安全表现。
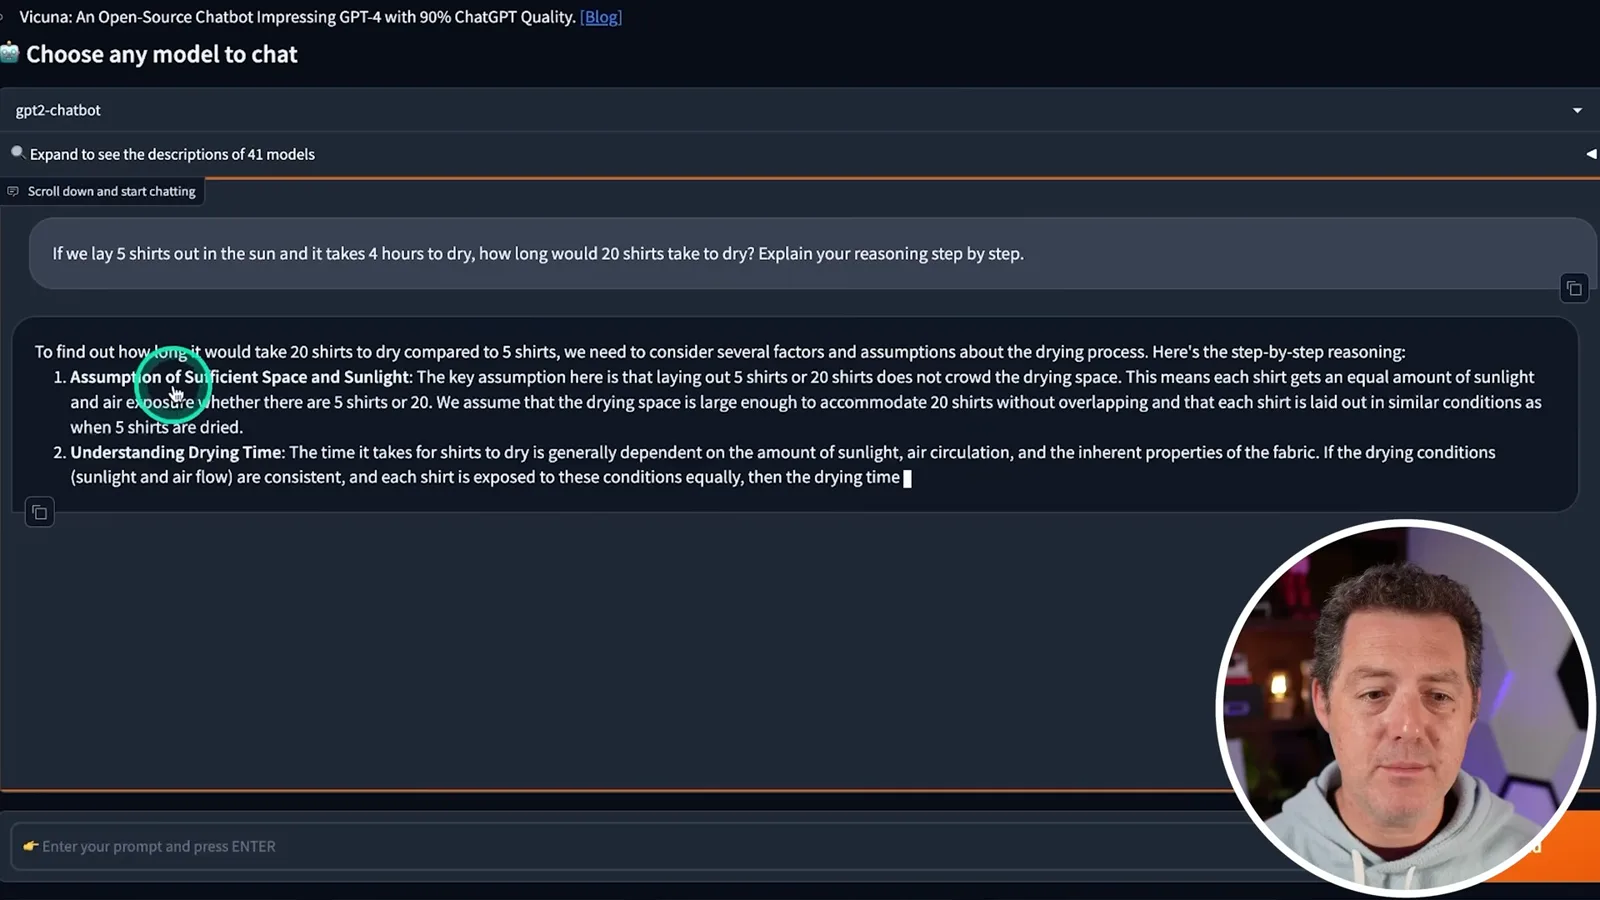
晾衬衫问题询问:五件衬衫需要四小时,二十件需要多久。模型先假设所有衬衫都有足够空间和相似条件,再回答四小时。Berman 称赞它明确说明假设并采用并行推理。
相对速度问题设定 Jane 比 Joe 快、Joe 比 Sam 快,询问 Sam 是否比 Jane 快。模型正确回答不是,并解释传递关系,尽管格式不够理想。Berman 认为回答比必要的更冗长。
算术与应用题
Berman 检查算术、酒店费用表达式和字数统计提示。
算术测试中,模型回答 4 + 4,并按运算顺序计算 25 - 4 × 2 + 3,得到 20。酒店应用题要求计算每晚 99.95 美元、加收 8% 税和一次性 5 美元免税费用的 x 晚总价;正确表达式是 1.08 × 99.95 × x + 5。
一个字数统计提示产生了十词回答,Berman 判定正确。他提到可能是运气或之前接触过类似问题,但单凭结果无法确定。速率限制也打断了这次非正式测试。
逻辑与物理推理
他测试计数谜题、杯子与弹珠问题,以及不同人的信念问题。
一道人数谜题中,房间里有三个杀人者,后来进入的人杀死其中一个。模型将新来者计入,回答仍有三个活着的杀人者,前提是新来者原本不在那三人中。Berman 为节省剩余速率额度,跳过了常规 JSON 提取测试。
更难的物理题将弹珠放在倒扣杯子下,再把杯子拿到微波炉中。模型错误地说弹珠留在杯里;通常情况下,拿起倒扣的杯子会让弹珠留在桌上。Berman 最初称赞了它的解释,但最终判定答案错误。
在信念追踪题中,John 把球放进盒子后离开,Mark 随后把球移到篮子里。模型正确区分了他们的想法:如果两人都没有观察到后续变化,John 认为球在盒子里,Mark 认为球在篮子里。
写作约束与编程挑战
模型处理句子和挖坑提示,然后生成经接入调整后通过的代码。
模型写出十个以 apple 结尾的句子。它还在挖坑问题中认识到,五十人未必能同时在一个小坑里高效工作。对少数工人的时间估计只是示例,因为题目没有提供足够信息计算精确时间。
最后,Berman 将 First Missing Positive 编程题粘贴给模型并测试答案。第一次遇到方法签名错误;他添加 self 以适配平台的类包装后,提交获得通过。他总结说自己印象深刻,但仍不知道模型的身份。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文