30 秒看懂
Matthew Berman 讨论了 Matt Shumer 关于 AI 潜在经济影响的文章,并结合自己使用编程工具的经历和 AI 实验室的案例展开分析。他认为个人应当尝试这项技术并为可能的冲击做好准备,但他预测的变化有多大、何时到来仍不确定。
- 1关于快速变化的警告Berman 借 Matt Shumer 的文章讨论,为什么 AI 行业以外的人可能低估变化的速度。
- 2编程的门槛降低他讲述自己如何用编程智能体自动化部分工作,并说 Shumer 也表示自己现在亲手写的代码少了很多。
- 3如何理解基准测试METR 图表按人类专家完成任务所需时间对任务分组,再观察模型是否成功。这并不能证明智能体可以在现实世界中独立运行任意项目那么长的时间。
- 4智能体构建编译器Anthropic 报告了一项多智能体构建 C 编译器的实验;团队提供的基础设施、测试和指导,是理解结果时不可忽视的条件。
- 5采用程度参差不齐Berman 引用一张麦肯锡图表:在受访的 AI 使用组织中,7% 已在整个企业全面扩展 AI 应用。这一范围比所有企业要窄。
要点建议
- Berman 根据自己的经历认为,新近出现的编程智能体显著改变了非专业人士能够构建的东西。
- METR 的任务时长基准按人类完成选定任务所需时间衡量模型表现,并不直接代表智能体连续自主运行的时间。
- Anthropic 的 C 编译器等项目展示了在人工设计的测试和监督下智能体的能力,并不能证明所有编程工作都已实现自动化。
- 大范围就业替代的预测存在不确定性,企业采用 AI 的深度也有很大差异。
- Berman 建议尝试与工作相关的工具、保持财务弹性并培养判断力,为变化做好准备。
按章节阅读整理后的全文
为什么这篇文章引起共鸣
Berman 介绍 Shumer 将当前形势与大众广泛行动之前的危机早期进行比较。他把这篇文章视为警告,而非确定的预测。
Matt Shumer 写了一篇题为《Something Big Is Happening》的文章,我认为其中的信息值得关注。他把当下比作疫情初期:一些人已经担忧,许多人却尚未改变行为。这种类比讨论的是认知,并不能证明两件事会以相同方式发展。
文章认为 AI 正在迅速进步,而许多人仍按工作将基本保持原样的假设做计划。少数公司和决策者对这些系统的开发与部署有着巨大影响。我想解释为什么我认为文章中的警告值得认真考虑。
编程方式的变化
个人经历展示了语言模型和智能体如何改变 Berman 与 Shumer 的编程方式。Berman 认为影响可能超出软件领域。
Shumer 描述了自己的编程工作发生的变化:过去需要亲手写代码的任务,现在可以交给智能体,他负责解释目标并检查结果。这只是一个人的经历,但我在自己的工作中也感受到了这种变化。
我用 AI 工具构建和自动化视频工作流程的一些环节。我可以描述一个应用、检查结果,再不断提出修改要求。这个过程仍然需要我知道自己想要什么、发现错误,并判断结果是否真的有效。
它与自动补全工具的区别在于,智能体在需要下一条指令之前能够尝试完成更多工作。它可以探索文件、修改内容、运行命令并反复迭代。但它并非不会出错,表现取决于任务、可用工具和监督方式。
我鼓励大家在自己领域的真实问题上尝试当前工具,而不是只凭过去的印象判断。我认为付费模型有助于了解最强产品的能力,不过学习和评估工具是否适合自己的工作,并不以订阅为前提。
近期进步的速度使我们很难根据某个较早的演示来推断未来。同时,一场令人印象深刻的演示,也不能证明某个职业的所有任务都能由智能体可靠且经济地完成。
基准测试与智能体项目
Berman 介绍 METR 的任务时长图表、Anthropic 的编译器实验和其他智能体案例。从这些案例推断未来时,必须考虑其条件和局限。
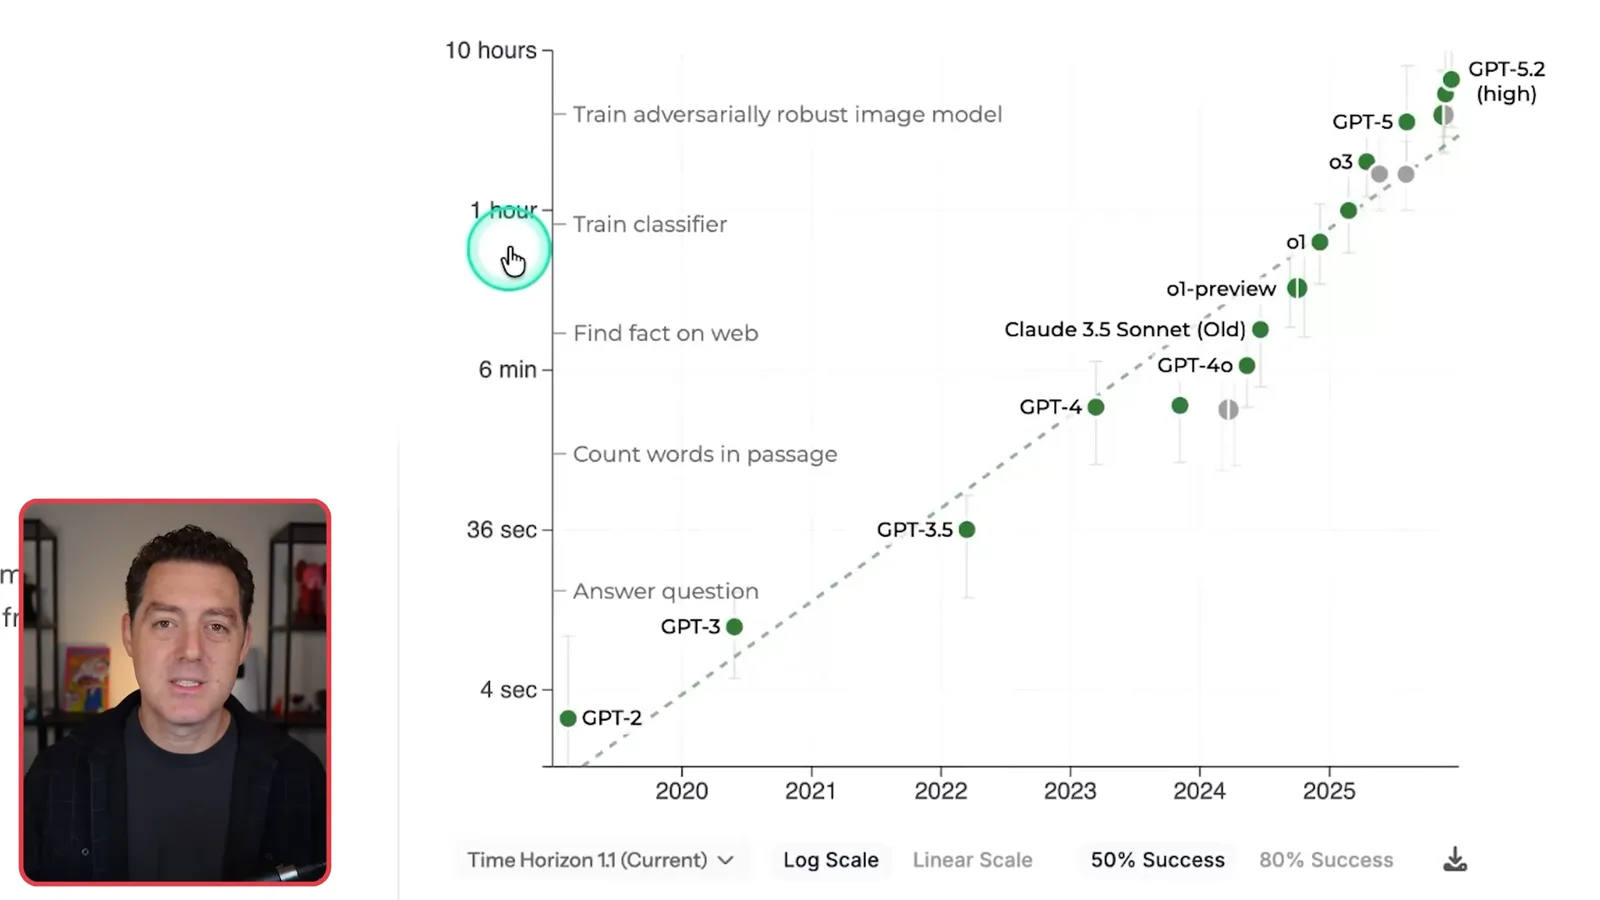
METR 的图表考察 AI 在不同任务上的表现,并按人类专家完成这些任务所需的时间分组。其 50% 任务时长估计的是模型在基准测试中有一半概率成功时对应的人类任务时长。这是特定任务集上的测量,并非显示智能体能自主运行任意工作的时钟。
Anthropic 介绍了一个使用多个智能体构建 C 编译器的项目,历时约两周,报告的 API 成本约为 2 万美元。研究人员设计了智能体使用的环境、测试和反馈。这个实验展示了特定条件下的重要成果,但并不意味着模型独立取代了一个软件团队。
我还讨论了 Cursor 的浏览器构建实验:智能体生成了大型代码库,并做出了一定程度上可运行的产品。代码行数并不能很好地代表实用性或质量,但这些例子说明了编程智能体为何受到关注。
OpenAI 表示,GPT-5.3-Codex 的早期版本协助了与其自身开发和调试有关的工作。我认为这是 AI 参与 AI 研究的一个例子,但它并不等于证明模型能够在无人监督的自我维持循环中独立改进自己。
工作会发生什么变化?
他讨论了有关就业冲击的预测和人类判断的作用。这些是可能情景和观点,并非已经确定的结果。
Shumer 和其他 AI 领袖警告,快速进步可能冲击白领就业。这些警告是预测,并不是对多少工作会消失、何时消失的定论。影响取决于可靠性、成本、监管、组织以及人们的选择。
一份工作由一系列任务、人际关系和责任构成。某个环节实现自动化可能改变其他部分,却未必消除整个岗位;与此同时,一些组织在某些工作上可能需要更少的人。我认为重大冲击的可能性足够严肃,值得提前考虑。
当系统能生成看似合理、却仍需检查的成果时,人的判断尤其重要。理解问题、设定目标、评估后果并对结果负责,与仅仅因为答案听起来很自信就接受它,是不同的事情。
为不确定性做准备
Berman 建议尝试工具、评估 AI 输出,并考虑财务弹性与教育问题。他最后建议保持适应能力。
我给出的第一条实际建议是亲自尝试。选一项你熟悉的任务,请 AI 工具帮忙,再将结果与你自己的做法比较。这样更容易发现它的实际能力,以及精美演示可能掩盖的错误。
学习如何提供背景信息并评估输出。不了解服务如何处理敏感信息时,不要随意输入;遇到高风险问题,也不要把模型的回答当作独立审查的替代品。
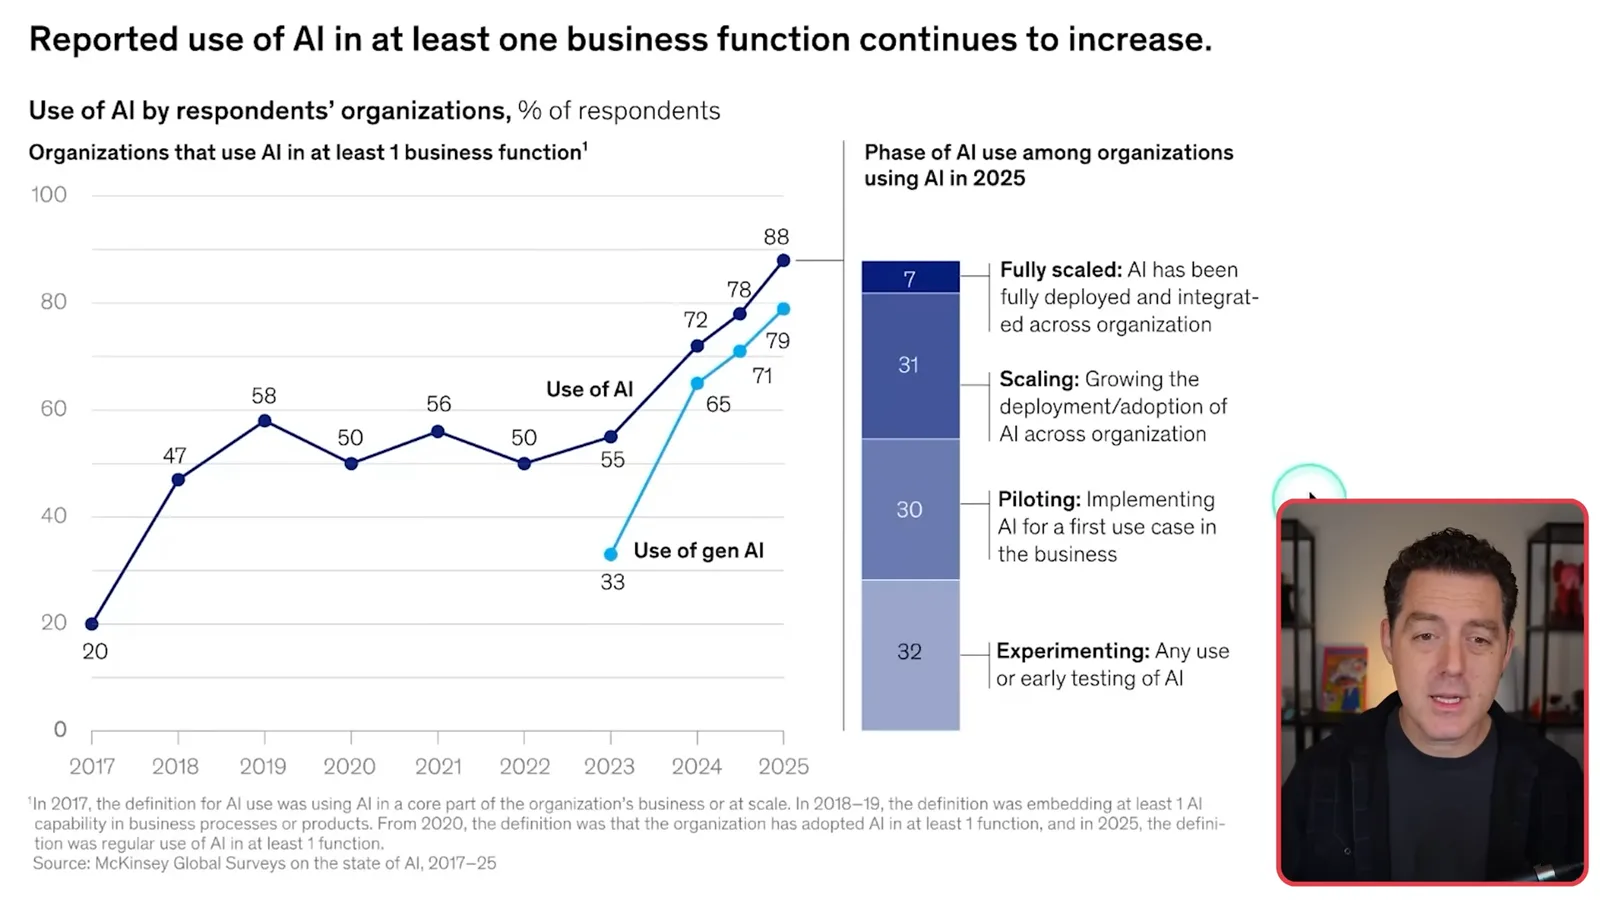
我讨论的一张麦肯锡图表显示,在使用 AI 的受访组织中,7% 已在整个企业全面扩展 AI 应用。这个数字针对的是一部分调查对象,并非所有公司。它表明,即便人们报告正在使用 AI,组织范围的部署也可能落后于试验。
我还建议考虑财务弹性,不要假定当前的就业环境会一直不变。每个人的处境不同,合适的做法要看各自的资源、责任和风险承受能力。
对于家庭来说,问题是如何帮助孩子使用新工具,同时保持独立思考、学习和行动的能力。基础知识与好奇心仍然重要:使用者能判断结果是否合理,工具才更有价值。
我看到风险,也看到机会。个人或小团队也许能够尝试以前需要更多资源才能实现的想法和产品。机会并不保证成功,但这也是通过动手制作具体东西来学习的理由。
关键并不是任何人都能准确预测时间表,而是等到一切完全确定后再行动,可能会让人准备不足。试用自己能够获得的工具,保持判断力,并随着证据变化调整做法。
如果你负担得起付费服务,我认为尝试一下可能值得;免费选项和共享资源同样可以作为起点。目标是通过实践了解这项技术及其局限。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文