30 秒看懂
Matthew Berman 介绍了一套定制的 OpenClaw 配置,将团队邮件、CRM、会议、知识库和内容流程连接起来。他解释了人工审核、不同版本的提示词、分层安全、定时任务、用量日志和恢复方案,并讨论实验性的健康和语音记忆工作流。这些是他在 2026 年 2 月的做法和说法,并不保证安全、可靠或符合当前订阅使用条件;本视频由 HubSpot 赞助。
- 1带审核的赞助邮箱来信按照评分规则打分、研究并生成草稿;低置信度和重要情况交由人处理。
- 2相互连接的流程邮件、CRM 阶段、标签、嵌入和草稿组成一个工作流,Berman 称其是逐步构建的。
- 3为不同模型维护提示他为每种模型维护指令文件,并每晚检查漂移,让共同的操作事实保持一致。
- 4CRM 与会议智能邮件和日历联系人、文稿及行动项连接到 CRM;拟议任务会经过审批队列。
- 5分层安全他介绍网关控制、访问规则、扫描、脱敏和审查,任何一项都无法保证不可信内容安全。
- 6可观测性与恢复系统跟踪模型使用和错误、批量发送通知,并加密备份和记录恢复流程。
- 7实验性个人工作流团队成员将健康数据和录音笔记与助手结合;敏感数据和他人录音需要适当保护和同意。
要点建议
- 赞助邮箱对邮件分类、研究发件人并起草回复,将不确定或重要的情况提交人工审核。
- CRM、会议流程和知识库共享上下文,但结合敏感来源会使访问控制和同意更加重要。
- Berman 为不同模型维护提示文件并检查漂移,同时按主题和优先级组织记忆与通知。
- 过滤、模型扫描、沙箱和脱敏是防御层,并不能证明提示注入或数据泄露不可能发生。
- 用量跟踪、定时任务、日志、加密备份和恢复测试支持系统运行,但自动化和生成的修复仍需监督。
- 他对订阅认证的描述属于历史说法;实施前应核实服务商当前条款和支持的认证方式。
按章节阅读整理后的全文
将赞助邮件变成智能体工作流
Berman 演示分流、研究、评分和人工审核回复。视频由 HubSpot 赞助。
每天高强度使用 OpenClaw 一个月后,Matthew Berman 介绍了一个他称为全职团队成员的定制系统。他将智能体连接到邮件、CRM、会议和其他服务。视频由 HubSpot 赞助,HubSpot 也是其工作流的一部分。
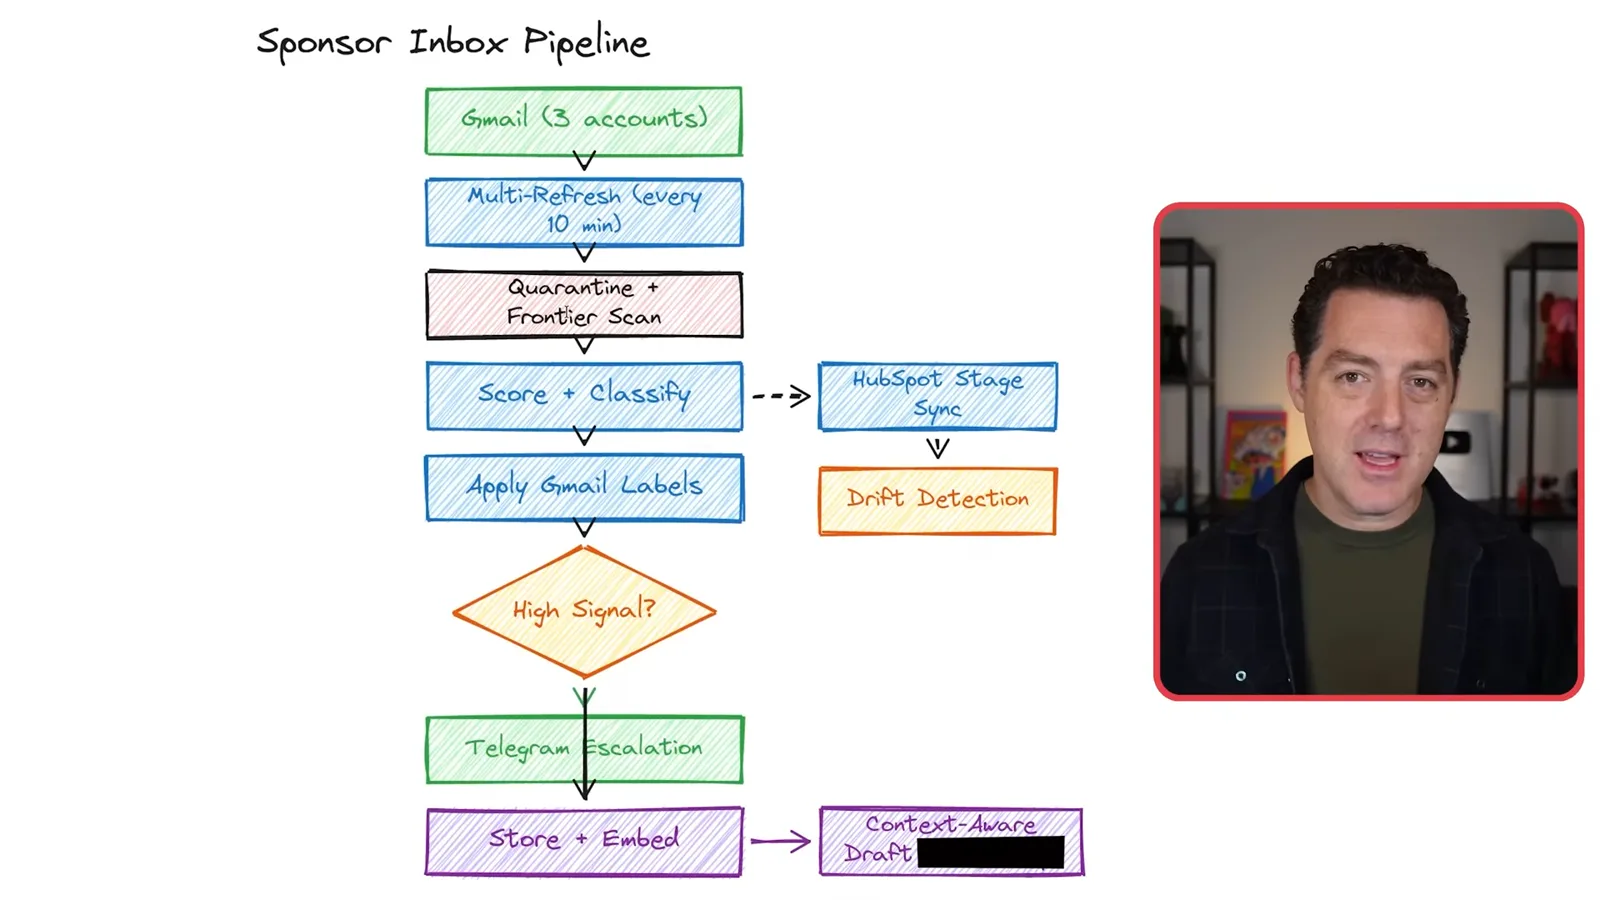
对于赞助咨询,他建立了独立的工作区身份,并将公开的群组邮箱路由给智能体。一封虚构样例邮件展示了系统如何分类咨询、研究发件人并依据评分规则打分。示例中,发件人信息相互矛盾,导致置信度低,系统通过 Telegram 请求审核。
Berman 可以批准或纠正分类。他说评分规则经过几天反馈逐步完善,考虑契合度、预算、清晰度、可信度和成交可能性等因素。高价值机会交给团队,其他类别则采取不同的后续处理。
系统会结合上下文起草回复,而不是只依靠模板。在示例中,Berman 本人审核草稿并点击发送。他的总体目标是逐步增加自动化,同时将重要或不确定的决策升级交人处理。
邮箱流程与提示版本
他概述邮件流程,为不同模型维护独立指令并检查漂移。
邮箱流程每十分钟刷新账户,隔离传入材料,在分类前先做确定性扫描,再做基于模型的扫描。它检查历史通信、更新 CRM 阶段和标签、存储并嵌入邮件,然后准备草稿。他承认第一层过滤并不完美;两层扫描都不能证明不可信内容无害。
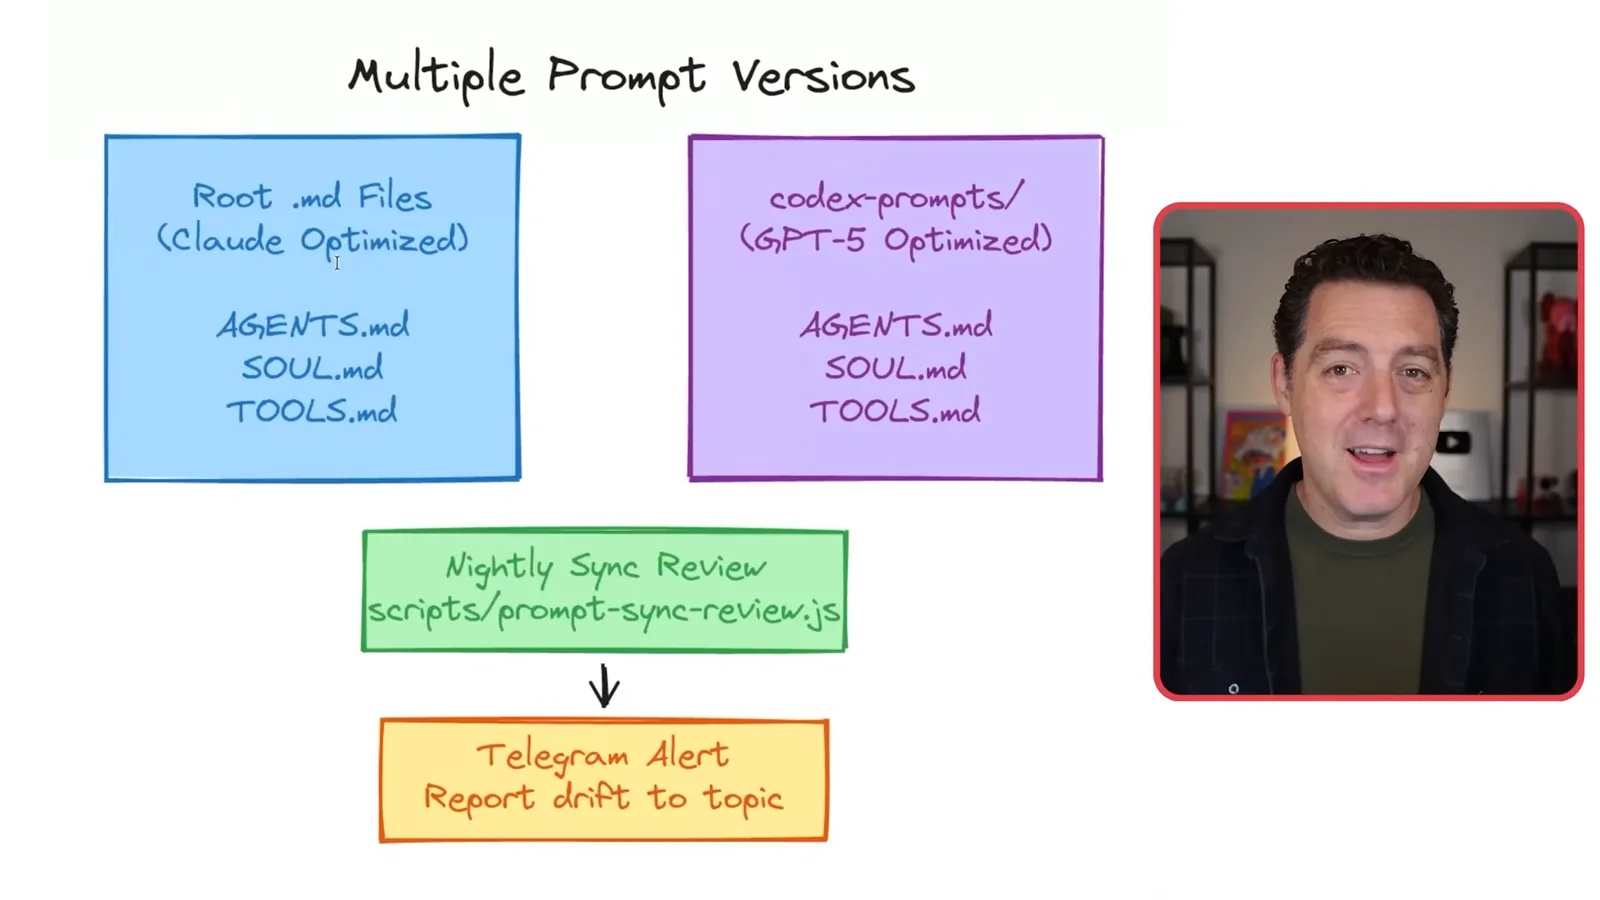
Berman 为不同模型维护独立版本的指令文件,因为他认为它们的提示偏好不同。每晚的检查比较操作事实并报告漂移。他的实际目标是在切换模型时避免规则悄然改变或丢失重要上下文;具体提示建议反映的是他当时的经验。
文件、主题、CRM 与会议
操作文件和独立对话主题支持 CRM 和会议行动项流程。
他将操作规则、身份、用户上下文、工具、心跳和记忆分别放在不同用途的文件中。产品需求、安全实践和技能等其他参考资料按需加载。他尽量避免跨文件重复事实,让每项更新都有明确的位置。
Telegram 群组主题将 CRM、知识、定时更新和研究等工作分成不同上下文。Berman 觉得这样更容易浏览对话,也减少每个线程需要携带的无关内容。这是一种工作流选择,并不保证记忆永久可靠。
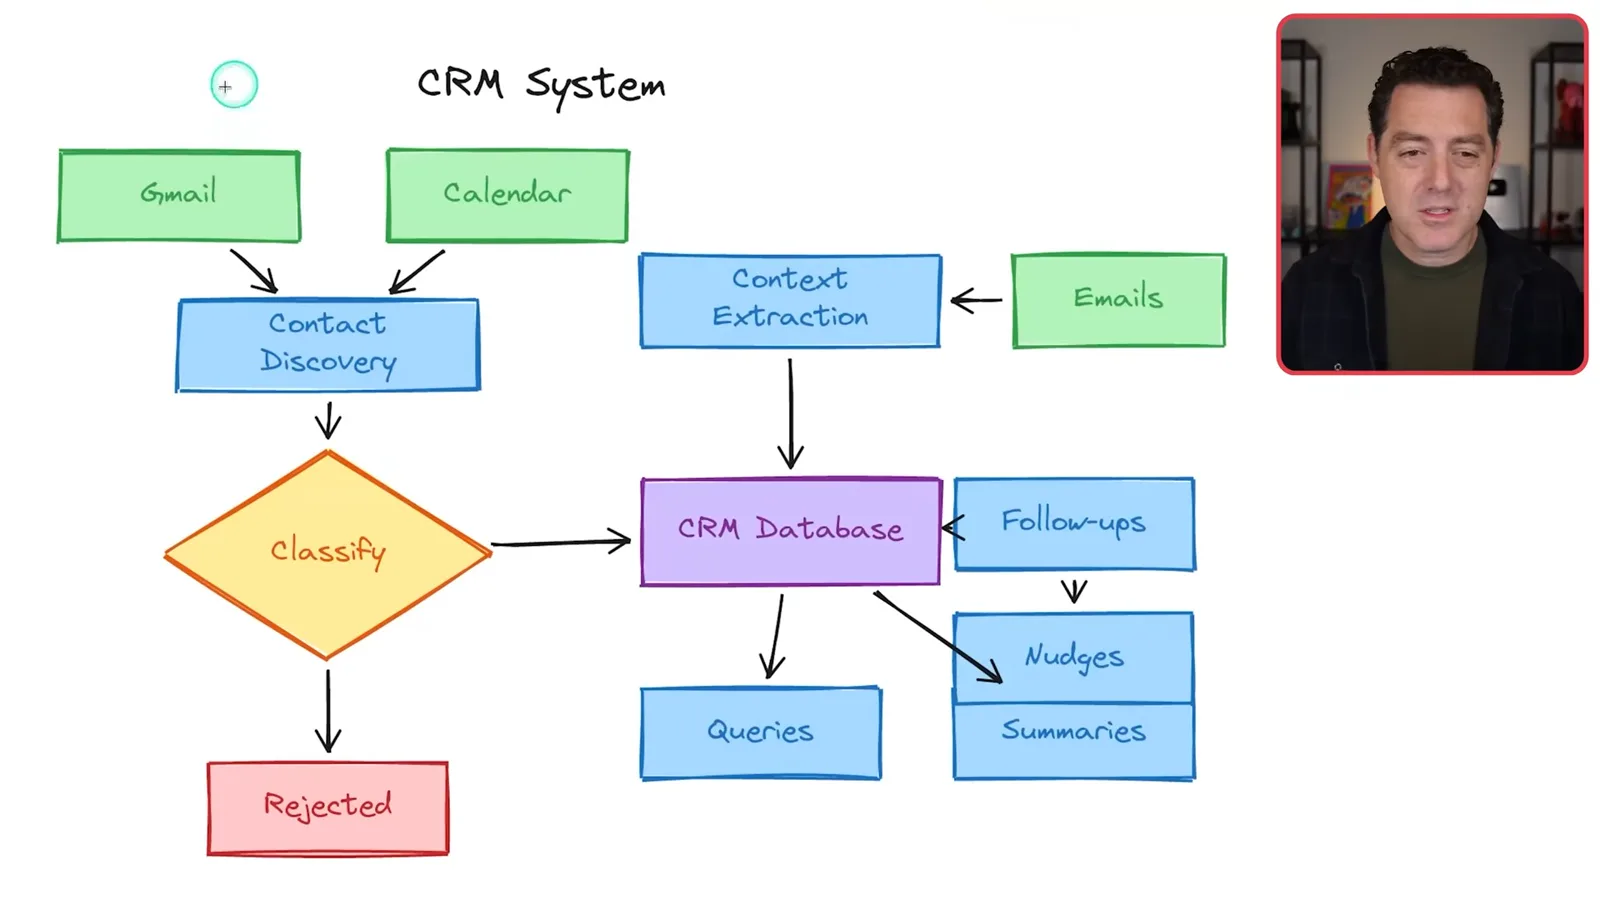
CRM 从邮件和日历中发现联系人,过滤不需要的条目并保存关系上下文。它可以研究公司、检索过去的对话,并回答哪些人最近未联系等问题。Berman 重视 CRM、赞助流程与知识库之间的连接。
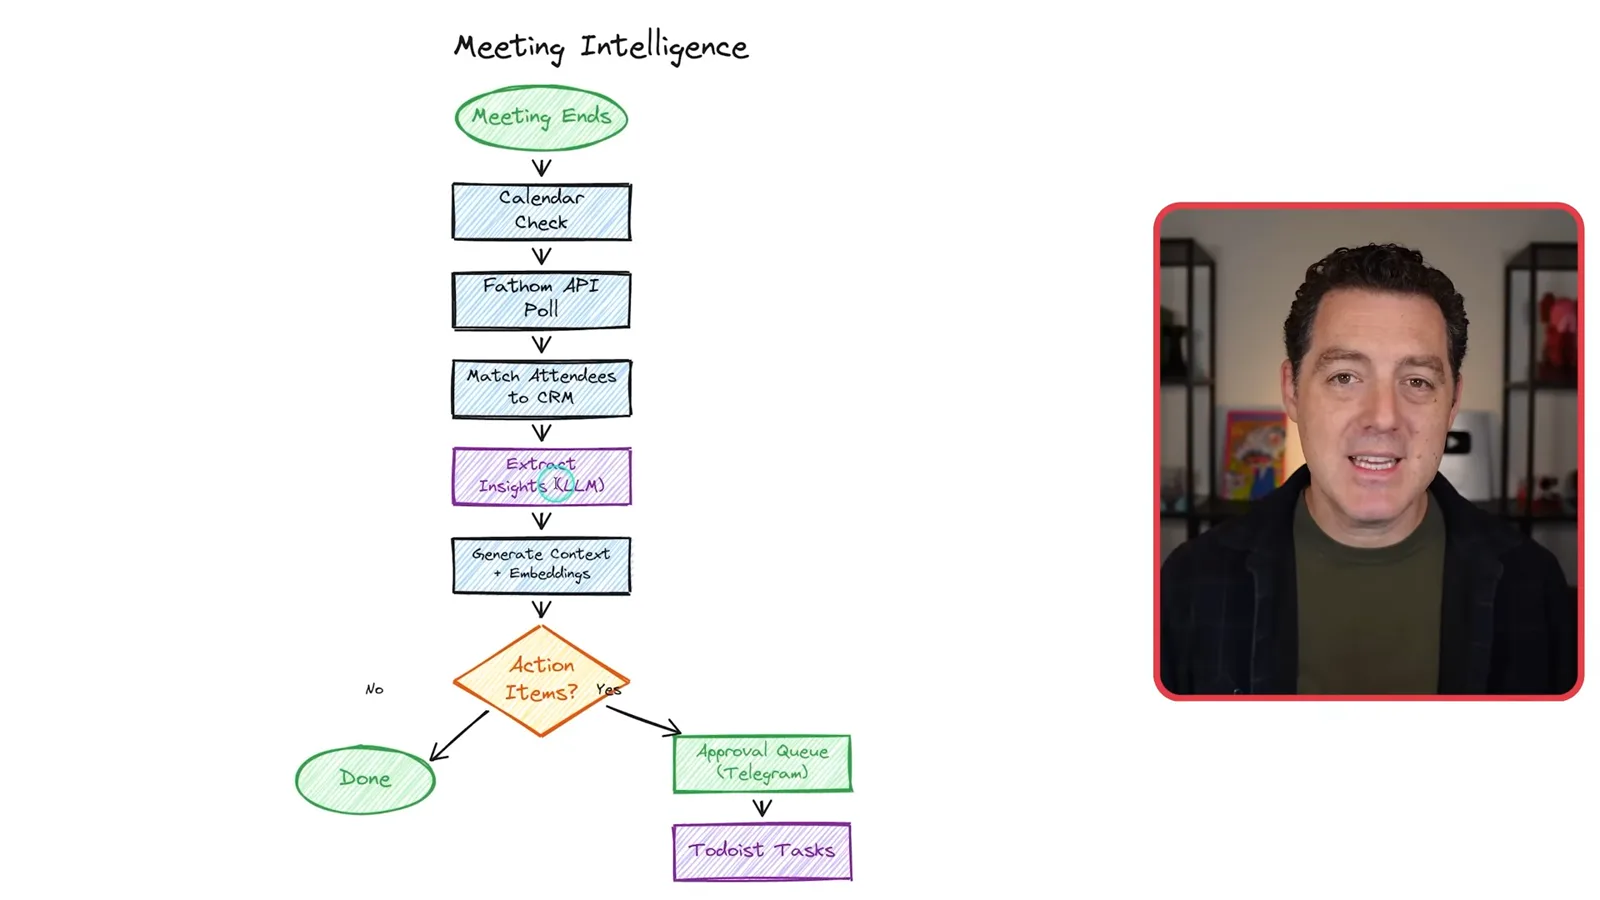
会议结束后,笔记服务提供文稿。流程将参与者与 CRM 记录匹配,提取见解和拟议行动项,并在本地生成嵌入。Berman 表示,拟议任务先发送到 Telegram 供他批准,再进入任务管理;交易和负责人信息也会关联到 CRM。
知识、内容与安全
知识库支持研究与内容规划;Berman 描述如何分层处理不可信材料和敏感数据。
知识库接收通过 Telegram 或 Slack 分享的文章、视频和帖子。内容经过获取、筛查、分块、嵌入和存储,供语义搜索;相关材料可以关联联系人或分享给团队。自动扫描后,外部材料仍然不可信,分享时也需要注意访问权限和保密性。
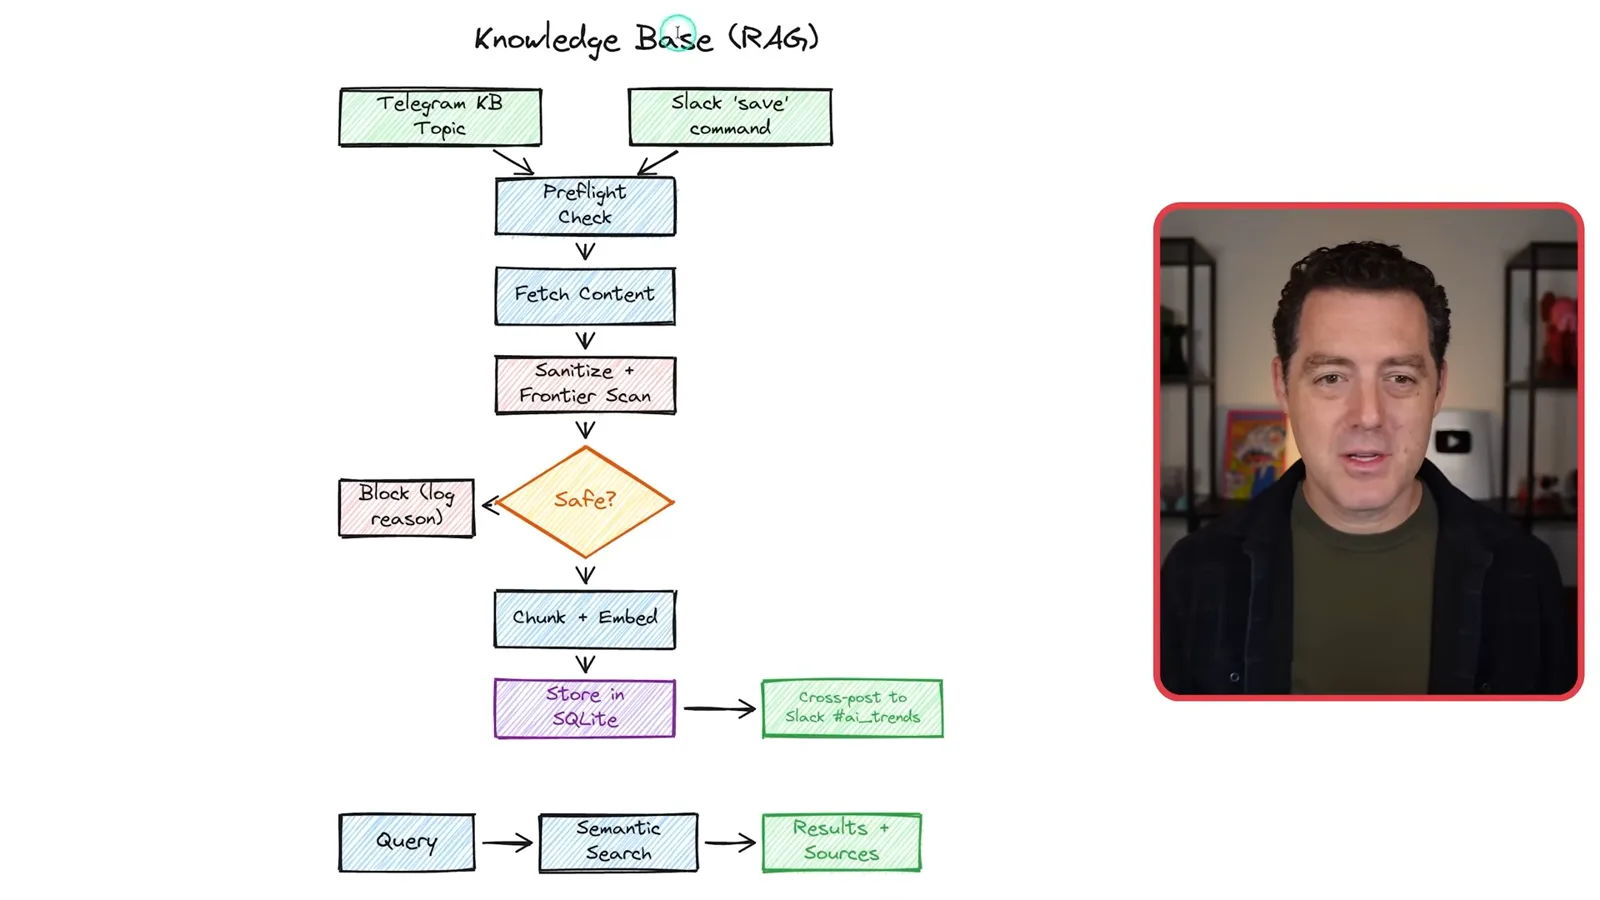
在内容规划中,Berman 将一段讨论标记为潜在视频创意。智能体阅读线程、搜索知识库和网络、创建项目卡片,并起草包含参考资料和包装创意的大纲。完成消息会发回团队;大纲是否有用仍取决于来源核查和编辑审阅。
安全是核心问题,因为智能体读取外部消息并能访问内部工具。Berman 描述了经过认证的网关访问、按频道区分的政策和分层提示注入处理:确定性过滤、隔离环境中的模型扫描及风险标记。过滤器和 AI 审查者可能漏掉攻击或出错;隔离和最小权限仍然重要。
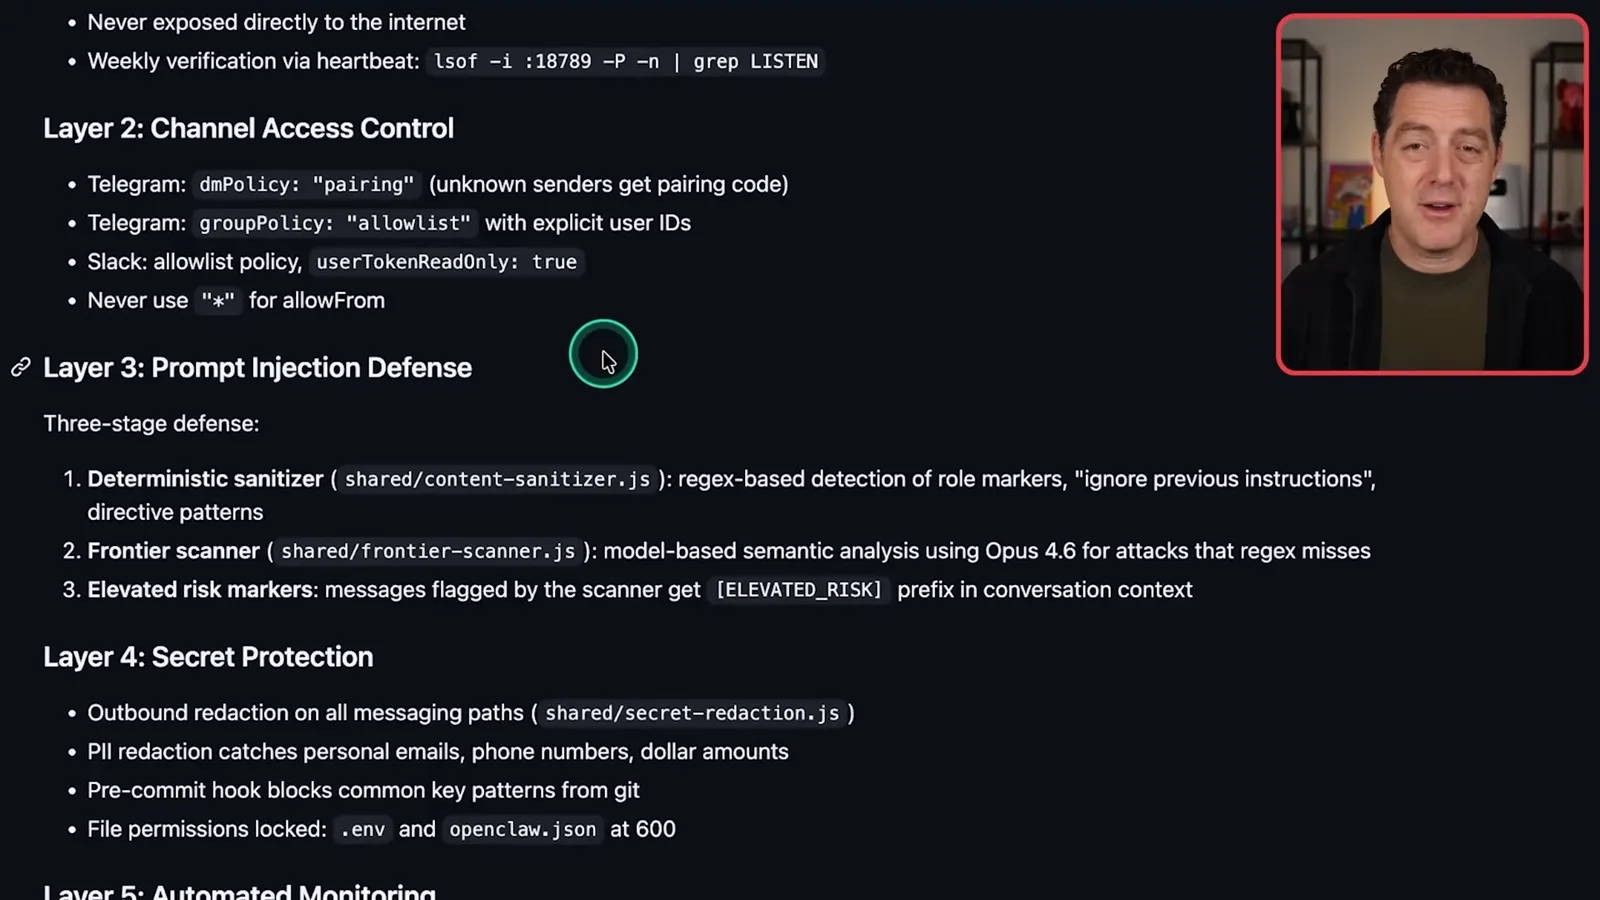
他还对外发内容中的秘密和个人信息脱敏、在提交前检查密钥模式、限制文件权限,并运行自动安全和健康审查。他也介绍了加密数据库和备份、访问分级,以及针对常见网络和数据库风险的防护。这些是他报告的措施,并非独立安全审计。
调度、记忆与通知
他错开定时任务、监视上下文使用量,并按紧急程度批量发送提醒。
定时任务收集社交数据、更新 CRM、检查配置和安全、轮转日志并准备简报。Berman 将较重的任务错开放在夜间,以适应使用限制并避免与白天工作争抢资源。他分享的是自己的日程示例,并非普遍适用的频率。
在记忆方面,Berman 表示默认系统对他效果很好。他将 Telegram 主题分开,用状态命令检查上下文窗口,并在上下文过满时清理或让消息过期。定时审查会精简每次调用时加载的文件中的重复和漂移。
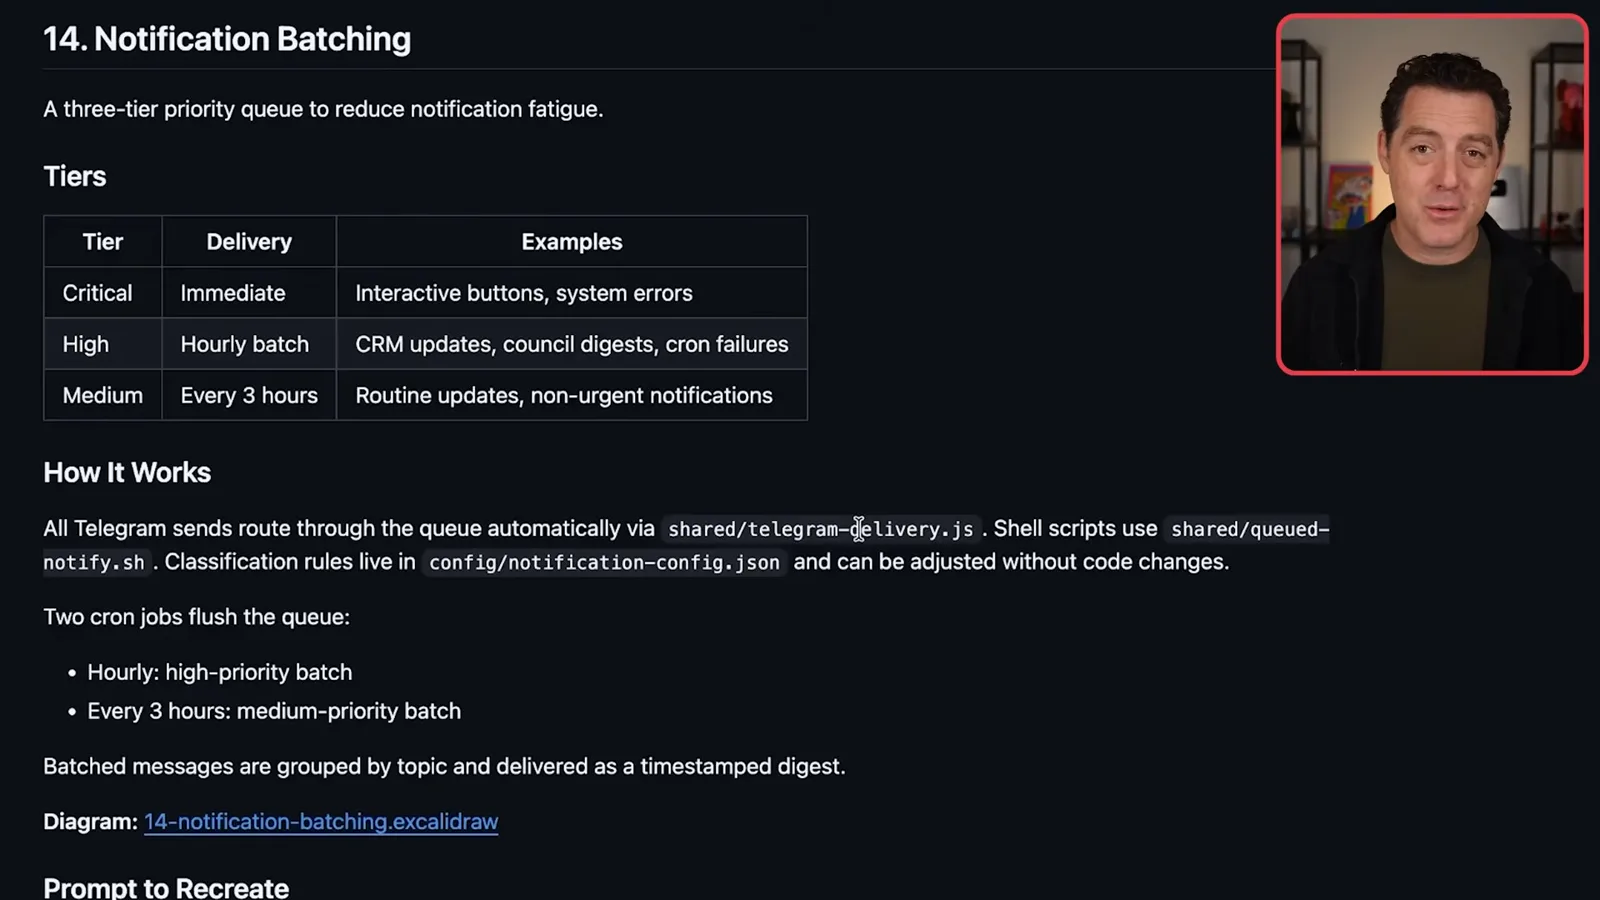
为了减少通知疲劳,他按优先级批量发送 Telegram 消息:关键事项立即发送,高优先级更新每小时一次,常规事项每三小时一次。通知数据库记录这些消息。合适的频率取决于用户需要看到什么及其紧急程度。
新的财务工作流将 QuickBooks 导出的交易记录导入数据库,供自然语言查询,并用规则限制财务细节可以分享的位置。另一个路由器将模型调用记录到 JSONL 和数据库,供用量仪表盘、失败监控和成本估算使用。Berman 指出,订阅方式使美元估算不够精确。
成本、日志与数据隔离
用量日志和错误审查支持运行;他介绍认证配置和分离工作与个人数据的规则。
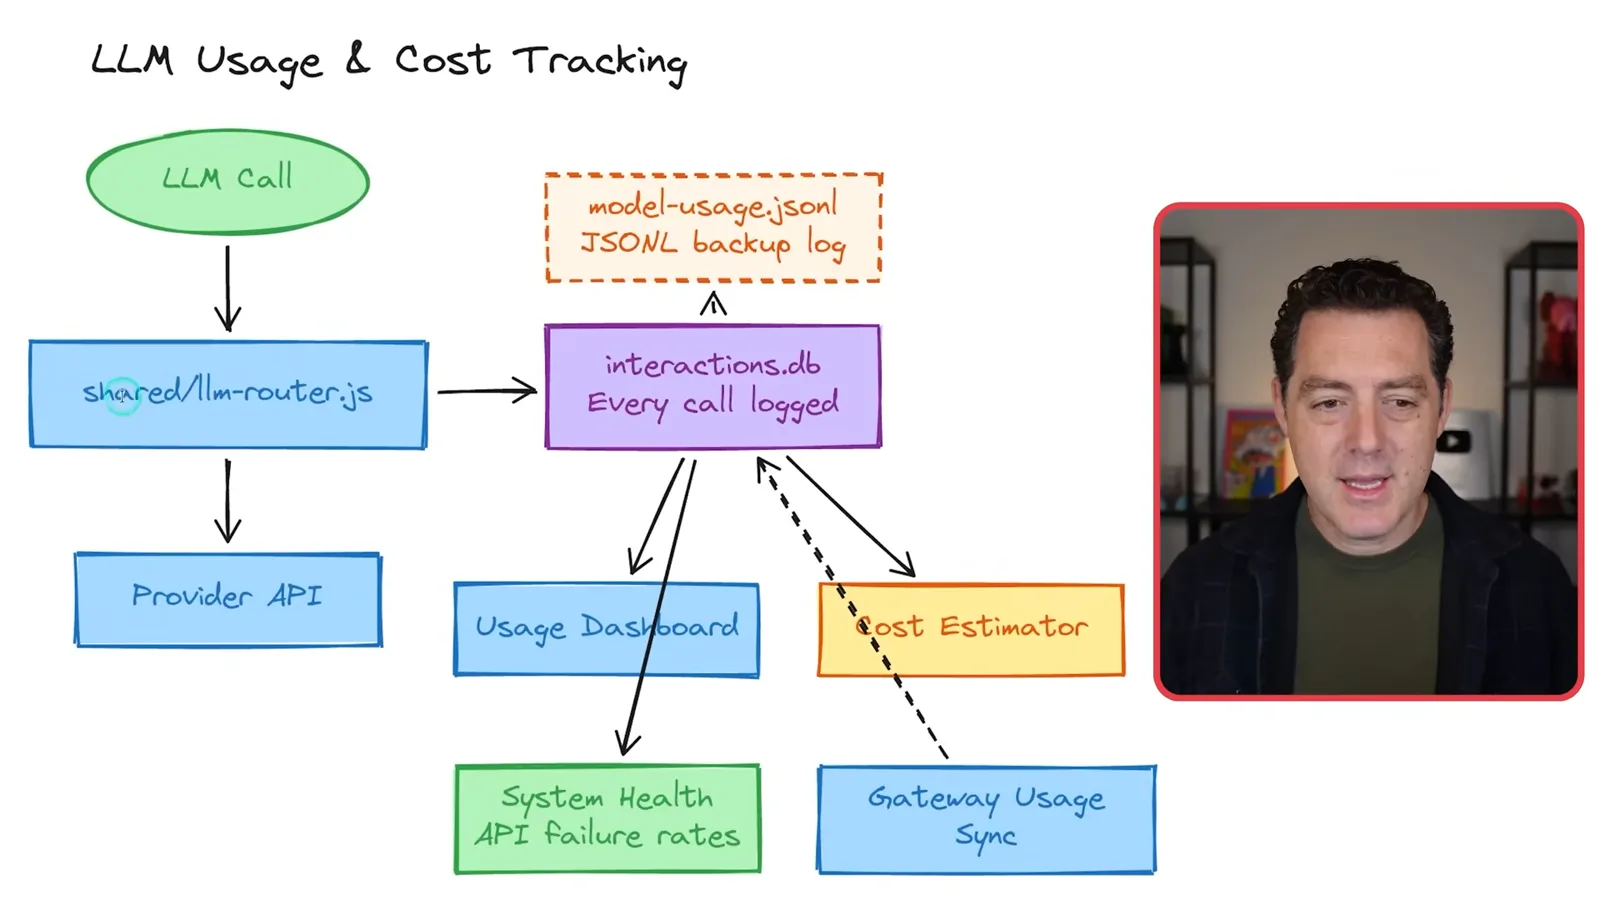
他主张结构化记录错误和服务调用,以便智能体第二天早上检查问题。他要求它提出或实施修复,并轮转日志以控制大小。日志本身可能包含敏感信息,自动修复也需要适当的审查和测试。
Berman 描述了 2026 年 2 月涉及 Anthropic agent SDK 和其订阅的一次认证变更,称它在自己的配置中有效。这是历史性的个人经验,并不证明该方法目前受到支持或被允许。用户需要检查服务商当前条款和有文档说明的认证方式。
一个实例同时服务工作和个人场景,因此他定义了数据分级和频道限制。财务细节和个人邮件只用于私信;内部笔记留在团队内,对外分享需要批准。Berman 承认,规则和确定性检查仍可能存在漏洞或失效。
改进、备份与个人用途
他回顾自动检查、成本控制、加密备份、健康跟踪和可穿戴设备记录。
他在文件中记录反复出现的错误、经验和功能请求,并自动审查平台健康、安全、提示一致性和数据完整性。一个创新侦察流程寻找其他用途。这些流程有助于发现候选改进,但不能被误认为正确性的独立保证。
他的成本控制措施包括本地生成嵌入、选择不同模型档位、错开定时任务、提示缓存、根据上下文轮询以及批量通知。他强调,即使单次调用便宜,规模化后也会累积,因此用量视图有助于发现工作集中在哪里。
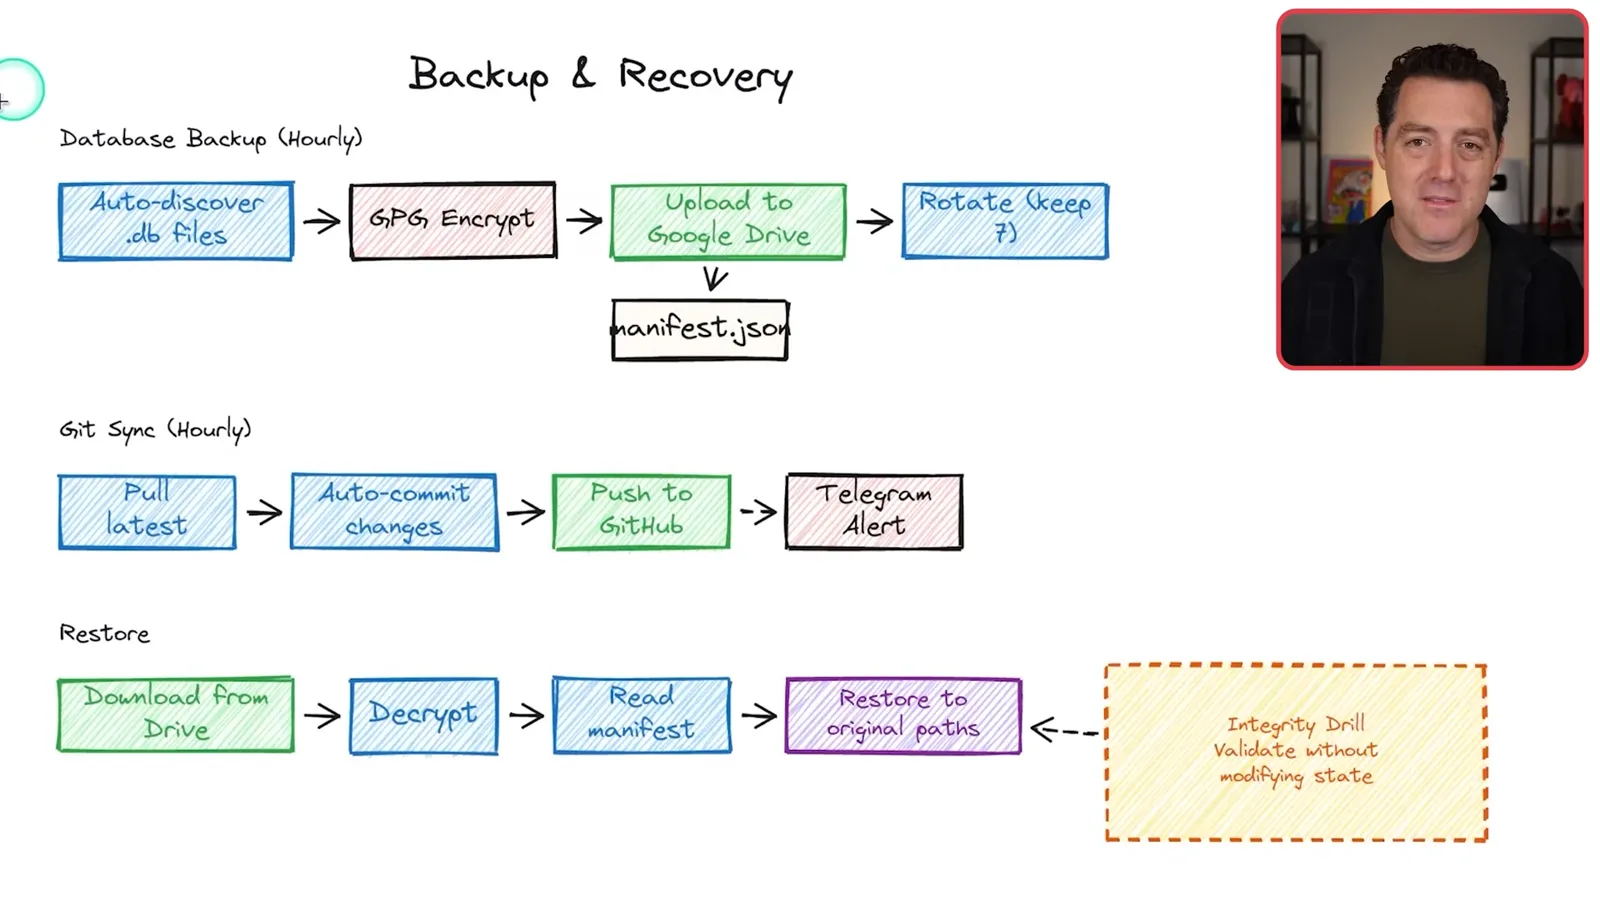
在恢复方面,他描述了发现数据库文件、加密、上传至 Google Drive 并轮转备份的过程。独立的 Git 同步保存代码变更,文档化的恢复流程则利用备份清单并解密。只有实际测试完整性和恢复流程,备份才真正有用。
一位团队成员尝试导入可穿戴设备和健康数据,以生成摘要并标记趋势。Berman 还介绍了一个可穿戴笔记系统,将语音衍生的记忆保存下来供私下查询。健康输出不是临床诊断,录制对话或存储敏感数据需要取得同意并采取适当的隐私保护。
Berman 希望与助手进行更自然的双向语音对话,但尚未确定解决方案。他最后表示,系统仍在实验中不断演进,而对他而言最大的价值是连接团队各个工作流程。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文