30 秒看懂
Matthew Berman 介绍 TypeSafe 的 Jev:一个为快速结构化决策设计的模型,并回顾从客服工单分类到模拟角色和游戏的演示。他强调宣称的速度和低成本,同时指出它并非通用聊天或编程模型。视频中的零幻觉说法不应被理解为决策正确的保证;模拟驾驶演示也不能证明真实道路上的安全性。
- 1不同的输出方式TypeSafe 介绍了 RLCD,即用于校准决策的强化学习,并将 Jev 定位为结构化决策工具,而非通用聊天工具。
- 2快速交互演示视频展示游戏控制和浏览器导航竞赛,但速度取决于设置,也不能证明广泛任务上的准确性。
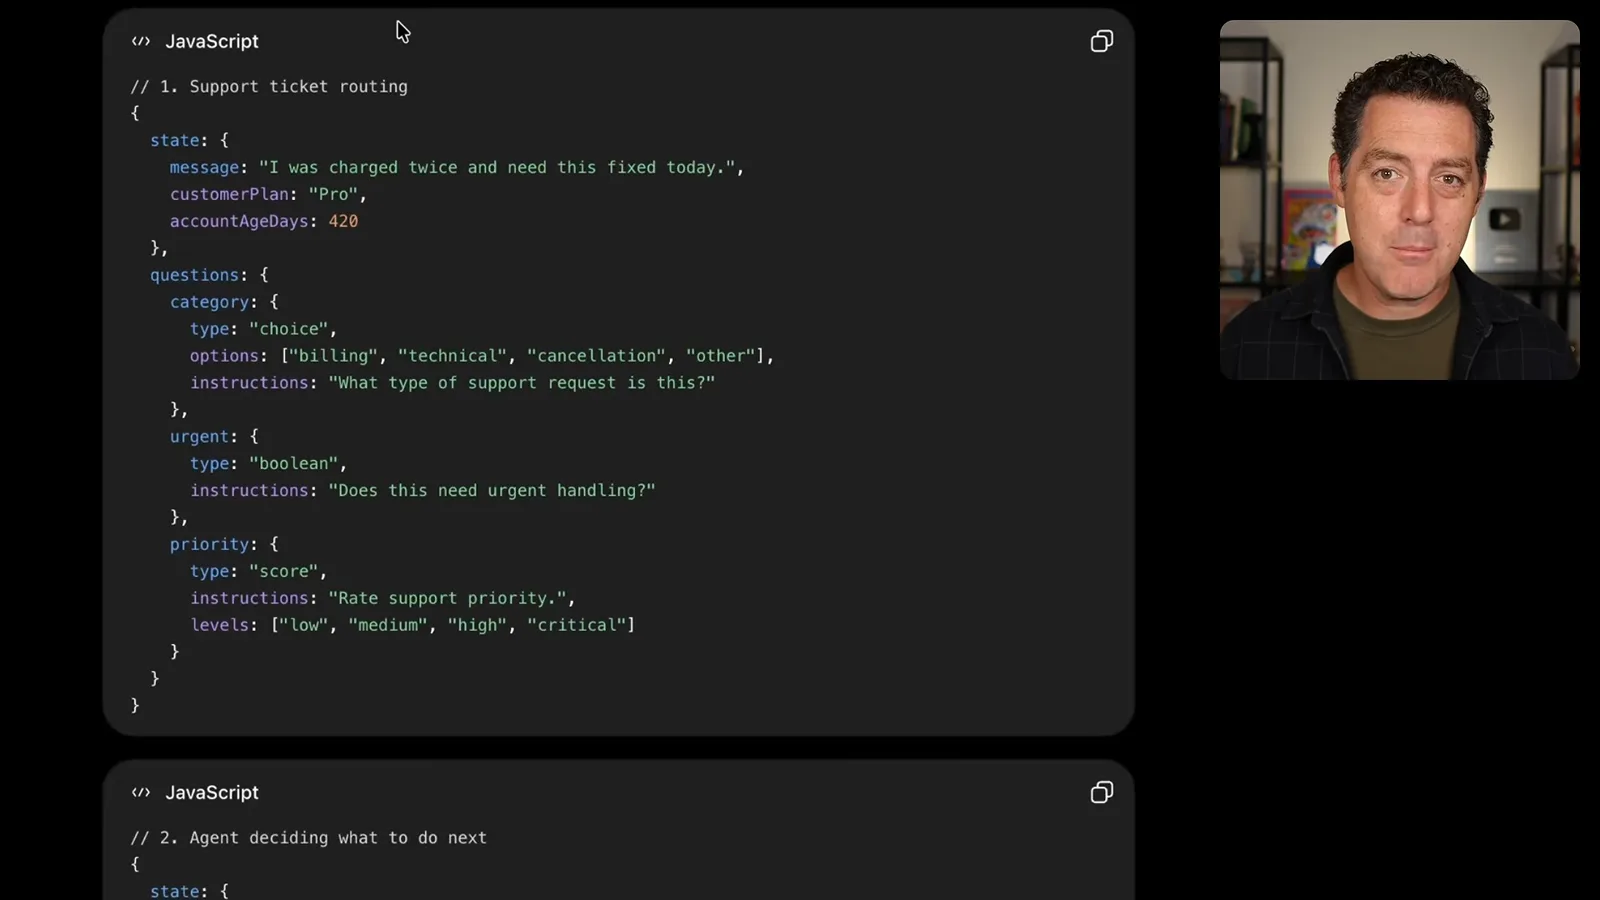
- 3工单路由一个示例根据输入状态和预定义输出类型,对客服请求类别、紧急程度和优先级进行判断。
- 4可靠性需要评估Berman 重复了零幻觉的说法。结构化回答仍可能出错,因此高风险用途需要针对任务的验证和监督。
- 5模拟小镇Berman 展示 50 个角色对广播作出反应,演示中不到一秒就返回了决策。
- 6国际象棋与其他演示计时棋局说明,即使棋面较弱,快速回应也可能影响结果。后续例子包括路由和模拟驾驶。
要点建议
- Jev 被介绍为返回结构化选择或分数的决策模型,而不是通用对话模型。
- 速度和成本比较取决于任务、设置、并发及定价条款;视频中的倍数是产品声明。
- 即使避免了自由文本中的编造,受限的输出格式也不能防止错误分类或决策。
- 示例包括工单路由、模拟智能体、模型路由、国际象棋和游戏;这些演示不是独立可靠性测试。
- 驾驶示例是模拟,不能证明自主驾驶系统已通过验证。
按章节阅读整理后的全文
Jev 简介
Berman 介绍这个决策模型以及开发者对速度、成本和训练的声明。
Matthew Berman 介绍 TypeSafe 的面向决策的 AI 模型 Jev。他对发布演示中展示的速度印象深刻,认为它以通用聊天和编程能力换取快速结构化决策。他引用的速度和价格倍数是发布时的声明,并非普遍适用的测量结果。
公司将其训练方法称为用于校准决策的强化学习,简称 RLCD。Berman 将面向决策的输出与对话模型作比较,介绍了回应速度最高快 200 倍、成本更低等声明,以及 2026 年 9 月所展示的免费输出 token 方案。价格和限制可能变化。
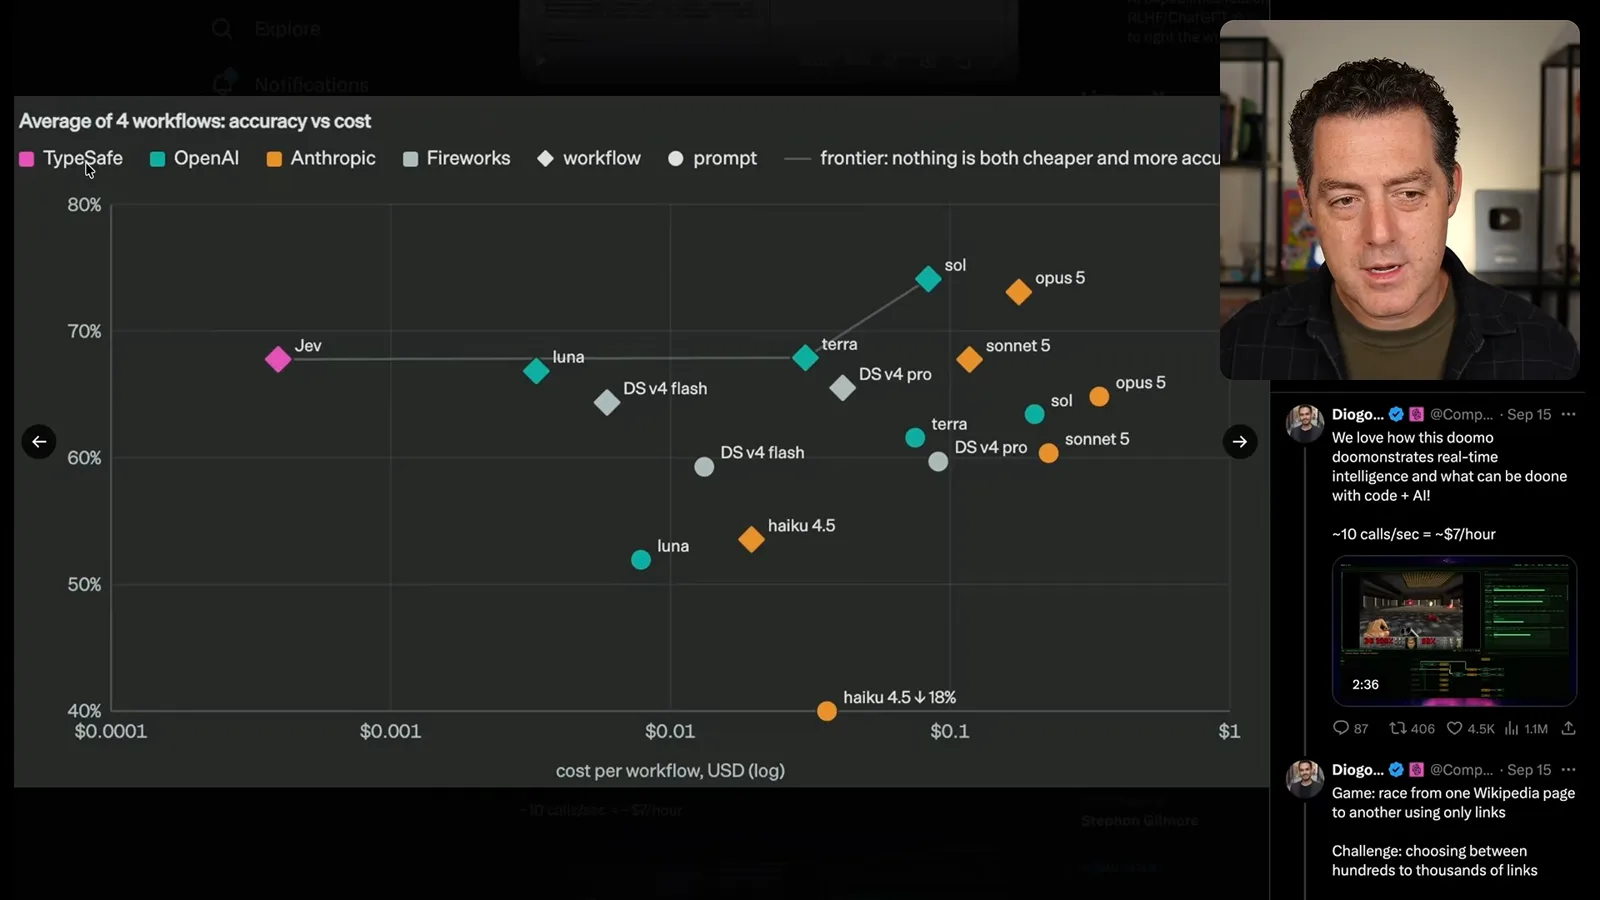
游戏、浏览器与工单路由
他展示快速交互示例,并解释结构化客服工单决策。
Doom 演示展示模型在游戏循环中作出选择。另一个维基百科导航竞赛比较 Jev 与其他模型连续选择链接的速度。这些例子展示了特定交互设置,不能单独衡量所有工作负载下的准确性或速度。
在客服工单示例中,客户报告重复扣费并要求尽快解决。输入包含账户信息,问题则要求给出类别、紧急标记和优先级分数。Berman 表示,许多这样的决策可以并行处理。
可靠性与模拟
视频讨论可靠性,并演示模拟小镇和分类可视化。
Berman 重复了 Jev 零幻觉的说法,并提到安全关键场景。结构化选择仍可能错误、有偏差或校准不佳;避免自由文本并不能保证真实性或决策安全。实际部署需要有代表性的测试、监控和适当的人类监督。
Berman 说,他使用另一个编程模型构建了模拟小镇,再用 Jev 处理角色决策。在关于面包店促销的广播后,界面显示约 0.6 秒内收到了 50 个回应:大多数角色继续原有活动,少数前去查看或参与。
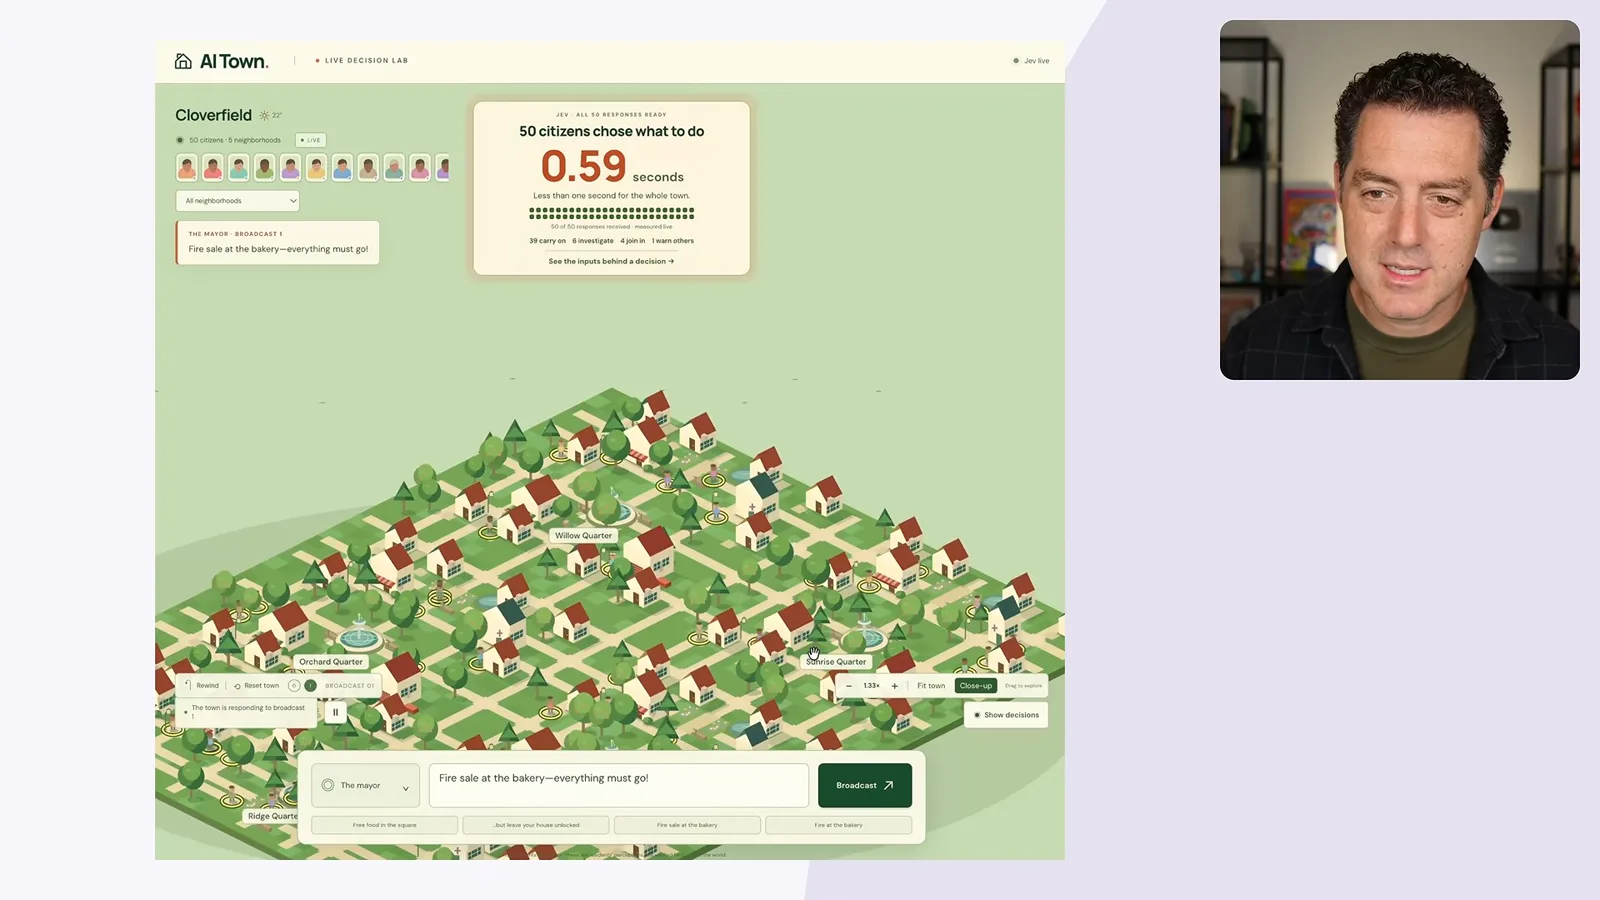
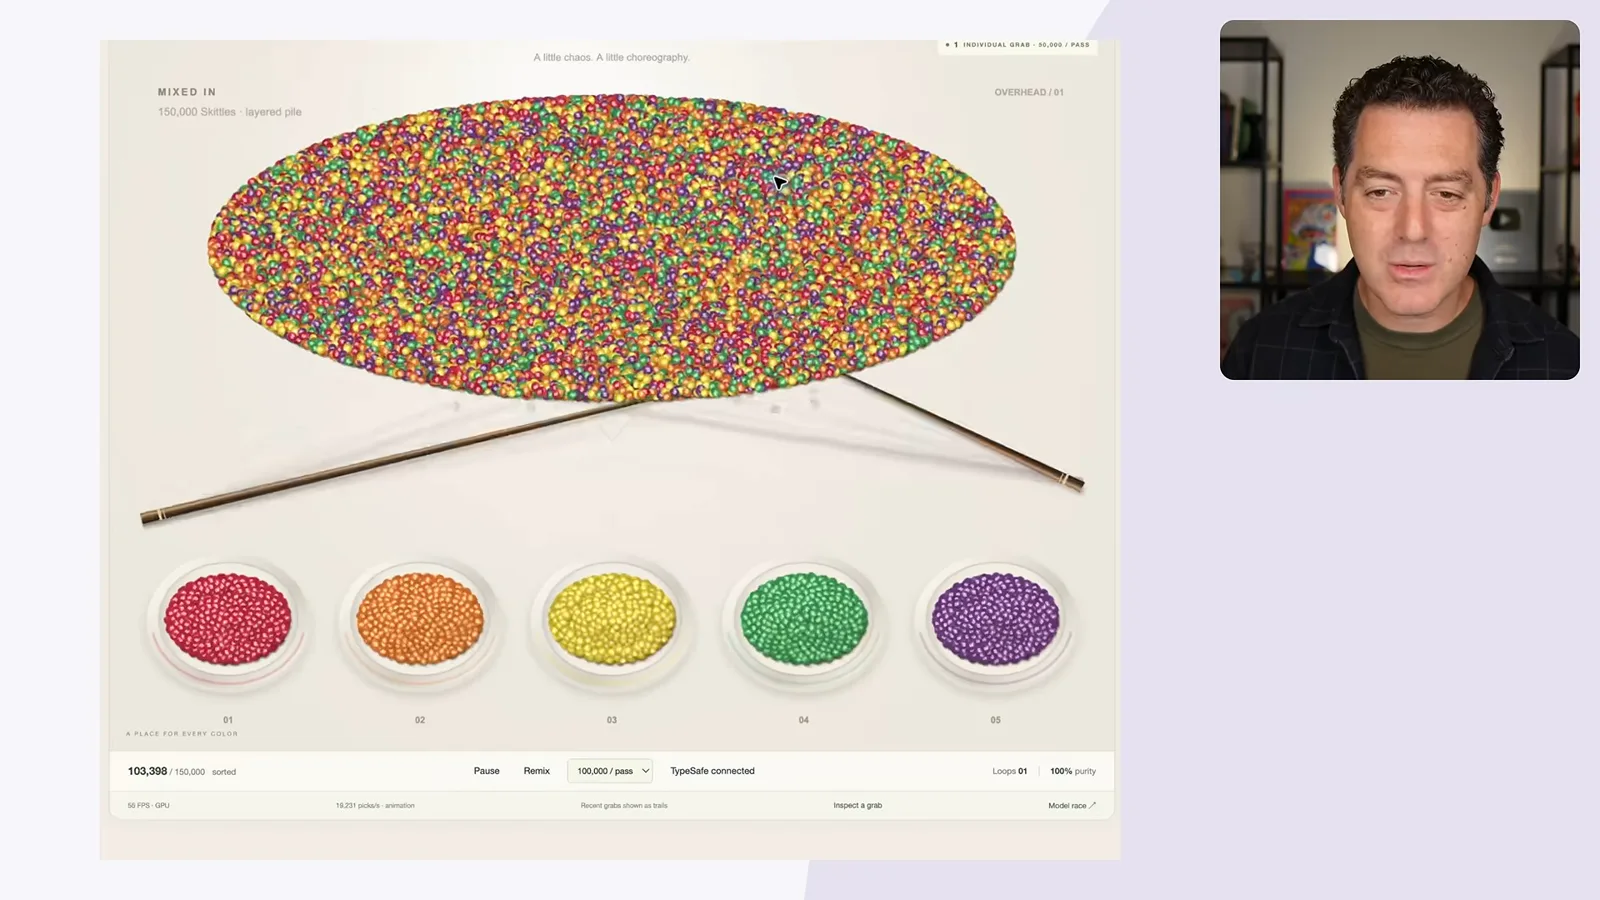
第二条提示让许多角色走向喷泉。另一个可视化示例对彩色糖果分类,Berman 称其中的决策并行进行。这些展示的是人工环境中的响应速度和编排,而非普遍真实环境可靠性的证据。
象棋、路由与驾驶演示
Berman 回顾其他人的实验,最后展望快速决策的可能用途。
Berman 强调 Jev 并非为了在所有任务中取代对话模型。他认为,在系统提供状态并要求结构化答案的大量选择场景中,它具有潜力。他也提到开发者提醒,这个模型在国际象棋方面不如通用模型合适。
计时国际象棋演示说明了速度的取舍:据介绍,一位对手棋面更强却因超时落败,另一位则击败了 Jev。Berman 认为限时条件下快速决策可能重要,但少数棋局不能证明整体棋力。
其他例子包括用 Jev 将提示路由给其他模型,以及一个分类并移除不需要的网页内容的工具。Berman 还展示了一位创作者制作的模拟驾驶环境,由 Jev 选择转向动作。该模拟并非 Tesla 的生产系统,也不能证明模型能够安全驾驶真实车辆。
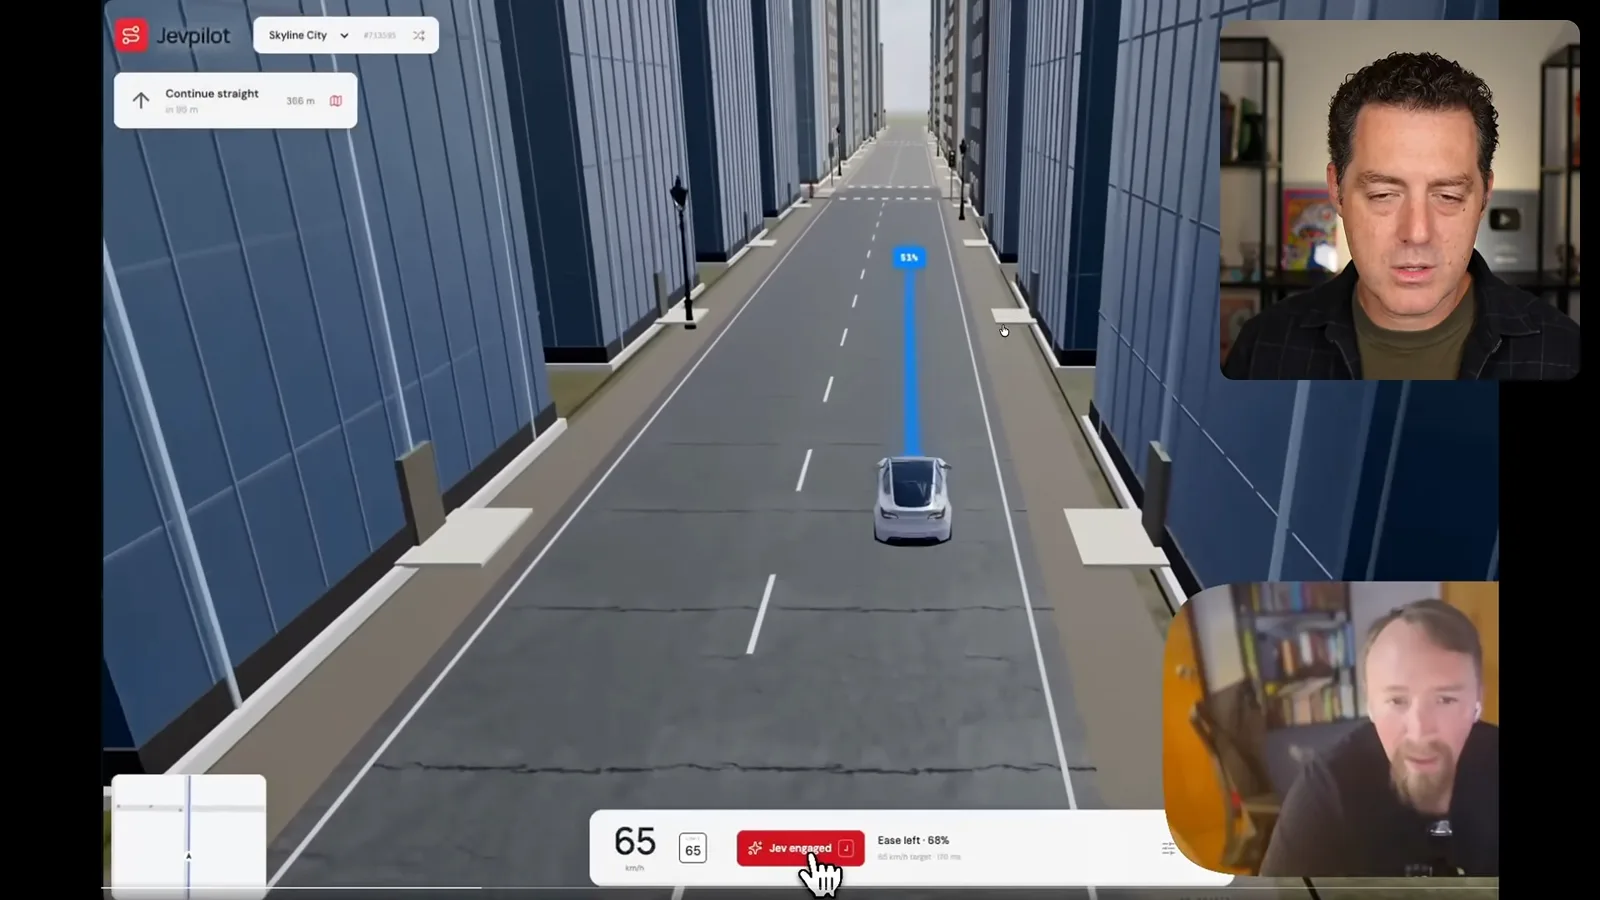
最后一个例子展示实时控制游戏。Berman 总结说,开发者仍在探索快速、低成本决策的有效用途,并期待更多实验帮助厘清其中的取舍。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文