30 秒看懂
Databricks 首席执行官 Ali Ghodsi 认为,当今 AI 已有足够能力改变工作,但他拜访的大多数企业仍主要将其用于聊天和编程。他说,障碍在于组织上下文、访问权限与安全、成本,以及对数据和知识产权的控制。Databricks 的 Genie 演示展示了他如何查询员工调查和客户反馈,但得到的答案仍需要检视。Ghodsi 将广泛应用与失控的自我改进情景区分开来:在他看来,更快的训练、更低的资源需求和通用能力提升必须不断循环。他预计企业应用需要 10 至 15 年。
- 1Ghodsi 认为现有 AI 能力与企业应用之间存在差距他认为当前模型符合较早的 AGI 定义,但说企业客户仍主要使用聊天和编程。这是他自己的定义和判断,并非业界一致认可的标准。
- 2智能体无法利用从未获得的上下文一位银行高管告诉他,银行不会录制会议。Ghodsi 说,缺少会议上下文会限制智能体处理其中决策的能力。
- 3数据访问带来安全和成本问题他说,访问公司数据会扩大攻击面,token 账单的增长也可能快于可衡量的业务回报。
- 4调查仪表盘带来的不只是一个分数Ghodsi 在 Genie 演示中比较了员工调查的不同类别,然后要求按部门细分。
- 5工程产出较高并不总意味着花费更多Ghodsi 说,Databricks 比较了拉取请求活动与 AI 成本,发现一些高产工程师的支出低于其他人。
- 6更多 AI 编写的代码本身不能证明存在失控循环Ghodsi 说,快速自我改进需要训练速度、资源使用和通用能力反复取得改善。
- 7防守方必须考虑攻击者与防守者的不对称Ghodsi 说,攻击者可以多次尝试且只需成功一次,而防守方必须阻止每次入侵。
要点建议
- Ghodsi 认为,智能体需要相关的组织上下文,才能帮助处理公司内部决策。
- 应共同评估 AI 的访问权限、安全、运营成本和知识产权控制。
- Ghodsi 说,仅凭 AI 编写代码,不能证明快速递归自我改进循环已经出现。
- 他预计网络攻击仍是严重的实际风险,企业应用会在多年间逐步展开。
按章节阅读整理后的全文
Databricks 为何押注云与数据
Ghodsi 将公司的起点追溯到伯克利的研究,以及企业数据工作面临的实际障碍。
Databricks 首席执行官 Ali Ghodsi 说,组织已经拥有足以改变工作方式的 AI 能力,难点在于安全、经济地把它与公司的知识连接起来。他把这一应用难题与更快的、自我改进的超级智能前景区分开来。
Jason Calacanis 介绍 Ghodsi,并问 Databricks 如何从早期研究项目发展成一家大企业。Ghodsi 将公司的起点追溯到加州大学伯克利分校 AMPLab 将数据处理与机器学习相结合的研究。
Ghodsi 说,研究人员在 2013 年创办公司,是因为当时业界还没有准备好采用他们开发的技术。早期应用之一是改进 Netflix 电影推荐;团队相信最终会有更多组织需要类似的数据科学能力。
难点并不只是让算法正常运行。Ghodsi 描述了拥有数十年历史软件、监管要求、安全规定和既定流程的组织。学术研究还没有充分解决治理和安全问题。
Calacanis 回忆过去保存原始日志有多昂贵。Ghodsi 说,云服务将计算和存储分开,让企业能保留更多数据,并按需使用计算资源。Databricks 很早就押注云基础设施、AI 应用和开源,他说这些选择当时颇有争议。
主持人回忆 Netflix Prize,认为它展示了组织邀请研究人员改进预测的做法。Ghodsi 解释说,AMPLab 中的 P 代表人:研究人员意识到 AI 需要人的反馈来解决最后一段难题。
当前能力与企业应用差距
Ghodsi 区分了自己对 AGI 的看法和一种更快的假设性超级智能,并概述四个应用障碍。
被问到从现有 AI 走向超级智能的问题时,Ghodsi 说,他认为系统已经符合多年前许多同事所持有的通用人工智能定义。他认为定义已经变化,并说即使不再进步,现有能力也能改变世界。
Ghodsi 用超级智能指另一种假设:一个在智力工作各方面都远快于人类、能力也强得多的系统。Calacanis 问,当今的限制来自算力还是模型本身。Ghodsi 回答说,现有模型相对较慢,往往需要多个智能体并行协作才能发挥作用。
Ghodsi 说,他接触的企业客户大多将 AI 用于类似搜索的聊天和编程,报告的编程速度提升通常为 20% 至 30%。据他观察,让数千个智能体执行核心工作的组织仍然不多。这与模型在困难技术问题上展示的能力形成对比。
他认为,一个障碍是上下文。大公司的决策分散在会议和文档中。一位银行高管告诉他,银行出于责任顾虑不会录制会议;Ghodsi 说,AI 无法帮助处理自己从未了解的决策。
下一个问题是访问权限。让智能体不受限制地访问公司所有数据会扩大攻击面,也可能带来内部威胁。Ghodsi 说,组织还需要比较快速增长的 token 账单与使用 AI 带来的收入或节省。
第四个顾虑是控制知识产权、避免依赖单一供应商。Ghodsi 肯定模型开发商的贡献,同时认为企业必须解决上下文、安全、成本和控制权问题,才能进一步推进应用。
Calacanis 补充说,组织结构可能限制企业如何使用强大的工具:如果车辆的其他部分无法承受,增加马力也没有多大用处。他问到模型公司进入仪表盘等相邻市场的问题。
Ghodsi 说,Databricks 不会把仪表盘作为独立产品收费。它的业务是受治理的数据,以及对数据发起的查询。他预计,更多智能体访问这些数据会增加用量,不过他认为部署仍处于早期。
他说,传统组织架构让决策沿层级上下传递,而交付产品需要跨部门协作:客户反馈经过产品管理、工程、市场和销售。理解企业运作方式的 AI 可能缩短这种跨职能延迟。
Ghodsi 说,他在 Databricks 内看到了这种做法,但无法估计有多少其他组织已大规模采用。他预计新的数字原生公司会比受软件、安全和监管约束的老牌企业推进得更快。
首席执行官助手背后的公司关系图
Genie 演示考察了调查、管理层级、工程产出和客户反馈。
Calacanis 说,他正把自己的播客和投资工作拆成服务与智能体,并设定可以衡量的中间目标。他认为,协调这些部分需要系统性思考,而不只是向聊天机器人输入提示词。
Ghodsi 演示 Genie。他说,系统会构建组织中人员、汇报关系、会议、文档和通信的关系图。按他的描述,后台工作会显示在收件箱中,系统利用这些资料回答问题。
一个例子是一项收到超过 1 万名员工回复的调查。Ghodsi 要求生成仪表盘,发现工作与生活平衡以及公司是否采纳反馈的得分较低。他说,后者尤其值得关注,因为员工以前也提出过类似问题。
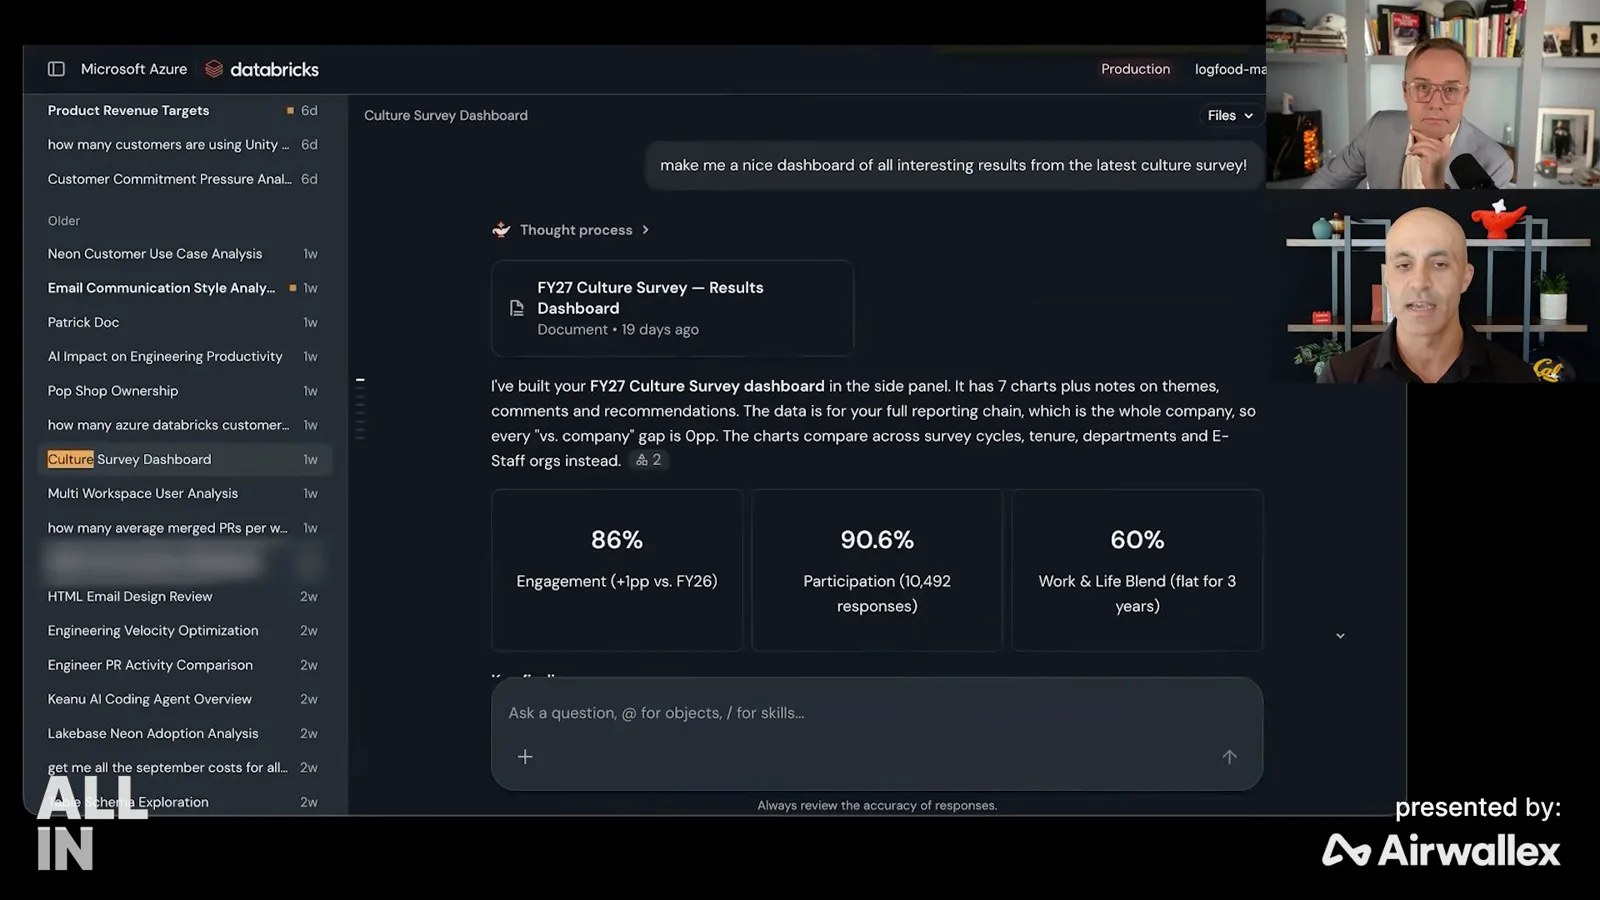
财务负责人推测工作与生活平衡导致了较低的行动得分,Ghodsi 便要求系统比较两项指标。他说,系统找到了与简单因果解释不符的例子。随后,他要求按部门细分,查看员工提出的不同问题。
他说,分析显示产品管理部门关注决策方式,工程部门关注工具,销售运营部门关注职业发展。他把这描述为一个反复提问的过程:第一个答案不够有用时,就进一步明确问题。
Ghodsi 说,系统利用已有关系图,而不是每次都从头搜索所有资料。关系图将某项指标与作者、相关片段和汇报关系连接起来;在他的演示中,组织上下文使分析成为可能。
第二个查询考察管理层级和每位管理者的直接下属数量。Ghodsi 说,系统发现了一条较深的汇报链,每层直接下属却相对较少,由此引出如何调整组织结构的讨论。
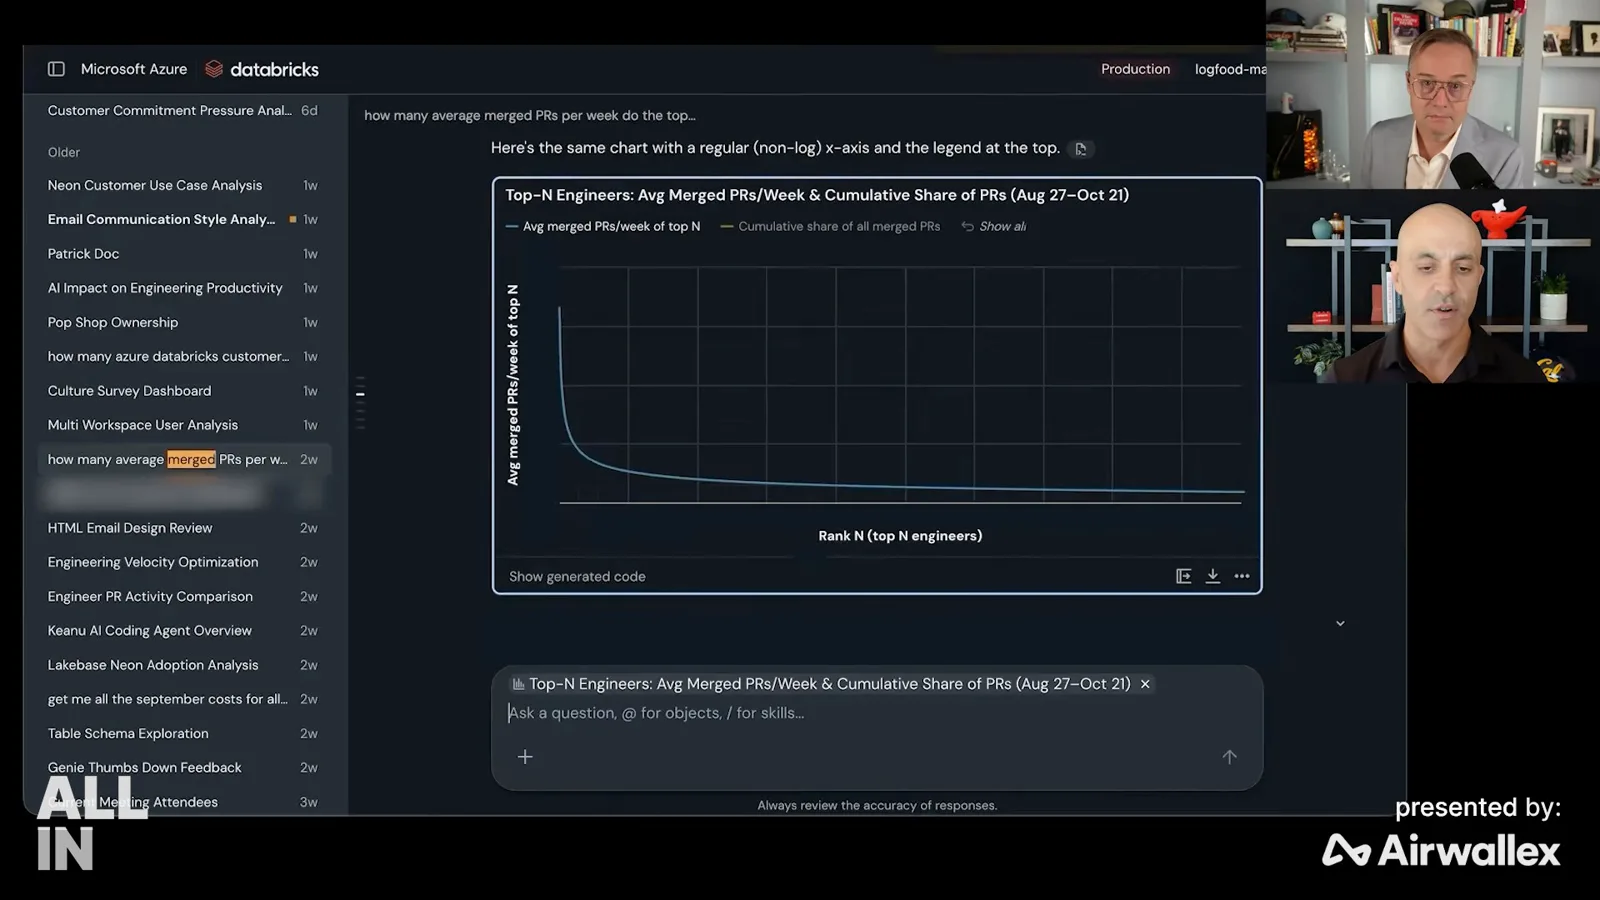
另一张图展示了约 2,000 名工程师合并的拉取请求。Ghodsi 说,领先的一组使用了自动化工作流,其他人则没有。他还比较了支出,称一些高产工程师的花费反而低于其他人,说明用量可以通过不同方式路由和管理。
客户会议录音提供了另一个例子。Ghodsi 询问会议进行得如何,并说系统识别出了客户的关切和功能请求。他描述了在后台收集客户反馈并将其传向工程团队的分析,以减少团队之间的延迟。
Calacanis 将管理比作侦探工作:领导者经常通过几场会议和不完整的说法还原发生过的事。他认为,共享记录可以为检验不同解释提供起点。
Ghodsi 说,一个目标是减少人为阻塞:智能体可能在等待法务、财务或其他团队批准某个步骤时停下来。主持人介绍了自己的实验,从通信中寻找重大决策,其中包括敏感的人事讨论,并在向更多人分享该机器人前意识到了这一点。
Ghodsi 说,他还会询问团队的实际运作方式与公司宣称的文化原则有何差异。差异可能是预警,也可能说明更广泛的政策需要重新考虑;他说,目的是让差异可见并加以讨论。
他说,员工可以访问这些信息,管理层也会分享改善工程产出分布的目标。Ghodsi 认为这种内部应用目前具有竞争优势,但预计类似做法最终会普及。
上市的取舍
Ghodsi 权衡资本和流动性与市场波动,并说目前没有可以宣布的上市日期。
Calacanis 问 Databricks 何时上市,并指出二级市场为私人公司股东提供了一些流动性。Ghodsi 说,他考虑的是哪条道路最有利于未来一二十年建设公司。
上市可以带来资本、知名度和定期交易股票的市场。保持私有则意味着组织要约收购,他称这是一项繁重工作。他说,员工在此前的要约中并未用完公司提供的全部流动性额度。
Ghodsi 说,公司保持私有的同时,也能完成大规模收购。Calacanis 指出,员工和投资者仍需考虑自己的下行风险和出售股票的原因。
被问到如何与不断扩展到相邻产品的公司竞争时,Ghodsi 说 Databricks 会继续开发。他再次谈到公开市场波动的代价:股价下跌可能大幅改变员工薪酬的价值,也会分散管理层的注意力。
他说 Databricks 最终会上市,但在当前 AI 转型期间,他更愿意避开公开市场的过山车。他没有给出日期;他表示,优先事项是专注于长期产品决策。
快速自我改进循环需要什么
Ghodsi 将更快、更省资源的训练、通用改进及重复循环列为其情景的条件。
Calacanis 回到递归自我改进的话题:AI 系统可能反复帮助创造更好的后继者。Ghodsi 说,看到智能体写代码会让这种未来显得迫在眉睫,尤其是对那些职业生涯一直在编程的人。
但 Ghodsi 认为,AI 编写代码的比例从 98% 升到 100%,本身并不能证明存在失控的循环。对于他所讨论的快速起飞情景,他提出了几个需要成立的条件。
他说,首先,后续训练运行必须大幅加快;其次,所需资源必须减少,而不能只是通过不断购买更多硬件来提速。他将其与自己目前看到的大规模、经过谨慎监督的训练运行作对比。
第三,能力提升必须能推广到不同任务,而不只是出现在某个强化训练的领域。第四,所有这些改善必须在循环中持续重复。他说,即使条件全部满足,也不能证明有意识的系统一定会接管一切。
Ghodsi 说,他目前没有看到这种循环:训练时间可能更长,获取和清理数据需要工作,改进也可能只针对特定领域。他认为,要造成他所设想的那种迫在眉睫的危险,除了强大的模型,还需要实际的物理手段。
网络安全与应用速度
讲者讨论攻防不对称、实际风险、生物医学应用,以及 Ghodsi 对经济影响逐步扩散的预测。
Calacanis 提到针对联网冰箱的攻击,认为更强的默认密码本可以限制该案例的影响。Ghodsi 同意网络安全是实际问题,并介绍了自己公司在监测和发现入侵方面的工作。
主持人问,防守方更充足的算力是否能让他们先于攻击者发现漏洞。Ghodsi 指出双方并不对称:攻击者可以多次尝试,只需成功一次;防守方却必须反复保护边界。
Ghodsi 预计,扫描和重写旧代码会逐渐减少漏洞。他把这作为自己的判断:现有漏洞数量有限,而攻击者可以利用智能体扩大搜索范围。Calacanis 补充说,人本身仍可能成为被攻破的入口。
被问及担心超级智能的研究人员时,Ghodsi 说他相信许多人是真诚的,阅读相关论证也确实可能令人不安。但他仍没有看到自己提出的快速循环四个条件成立的证据,同时承认其他人可能拥有他不了解的信息。
Calacanis 列出其他问题,包括儿童与聊天机器人的关系、有害建议以及通过在线系统进行操纵。Ghodsi 说,医院等服务遭受网络攻击等实际风险值得关注,尽管他认为生存风险很低。
对于 AI 可能在十年内治愈癌症的说法,Ghodsi 说自己不知道时间表,并指出药物研发需要经过人体试验。他提到 Databricks 支持的肝病研究,以及与 Merck 开发的模型,作为 AI 协助生物医学工作的例子。
他还提到危机支持和物流等客户讨论过的应用。Ghodsi 预计 AI 会让世界变得更好,同时说风险需要受到重视;这些例子被用来说明应用,而非预测医学突破的时间。
尽管 Ghodsi 认为现有 AI 很强大,他预计解决企业上下文缺口需要 10 至 15 年,经济影响也会缓慢扩散。无法录制会议的银行说明了他的观点:如果智能体无法获取发生过的事情,就无法完成他在演示中展示的内部分析。
Calacanis 把早期 AI 使用者比作宽带普及前就看到互联网潜力的人。Ghodsi 回忆了早期互联网安全事件 Morris 蠕虫;两人最后指出,应用和安全需要共同发展。
同频道的其他文章
 1:24:55EN → 简体中文
 All-In Podcast· 2026年11月14日播客 · 4 人对谈黄仁勋离任后,Nvidia 的 AI 投资引擎面临考验主持 Jason Calacanis, Chamath Palihapitiya, David Sacks, David FriedbergAll-In 主持人讨论 Nvidia 换帅、AI 芯片管制,以及投资放缓可能如何影响 Anthropic。
 1:33:03EN → 简体中文All-In Podcast· 2026年11月7日播客 · 4 人对谈All-In 主持人讨论中期选举与 AI 基础设施争议主持 Jason Calacanis, Chamath Palihapitiya, David Sacks, David Friedberg嘉宾对选举结果的原因、数据中心的未来以及谁将控制 AI 算力存在分歧。
 1:25:46EN → 简体中文All-In Podcast· 2026年10月30日播客 · 4 人对谈All-In 谈 Anthropic 上市、AI 基础设施和美国中期选举主持 Jason Calacanis, Chamath Palihapitiya, David Sacks, David Friedberg主持人分析 Anthropic 的上市文件,讨论 AI 基础设施热潮的成本、Alphabet 业务,并给出不同的中期选举预测。
 55:39ENAll-In Podcast· 2026年10月29日播客 · 2 人对谈Will Ahmed on WHOOP’s Subscription Model, Health Data and Wearable Strategy嘉宾 Will Ahmed · 主持 Jason CalacanisThe WHOOP CEO discusses the company’s business model, physiological data, AI features and its account of interactions with the FDA.
 1:43:22EN → 简体中文All-In Podcast· 2026年10月23日播客 · 4 人对谈AI 安全、投资与法国未来的争论嘉宾 Nikesh Arora · 主持 Jason Calacanis, Chamath Palihapitiya, David FriedbergAll-In 主持人与 Nikesh Arora 讨论网络安全和 AI 支出,随后辩论法国动荡、公共服务及美国政策。
 40:00EN → 简体中文All-In Podcast· 2026年10月21日播客 · 3 人对谈Arvind Krishna 与 Nikesh Arora 谈量子风险、AI 模型和软件整合嘉宾 Arvind Krishna, Nikesh Arora两位企业高管讨论后量子密码准备、开放权重模型的经济性,以及企业网络安全的变化。