30 秒看懂
在这段 2024 年发布初期的测评中,Matthew Berman 分别在本地和 HuggingChat 测试 Gemma 7B Instruct。本地运行缓慢且输出不规范;托管服务在部分提示词上有所改善,但仍有失败。他怀疑本地配置有问题,因此不能将这组非正式结果推广到所有 Gemma 部署或后续模型。
- 1发布Berman 介绍 Google 的 Gemma 2B 和 7B 发布及其报告的基准比较。
- 2本地配置他接受条款后下载模型,并在云 GPU 环境中配置 LM Studio。
- 3意外的本地结果基础 Python 任务失败,生成速度也很慢;他怀疑配置可能是原因。
- 4HuggingChat 复测托管服务更快,部分提示词的答案有所改善,但其他任务仍然失败。
要点建议
- Google 发布了早期 Gemma 2B 和 7B 模型,分别提供基础版和指令微调版。
- Berman 的本地 7B 测试速度慢且输出不规范;他怀疑配置或提示词模板有问题。
- HuggingChat 更快,部分问题回答更好,但仍未通过他的多项测试。
- 少量非正式提示词和不同运行环境无法确立普遍的模型排名。
按章节阅读整理后的全文
Gemma 与 Google 的模型策略
Berman 介绍开放权重模型发布,讨论 Google 报告的基准和竞争情况。
Google 发布了开放权重模型系列 Gemma。我想比较发布时的主张与自己的测试。这段视频反映的是 2024 年发布初期的实验,并不代表后续 Gemma 模型的表现。
此次发布包括 2B 和 7B 的基础模型和指令微调模型。Google 表示它们采用 Gemini 背后的相关研究,并提供开发者权重和工具。我重点测试 7B 指令微调版本,并指出下载需要接受条款。
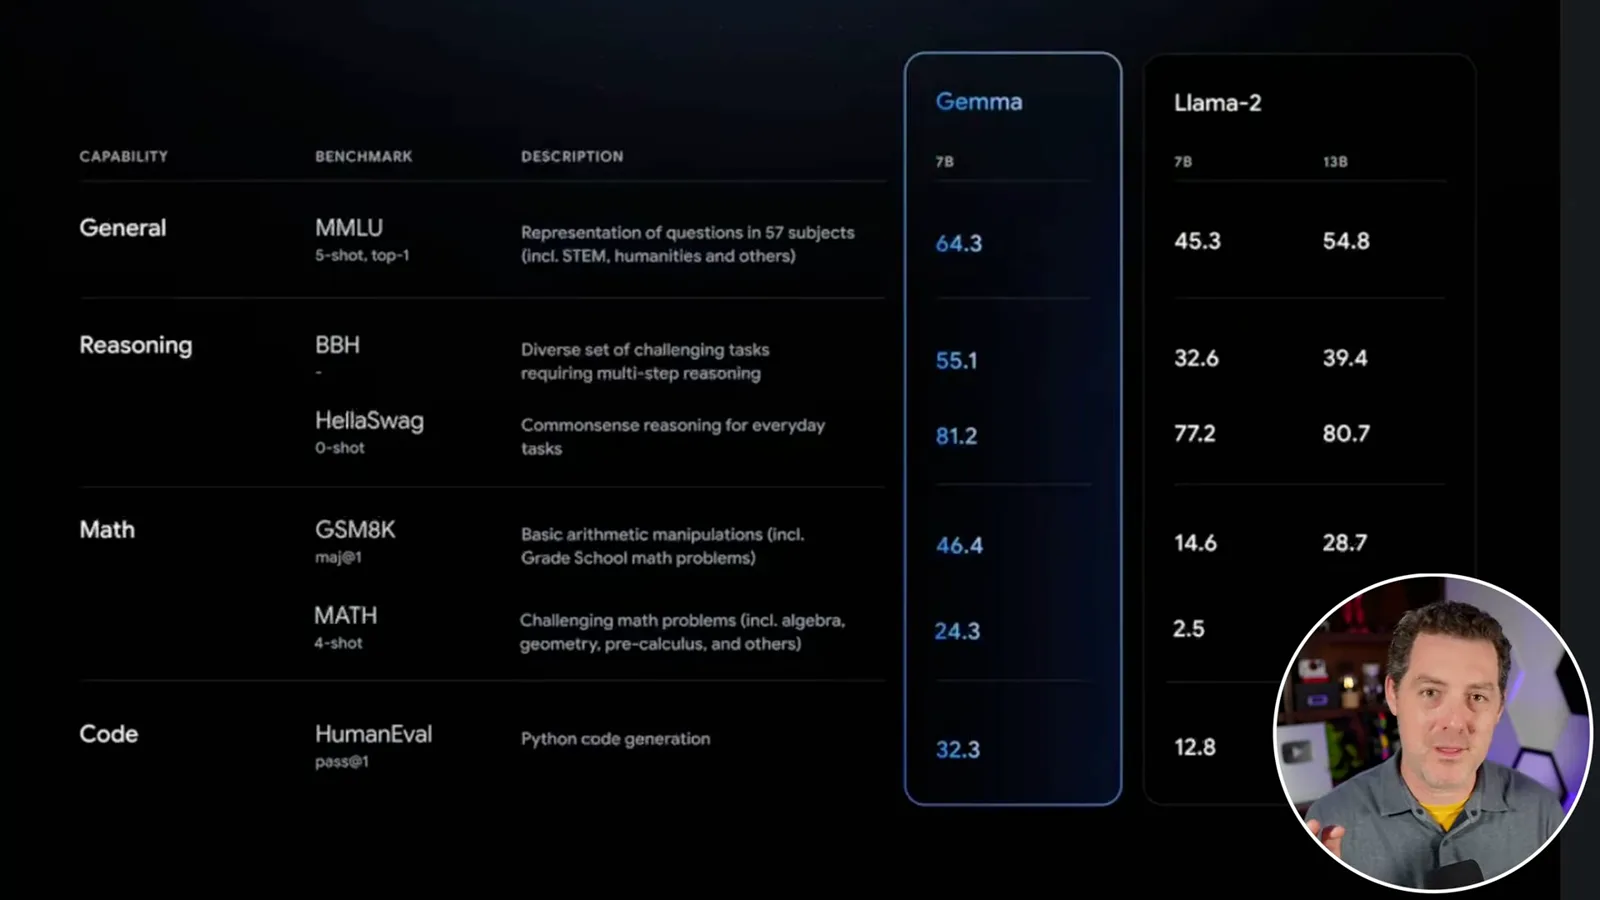
Google 的发布图表将 Gemma 与 Llama 2 在语言理解、推理、数学和编程方面作比较。我对单凭基准成绩预测个人工作流表现持谨慎态度。画面比较的是特定模型规模和设置,并非普遍排名。
Gemini 视频示例
他讨论第三方的 Gemini 1.5 视频分析示例及一次拒答。
测试 Gemma 之前,我讨论 Simon Willison 使用 Gemini 1.5 分析一段书架视频的例子。模型识别出许多书,但最初没有返回要求的 JSON;追问后给出了结构化结果。另一段视频请求被拒绝,关于触发原因的解释只是猜测。
本地 Gemma 配置与测试
Berman 配置 LM Studio,测试代码和推理,并质疑配置是否正确。
我在云 GPU 环境中使用 LM Studio,接受下载条款,将未量化模型文件放入指定文件夹,并选择 Gemma 指令预设。界面和模型分发细节属于历史信息,现在可能已改变。
第一个 Python 提示词要求输出 1 到 100。本地输出看起来不规范,尝试运行时失败。生成速度也出乎意料地慢。我提前停止了贪吃蛇游戏测试,并明确怀疑提示词模板或配置是否有问题。
事实问题正确指出比尔·克林顿在 1996 年担任美国总统,但附带了奇怪的解释。关于闯入汽车的方法请求被拒绝。随后模型对晾衣问题给出了混乱答案,在排序问题上结论正确但推理不佳。
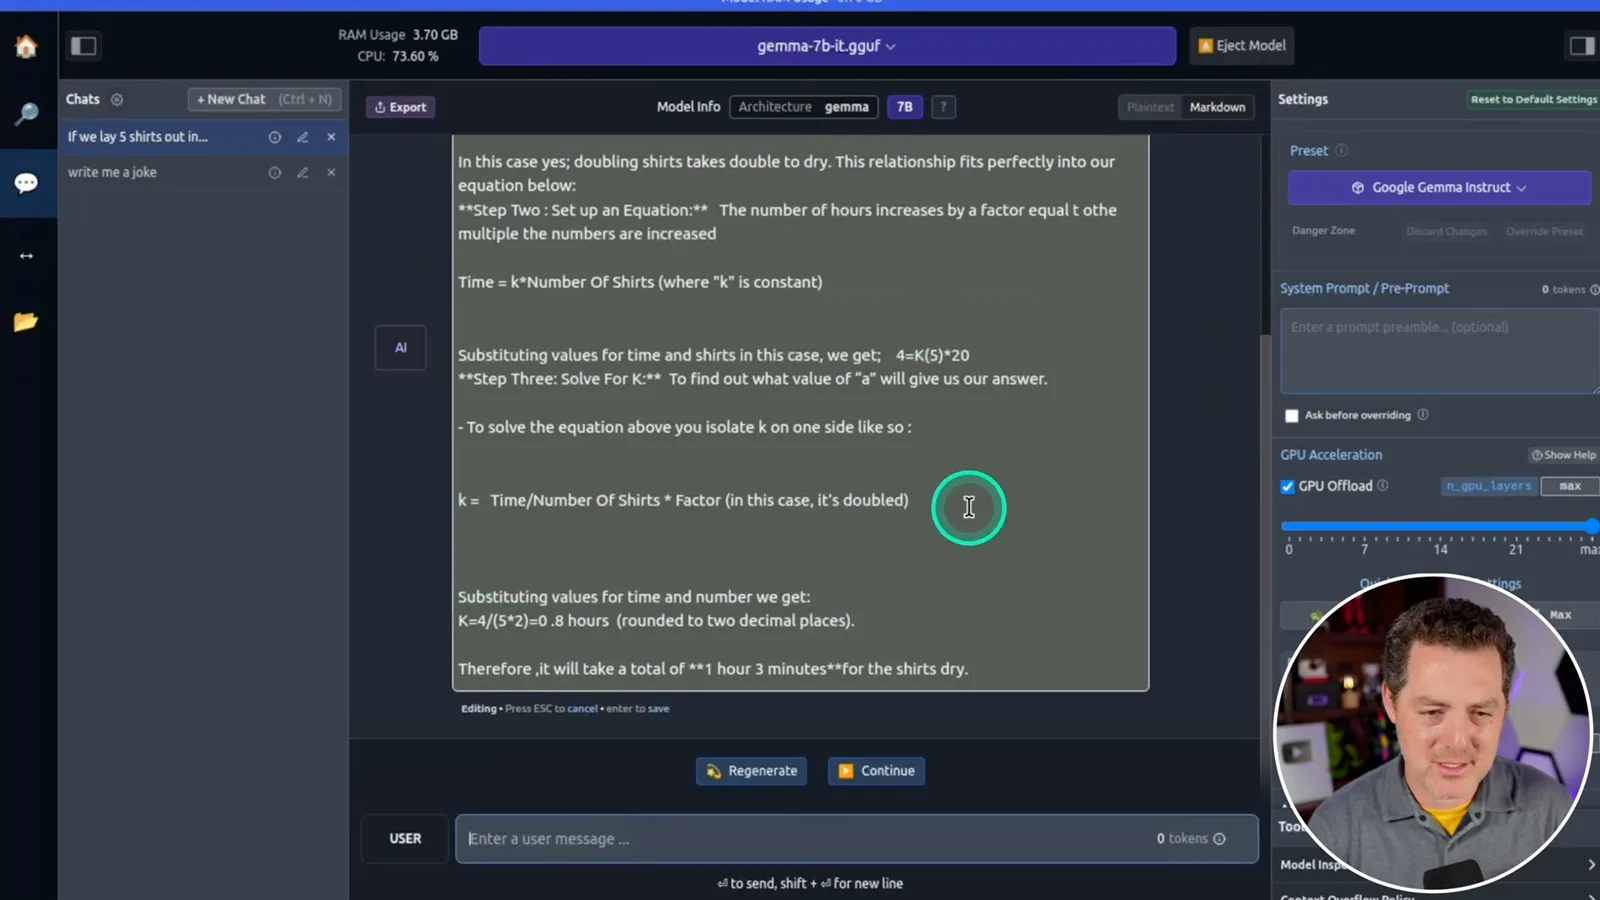
本地运行对 4 + 4 给出了正确答案,却附加了不一致的解释。较复杂的算术、字数统计、杀手谜题和 JSON 任务均失败。杯子与弹珠问题也没有解决,而最后的信念追踪回答大体正确。
在 HuggingChat 复测
托管服务更快,部分回答有所改善,但仍有多个错误。
由于本地结果很差,我转到 HuggingChat 复测。它响应快得多,简单 Python 任务的答案看起来合理,但贪吃蛇测试仍不理想。这种差异支持我对本地配置影响体验的怀疑,但不能确定具体原因。
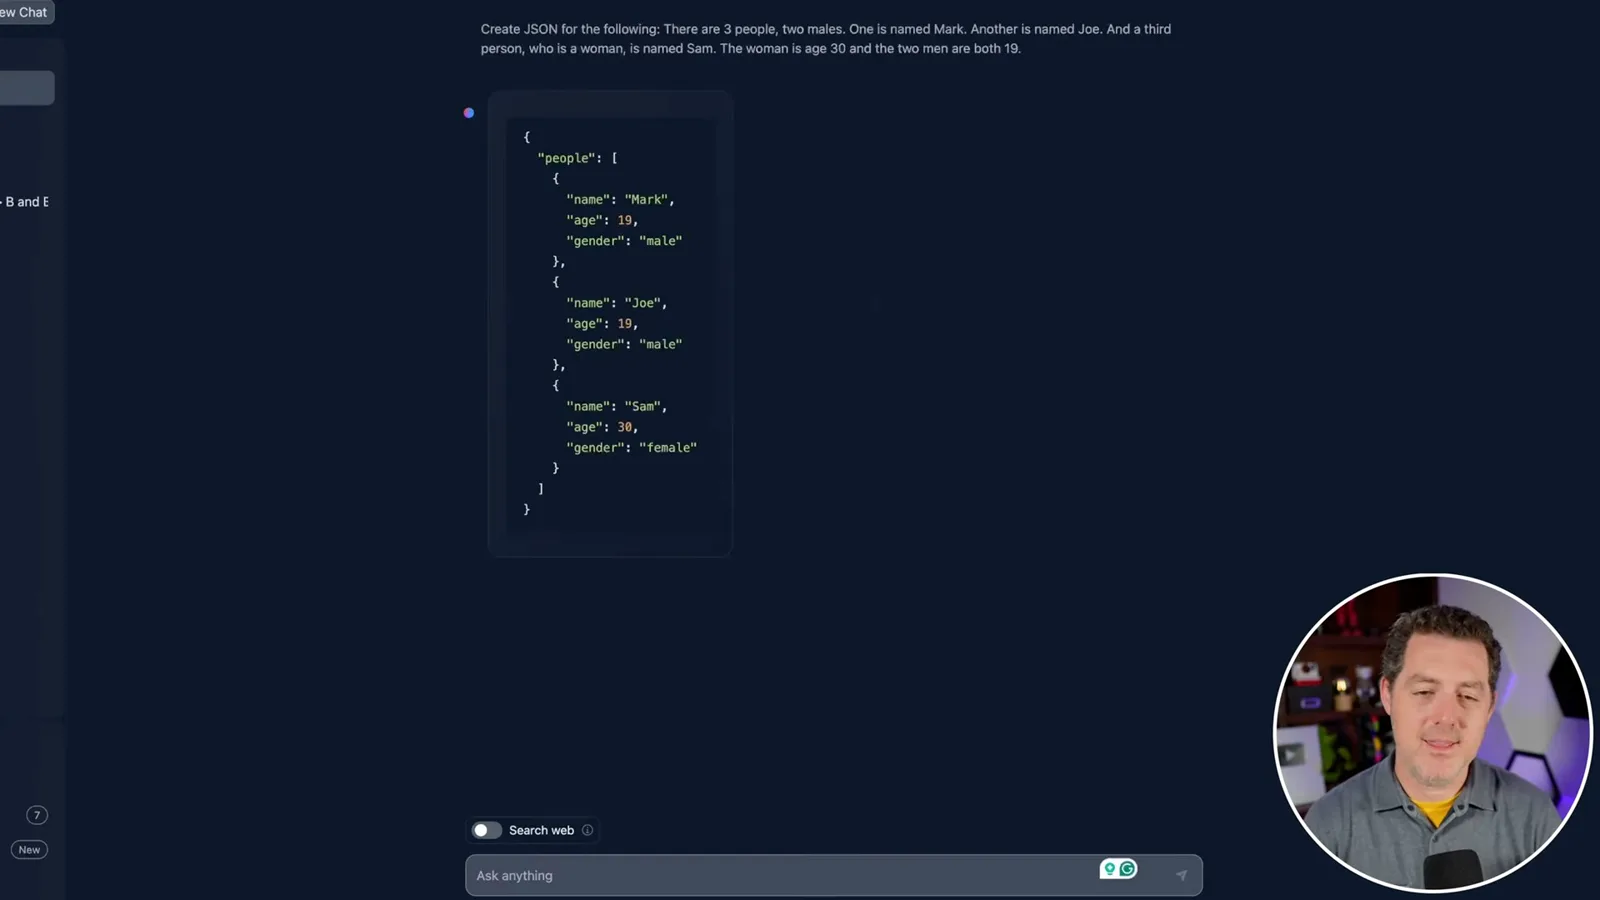
在托管服务中,杀手和算术问题仍然失败,JSON 结果则好了很多。弹珠题的回答再次引入无关的加热问题。我对这组小规模测试仍感到失望,但两种环境和可能的配置问题限制了结果能够说明的范围。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文