30 秒看懂
Matthew Berman 采访 Groq 的 Andrew Ling 和 Igor Arsovski,讨论公司的 LPU 架构、编译器、互连网络和制造。他们认为可预测执行有助于快速推理,并讨论低延迟的潜在用途。采访由 Groq 赞助;性能与质量比较是受访者的说法,未经独立基准验证。
- 1GPU 与 LPU 设计Arsovski 比较了搭配高带宽内存的 GPU 和 Groq 较早、结构更规则的 LPU。
- 2可预测的时序他表示内存访问和同步时间的变化会增加传统系统的复杂度;Groq 则提前调度执行。
- 3编译器优先设计Ling 介绍了从机器学习工作负载出发、共同设计软硬件的过程。
- 4调度芯片网络工程师介绍了芯片通过软件调度网络通信;他们描述的设计不需要独立的机架顶部交换机。
- 5手机演示与本地推理手机演示使用远程服务器;受访者讨论了未来使用较小设备端模型的可能性。
- 6低延迟可能带来的机会Ling 提议利用额外模型调用和评估改善答案,但指出公司当时只有概念验证,还没有商业功能。
要点建议
- Groq 工程师介绍了一种围绕可预测执行与片上内存设计、由编译器调度的架构。
- 他们将较早的 14 纳米芯片与使用高带宽内存的 GPU 比较;结果取决于工作负载和系统设计。
- 编译器将多个芯片的计算和通信作为协同系统进行调度。
- 据 Arsovski 介绍,首款芯片在纽约州制造、在加拿大封装。
- 快速推理可能在给定延迟预算内允许更多迭代,但不会自动提升答案质量。
按章节阅读整理后的全文
开场与工程背景
Berman 介绍这次赞助采访。Ling 和 Arsovski 分别介绍编译器和定制芯片领域的职业经历。
Matthew Berman 采访 Groq 编译器软件副总裁 Andrew Ling 和首席架构师兼院士 Igor Arsovski,讨论 Groq 如何为 AI 推理设计语言处理单元及其软件。视频由 Groq 赞助;下文的技术说明和比较来自受访者,并非独立测量结果。
Ling 在多伦多大学研究计算机架构、机器学习、编译器和 FPGA,随后在半导体公司从事十多年编译器工作。随着工作转向机器学习,同事和行业人脉向他介绍了 Groq。
Arsovski 也毕业于多伦多大学,曾在 IBM Microelectronics 和 GlobalFoundries 开发定制网络芯片。他在 Groq 规模还很小时认识创始人 Jonathan Ross,后来在 Marvell 工作并参与 Google TPU 物理设计,随后加入 Groq。
GPU 内存与首款 LPU
Arsovski 解释 GPU 内存和制程节点,随后介绍 Groq 首款芯片使用 14 纳米工艺的原因及制造地点。
Berman 询问传统推理硬件如何工作。Arsovski 介绍一款高端 GPU:大型计算芯片旁边是堆叠的高带宽内存(HBM)。这种内存能存储比片上存储多得多的数据,但访问时的带宽和延迟特性不同。
被问及制程节点名称时,Arsovski 说纳米名称历史上与极小的特征尺寸有关,但现在已不再直接代表某个具体物理尺寸。他区分了 GPU 的内存容量与所用内存技术的带宽和位置。
展示的首款 Groq LPU 使用 14 纳米工艺,比对比的 GPU 工艺更早。Arsovski 表示,这与芯片的开发时间和希望建立北美供应链有关:芯片在纽约州 Malta 制造,在加拿大 Bromont 封装。
可预测性与编译器设计
嘉宾讨论延迟变化、人工优化的软件和 Groq 的软件优先方法,并介绍跨芯片计算协调。
Berman 询问所谓确定性执行是什么意思。Arsovski 解释,处理器可能很快从附近缓存取得数据,也可能需要更久才能从外部内存取得数据;当许多核心和芯片互相依赖时,时间变化会使协调复杂化。这里讨论的是执行时序,并不保证模型输出总是相同。
Ling 表示,为时序变化的硬件编程和调度可能需要保守假设及大量人工优化。他以专门的数学库和人工调优内核为例,说明业界如何榨取性能,而不是说所有 GPU 软件都由人工编写。
据 Ling 介绍,Ross 最初思考如何分解机器学习工作负载,再设计执行这些操作的硬件。Arsovski 说 Groq 的软硬件团队跨整个技术栈紧密合作:编译器工程师参与硬件决策,反之亦然。
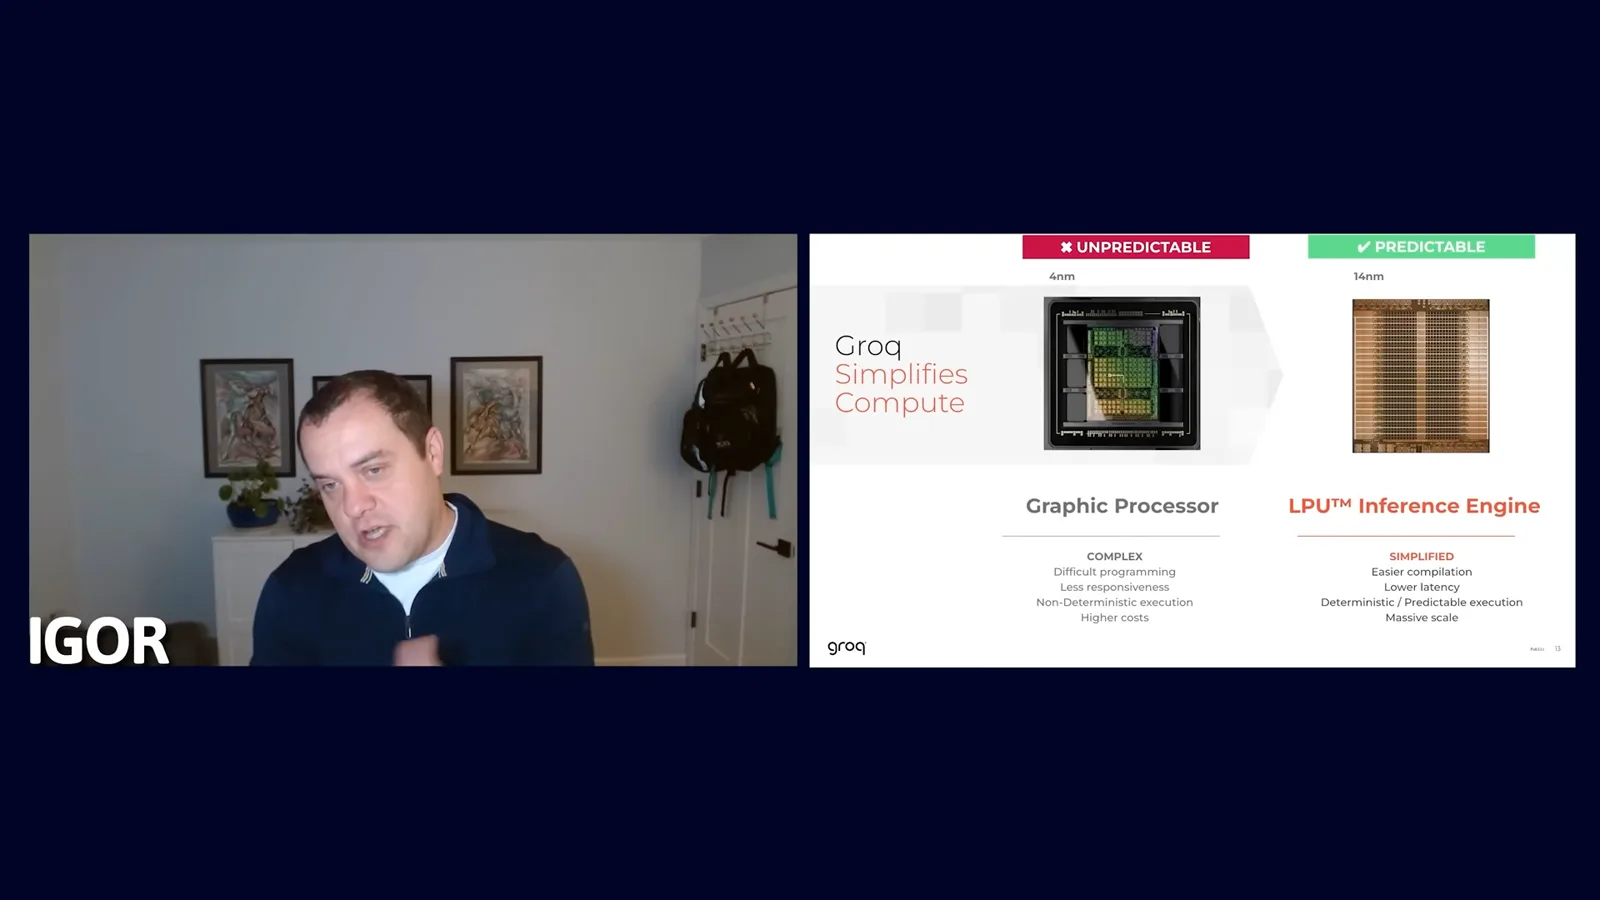
Arsovski 将 LPU 描述为结构规则的芯片,没有对比 GPU 旁边展示的外部 HBM 堆叠。他说软件可以规划特定时刻哪些功能单元和内存处于活动状态。嘉宾将性能归因于包含编译器和系统在内的整体设计,而不是仅归因于制程节点。
Ling 表示,可预测行为使编译器能够把较大问题调度到多个芯片上,仿佛它们是一个协同整体。嘉宾认为,新公司可以从不同架构出发,而成熟厂商已经在现有软硬件生态上投入了大量资源。
连接多个芯片
Arsovski 对比传统网络与 Groq 的调度互连。Ling 解释编译器如何协调通信。
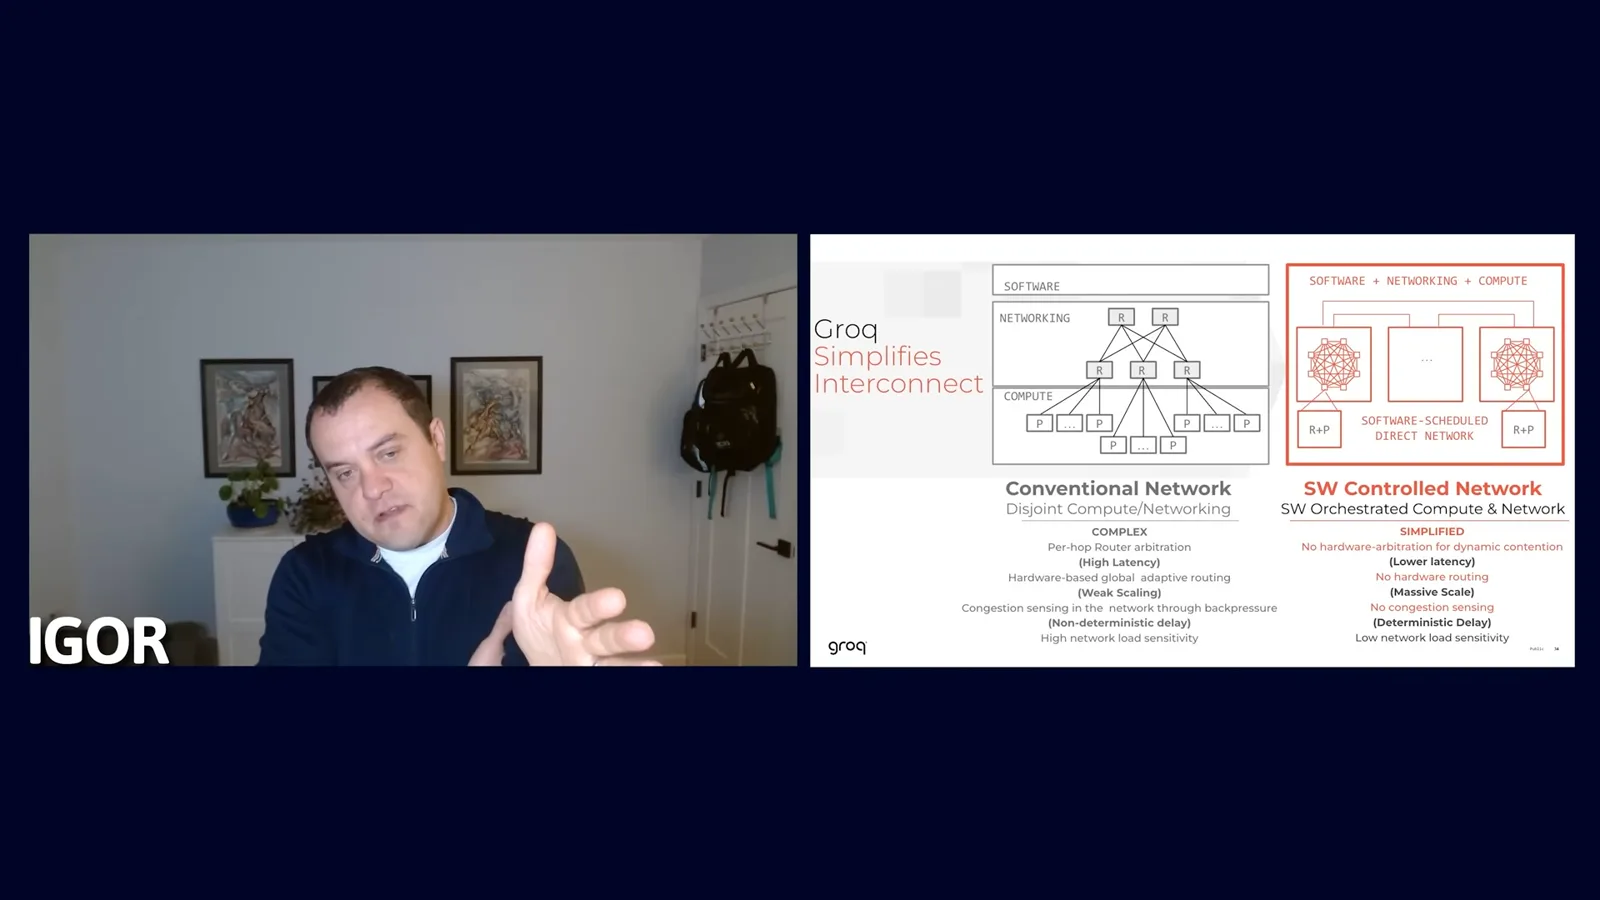
讨论从单芯片转向连接处理器的网络。Arsovski 表示,传统路由可能引入拥塞和延迟变化,使多芯片工作负载的调度变得困难。Berman 将其概括为:独立处理器需要通信,但各自完成工作的时间可能不同。
Arsovski 说 Groq 的芯片结合了加速和交换功能,在所描述的系统中,芯片在组内和跨组直接通信,而不依赖独立的机架顶部交换机。软件同时调度计算和通信,因此网络和芯片可以作为协同整体处理。
Ling 解释说编译器和芯片构成一个平台:Groq 使用部分通用编译器基础设施,但针对自己的架构构建了特定调度方法。如果执行时间可以预测,编译器就能规划何时通过芯片链路发送数据。
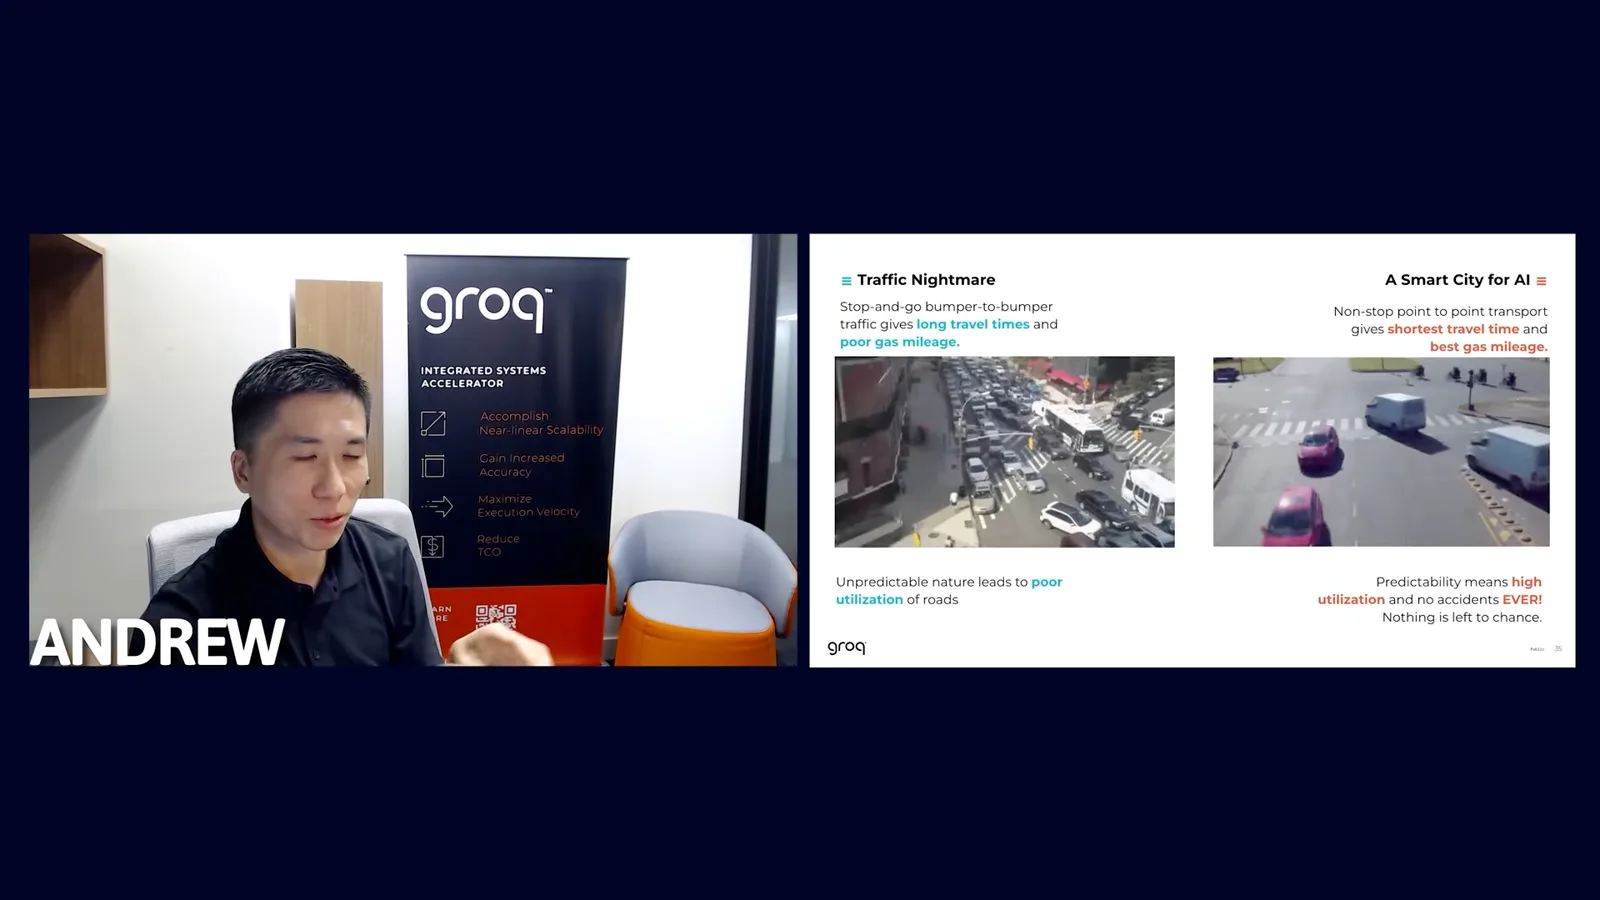
Arsovski 将调度数据传输比作给汽车安排精确的路线和出发时间,从而避免在路口等待。这个类比用来说明减少拥塞和提高链路利用率的目标;实际性能取决于工作负载和系统。
应用与模型支持
他们讨论其他工作负载、未来设备、远程手机推理和编译新模型的过程。
被问及语言模型以外的应用时,Ling 提到需要大量内存带宽的工作负载,包括循环模型、图神经网络和潜在药物发现应用。这些是团队认为有前景的领域,并非经过独立验证的全面优势结论。
Berman 询问这种架构未来是否可能出现在消费设备中。Arsovski 表示,规则结构可以平铺成更小的设计、小芯片或独立芯片。嘉宾将此作为设计上的可能性,而不是已经宣布的消费产品。
手机演示快速给出了语音回答,但 Berman 指出手机仍在访问服务器。嘉宾区分了远程推理与完全在设备上运行模型。他们认为,与最大的服务器模型相比,较小的专用模型或蒸馏模型可能更适合本地运行。
Ling 说,将新模型接入 Groq 可能需要先调整 PyTorch 描述,去除厂商特定的底层操作,再交给 Groq 的编译器和软件栈。团队也会测试客户的专有模型。采访中提到的 2024 年支持模型列表属于历史信息。
制造与普及
Arsovski 解释制造工艺和芯片规则性;嘉宾介绍公开使用和开放权重模型如何帮助展示硬件。
Arsovski 概述光刻:使用掩模、光刻胶和蚀刻,在硅片上一层层形成图案。他介绍先进制造技术,并表示 Groq 首款芯片采用晶圆厂的常规逻辑工艺,无需独特的制造流程。
Arsovski 认为规则的设计有助于扩展,并使高密度结构更容易排列。他说与讨论中用于说明的 CPU 和 GPU 设计相比,Groq 芯片中用于指令控制的面积相对较少。这些百分比是公司方面的估计,不应推广到所有芯片。
Berman 询问 Groq 多年开发后如何获得广泛关注。Ling 认为让更多人能够使用技术是关键;Arsovski 说开放权重的 Llama 模型帮助公司展示了硬件能力。团队谈到长期项目接触更广泛受众时的兴奋。
快速推理能带来什么
Ling 介绍快速推理可能支持的迭代用途,并指出当时仍处于概念验证阶段。
Berman 对将低延迟推理用于智能体和编程感兴趣。Ling 提议,调用更快可以让系统在展示答案前有时间进行多次草拟、评估和修订。他说 Groq 当时已有概念验证,但尚未推出相应商业功能;额外迭代并不保证答案更好或更准确。
Arsovski 补充说,开发者已经可以尝试连续提示词,并评估结果是否有所改善。Berman 向嘉宾致谢,结束采访。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文