30 秒看懂
Matthew Berman 解读 Anthropic 的《构建有效的智能体》,介绍提示词链、路由、并行、编排器和评估循环。他建议从简单方案开始,并进行充分测试。视频由 Vultr 赞助;Berman 表示他投资了 CrewAI、Groq 和 Not Diamond。
- 1工作流与智能体Anthropic 区分预定义的代码路径和由模型动态决定流程及工具的系统。
- 2从简单做起Berman 赞同仅在必要时增加复杂度,因为智能体系统可能增加延迟和成本。
- 3链式调用与路由提示词链将任务分解为顺序步骤;路由选择专门的处理路径或模型。
- 4并行执行任务拆分让独立子任务并行;投票则比较同一任务的多次尝试。
- 5编排与评估协调者可以委派工作,独立评估者则为修改提供反馈。
- 6衡量并迭代Berman 强调测试、可观测性和基准评估,而不是假定某种模式一定有效。
要点建议
- 从最简单的方案开始,只有在确实改善任务时才增加智能体系统的复杂度。
- Anthropic 区分预定义的工作流与由模型动态决定工具使用的智能体。
- 链式调用、路由、并行和评估循环分别解决不同的编排问题。
- 框架提供便利的抽象,但也可能隐藏提示词并使调试更困难。
- 衡量质量、延迟和成本,并在需要时加入人工审查。
按章节阅读整理后的全文
框架、定义与权衡
Berman 介绍 Anthropic 的指南,对比工作流和智能体,并讨论简单性、成本及框架的利弊。
Anthropic 关于构建有效智能体的指南提供了将语言模型转化为实用系统的有益模式。我会解读其中的建议,并结合自己的智能体项目补充经验。视频由 Vultr 赞助。我还披露了对下文提到的 CrewAI、Groq 和 Not Diamond 的投资。
指南称,成功实现往往使用简单、可组合的模式,而不是复杂框架。我同意简单智能体本身也有用,但我也使用 CrewAI,认为应用变复杂时框架可以提供帮助。我是 CrewAI 的投资者。
Anthropic 作出区分:工作流通过预定义代码路径编排模型和工具;智能体则让模型动态决定流程和工具使用。实际上,我认为将结构化步骤与灵活的模型决策结合起来很有价值。
从最简单的方案开始,只有必要时才增加复杂度。智能体系统可能改善某些任务的表现,但也可能消耗更多 token 和时间。我也是推理服务商 Groq 的投资者;更快、更便宜的推理可能影响这一权衡,但结果取决于具体应用。
框架可以提供抽象、工具和常见模式,但这些层也可能隐藏提示词和响应、增加调试难度,并诱使开发者添加不必要的复杂度。简单任务可能只需要配备检索、工具和记忆的模型。Berman 还提到 Model Context Protocol,称其可用于连接模型与第三方工具。
工具、提示词链与路由
他介绍模型工具和 MCP,随后解释顺序提示词以及将任务路由给专门模型。
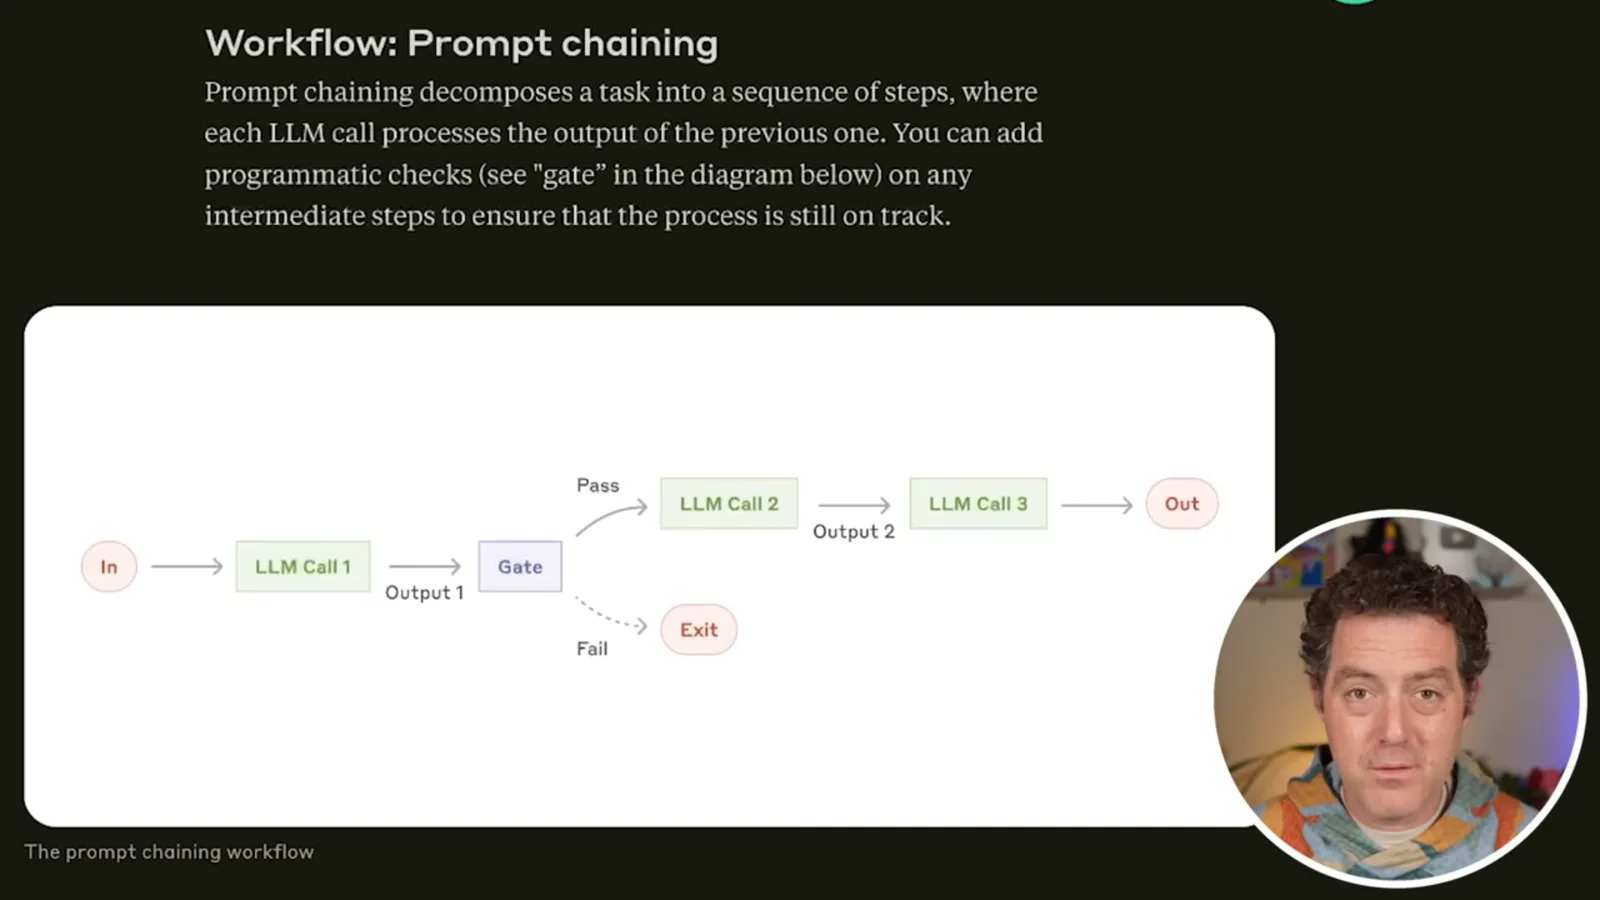
提示词链将任务拆成顺序步骤:每次调用处理上一步的输出,并可在中间加入检查。例如,一个调用生成营销文案,另一个再翻译。这可以简化单次任务,但会增加延迟。
路由先对请求分类,再将其交给合适的专门路径或模型。系统可以用较小模型处理常见简单请求,用更强的模型处理困难情况。我投资了从事模型路由的 Not Diamond;路由决策仍需要根据成本、速度和质量进行衡量。
并行工作与评估
他讨论任务拆分、投票以及安全检查和代码审查的例子。
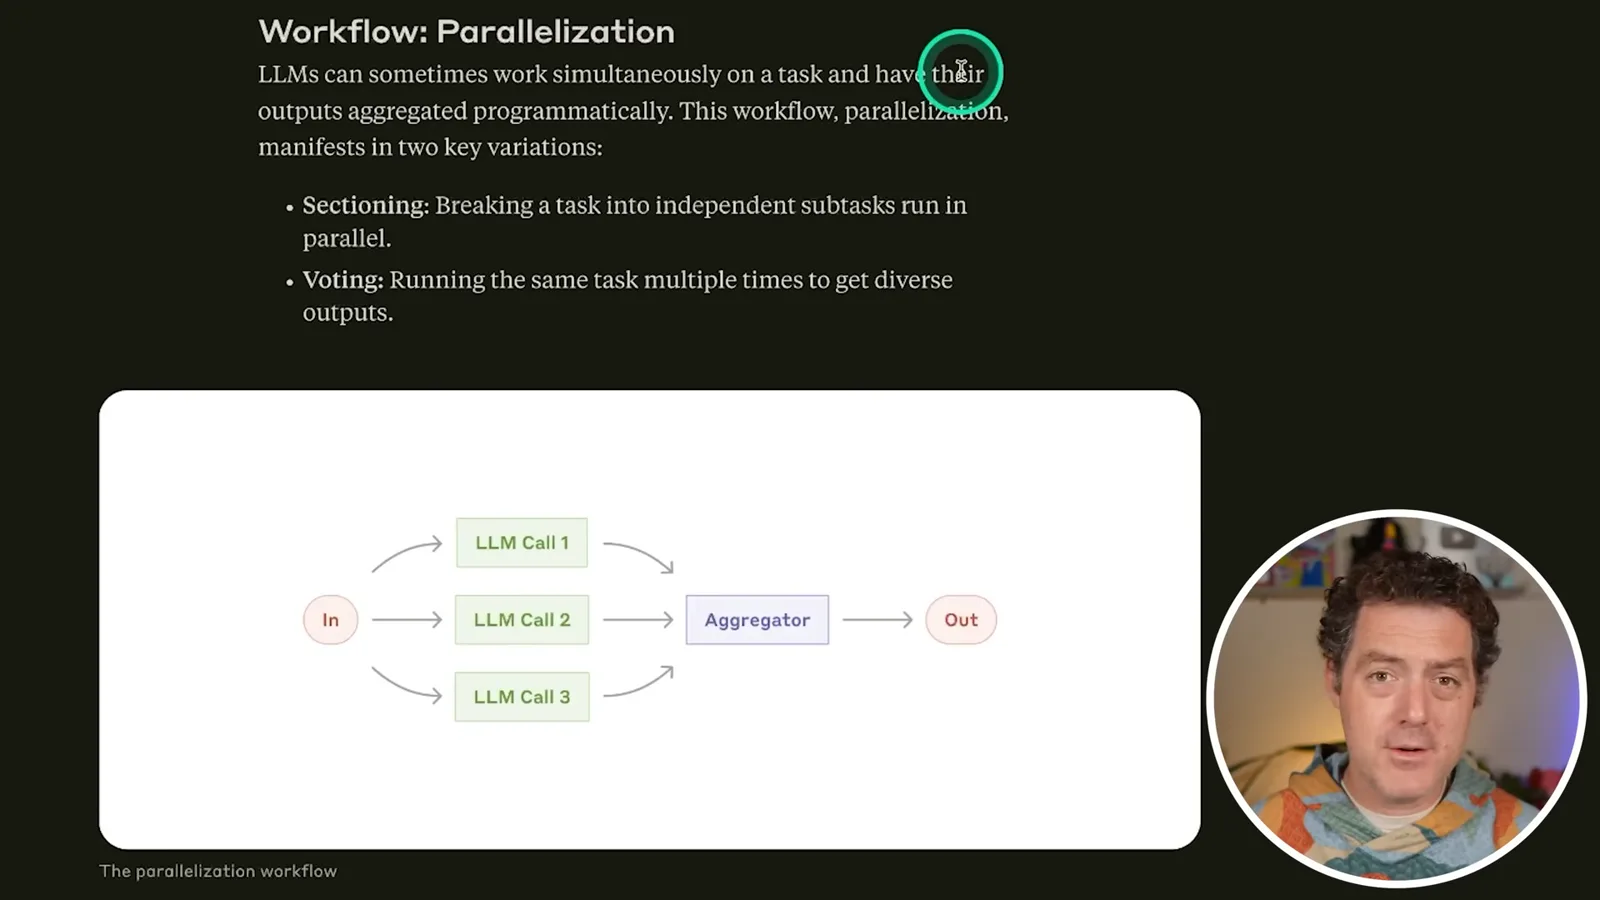
指南介绍了两种并行方式。任务拆分让独立子任务同时运行;投票则对同一任务生成多个尝试并汇总结果。例如,可以同时进行请求安全检查与响应生成、评估答案的不同方面,或者审查代码。这些模式本身不能证明每种推理模型的工作方式。
编排器与评估循环
Berman 介绍一个使用协调者和审查者处理 PDF 问答的项目,并解释迭代评估。
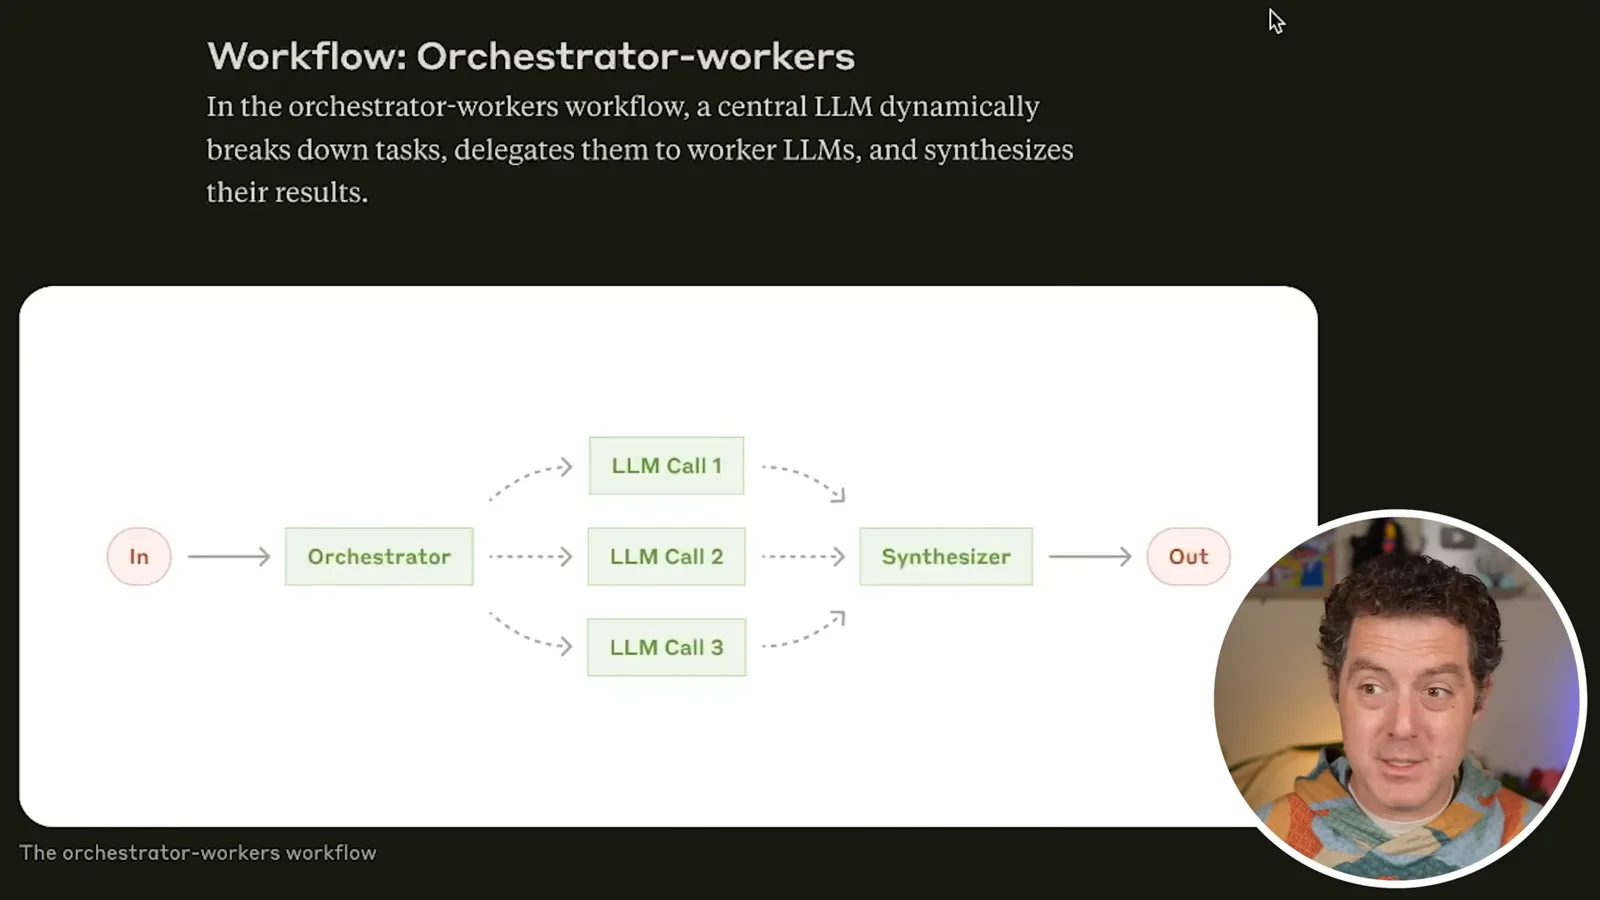
在编排器—工作者模式中,中央模型拆分任务、委派工作并整合结果。我曾用类似方式根据 PDF 生成问答。审查者从 30 条中标出约两条错误或缺乏依据的内容,工作流随后生成替代项;这是一个示例,并非普遍错误率的测量。
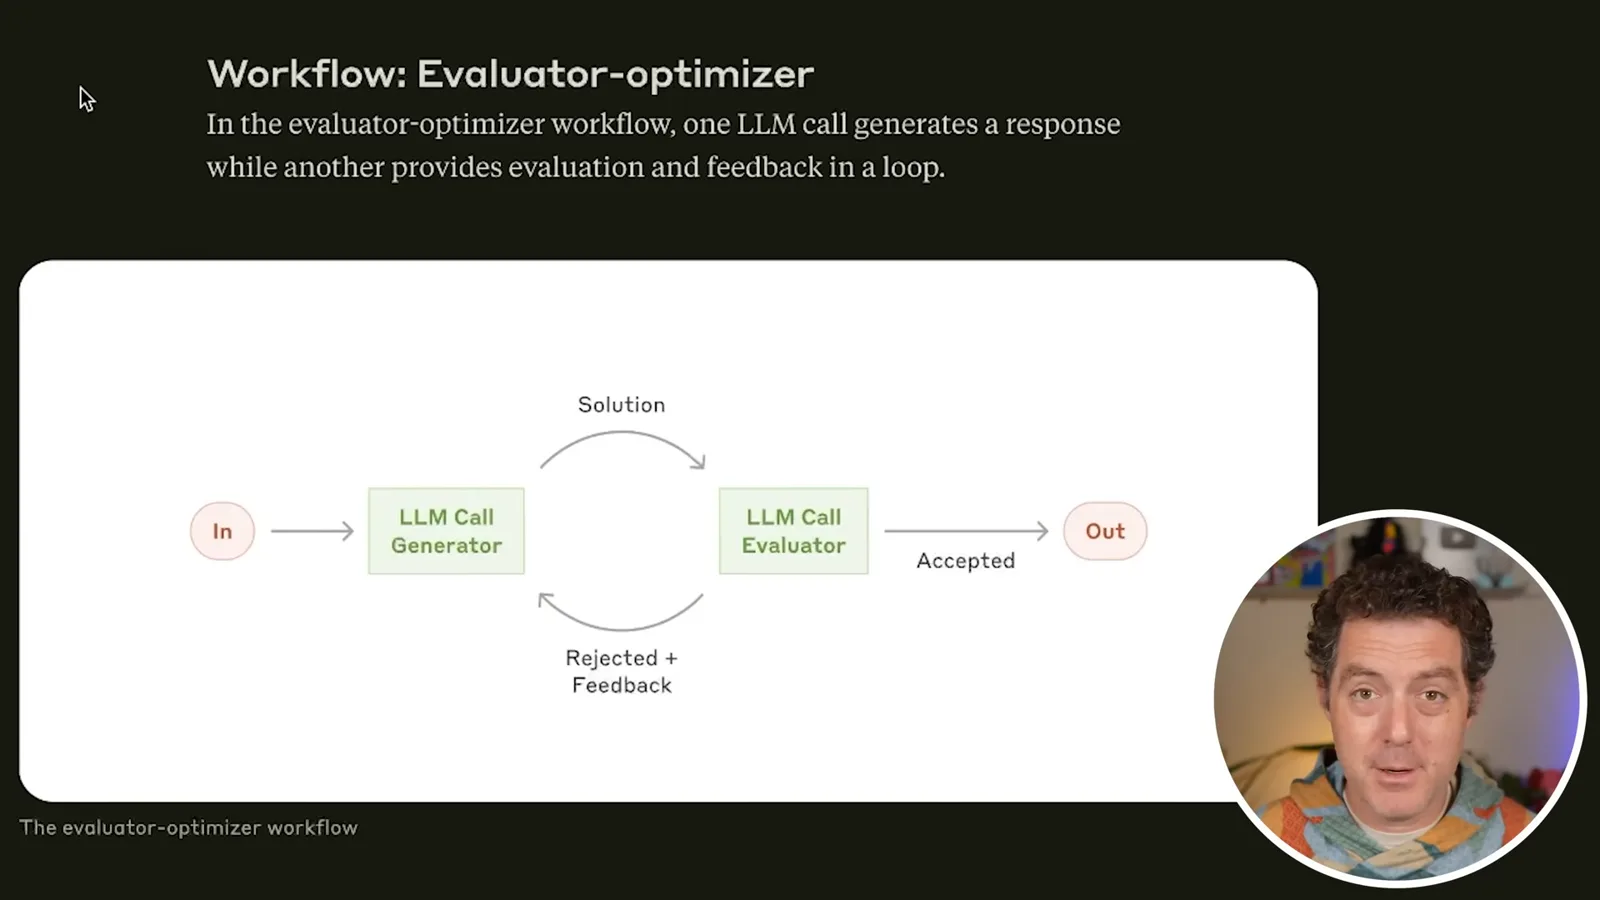
评估者—优化者循环先生成响应,再评估;如果需要,反馈会用于下一次尝试。当评估标准清楚、修改能带来可衡量价值时,例如细腻的翻译或多轮研究,它可能有用。评估者也可能犯错,因此仍需要测试。
自主智能体与人工审查
他讨论开放式智能体任务、人工检查点和编程智能体工作流,最后强调衡量和迭代。
对于无法完全预先规定步骤的开放式问题,智能体可以跨多个回合规划并使用工具。它可能需要在检查点或遇到阻碍时暂停,请人提供意见。例如,编程智能体可以搜索文件、修改代码、运行测试并返回结果,必要时由人澄清任务。
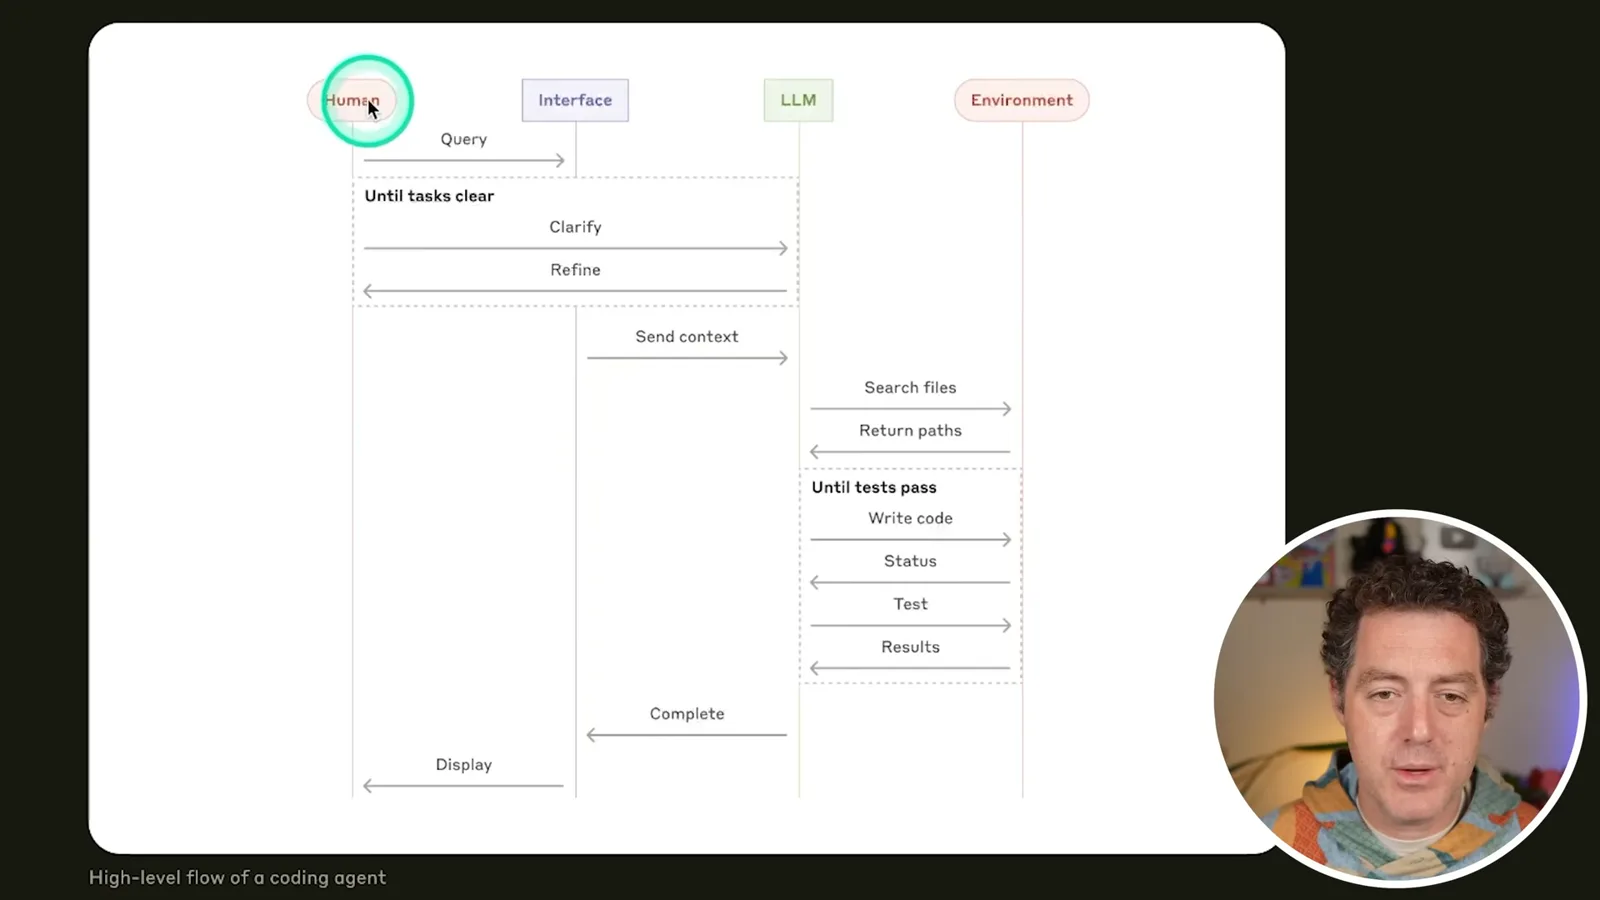
这些模式是可以根据任务组合的构件,而不是必须遵循的模板。衡量结果、使用可观测性工具、进行基准评估并持续测试。最有用的设计,是能可靠完成手头工作的设计。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文