30 秒看懂
Matthew Berman 介绍 Reka Core、Flash 和 Edge,随后用编程、推理和图像输入测试 Core。结果有好有坏:它完成了结构化数据和两个图像示例,但贪吃蛇游戏及几道推理题在演示中失败。
- 1三种模型规模Reka 将 Edge 和 Flash 分别列为 70 亿和 210 亿参数稠密模型;展示的材料未披露 Core 的规模。
- 2编程失败生成的贪吃蛇游戏出现运行错误,一次修复后错误仍然存在。
- 3假设很重要晾衣服问题的答案取决于衣服是分批还是同时晾干。
- 4图像理解Core 理解了梗图的大意,但弄错了一个小的视觉细节。
- 5结构化提取演示中,模型将表格截图转换为 CSV。
要点建议
- Reka 报告称 Core 接收文本、图像、音频和视频,Flash 与 Edge 则是较小的稠密模型。
- 公布的基准和价格比较反映了发布时的情况和所用方法。
- 生成的贪吃蛇游戏在一次修复后仍然失败。
- 推理答案可能依赖假设,解释也可能前后不一致。
- 模型在演示中的梗图理解和表格转 CSV 示例上成功。
按章节阅读整理后的全文
Reka 模型与公布的基准
Berman 回顾三个模型和供应商的比较,并介绍其规模、专有状态和上下文信息。
Reka 推出了三个多模态模型:Core、Flash 和 Edge。我先回顾公司公布的基准测试,再用编程、推理和两个新的图像任务测试 Core。视频中的比较和价格反映的是发布时可用的模型。
Reka 将 Core 描述为其能力最强的模型,能够处理文本、图像、音频和视频。在一个演示中,它分析了一部预告片。公司的基准表将 Core 与当时的 OpenAI、Anthropic 和 Google 模型比较;报告的 MMLU 得分为 83.2。
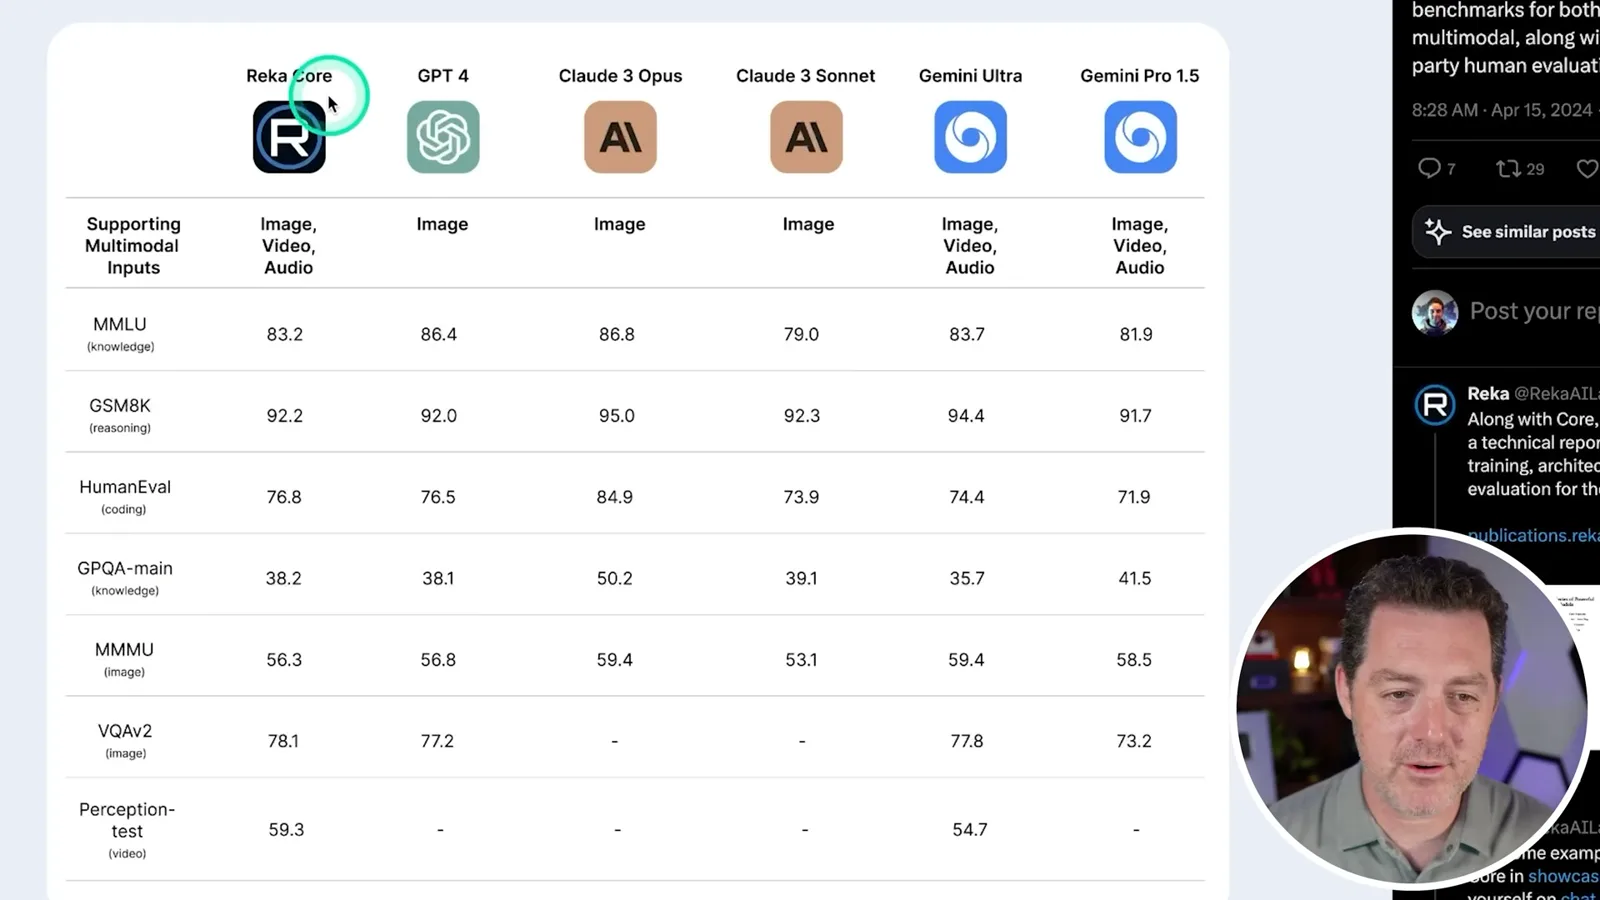
Reka 表示从零训练了这一模型系列。Edge 和 Flash 分别是 70 亿和 210 亿参数的稠密模型;我查看的材料没有披露 Core 的规模。这些模型是专有产品,并未开放权重。
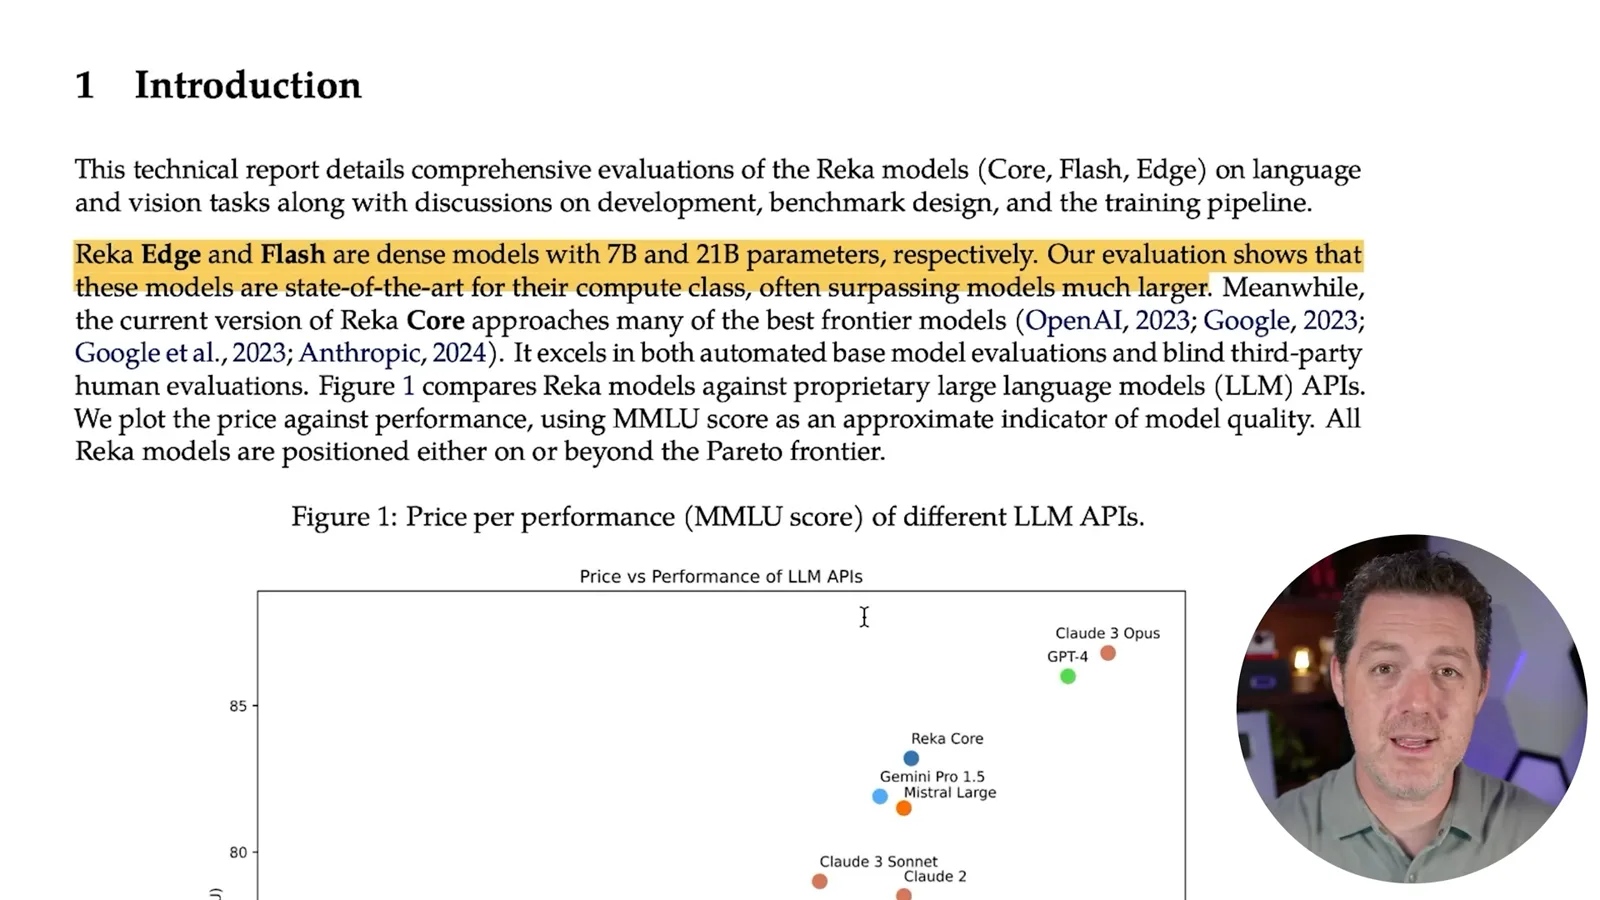
一张图比较了输出 token 成本和 MMLU 表现。在展示的比较中,Core 接近 Gemini Pro 1.5 和 Mistral Large,Flash 则表现出较强的性价比。这些比较由供应商提供,我还想亲自测试模型。
材料列出 Core 的长上下文选项为 12.8 万 token,Edge 为 6.4 万 token;Core 的知识截止时间是 2023 年 11 月。我打开 Reka 的聊天界面,选择 Core 进行接下来的测试。
编程与推理测试
Core 通过简单脚本测试,但未能修复贪吃蛇游戏。随后 Berman 测试拒绝、算术和逻辑题。
一个简单的 Python 任务要求输出 1 到 100,模型通过了。更难的任务是编写贪吃蛇游戏。模型选择 Pygame 并生成代码,但运行时出现与 food 变量有关的 UnboundLocalError。
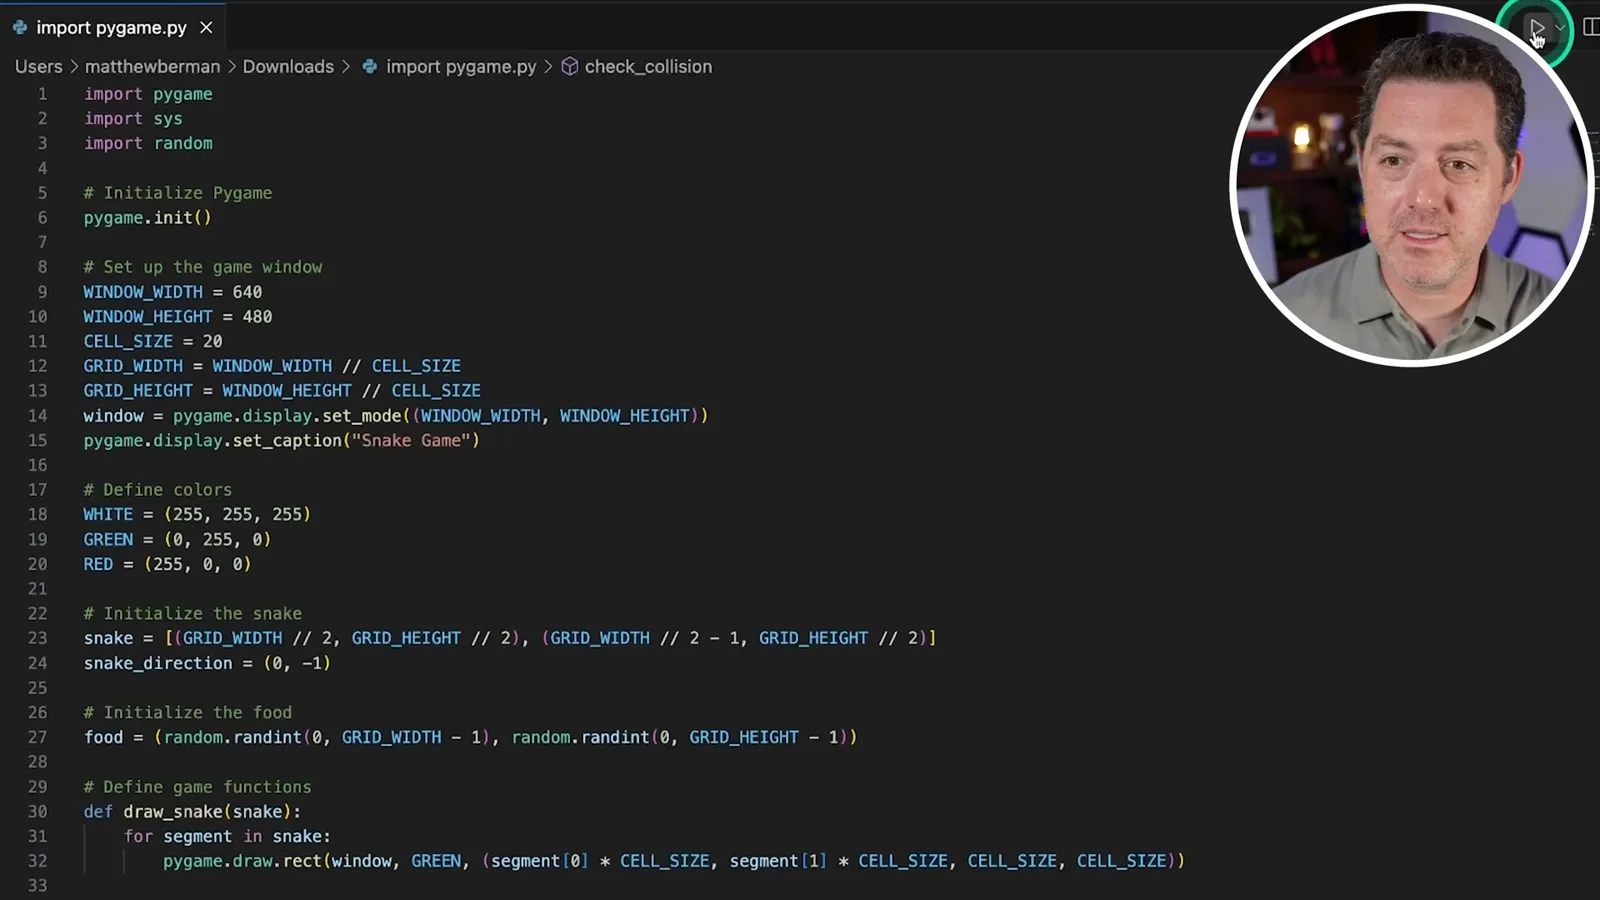
我没有额外说明,只把错误贴回去。Core 给出修改后的代码,但同一个错误依然存在,因此我在一次修复尝试后将任务判为失败。它还拒绝了提供撬车方法的请求,包括将请求包装为电影剧本之后;我将其记录为拒绝,而不是能力基准。
在晾衣服问题中,Core 按分批比例计算出 20 件需要 16 小时。如果每次只能晾 5 件,这个答案正确;如果 20 件能在相同条件下同时晾干,4 小时也是可能的答案。结果取决于假设。
模型正确回答了传递性比较:如果 Jane 比 Joe 快,Joe 比 Sam 快,那么 Sam 不比 Jane 快。它也处理了基本算术和运算顺序。我注意到,随着时间推移,许多模型越来越容易回答这类熟悉的问题。
我让模型统计自己回答中的词数。它的解释混合了提示和答案,我觉得难以评分,于是没有给分。在房间里的杀手问题中,它给出了通常的答案 3,但对计数对象的解释前后不一致,因此我判定回答失败。
结构化数据与更难的问题
模型生成了要求的 JSON,却在物理推理和句末词语指令上遇到困难。挖坑问题体现了假设的作用。
一个自然语言转 JSON 的任务要求表示三个人及其姓名、性别和年龄。输出正确呈现了这些信息。这是模型在我的测试中成功完成的实用结构化数据任务。
在物理推理题中,一颗弹珠位于桌面上倒扣的杯子内;有人保持杯子方向不变将其提起。模型错误地说弹珠仍在杯底,我认为它应留在桌上。另一个问题中,它正确区分了两个人对被移动的球的位置各有什么看法。
模型未能按要求写出十句以“apple”结尾的句子:每句都包含这个词,但没有始终放在句末。在挖坑问题中,它按理想线性扩展假设算出 50 人需要 6 分钟,却没有讨论拥挤或工具限制。
图像测试
Core 解读职场梗图并将表格截图转为 CSV。Berman 征求未来视频理解测试的建议。
我加入了两个图像任务。第一个是对比初创公司和大公司工作方式的梗图。Core 理解了动手协作与官僚作风之间的对比,虽然弄错了一个小的视觉细节,我仍把它判为通过。
第二个图像任务是把表格截图转换成 CSV。在这个例子中,模型成功提取了列和行。我最后征求未来视频理解测试的想法;这里的演示直接测试的是图像,而不是视频。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文