30 秒看懂
Matthew Berman 解读复旦大学与上海人工智能实验室的一篇论文,介绍可能复现 o1 式推理的方法。他解释初始化、奖励信号、搜索和学习如何协同,并区分作者的假设与 OpenAI 系统已确认的细节。
- 1一份推测性路线图综述汇集了可能复现 o1 式推理的技术,并未揭示 OpenAI 的专有配方。
- 2四个组成部分论文以策略初始化、奖励设计、搜索和学习构建框架。
- 3奖励推理过程中间反馈可以定位推理链中的错误,而不仅是给最终答案打分。
- 4两种搜索模式树搜索探索替代方案,顺序修订则逐步改善一次尝试。
- 5开放问题通用领域、多模态推理和世界模型需要超越简单对错测试的反馈。
要点建议
- 推理时计算为改善困难推理任务提供了另一种方式。
- 推理系统将初始能力与反馈、搜索和学习结合起来。
- 过程奖励评价中间推理步骤,结果奖励评价最终答案。
- 树搜索探索不同分支,顺序修订则反复改进已有解答。
- 论文对 o1 的解释属于推测,也指出了超出易验证任务范围的挑战。
按章节阅读整理后的全文
推理与推理时计算
Berman 介绍这篇研究综述,以及模型为何可以在回答时投入更多计算。他还将讨论放在 OpenAI 的 AGI 框架中。
复旦大学与上海人工智能实验室的一篇论文梳理了 OpenAI o1 这类推理模型可能的构建方式。作者提出复现测试时计算能力的框架;这是一种有依据的假设,并非对 OpenAI 专有方法的确认。
思考模型的核心思路是在推理阶段投入更多计算:收到提示后,先生成较长的推理过程再给出答案。我认为这能改善复杂数学、科学、逻辑和编程任务的表现。论文讨论的是 o1,撰写时 o3 尚未发布。
论文将 o1 放在 OpenAI 五阶段 AGI 框架中的“推理者”阶段。其他阶段包括聊天机器人、能够行动的智能体、协助发明的创新者,以及由 AI 运营的组织。我认为智能体方向已出现进展,但后面几个阶段仍属于推测。
o1 系统卡报告称,增加强化学习和推理时的计算量能够改善表现。在我看来,这意味着训练之外又出现了一个扩展维度:让模型在回答问题时投入更多计算。我认为这是 2024 年 AI 领域的重大进展之一。
四个组成部分
综述将可能的组成部分分为初始化、奖励、搜索和学习。每个部分对应推理过程中的不同环节。
研究者将讨论分成四个部分:策略初始化、奖励设计、搜索和学习。初始化建立模型的起始能力;奖励设计提供反馈;搜索探索可能的答案;学习则依据经验改变行为。
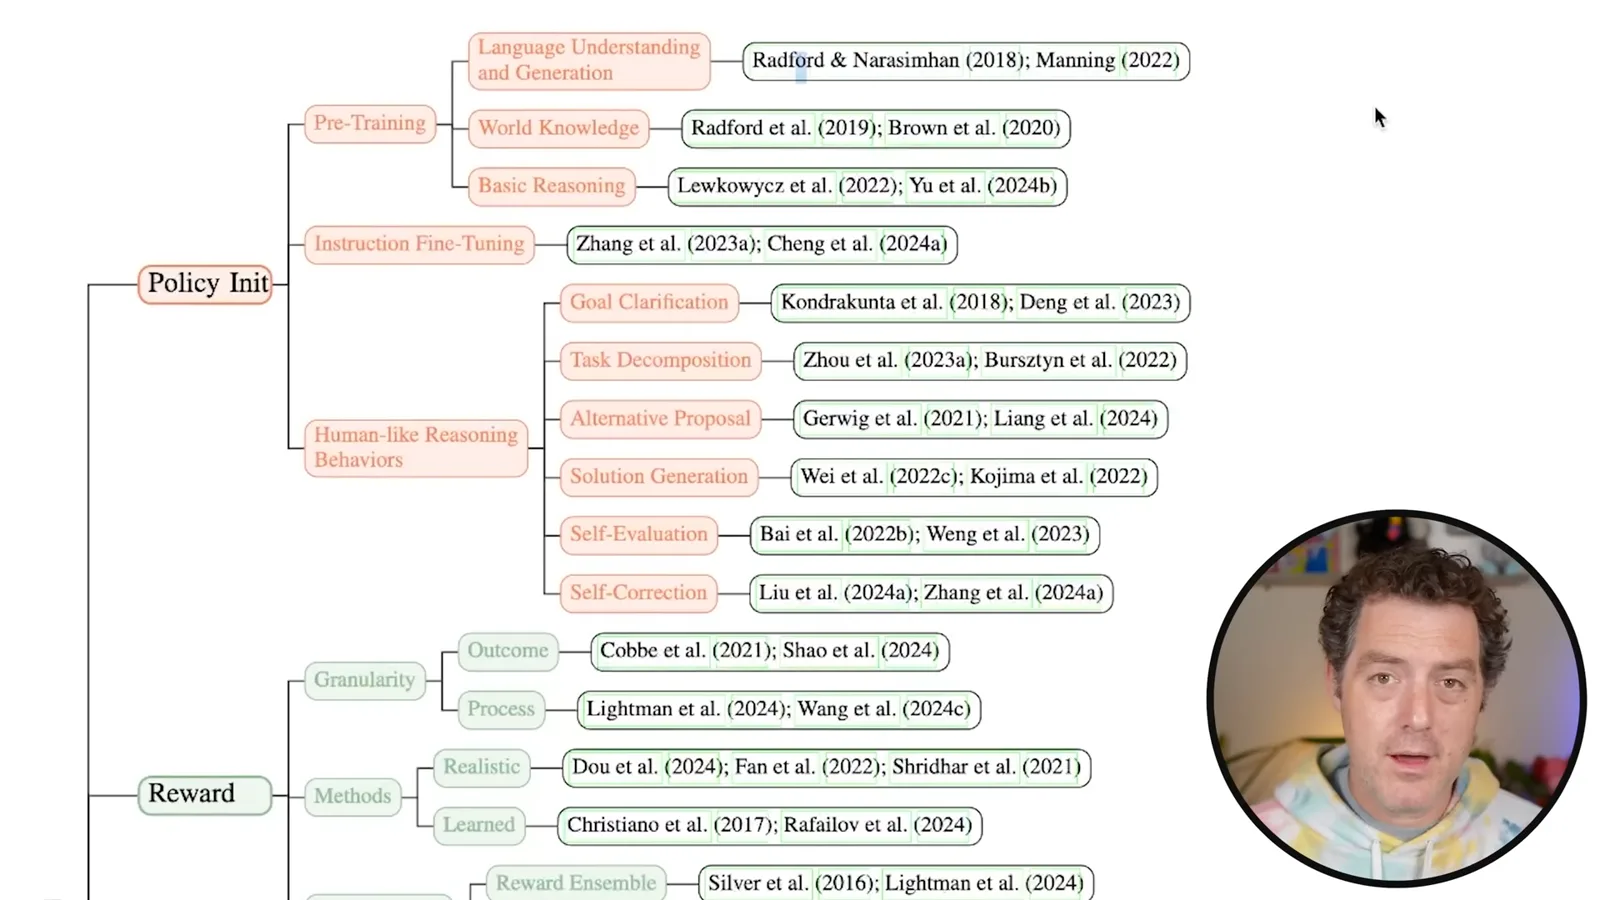
初始化包括预训练、指令微调和类似人类的推理行为,例如明确目标、分解任务、提出替代方案、生成解答、评估结果和纠正错误。这些是后续搜索和学习的基础。
奖励告诉系统应该追求什么。下国际象棋时,简单的信号可以区分输赢;语言任务则更难,因为正确性与质量未必一目了然。因此,为这些问题设计反馈是一项核心挑战。
搜索既可以发生在训练时,也可以发生在推理时。模型可以生成多个解法,评估之后继续迭代。强化学习利用与环境交互得到的反馈;自动反馈能够减少对昂贵人工判断的依赖,但反馈质量依然重要。
初始化推理行为
模型可以分析和分解问题、生成替代方案,并评估或纠正自己的解答。作者讨论了模型可能如何学习这些行为。
在强化学习中,策略规定智能体如何根据所处状态选择行动。对语言模型而言,行动可以从三个层级理解:完整解答、单个推理步骤,以及组成步骤的 token。
作者描述了六种可以通过提示激发或从专家轨迹中学习的推理行为。第一种是分析问题:重述问题,找出隐含约束,把抽象要求变成可执行的规格。编写提示时,你可以先让模型指出缺失的信息。
任务分解将复杂问题拆成可管理的小任务,就像按照步骤组装家具。在编程例子中,模型可以分别处理读取输入字符串、去除空格和解析字符串。接下来的任务完成环节则逐一解决这些明确的小问题。
当一条路径走不通时,提出替代方案就能生成其他思路。论文以破解密码为例;调整采样设置也能产生更多样的候选方案。逐步推理有助于处理复杂任务,但不能保证答案正确。
自我评估要求模型检查提出的解答。我常发现评估与生成结合很有用,多智能体系统尤其如此:一个智能体给出答案,另一个负责批评。自我纠正则提出修复方案并再次测试,形成闭环。
研究者推测,推理模型需要足够的上下文容量来生成长而多样的推理过程。他们还讨论了代码和结构化逻辑数据可能提升推理能力的证据,以及自我反思训练。这些是可能的组成部分,并非披露 o1 的训练配方。
设计奖励
结果奖励和过程奖励提供不同层级的反馈。测试、学习得到的奖励模型和 AI 裁判可以在不同场景下提供信号。
奖励模型可以评价结果,也可以评价过程。结果奖励检查最终答案;过程奖励则评价中间步骤。如果前几步正确而后面出错,过程反馈可以指出需要修改的位置,而不是把整次尝试一概判为错误。
反馈可以来自真实环境。例如,针对代码运行测试,可以告诉模型输出是否符合预期。但真实反馈可能成本高,也可能在测试时无法获得,此时可以用学习得到的奖励模型来估计反馈。
另一种方法是 AI 裁判:由一个模型评价另一个模型生成的候选答案。作者推测,处理多领域任务的系统可能结合多种奖励方法,而过程监督对较长的数学和编程推理尤其有用。这仍是他们的假设。
世界模型与搜索
Berman 讨论有关世界模型的不同观点,随后解释搜索和候选答案的选择。搜索可以针对完整解答、步骤或 token 进行。
论文也提出了世界模型的问题。研究者对仅靠语言能否建立世界模型存在分歧;其他人则探索视频,或预测未来状态的表征。我提到 Yann LeCun 的研究和李飞飞创办的 World Labs,作为不同路线的例子。
搜索在奖励或启发式规则的指导下,探索多次尝试或不同推理路径。论文认为,搜索能改善训练和推理两个阶段的结果。这意味着,配合有效搜索程序的小模型有时可能胜过没有这种程序的大模型。
自一致性方法采样多个解答,再通过投票等方式选择一致的答案。自我评估则让模型检查自己的输出。两者都依赖选择信号的质量;论文将“评估比生成容易”称为一种假设。
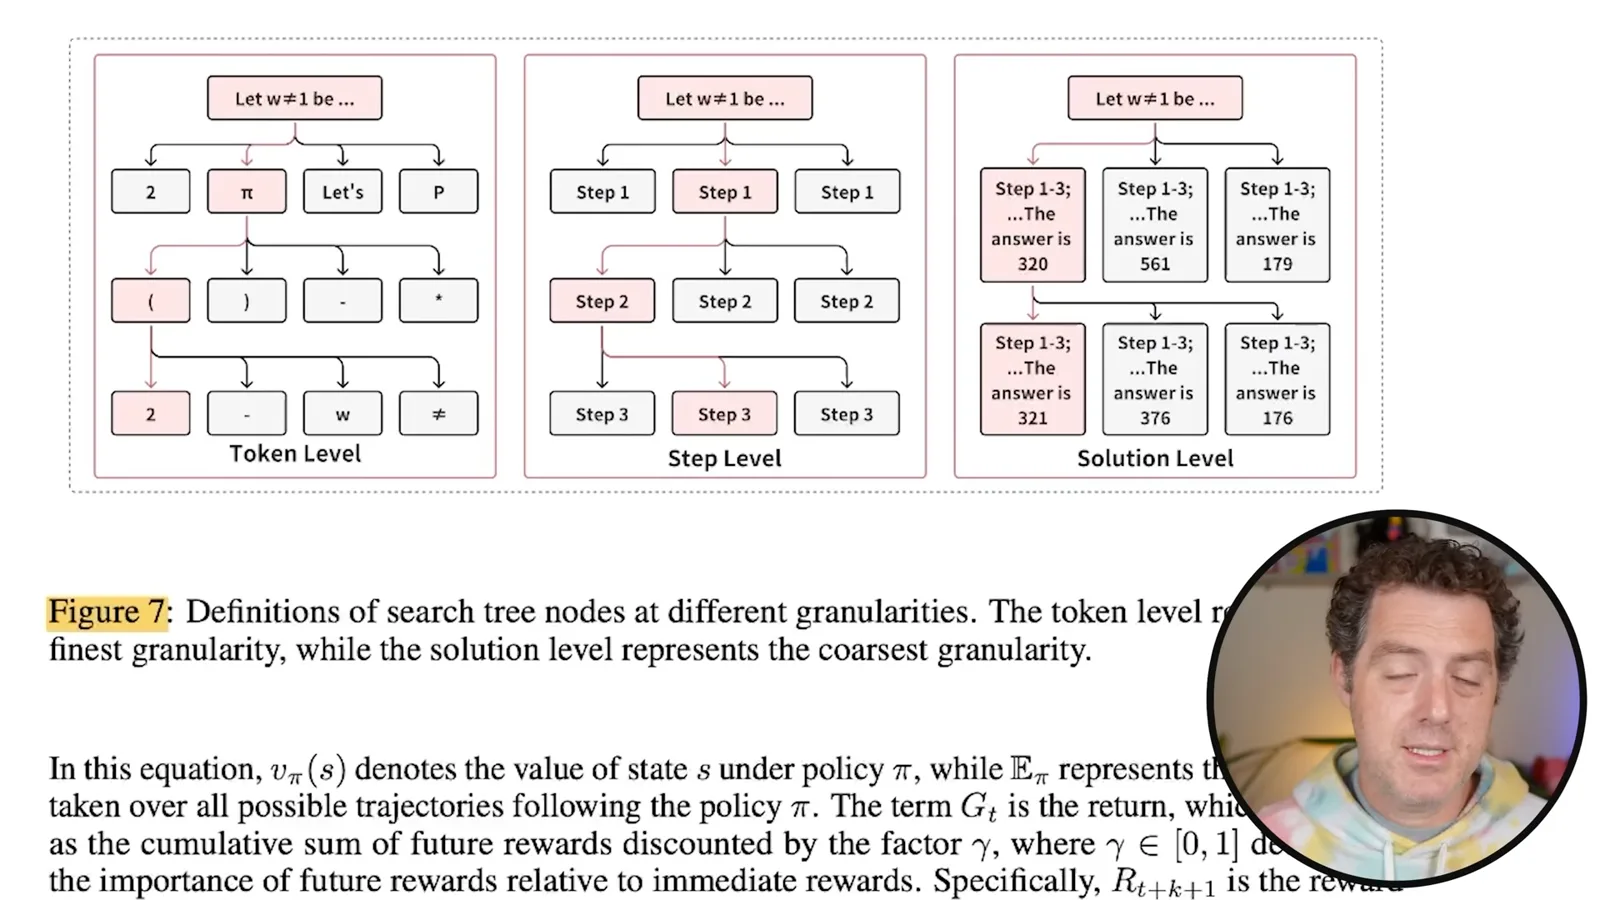
搜索可以在完整解答、中间步骤或单个 token 的层级进行。完整解答层级把候选项作为整体评价;步骤层级比较下一步的可能选择;token 层级则进行更细的决策。
搜索方法与强化学习
树搜索和顺序修订在探索上各有取舍。强化学习可以利用交互来改善策略。
论文区分了树搜索和顺序修订。树搜索探索多个解答分支,顺序修订则反复改进已有尝试。两者需要在探索广度和迭代改进的效率之间权衡。
Best-of-N 采样生成多个候选答案,再用奖励模型选出一个。束搜索会扩展和剪除部分序列。蒙特卡洛树搜索通过模拟探索估计不同动作的价值;增加模拟次数可以改善估计,但也会消耗更多计算资源。
顺序修订先生成答案,再进行反思、改进并重复这一过程。论文推测,训练时搜索可能偏向借助外部指导的树搜索,推理时则可能采用结合内部指导的顺序修订。作者并未声称掌握 OpenAI 的实现细节。
强化学习可以通过交互产生经验,减少对稀缺人类专家样本的依赖。我用围棋说明反复对弈如何发现强大的策略。AlphaGo 著名的第 37 手让人类观察者感到意外;不过,AlphaGo 的发展过程也使用了人类棋谱,因此不能将自我对弈等同于完全没有人类示例。
开放研究与未来方向
讨论最后介绍开放实现,以及通用领域、多模态和世界模型方面尚未解决的问题。
论文梳理了受 o1 风格推理启发的开放实现和研究项目。我还提到了 DeepSeek R1 和 QwQ 等更易获取的推理模型研究。方法和项目的开放让研究者有机会开展实验,尽管其表现可能与专有系统不同。
尚未解决的问题包括:如何让推理适应难以直接验证答案的领域、如何加入多种模态,以及如何在世界模型中学习或搜索。这些问题关系到如何将强大的推理能力应用于反馈不完整或模糊的现实环境。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文