







筛选结果
63 篇排序
 25:50EN → 简体中文
Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文
本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 2:00:51EN → 简体中文
 Cognitive Revolution "How AI Changes Everything"· 2026年10月10日播客在每个 Token 处重新采样,就能看见模型怎样做决定主持 Nathan LabenzGoodfire 的 Eric Bigelow 谈分叉路径、上下文学习,以及为什么越来越难信任思维链(chain-of-thought)监控。
 21:29EN → 简体中文
Mistral Large 4 预览版:欧洲开放权重、网络安全基准与设置障碍Matthew Berman · Forward FutureMatthew Berman 回顾模型公布的规格和基准,并在智能体编程工作流中进行测试。
 56:31EN → 简体中文
 Unsupervised Learning: With Jacob Effron· 2026年10月6日播客后训练赢在推理:为什么掌控权重,胜过押注某一家实验室主持 Jacob EffronApplied Compute 的 CEO Yash Patil 认为,掌控权、私有评测,以及在最大的工作负载上做后训练,比担心前沿实验室变得恶意更重要。
 20:46EN → 简体中文
开放权重 AI 模型:Token 份额、支出与战略取舍Matthew Berman · Forward FutureMatthew Berman 分析 Vercel AI Gateway 的一份快照,说明模型使用量与支出可能呈现截然不同的情况。
 2:06:11EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2026年8月14日播客Lindy 跑在 DeepSeek 上,CEO 却主张禁用中国模型主持 Nathan LabenzFlo Crivello 向 Nathan Labenz 讲述 Lindy Teammate 如何住在 Slack 里、如何用两次模型调用就调出 20 亿个 token 的记忆,以及他为什么仍想禁止那些目前支撑着这款产品的廉价中国模型。
 2:16:29EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2026年8月2日播客从每月两篇到每月六十篇:两周中国行看到的 AI 安全主持 Nathan LabenzNathan Labenz 认为,那句耳熟能详的“中国绝不会慢下来”,一接触到中国真实的 AI 安全生态就站不住了。
 52:29EN → 简体中文
Claude Opus 5:基准测试、任务成本与初步体验Matthew Berman · Forward FutureMatthew Berman 直播解读模型发布、评测和定价,并说明为什么完成任务的成本比单纯的 token 单价更值得关注。
 27:13EN → 简体中文
Kimi K3 与开放权重 AI 之争Matthew Berman · Forward FutureMoonshot AI 宣布 Kimi K3 后,Matthew Berman 探讨模型经济性、竞争与安全方面的争论。
 1:47:38EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2026年7月4日播客19 个神经元就能开车,Liquid AI 想把基础模型装进每一块芯片主持 Nathan LabenzRamin Hasani 从线虫只有 300 个细胞的大脑讲起,一直讲到将在梅赛德斯-奔驰汽车里开口说话的 600 兆字节模型,并解释为什么如今的架构搜索,已经胜过那些凭经验拍板的“架构复仇者”。
 1:06:36EN → 简体中文Unsupervised Learning: With Jacob Effron· 2026年6月12日播客账单一夜翻倍,接下来 API 可能会消失主持 Jacob Effron隔了半年,Ari Morcos 和 Rob Toews 再次与 Jacob Efron 碰面,讲了为什么编程智能体终于能用了,为什么接近前沿的开放权重模型可能已经见顶,以及算力短缺为何可能让公开 API 被拔掉插头。
 1:42:54EN → 简体中文
AI 与网络安全:Matthew Berman 的警告、预测与未解问题Matthew Berman · Forward Future一场直播回顾据报道的 AI 辅助威胁,并讨论更强的防御模型能否跟上攻击者。
 54:26EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2026年2月22日播客100 亿活跃参数,以及让模型适配智能体的枯燥工作主持 Nathan LabenzMiniMax 研究员 Olive Song 讲解了 M2 的训练方法:她把专家开发者当作奖励模型(reward model),采用交错思考(interleaved thinking),并搭建了扰动流水线,把每一次脚手架变动都当作真正的泛化考验。
 4:25:13EN → 简体中文
 Lex Fridman· 2026年1月31日播客架构几乎没变,变的是数据、成本和开放权重主持 Lex FridmanNathan Lambert 和 Sebastian Raschka 带 Lex Fridman 回顾了这一年:训练方法和数据集的变化,远大于模型设计的变化。展望 2026 年,争论的焦点似乎是推理成本、智能体,以及真正开放的模型该归谁。
 1:54:30EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2026年1月9日播客癌细胞比例从 1/10 降到百万分之一主持 Nathan LabenzNathan Labenz 独自主持的 AMA(有问必答),更新了儿子淋巴瘤的治疗情况,称 Claude Opus 4.5 为软件层面的通用人工智能(AGI),并盘点了 2026 年初仍具竞争力的玩家。
 1:18:40EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2026年1月1日播客当 AI 成了油井:Luke Drago 谈“智能诅咒”(intelligence curse)主持 Nathan LabenzWorkshop Labs 联合创始人在未来生命研究所(FLI)的播客中讲述,非人类生产主导的世界为何可能重演资源诅咒(resource curse),以及私人数据、开放权重(open weights)和登月式的职业选择,或许仍能打破这一局面。
 1:32:38EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2025年12月6日播客波兰语只占前沿训练数据的 1%,所以波兰自己做了一个模型主持 Nathan Labenz波兰国家信息处理研究所的 Marek Kozlowski 讲解 PLLuM 如何借助语言适配、有机指令和本地部署的小模型,让一个中等规模的国家掌握自己的 AI。
 1:09:48EN → 简体中文Unsupervised Learning: With Jacob Effron· 2025年12月5日播客中国 AI 实验室从 15 家减到 6 家,算力差距是 15 比 1主持 Jacob EffronJordan Schneider 在《Unsupervised Learning》节目中说,中国的模型是私人资本的故事,北京仍然从硬件的角度看问题。西方真正的优势,在于它能够对外供应的芯片,并非什么国家统筹的总体规划。
 1:25:54EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2025年12月3日播客训练结束数小时后,Z.ai 就把权重放上了互联网主持 Nathan LabenzZ.ai 的 Zixuan Li 向 ChinaTalk 讲述中国实验室如何发布 GLM,如何把开放权重当作进入西方生态的门票,以及他们仍然如何看待自己:一家后起之秀。
 17:51EN → 简体中文
2025 年 8 月 AI 新闻:Claude for Chrome、新模型与 AI 基础设施Matthew Berman · Forward FutureMatthew Berman 回顾浏览器智能体预览版、模型发布、有关 Apple 的讨论报道,以及推理和天气研究。
 1:01EN → 简体中文
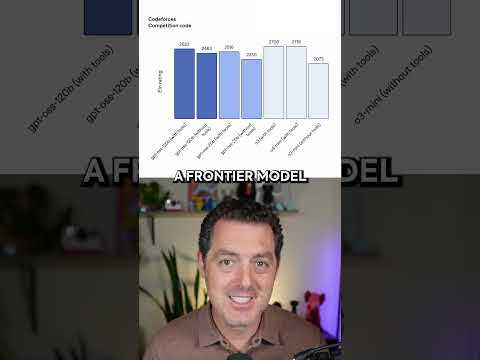
OpenAI 发布 gpt-oss 与一项编程基准Matthew Berman · Forward FutureMatthew Berman 介绍两个开放权重模型,并解读发布时的 Codeforces 比较。
 2:14:55EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2025年7月26日播客从 Character AI 到 1% 的预警事件:Gabriel Weil 主张用法律责任治理 AI主持 Nathan LabenzTouro University 法学教授在与 Nathan Labenz 的对谈中说明:过失责任、严格责任和惩罚性赔偿,可以如何让前沿实验室把公众风险当作落在自家资产负债表上的损失。
 23:39ZH
 跟李沐学AI· 2025年7月23日李沐:给文本大模型加入一千万小时语音,开源 Higgs Audio李沐 · Boson AI李沐介绍团队如何在文本大语言模型的训练里加入大量语音数据,做成能听能说的 AudioLLM,并把 Higgs Audio 开源。他讲了架构取舍、token 压缩、数据从哪来,以及怎么在 3090 上跑起来。
加载更多已显示 24 篇,共 63 篇