30 秒看懂
在 2026 年 5 月的直播中,Matthew Berman 讨论报道中的网络事件、漏洞研究和 AI 辅助攻击的经济性。他也对模型能力与安全提出推测性预测;文章区分了这些观点和他引用的报告。
- 1一项报告中的漏洞利用Google 描述了一项据信由 AI 开发的漏洞利用工具,并说提前发现可能阻止更大范围的使用。
- 2Vercel 事件Berman 阅读 CEO 对 AI 加速攻击的怀疑;直播没有确认使用了哪些工具。
- 3更强模型的假设Berman 认为更强的防御模型应当胜过较弱的攻击者,观众则质疑这一前提。
- 4小目标的长尾他预测成本降低可能让更多低价值攻击有利可图。
要点建议
- 直播讨论了 Google 对一项疑似 AI 开发的漏洞利用工具及可能的防御性提前发现的判断。
- 供应链攻击和凭据盗窃可能成为进入更广泛环境的途径。
- Berman 关于更强模型防御能力的论点依赖一些受到观众质疑的假设。
- 他预测,攻击成本下降可能让更多小目标面临攻击尝试。
- 开放模型既有合法防御用途,也存在潜在滥用风险。
按章节阅读整理后的全文
报道中的威胁
Berman 介绍报道中的 AI 辅助漏洞利用和软件供应链事件。
我担心近期关于网络攻击频率和严重性上升的报告,包括用 AI 加速行动或发现漏洞。这场 2026 年 5 月的直播结合了报告和我自己的预测,后者不应当作已经确定的结果。
Google 威胁情报团队表示,它发现一个威胁行为者使用了据信由 AI 开发的零日漏洞利用工具。Google 还说自己的提前发现可能阻止了一场计划中的更大规模攻击;公司的判断包含不确定性。
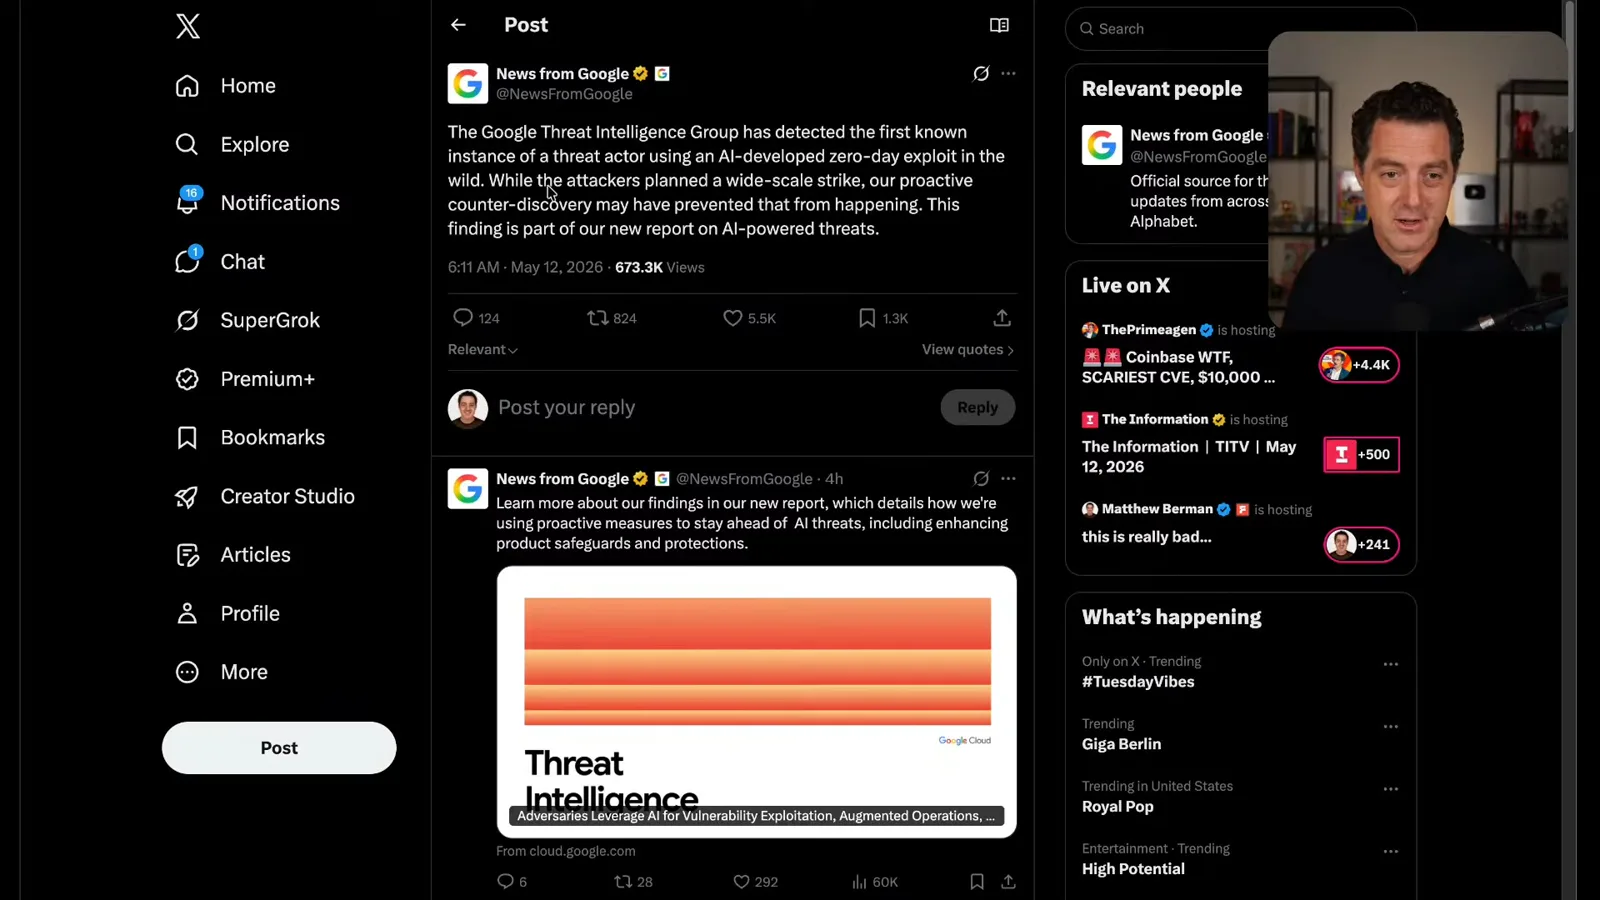
我解释说,在修复措施出现之前,零日漏洞可能很有价值,攻击者也可能保留它等待时机。发现漏洞、开发利用工具和实际利用是不同的事情。
接着我讨论关于 Shai-Hulud 软件包供应链蠕虫的报道,以及另一份关于被盗令牌撤销后触发破坏行为的报告。我引用直播时报道中不断变化的受影响软件包数量,没有独立核实每个案例。
我认为更多 AI 生成代码以及对安装依赖审查不足可能扩大暴露面。我承认自己经常不仔细检查生成的代码,同时指出我的项目规模相对较小。
我讨论报道中的凭据盗窃,并担心自动化可能提高尝试的数量和速度。一起事件涉及凭据被盗,本身并不能证明 AI 到底起了多大作用。
我猜测,由于服务商设置了安全措施,攻击者未必在所有工作中使用最新的托管模型。直播中我没有证据确定每起攻击具体使用了哪些模型。
Vercel 和 Google 报告
他阅读事件更新,讨论 AI 在攻击和防御工作流中的作用。
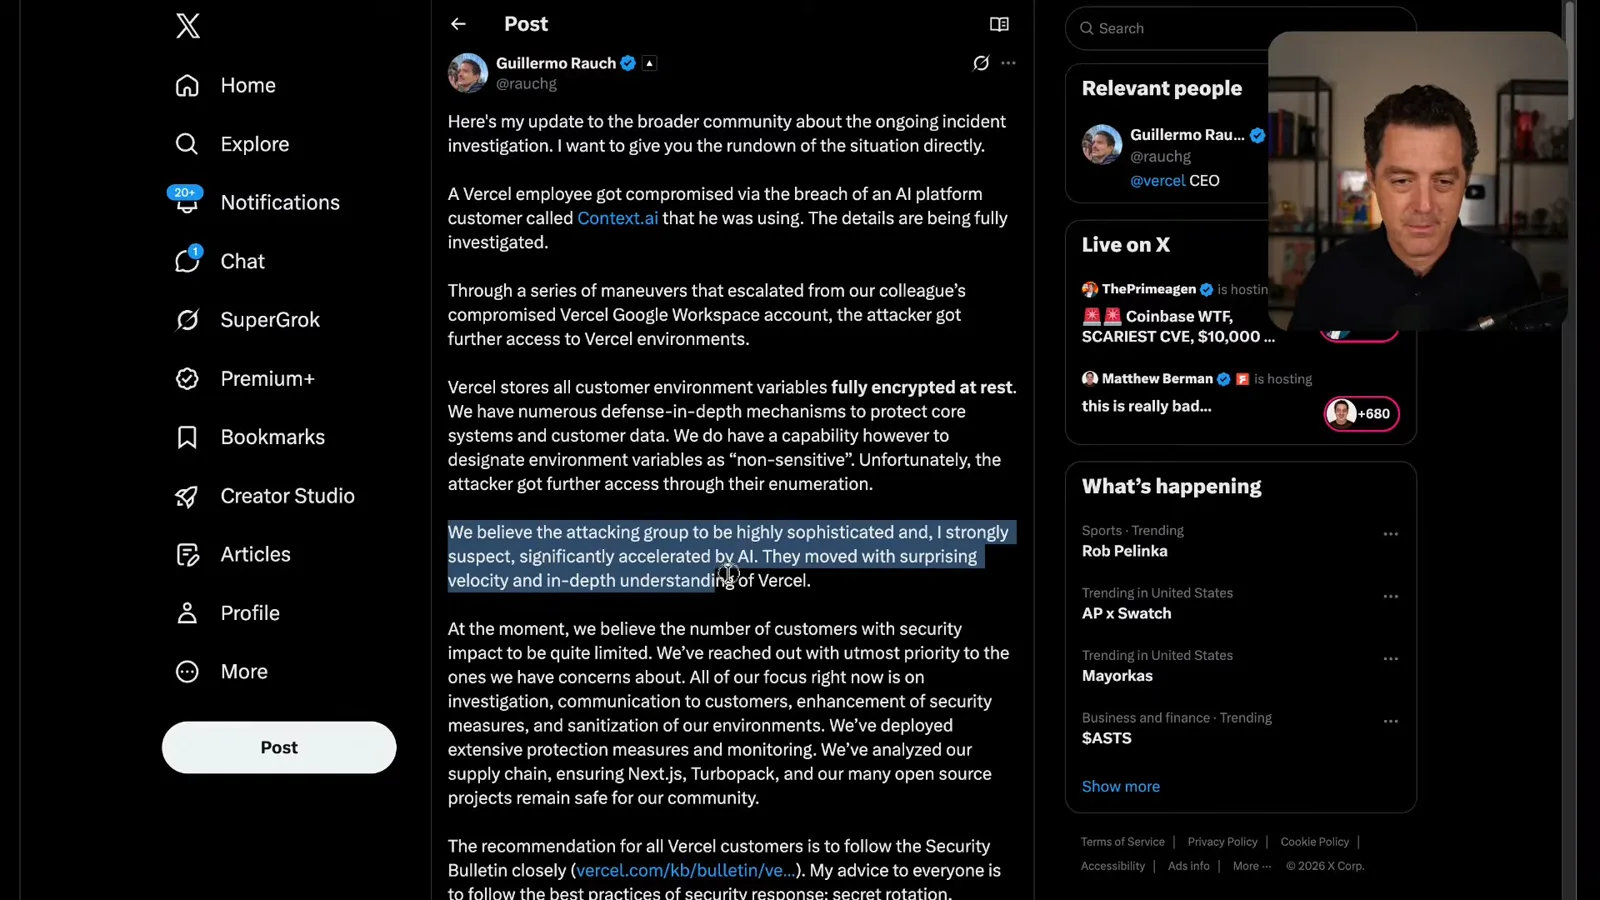
我转向 Vercel 2026 年 4 月的安全事件,并阅读公司的公开更新。其 CEO 说他强烈怀疑 AI 加速了攻击者的行动;这是公开表达的怀疑,并非对具体工具的证明。
更新描述了一名员工因第三方服务事件而受到影响,攻击者随后获得对 Vercel 环境的进一步访问。我称赞公司的沟通,同时用这个事件讨论 AI 辅助攻击可能达到的速度。
回到 Google 报告,我读到它将 AI 同时描述为对手的工具和攻击目标。报告讨论了漏洞研究、恶意软件开发以及针对 AI 环境的威胁。
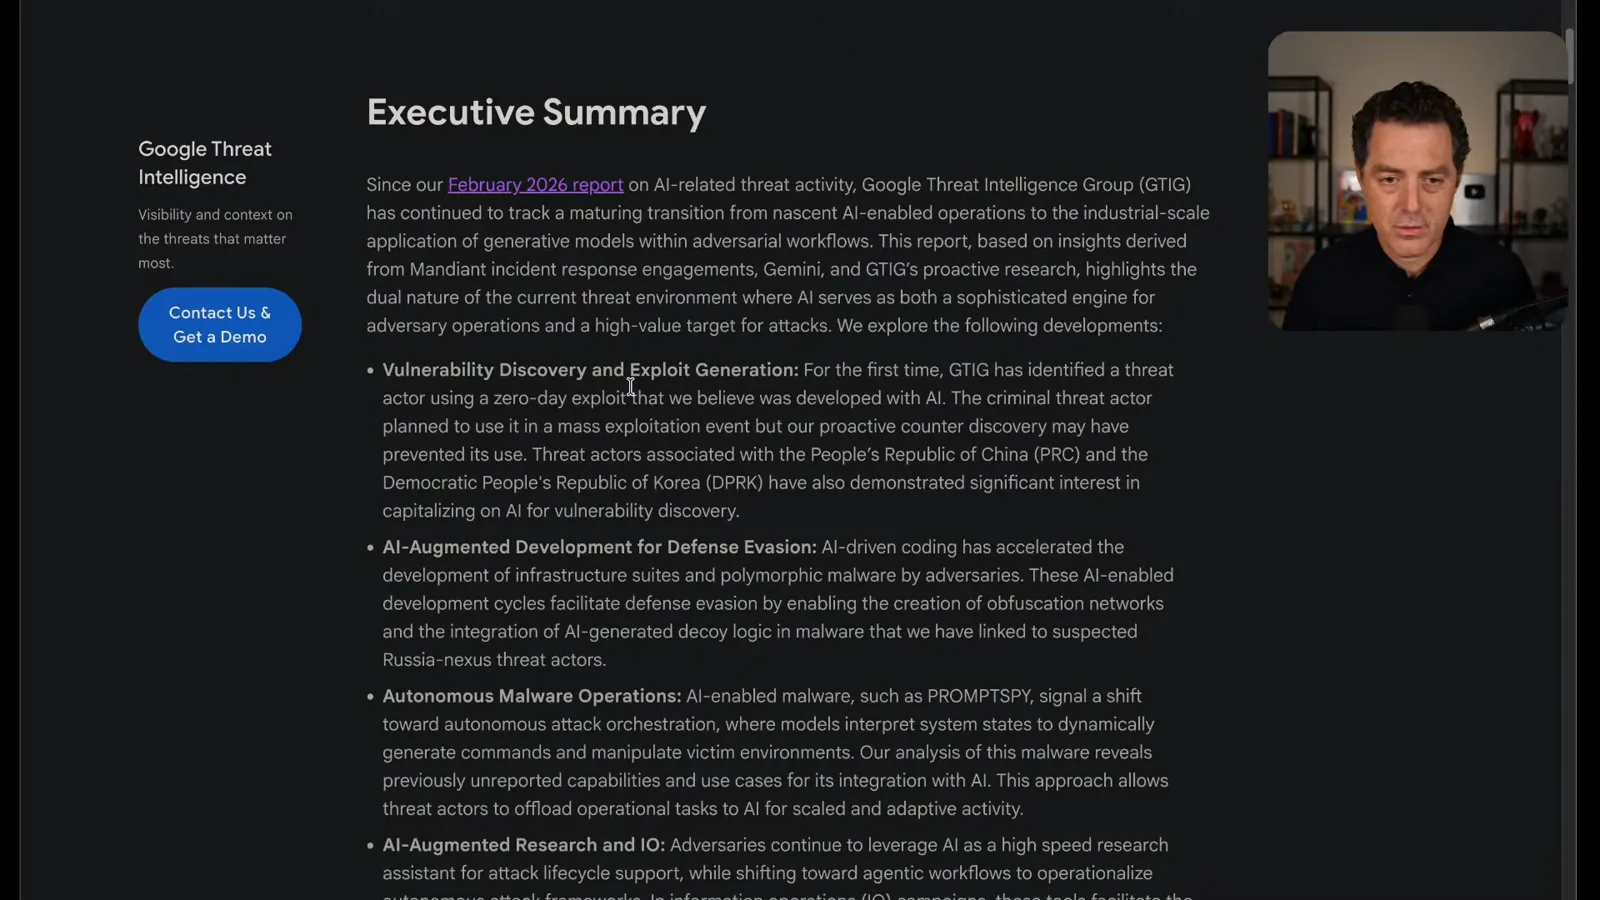
报告以一定程度的置信判断将一项漏洞利用开发案例与 AI 联系起来,并说提前发现可能阻止大规模使用。我将其解读为对漏洞发现速度的警示,而非事件的完整说明。
我强调许多漏洞原本就存在于代码中,攻击者或防御者都可能发现它们。我进一步说 AI 不会制造漏洞,这种说法过于绝对:新生成或修改的代码也可能引入缺陷。
报告还描述了 AI 辅助开发和规避防御。我担心更快的软件生产会降低构建恶意工具所需的工作量,但应区分报告中的案例和我的总体预测。
我考虑自主运行和本地模型。本地运行仍然需要硬件、电力和维护;我的意思是这些途径可能降低某些任务的成本或重复执行的门槛,并非真的免费。
Google 报告还讨论了对托管模型的隐蔽访问,以及滥用试用和账户系统。我表示自己不知道成功滥用有多普遍,尤其是在服务商有检测和安全措施的情况下。
供应链攻击可能以依赖项和 AI 相关软件为入口,进一步影响更广泛的环境。我担心它们的传播能力,但我讨论的事件各不相同,不能当作同一起攻击。
这引出了开放模型和闭源模型的艰难讨论。我仍支持开放模型,同时承认低成本、可修改的模型也可能被恶意行为者使用。
钓鱼与漏洞的未来
他考虑深度伪造,并对软件安全作出推测性预测。
除了软件入侵,我还讨论钓鱼和深度伪造。我回忆与 Pindrop Security 代表关于检测的交流,并建议家人约定验证突发紧急请求的方式。
我提出一个预测:AI 会揭示并帮助修复大量漏洞,最终让软件安全得多。我猜测可能需要两到三年,但这是我的推测,并非已经得到证实的结果。
一位观众质疑攻击者可能引入新漏洞。我回应说更强的防御 AI 可能发现它们,但这个论点依赖访问、部署和检测能力等假设,并非已证明的保证。
我追问漏洞是否会永远存在,并承认自己关于完美软件的想法只是推测。后来我澄清,自己并非真的预期软件能够完全没有漏洞。
更强模型的论点
Berman 和观众讨论算力、人的判断以及更强模型是否保证防御成功。
我概述 Jensen Huang 提出的“我的 AI 对你的 AI”框架,并追问防御方为什么可能拥有更强的系统。我的解释是经济因素:资源密集型模型可能更容易由资金雄厚的机构或国家开发。
我认为较小的犯罪团体可能不如大国容易获得算力和人才。这是经济层面的论点,不能证明每个防御者都有更强模型,也不能证明较弱模型无法找到被遗漏的漏洞。
我提出,如果较强的防御模型漏掉漏洞,较弱的攻击模型也会漏掉。观众以更好的框架、人的判断和创造性组合提出反驳;直播没有解决这一分歧。
一位观众认为小模型加上人的参与仍能发现漏洞。我不同意,并强调模型的上下文处理能力和速度;但模型规模、搜索策略与结果之间的关系在这里仍是开放问题。
我不赞成把它完全类比为冷战,因为网络攻击已经在发生。冲突可以在数字系统中实际发生,同时又不是传统的实体战争。
网络安全模型与防御产品
他讨论 Anthropic 的预览版和 OpenAI 宣布的工具。
我转向 Anthropic 的 Mythos 预览和有限访问方式。我批评公司的宣传方式,同时也考虑限制强大网络安全模型可能减少滥用的论点。
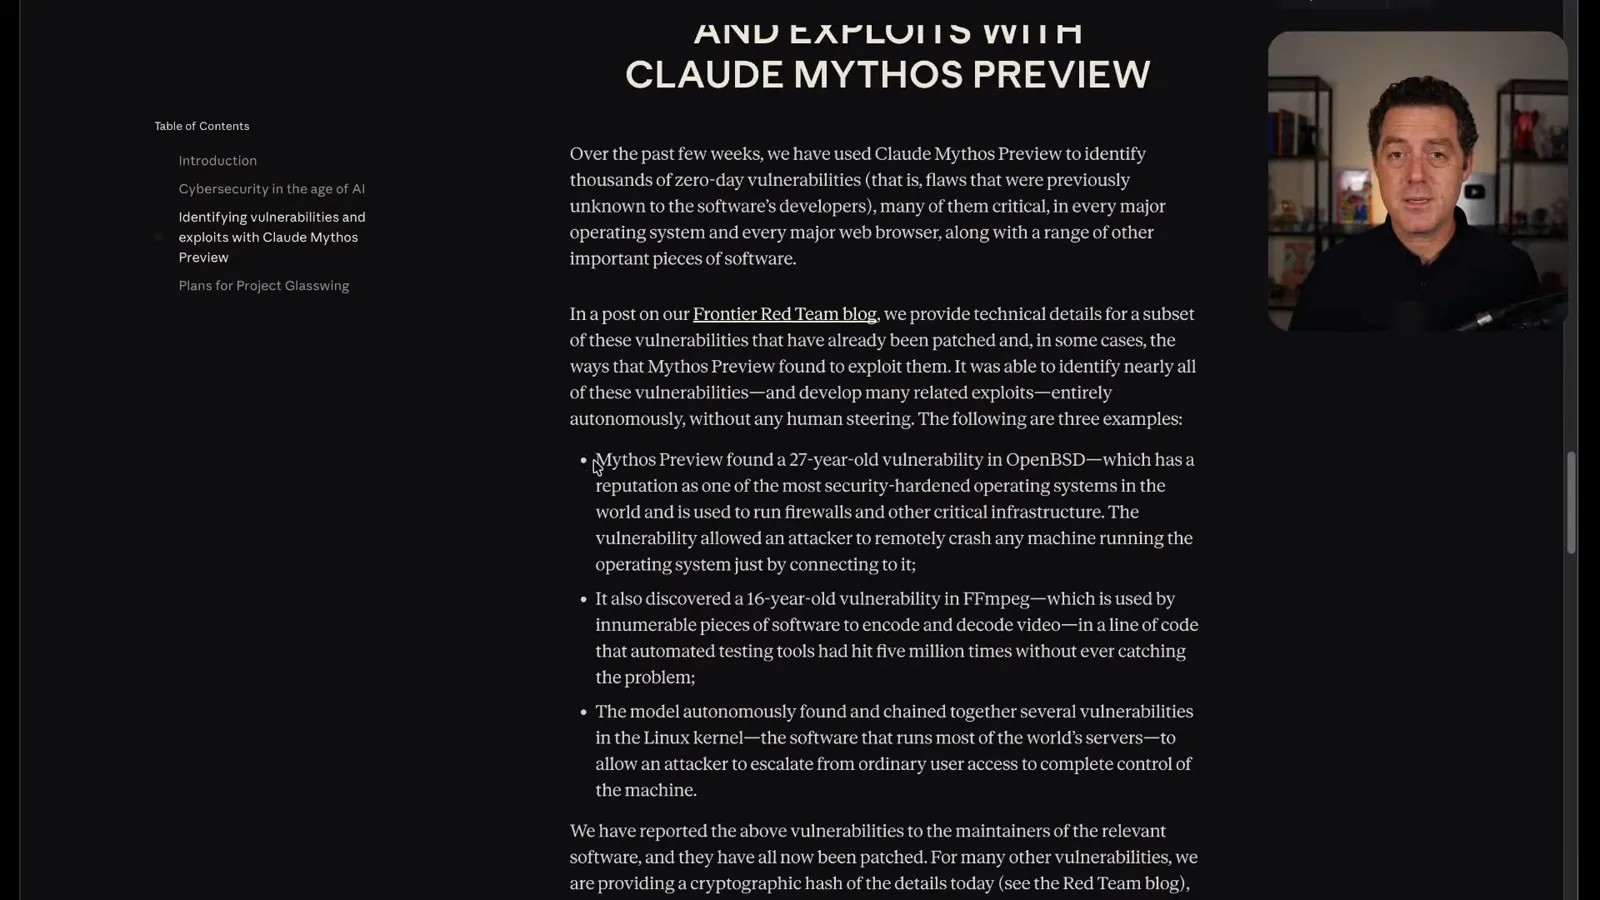
我阅读 Anthropic 报告的 OpenBSD 和 FFmpeg 漏洞,以及涉及 Linux 内核的漏洞链。这些是当时公司报告的研究结果;视频没有独立复现。
我比较屏幕上 Mythos 预览版和 GPT-5.5 Cyber 的 CyberGym 成绩。报告的分数接近,但基准条件和有限例子不能证明它们在所有真实安全工作中等同。
我讨论 OpenAI 的 Daybreak 公告:它被描述为结合模型、Codex 和安全合作伙伴开展防御。我还回忆早期测试 Aardvark 时,一份漏洞报告花费的时间超出预期。
我描述当时介绍的通用工作和授权网络安全工作所对应的不同访问层级与安全措施。产品访问条件和政策可能变化,我对两家公司做法的评价属于个人观点。
攻击经济性与开放模型
一幅手绘草图说明他对小目标遭受攻击的担忧。
一位观众质疑我关于最强模型总需要庞大硬件的假设。我不赞同他们对小设备上高能力模型的预测,但承认自己关于并行能力的回答也是推测。
我认为即使单个小目标带来的收益较少,攻击成本下降后,大规模攻击小目标仍可能有利可图。我画了一条经济曲线,并在直播中指出坐标轴令人困惑,可能需要交换。
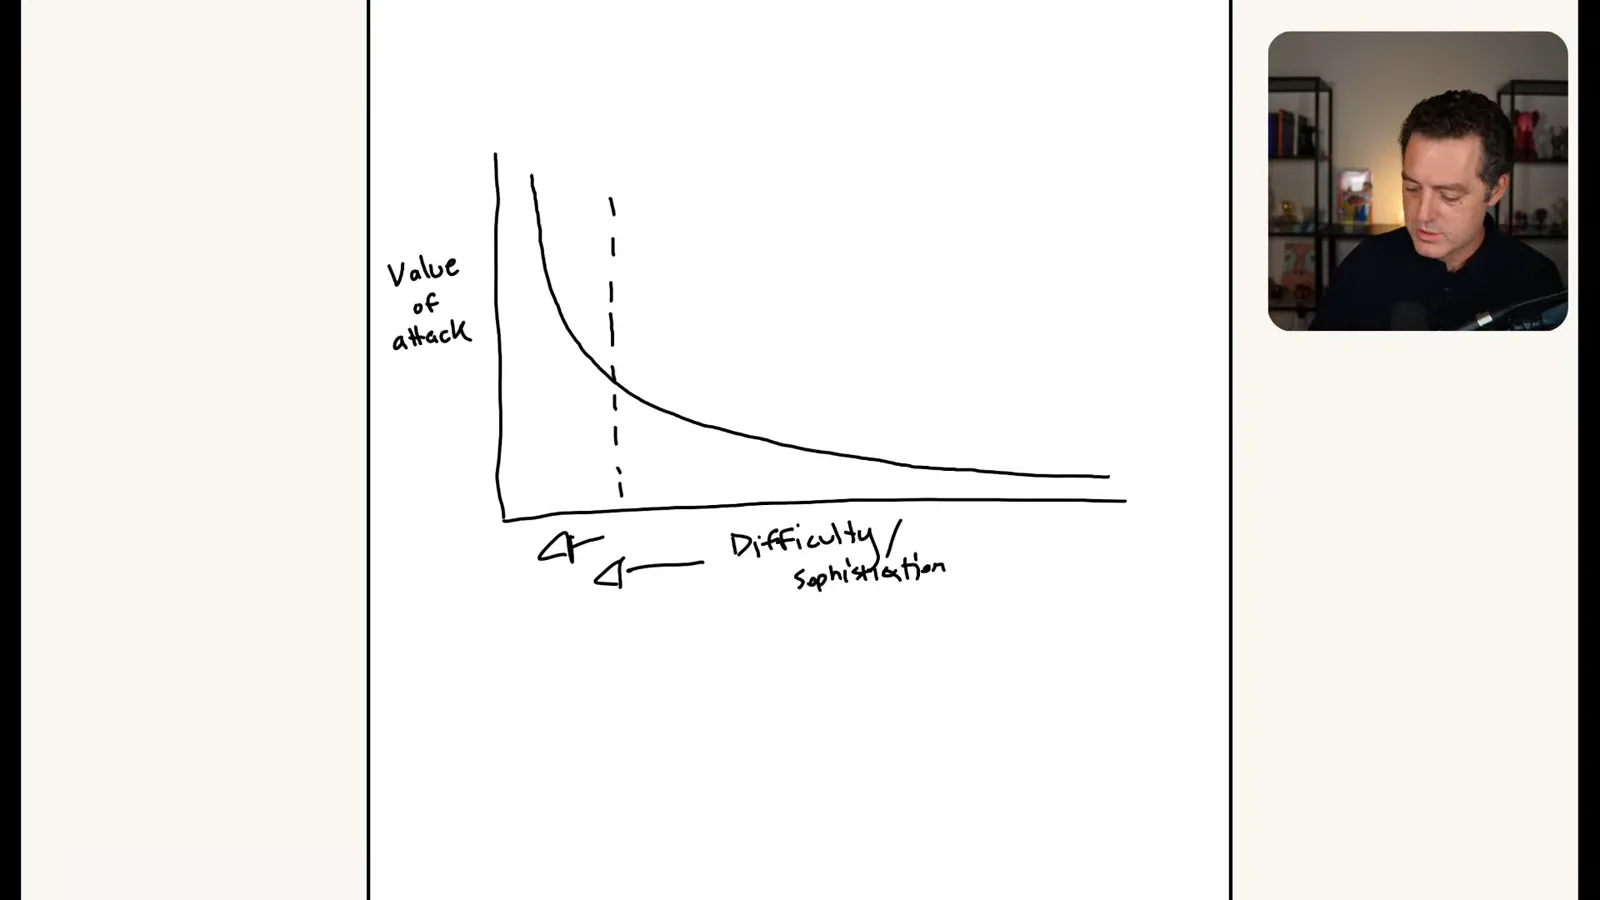
长尾论点与我关于资金充足的防御者能使用更强模型的观点是两个不同问题:许多个人和小组织可能根本没有部署这些防御。我担心这种差距会使他们暴露在风险中。
我再次讨论开放模型的权衡:广泛可用既能帮助合法用户和防御者,也可能为恶意行为者提供低成本工具。我承认这种担忧,但仍支持开放模型。
国家竞争与结论
他讨论地缘政治担忧,以及自己支持开放模型发展的立场。
我播放了 Jensen Huang 参与的一段对话,并概述其中关于 AI 相互对抗的论点。这个片段说明了一种观点,不能证明 AI 防御者总会获胜。
我讨论国家之间的竞争,担心资源充足的政府既能发展强大的防御能力,也能发展进攻能力。我将自己希望美国保持领先的立场,与对中国普通民众的敌意区分开来。
我指出两个担忧:针对大量小目标的低成本攻击,以及资源相近国家之间的竞争。这些是我认为可能出现的情景,并非对发生频率的量化预测。
被问到是否应该禁止中国模型时,我说不应该,并主张支持美国的开放模型发展。这是我的政策偏好;直播结束时,更广泛的安全争论仍没有定论。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文