30 秒看懂
2026 年 7 月,Matthew Berman 以 Kimi K3 为切入点,讨论开放权重模型、推理经济性和美国可能实施的限制。他支持广泛开放模型,同时审视关于安全与蒸馏指控的反对意见;其中若干政策及法律说法属于预测或观点,而非既定结果。
- 1发布公告Moonshot 的帖子介绍了 Kimi K3,并称计划在 7 月稍晚开放权重。
- 2每项任务成本运行模型需要基础设施成本,单纯比较 token 价格可能掩盖任务层面的差异。
- 3政策争论Berman 讨论有关美国可能实施限制的报道,并反对禁令。
- 4蒸馏指控视频介绍 Anthropic 的指控及不同观点,但没有独立判定其真伪。
要点建议
- 开放权重、完整的开源训练方案和免费的托管推理是不同的概念。
- 完成任务的成本取决于模型质量、token 用量、重试次数和基础设施,而不只是 token 价格。
- 开放权重模型有助于竞争和本地使用,同时也让安全防护更难执行。
- 有关可能出台政策限制的报道及蒸馏指控,不能证明禁令已经生效或不法行为已经裁定。
- 展示的证据不能证明关于诉讼结果或国家所有权的概括性说法。
按章节阅读整理后的全文
Kimi 与开放权重
Berman 介绍模型公告及公司可能开放权重的原因。具体开放程度因模型而异。
我探讨 Moonshot AI 的 Kimi K3 公告对开放权重 AI、竞争和美国政策可能产生的影响。我认为该模型可以与领先的专有系统相比,但这一判断取决于任务和基准测试,而非适用于所有情况的排名。
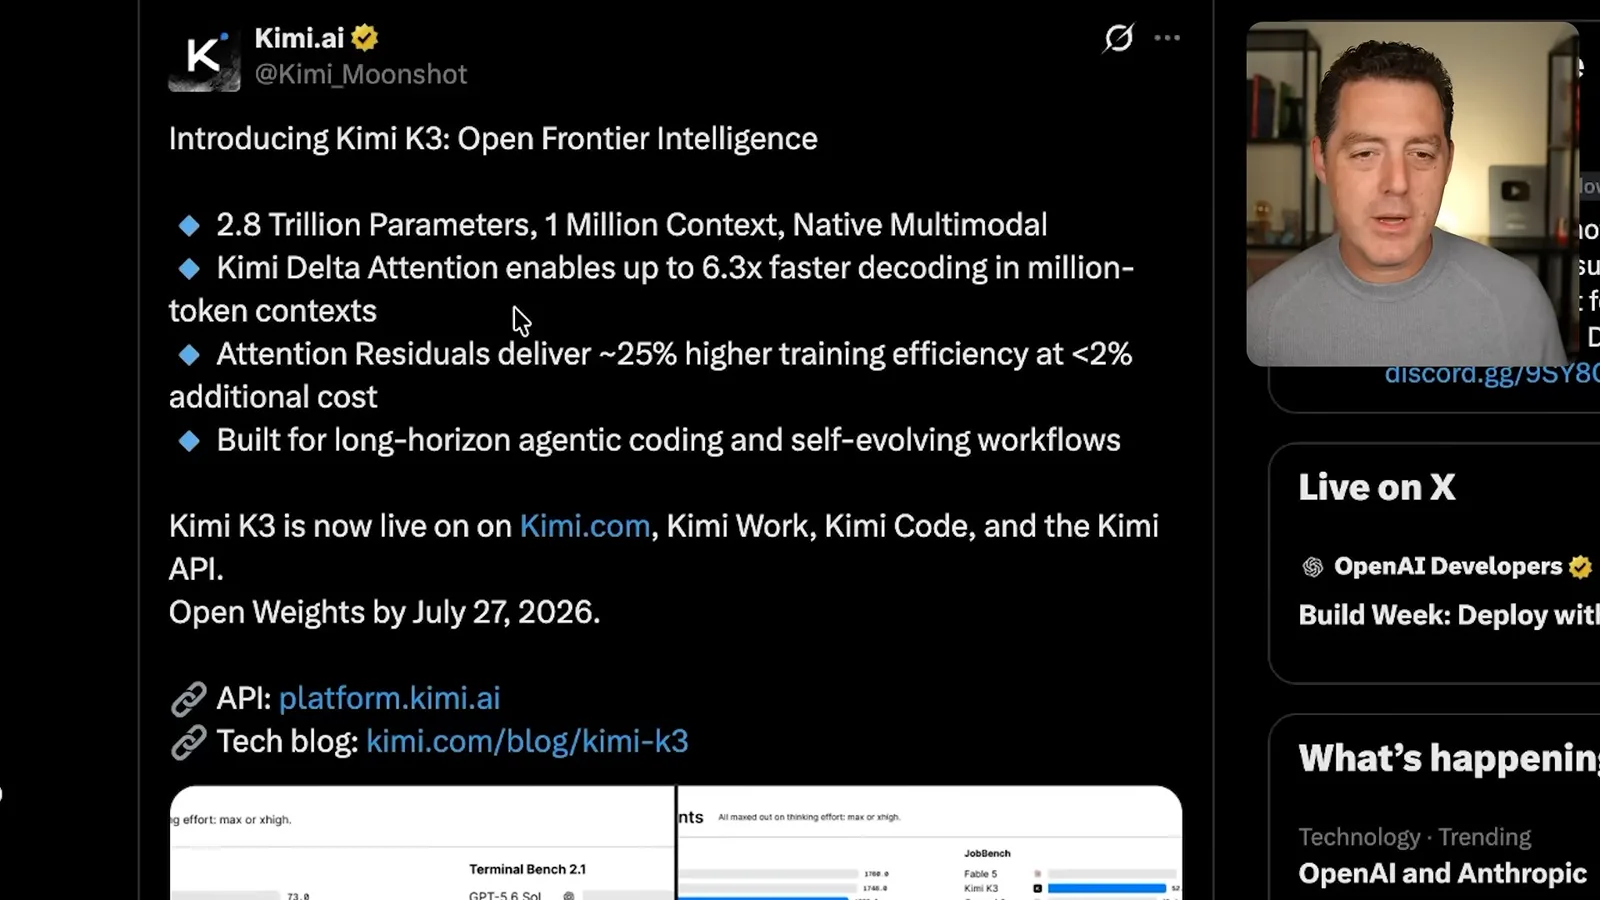
视频展示的公告称,该模型有 2.8 万亿参数、100 万 token 的上下文窗口和原生多模态能力。公告称计划在 2026 年 7 月 27 日前开放权重;视频发布于 7 月 21 日,因此不能把公告当作当天权重已经可用的证据。
我比较了由供应商控制访问和价格的封闭模型,以及其他人可以下载并运行的模型。我将后者称为开源,但开放权重不一定意味着同时提供训练数据、完整训练方案或不受限制的许可证;不同发布的开放程度各不相同。
我将 OpenAI 和 Anthropic 等美国领先实验室与专有模型联系起来,并将 DeepSeek、Moonshot 和阿里巴巴等中国实验室作为开放权重的竞争者讨论。这两类都不能简单按国家划分:各家公司发布的内容和运营方式各有不同。
为什么开放权重?一个可能的原因是建立生态并成为标准。更广泛的采用可以提高对周边技术栈的影响力,而价格低廉的替代方案也会给竞争对手的定价和利润率带来压力。
我把低价描述为一种竞争策略,并与 Meta 的 Llama 做法比较。我还推测,政府支持和地缘政治影响可能塑造中国的 AI 战略;但应逐家公司评估支持和所有权情况,而不是假定它们完全相同。
Linux、Android、Chromium 和 React 等开源项目的成功,说明广泛采用的共享基础如何壮大生态。公司可能开放一个层次,同时在另一个层次竞争,不过每个项目都有不同的治理方式和条款。
竞争与 AI 技术栈
他讨论 Baker 关于市场集中和价值分配的观点,并思考降价可能如何影响需求。
投资人 Gavin Baker 认为,如果少数前沿实验室以极高的推理利润率主导市场,芯片、能源、数据中心、服务商、开发工具和软件公司都可能处于不利地位。这是一种情景和经济论证,并非对每家实验室利润率的核实测量。
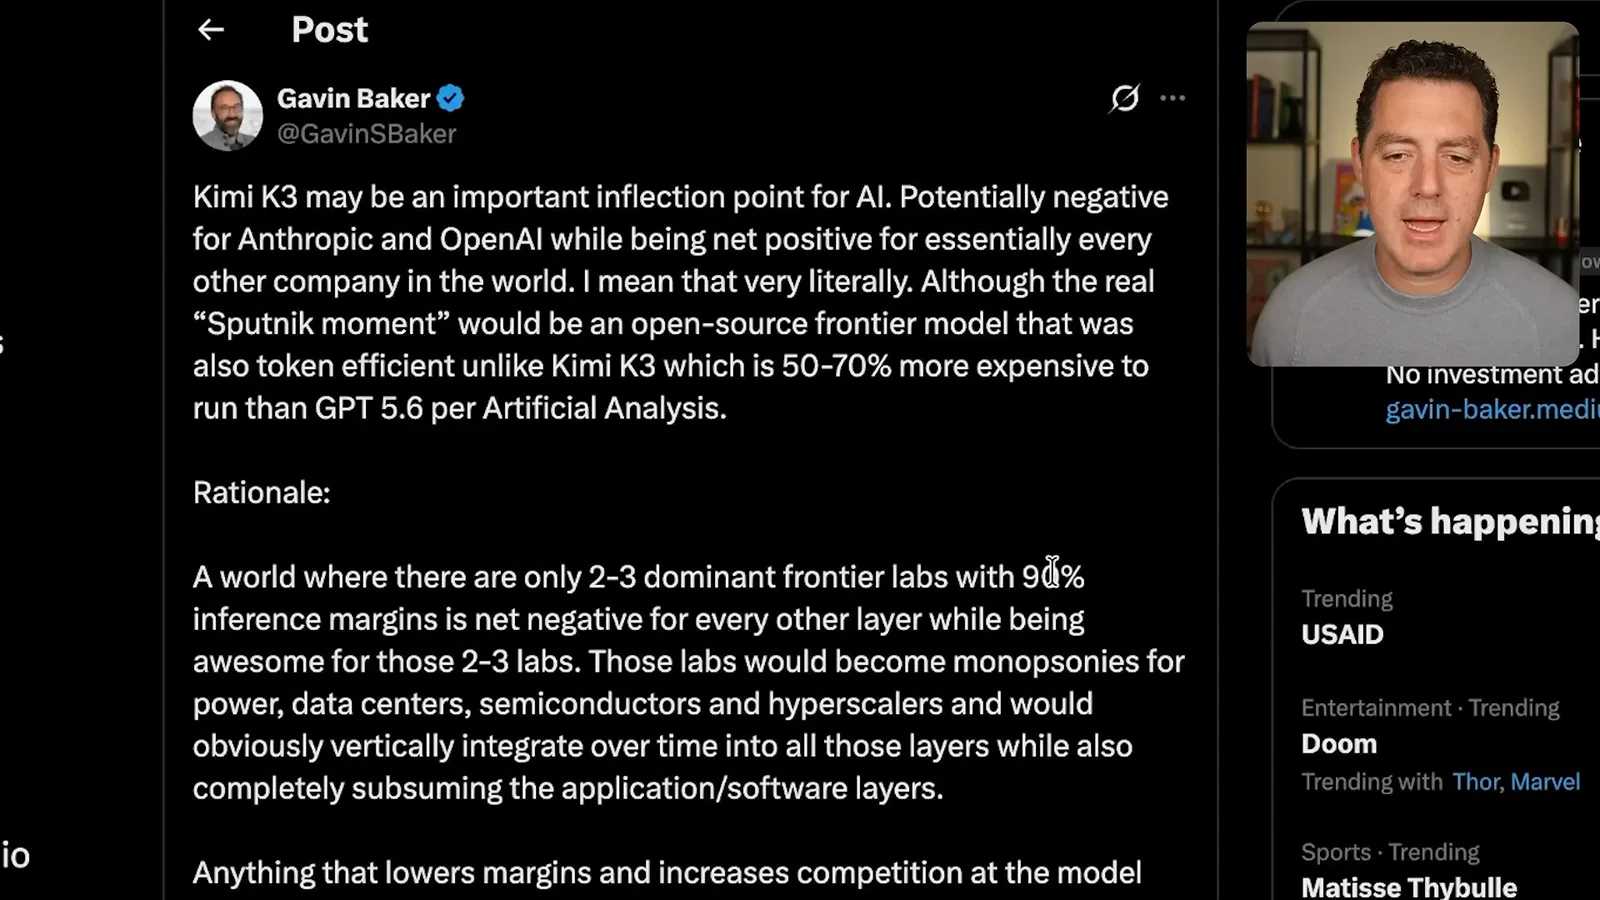
我担心,如果少数模型供应商垂直整合,并与建立在其平台上的应用直接竞争,初创企业就会面临平台风险。更多供应商和开放权重替代方案可能增强客户的议价能力,竞争也可能给价格带来压力。
Baker 认为,模型层利润率下降可以让技术栈其他层次获得更多价值。我借用杰文斯悖论:单位成本降低可能刺激需求,进而增加对芯片、电力和数据中心的总需求。反弹效应是否超过效率提升,仍需实证判断。
推理需要多少成本
硬件、电力和 token 用量使成本比较更加复杂。Berman 讨论完成有用任务的成本。
Ben Thompson 的经济分析强调,开放权重并不意味着提供推理服务没有成本。即使某个模型可以免费下载,训练和运行它所需的硬件、电力、工程和研究仍然有成本。
我引用了当时 Kimi K3 的价格:每百万输入 token 3 美元、每百万输出 token 15 美元;GPT-5.6 分别为 5 美元和 30 美元。这些是历史 API 报价,实际成本取决于服务商、用量和当前条款。
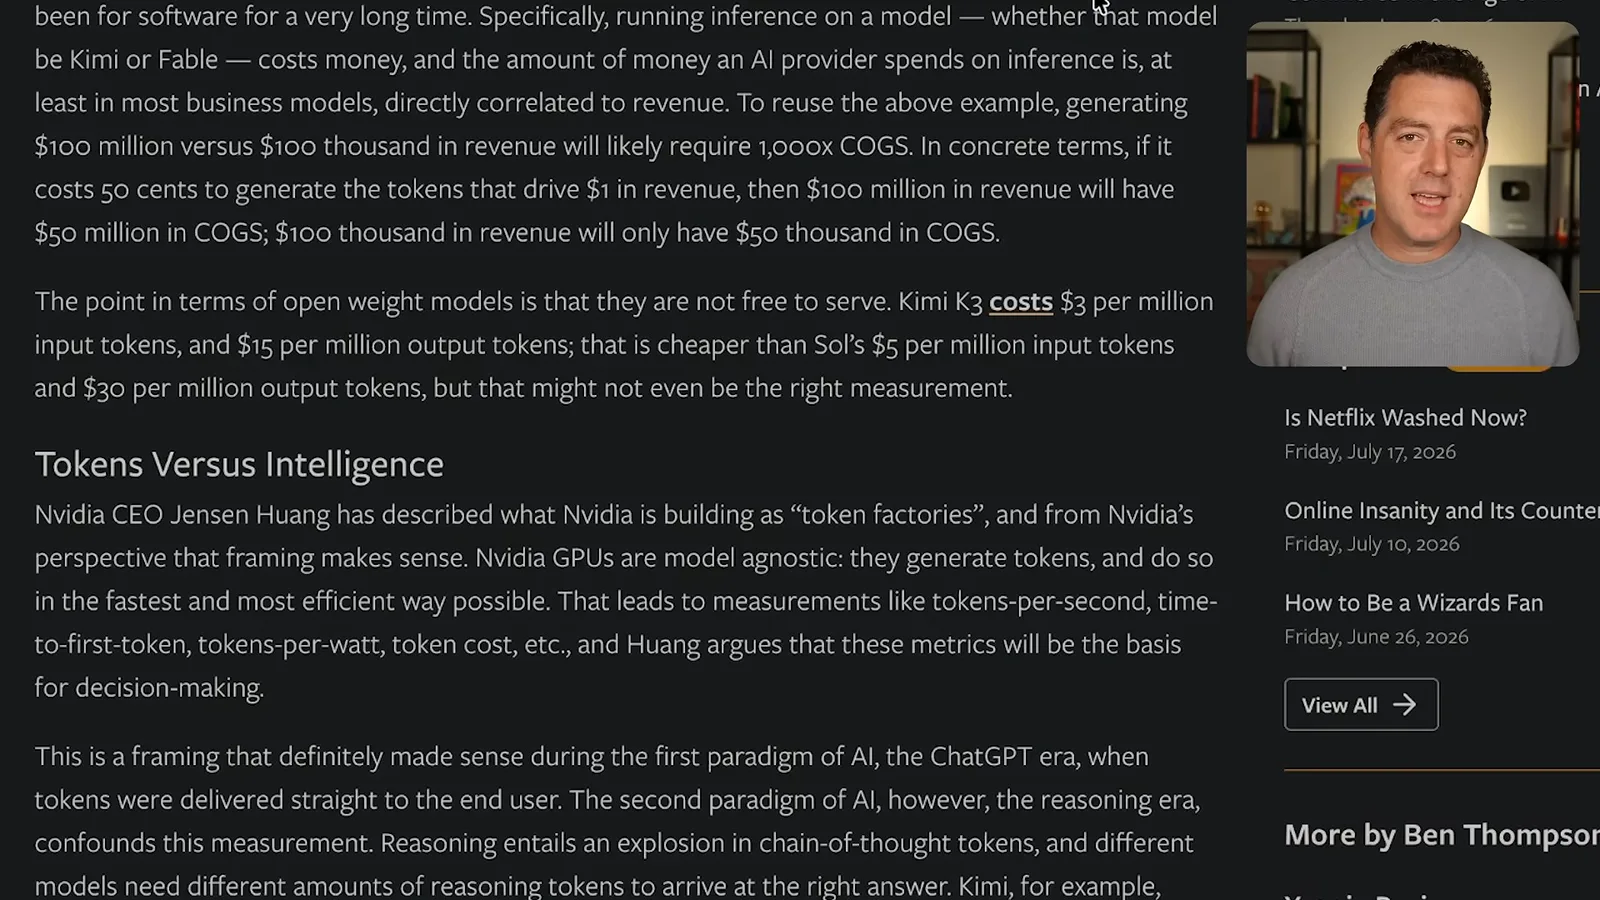
重要的是比较完成一项任务的成本,而不只是每个 token 的价格。不同模型可能需要不同数量的推理和输出 token、达到不同质量,或需要重试。我讨论了 Kimi 大约使用两倍 token 的一种说法,但这不是通用换算系数。
我认为开放权重生态可以帮助外部研究者改进推理、定制模型,并针对不同芯片优化部署。但某个系统是否因此比专有竞争产品更便宜或更好,取决于工作负载和总成本。
安全与政策
他讨论可能的限制、安全防护及关于开放权重的不同观点。相关政策讨论被表述为预测,并非已经实施的禁令。
我讨论 Axios 在 2026 年 7 月关于美国可能限制中国 AI 模型的报道。我反对禁令,也怀疑它是否容易执行;媒体报道政策讨论,并不等于禁令已经生效。
这里存在真实的安全权衡。一旦权重被广泛提供,使用者就可以在原供应商控制之外运行或调整模型,后训练也可能削弱安全防护。与此同时,广泛获取模型可以支持研究、竞争和本地部署。
我讨论 David Sacks 的一种说法:Kimi 修复了其他模型拒绝处理的安全漏洞;还讨论了 Hugging Face 报告的一次经历,其中安全过滤器妨碍了安全分析。这些是讨论中提出的案例和说法,并非对各模型安全措施的全面比较。
防御安全工作的难题在于,过滤器既可能拦截有害请求,也可能阻碍正当分析。有价值的评估应区分防御工作和滥用,并测量这两类错误,而不是假定完全开放或一概拒绝就能解决问题。
当时在 OpenAI 任职的 Dean W. Ball 对开放权重提出了不同看法。我质疑他将其描述为减速主义;画面中的帖子还认为开放权重可能抑制未来的 AI 资本投资,而我的口头概括没有充分涉及这一理由。
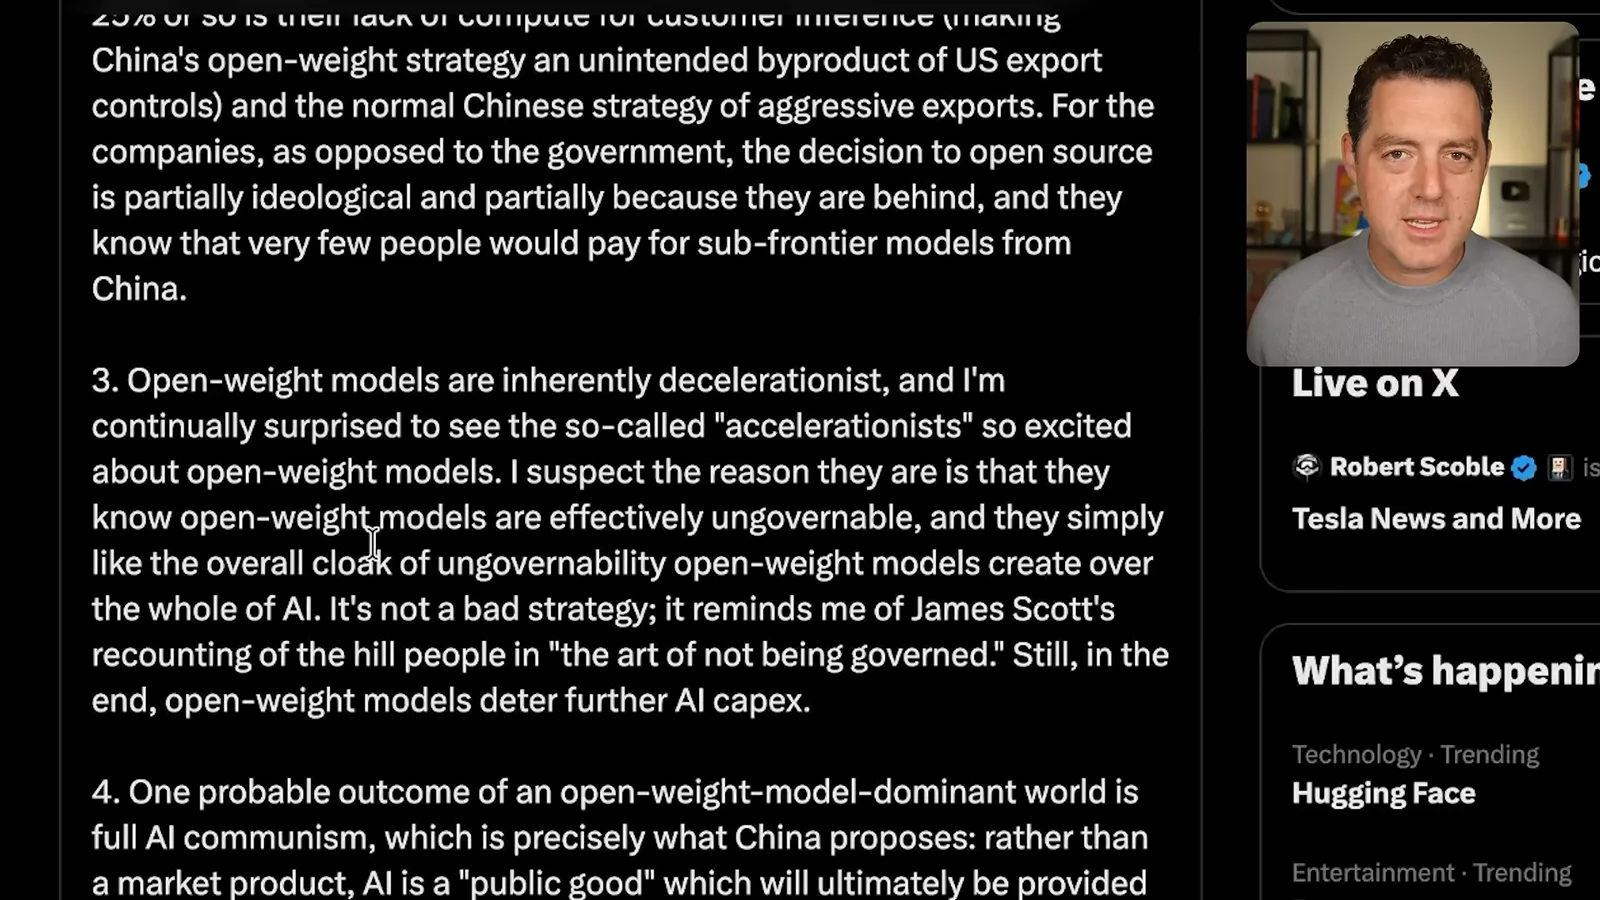
Ball 还推测,政府机构可能围绕中国开放权重模型制造监管不确定性,而不是正式禁止开源。我认为这可能让考虑采用模型的公司望而却步;这是他的预测,不是政府已经宣布的行动。
Will Manidis 和 Box 首席执行官 Aaron Levie 认为,限制可能减少美国公司的选择,并强化现有模型供应商的地位。Levie 说,能够使用多种模型有助于降低成本、进行专业化微调、开展安全工作和保持竞争;这些都是关于可能后果的论点。
蒸馏与结论
Berman 思考 Anthropic 的指控和潜在诉讼。他认为竞争的益处超过风险。
反方观点涉及所谓的蒸馏攻击。Anthropic 指控某些实验室提取大量模型输出,以改进自己的模型。蒸馏是一类更广泛的技术;具体使用是否违反合同或法律,要看事实。
我解释了基本思路:一个能力强的系统生成的提示和回答,可以成为另一个模型的训练数据。视频没有独立证实 Anthropic 的指控,也没有确定这些数据对任何公司模型的影响程度。
我提出,反对提取模型输出与使用互联网材料训练模型之间可能存在不一致。材料可以公开获取,本身并不能解决版权或合同问题;这些问题也会因数据集和司法辖区而异。
我推测美国和中国公司是否能就模型提取有效地相互起诉。我关于所有权和中国法院胜诉机会接近零的概括性说法,没有视频证据支持,不应当作法律结论。
我个人怀疑所谓的蒸馏是否足以单独解释中国模型的能力。这是一种观点;这里讨论的公开说法并不能确定任何特定训练来源贡献了多少。
我的结论是应允许开放权重模型,包括来自中国的模型,同时关注风险。我认为竞争可以减少集中并在整个技术栈创造价值;我也支持让专有实验室拥有更大的灵活性,同时承担防止滥用的责任。
我建议托管服务商可以考虑客户身份验证和监测。实际权衡仍是如何平衡安全、防御用途的访问、竞争和问责;单次模型发布无法解决所有这些问题。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文