30 秒看懂
在发布日直播中,Matthew Berman 先讨论开放权重模型的价值,再解读 Anthropic 的 Claude Opus 5 公告。他分析该公司的评测图表和定价、Box 的企业任务评测以及 ARC-AGI-3 结果,同时强调自己的上手时间很短;直播故障也使观众无法看到完整的编程测试。视频的一部分由 Box 赞助。
- 1开放权重的理由Berman 认为更多人使用模型可以促进竞争,减少权力集中。他也指出,AI 使用增加会带来芯片需求,NVIDIA 因此受益。
- 2发布时的基准成绩Anthropic 图表显示终端编程、计算机操作等任务有所进步,但某些评测结果较弱。这些是厂商在特定条件下报告的测量结果。
- 3完成任务的成本如果模型消耗更多 token 或需要更多尝试,较低的 token 单价并不保证总成本更低。Berman 据此解读 Anthropic 的成本与得分图表。
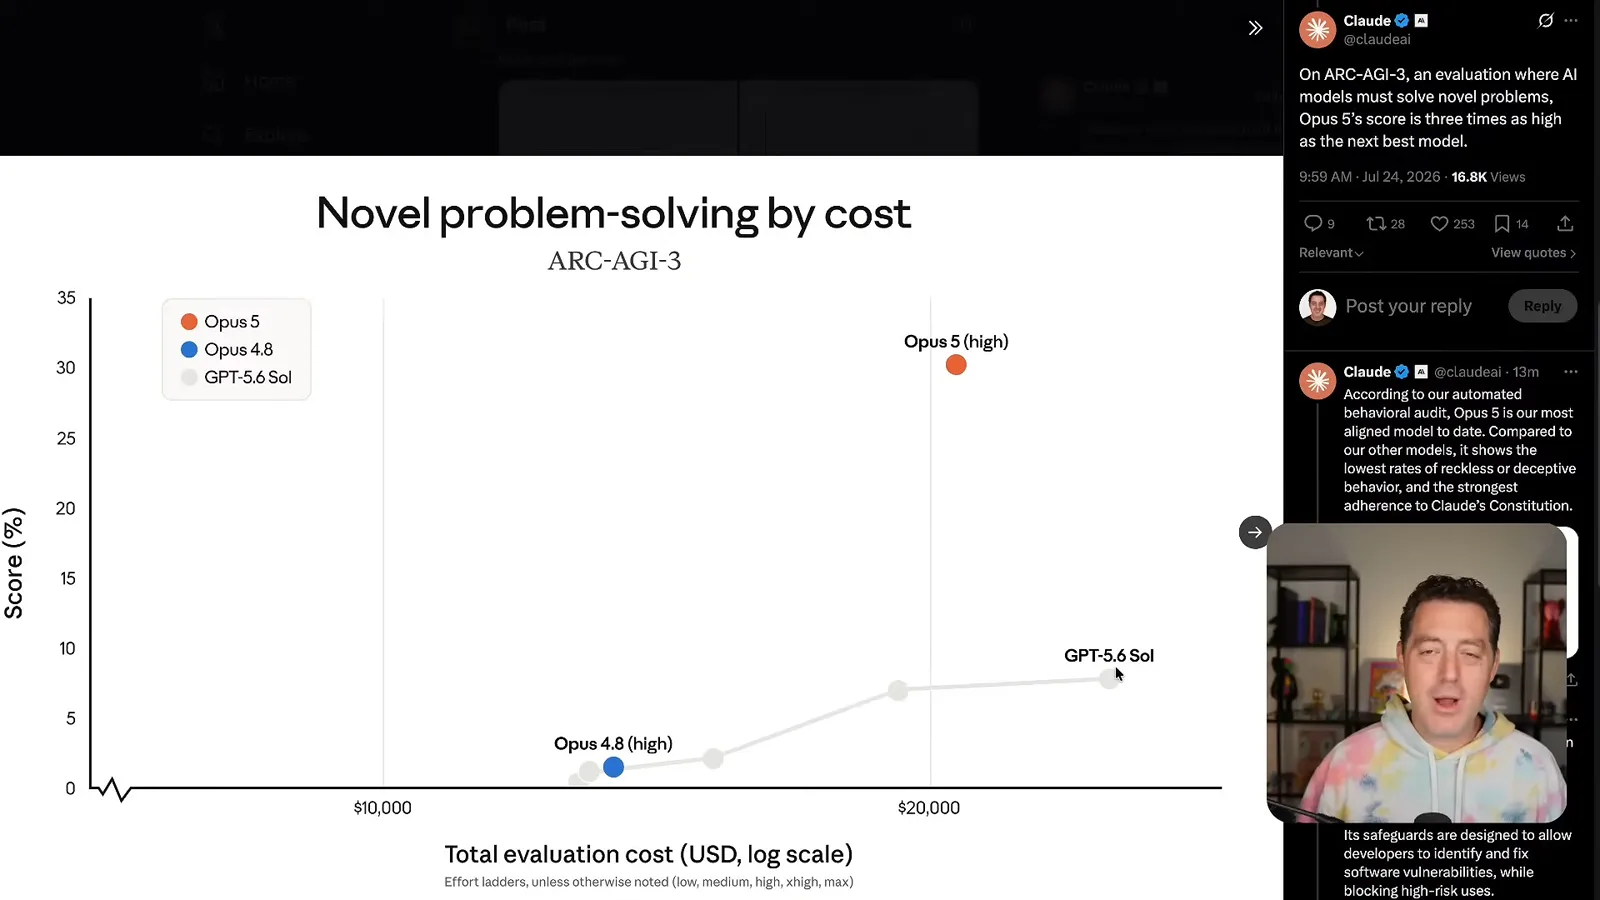
- 4ARC-AGI-3 的提升发布图表报告 Opus 5 得分为 30.2%,GPT-5.6 Sol 为 7.8%;该基准考察交互式新问题求解。
- 5赞助商的企业评测Box 图表显示,与 Opus 4.8 相比,总体准确率从 63% 升至 68%。Berman 口误说成 78%,画面显示的是 68%。
要点建议
- Berman 认为开放权重模型能够增加竞争与选择、降低推理成本,同时承认 NVIDIA 在这一生态中有商业利益。
- Anthropic 的发布图表显示 Opus 5 在多项任务中超过 Fable 5,但并非每项评测都领先。
- 应同时比较完成任务的成本与成功率,而不只看 token 单价;结果取决于任务与配置。
- 发布时公布的 ARC-AGI-3 成绩令人关注,但单项基准无法全面衡量通用能力。
- Box 的赞助评测将 Opus 5 与 Opus 4.8 在基于文档的企业任务中比较,并未涵盖所有竞争模型。
按章节阅读整理后的全文
开放权重与权力集中
Berman 讨论支持开放权重的联名信,认为更多模型选择能促进竞争。他也承认 NVIDIA 有销售更多芯片的动机。
模型公布前,Berman 讨论了一封支持开放权重 AI 的联名信。他认为,人们可以检查、修改、微调和自行部署模型,也可以选择不同的推理服务商,从而增加选择并带来竞争压力。他最担忧的是 AI 权力集中在少数前沿公司手中,同时也承认环境、审查和就业方面的担忧。
在他看来,竞争有助于降低推理价格,让 AI 能用于更多场景。Berman 也承认 NVIDIA 在这一论点中有商业利益:使用 AI 的人越多,芯片需求可能越大。他对开放权重的支持是一种生态判断,并不证明每个开放模型或部署都便宜或安全。
Opus 5 发布时的基准测试
Berman 解读 Anthropic 新模型及评测表。他此前只短暂体验过该模型。
Anthropic 宣布 Claude Opus 5 后,直播转向新模型。Berman 表示自己此前只短暂体验过该模型,公告的大部分内容也是第一次看到。他把它放在 Claude 家族中,与 Haiku、Sonnet 和 Fable 一起讨论,并从公司公布的评测开始,而不是声称已经完成独立测试。
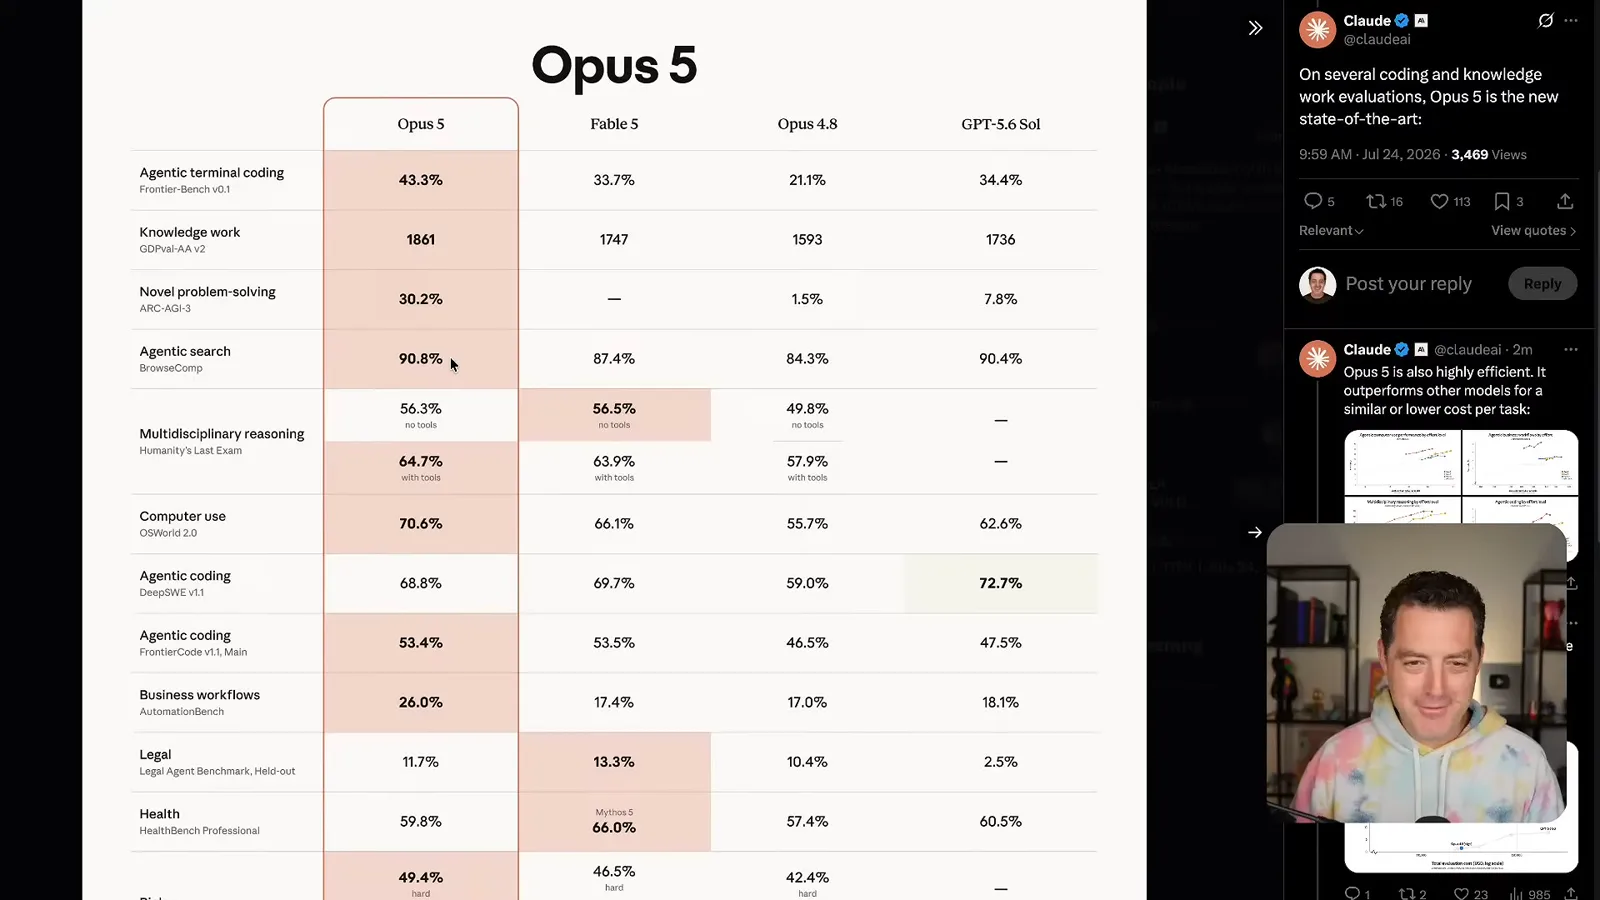
画面中的表格显示,Frontier-Bench 终端编程评测中,Opus 5 为 43.3%,Fable 5 为 33.7%;OSWorld 2.0 计算机操作评测分别为 70.6% 和 66.1%。其他评测则出现相反结果:Fable 在 DeepSWE 和法律基准上略高。这些数字对应公告中的特定评测和设置。
Berman 特别关注实际编程与智能体工作。他指出,图表中 DeepSWE 相较 Fable 几乎持平,而其他一些分数有所提高。他的第一反应很兴奋,但尚未确认这些差异会如何影响自己的实际工作。
任务成本与新问题求解
他比较性能与任务总成本,并分析 ARC-AGI-3 成绩。图表结果对应特定测试配置。
Anthropic 还绘制了任务表现与成本的关系图。Berman 认为,单看 token 单价不够:单价较低的模型可能消耗更多 token,或需要更多尝试才能得到可接受的结果。有意义的比较应在相近条件下同时考察质量或成功率与任务总成本。
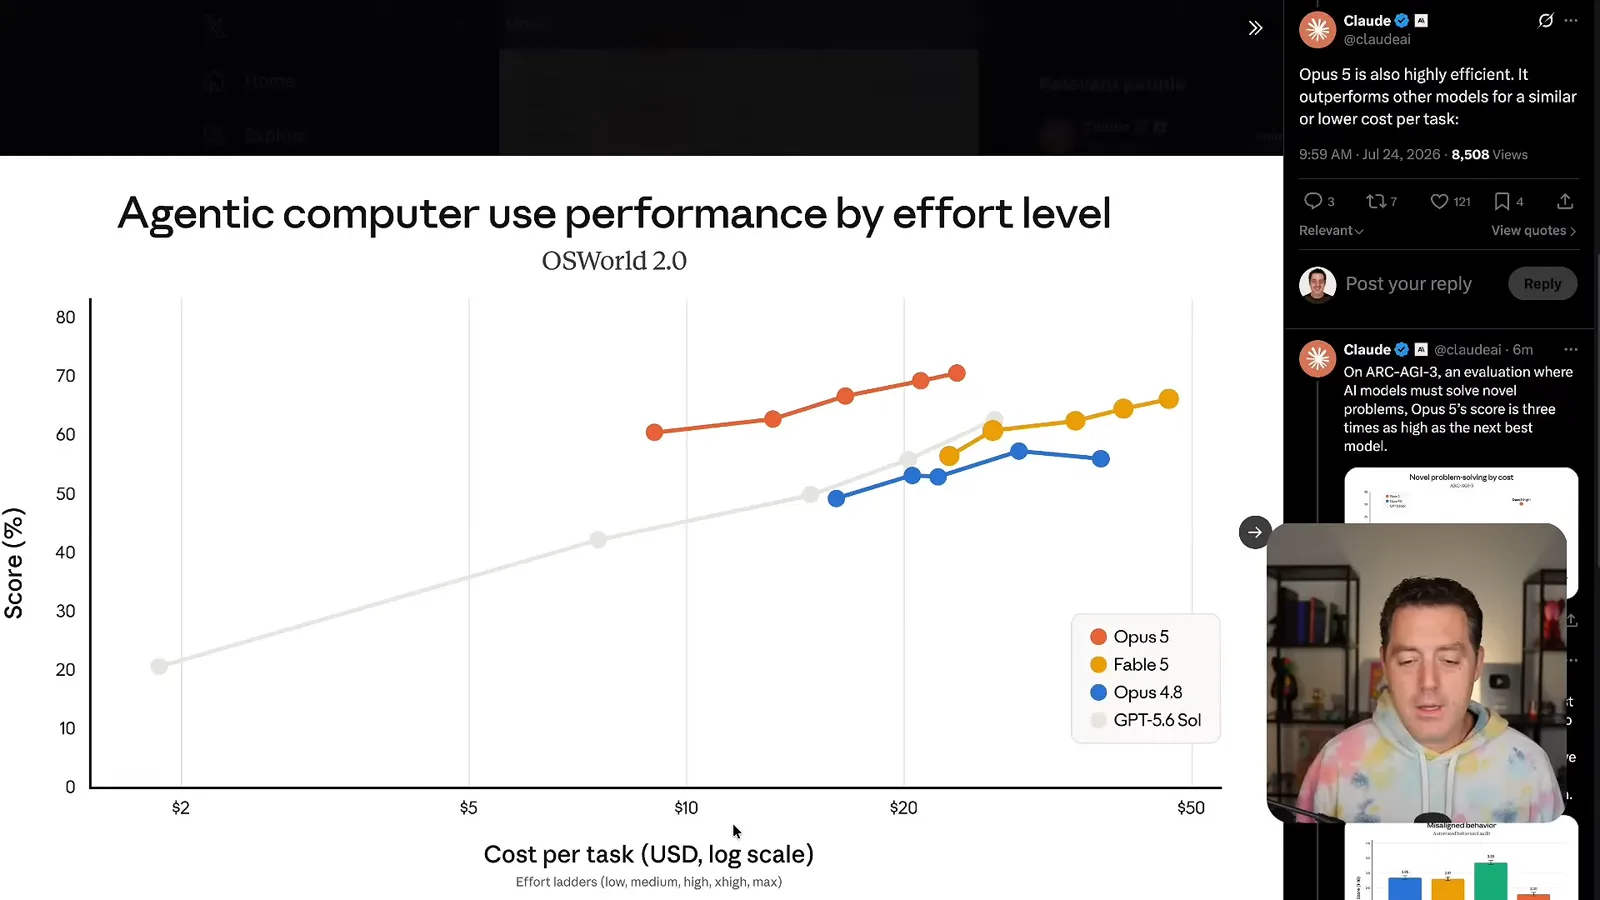
直播展示的 OSWorld 图表中,Opus 5 的数据点在成本较低的位置高于多个对比模型。Berman 将其解读为该测试中的效率提升,并在 AutomationBench 图表中看到类似现象。这些是发布时的图表,成本与排名应结合其配置和工作负载理解。
Frontier-Bench 图表也展示了推理力度与价格之间的取舍。Berman 发现,某个更高力度的数据点成本更高,得分却低于前一个点。增加计算量并不必然提高每次评测的结果;用户需要针对自己的任务测试合适的设置。
ARC-AGI-3 提供没有说明的交互式游戏,要求模型自行发现规则并解决新问题。发布表格中,Opus 5 得分 30.2%,GPT-5.6 Sol 为 7.8%,Opus 4.8 为 1.5%;表格没有给出 Fable 的成绩。Berman 认为提升很显著,并等待基准组织公布经验证的结果。
安全措施、定价与直播测试
Berman 讨论安全措施并介绍发布时的 token 定价。直播故障使观众无法看到他的魔方编程测试。
公告还讨论了对齐和网络安全。Berman 指出,公布的结果称 Opus 5 在网络安全任务上强于 Opus 4.8,但开发漏洞利用的能力落后于 Mythos 5。他对训练和安全措施提出猜测,包括能力是否被有意削弱;图表本身无法证实这些猜测。
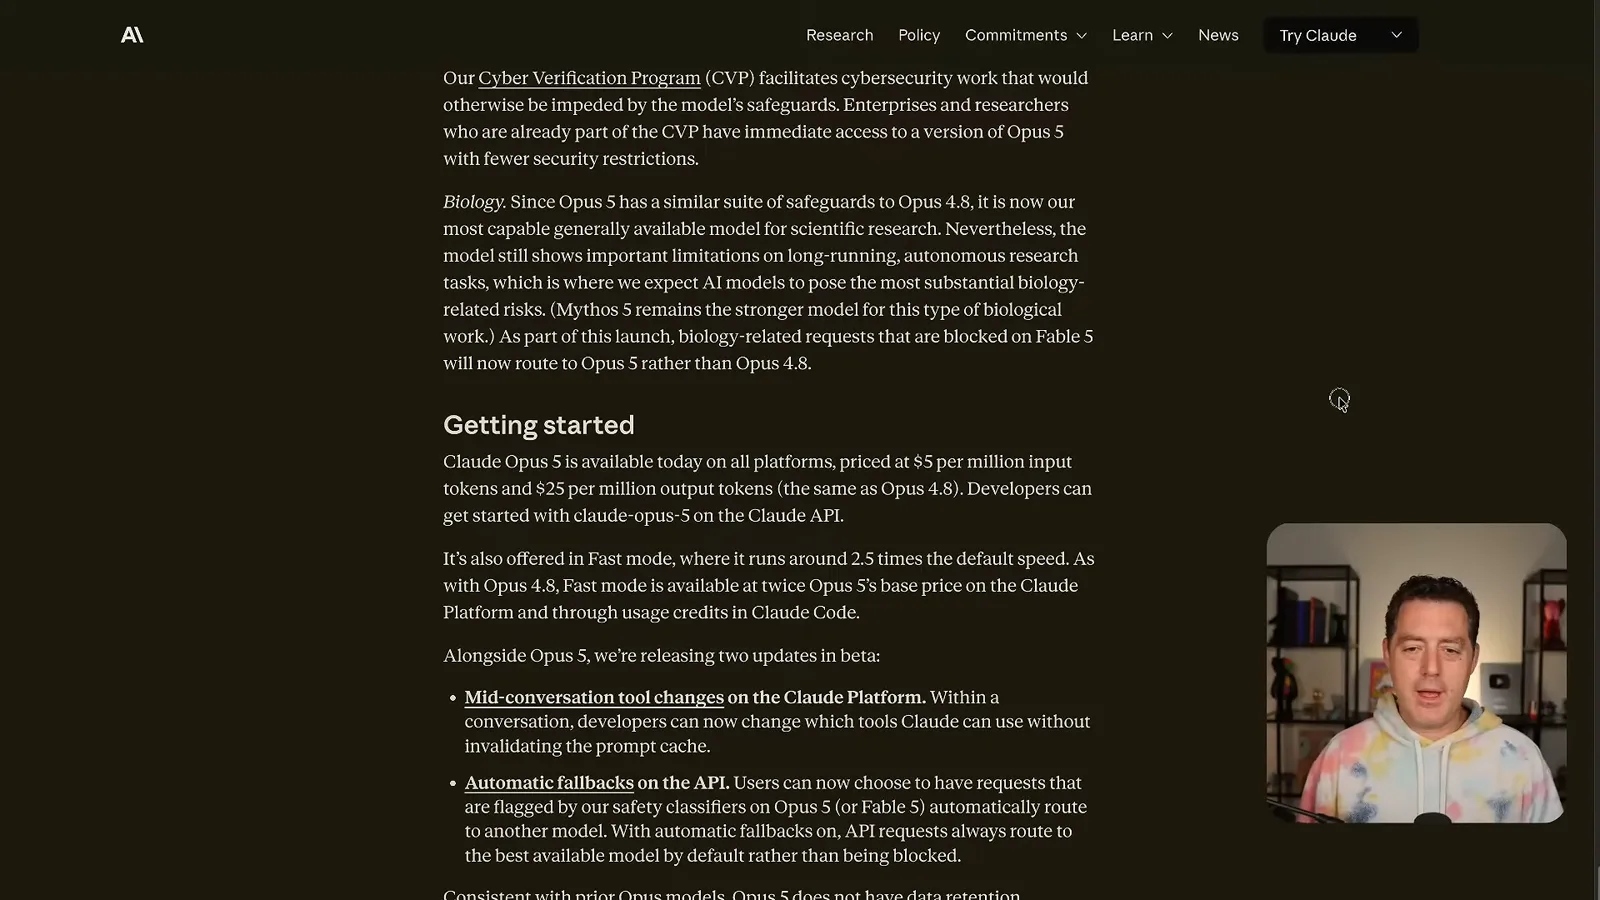
Berman 读出发布时的价格:每百万输入 token 5 美元,每百万输出 token 25 美元,与 Opus 4.8 相同,且为所述 Fable 价格的一半。页面还介绍了价格更高的快速模式。这些是视频发布时的价格;实际任务成本取决于使用量、设置以及后续定价变化。
可选的 API 回退功能能将被安全分类器标记的请求转至其他模型。Berman 不喜欢中断式回退,并提醒用户回退模型的价格会适用。发布材料将该功能描述为用户可选项,这并不意味着所有被标记请求都会有相同结果。
Berman 开始直播编程测试,要求模型制作一个美观的魔方模拟器,支持设置、打乱和逐步求解。直播的屏幕捕获冻结并崩溃,因此观众无法可靠地观察测试。他后来表示任务运行了九分钟、使用约 4.6 万 token,但没有展示完成结果。
被问到模型忠诚度时,Berman 说自己当时使用 GPT-5.6 Sol Medium,如果另一个模型对他来说更好、更快、更便宜,他会切换。他表示自己没有受到这两家模型公司的付费。这是个人经验,并非受控比较。
Box 的企业评测
视频赞助商展示了基于文档的任务中与 Opus 4.8 的比较。Berman 希望看到与更多模型的比较。
Box 赞助了直播的一部分,并分享自己对 12 个行业中基于文档的企业工作的评测,任务包括尽职调查、根据数据起草报告、审核专家工作和数据分析。Berman 指出对比对象是 Opus 4.8,并表示希望也能看到 GPT-5.6 Sol 的结果。
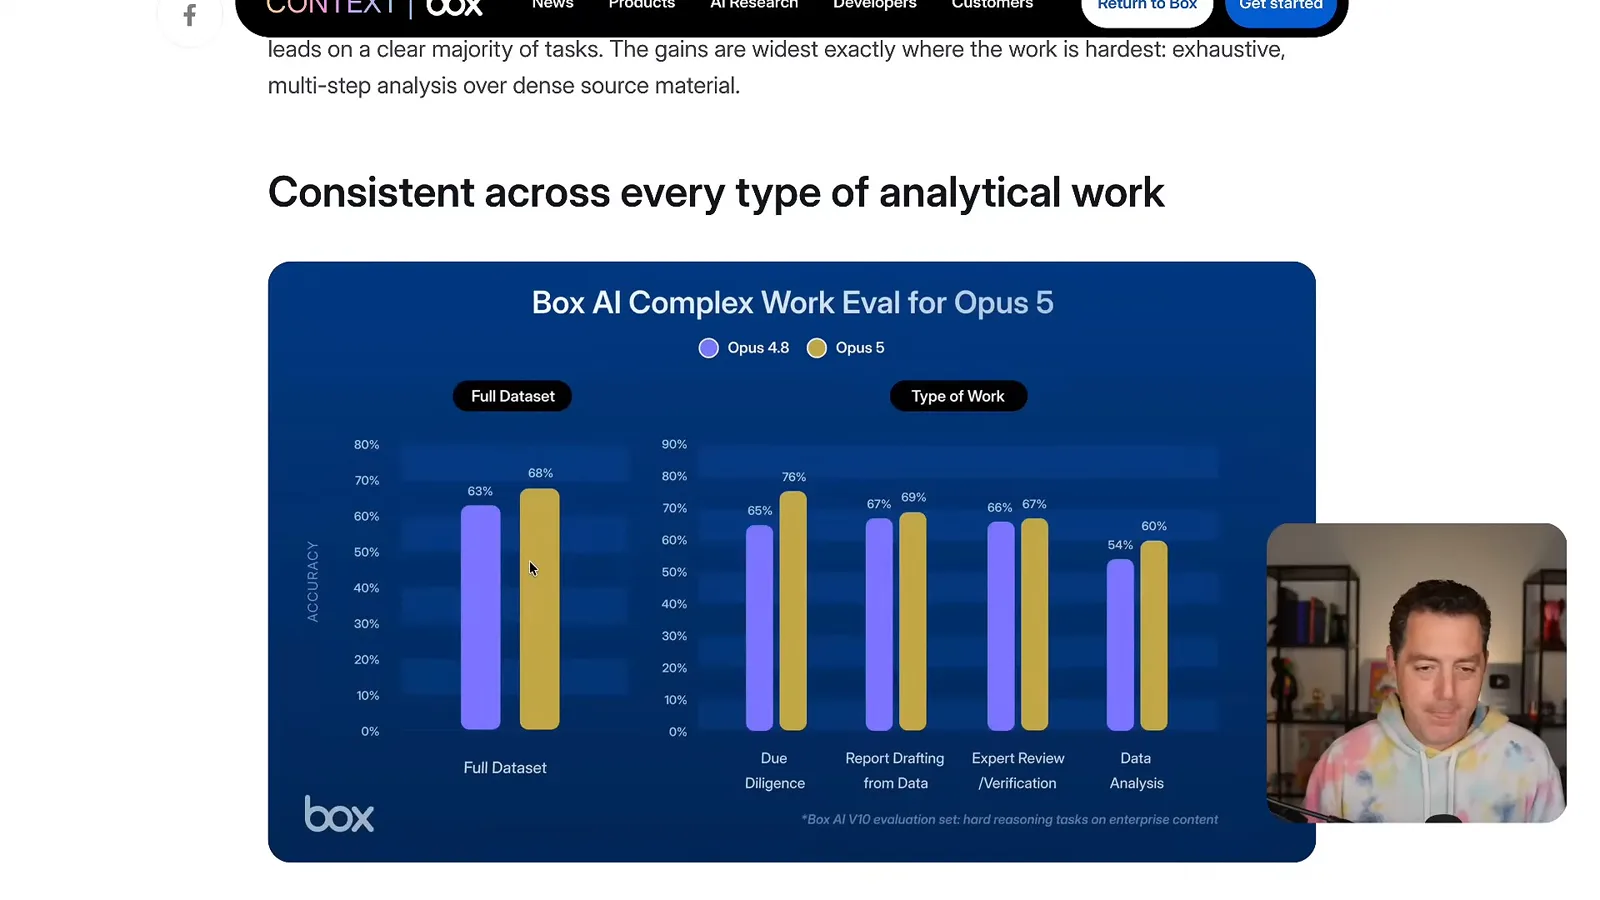
Box 的画面图表显示,Opus 4.8 的全数据集准确率为 63%,Opus 5 为 68%;尽职调查从 65% 升至 76%,报告起草从 67% 升至 69%,专家审核从 66% 升至 67%,数据分析从 54% 升至 60%。Berman 口播将总体结果说成 78%,但图表显示 68%。这些是 Box 在其自有评测中得到的结果。
屏幕共享仍未恢复,Berman 只能口头汇报魔方任务的进度。他猜测 Opus 5 是否由 Fable 5 蒸馏而来,并明确表示这只是猜测。未完成展示的演示和基准图表都不能证明模型采用了何种训练方法。
ARC 反馈与其他比较
Berman 转述 ARC Prize 的反馈,并查看其他排行榜。最后他强调应同时关注任务质量与成本。
Berman 转述 ARC Prize 的 Greg 发来的消息:团队正准备公布经验证的成绩,Greg 称该模型表现令人印象深刻。发布图表中的 30.2% 远高于画面展示的先前对比成绩。Berman 还讨论了基准作弊的担忧;他认为作弊总是容易发现,这并不是可靠保证,独立验证仍然重要。
讨论回到安全措施,以及政府审查是否可能影响模型可用性。Berman 猜测审查流程和网络安全成绩背后的原因,但没有给出证据。他还提到 Anthropic 声称分类器干预频率会比 Fable 5 低,这一说法依赖该公司的测试。
Berman 查看其他公开比较,但直播时 Arena 尚未公布 Opus 5 的分数。他还介绍了一个综合金融和编程评测的指数:该模型首次进入时排名靠前,显示成本低于领先者。不同排行榜衡量的任务各异,因此排名也可能不同。
他的结论是,同时评估完成有用工作的质量和成本。较低的标价本身不够,强劲的基准成绩也不能替代对代表性工作流程的测试。观众没有看到完整的直播演示,因此本场讨论仍是对已公布结果的初步印象。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文