30 秒看懂
Nathan Lambert 回答课程问题,解释工业后训练的各阶段如何配合、何时需要 KL 正则化、数据需求如何随规模变化,以及为什么强化学习不能与监督微调互换。他还讨论上下文学习与训练的选择,以及低质量合成数据的风险。
- 1结合专家模型多教师同策略蒸馏可以整合专家模型;顺序强化学习是另一种选择。
- 2KL 取决于任务可验证的数学和代码奖励可能降低对惩罚项的需求,而复杂工具使用可能使正则化重新变得重要。
- 3强化学习不只是监督微调相似的损失形式不能消除同策略生成经验和负梯度的作用。
- 4训练还是提供上下文衡量实际任务,将性能提升的价值与训练和服务成本相比较。
- 5合成数据可能有害教师选择和数据流程质量决定蒸馏数据是否有助于学生模型。
要点建议
- 工业配方结合多个阶段,也可能通过蒸馏整合不同领域的专家模型。
- 简单的可验证任务可以不使用 KL 惩罚,但更复杂的智能体任务可能需要正则化。
- 较大模型可能用更少的示例高效学习,但提示数量只是会变化的粗略经验法则。
- 强化学习与监督学习的区别包括生成经验,以及压低较差样本的能力。
- 训练前应评估业务价值与成本,也不能假定合成数据天然有益。
按章节阅读整理后的全文
阶段与专家模型
Lambert 解释多阶段配方和结合领域能力的方式。
工业界的后训练配方比单篇公开论文通常能展示的复杂得多。一个常见的抽象是先进行监督微调,建立推理行为,再通过强化学习提高能力和智能体表现。实际上,实验室会使用许多中间模型、专家模型和训练阶段。
OLMo 3 的示意图展示了一个相对简单的配方:预训练、中期训练和长上下文训练,接着是监督微调和强化学习,中间还可能有偏好微调。即使这样一个直接的开放配方,也包含多个阶段。
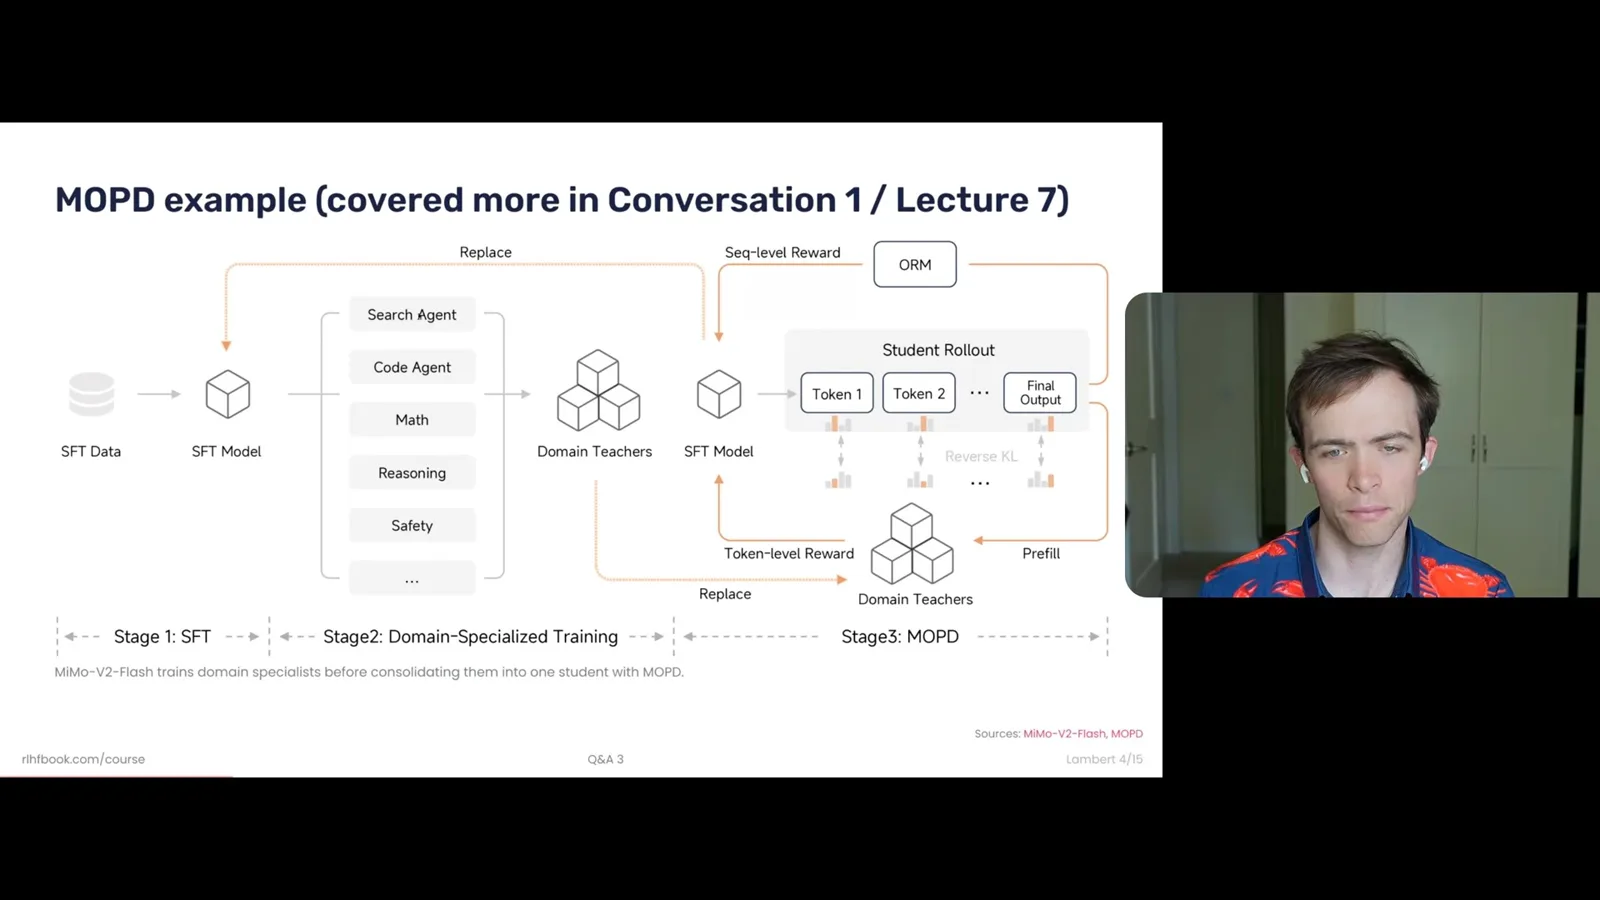
结合专家能力的一种新方法是多教师同策略蒸馏:训练不同领域的专家,再把它们的方向整合到一个学生模型中。也有研究按能力顺序进行强化学习,包括 NVIDIA 的工作。我不会假定按能力逐一顺序训练是行业的普遍做法。
KL 与数据预算
他讨论 RLVR 中的正则化,以及为什么固定的监督提示数量只能作为粗略参考。
为什么推理模型的配方经常省略 KL 惩罚?对于数学和代码这类相对清晰、奖励可以验证的任务,真实答案可以减轻部分过度优化问题。在 Tülu 3 中,我们发现数学强化学习可以在较为特定的模式中学习,不一定扰乱其他领域。
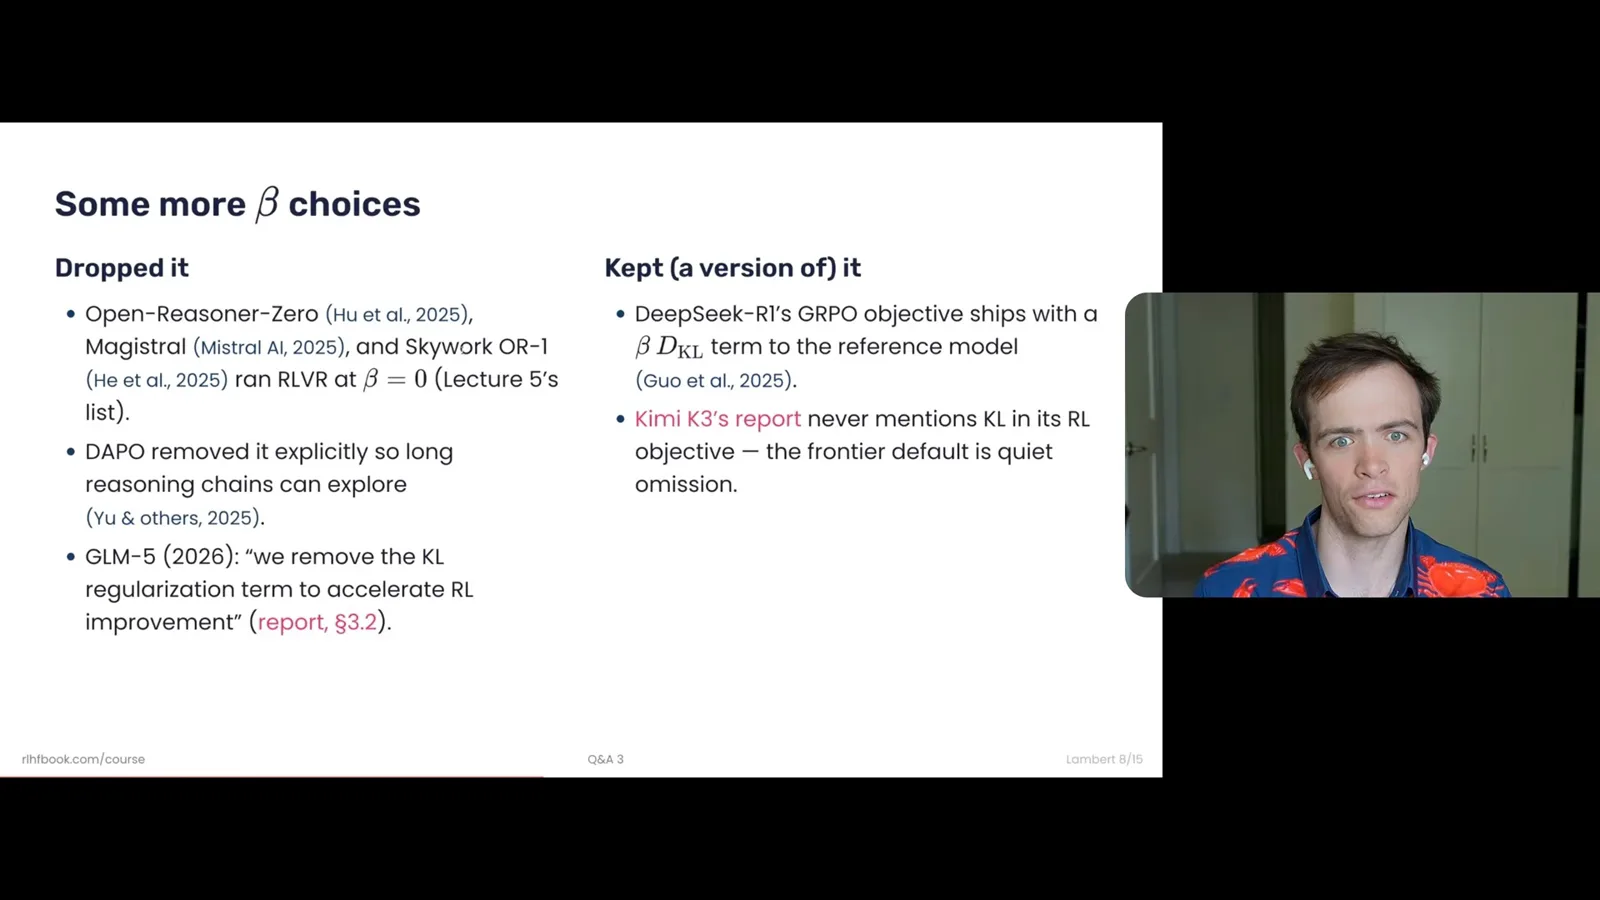
随着工具使用和智能体任务变得复杂,过度优化可能以更多形式出现,正则化也开始回归。不同报告的做法不同:Open-Reasoner-Zero、Magistral、Skywork 和 DAPO 都讨论过移除 KL,GLM-5 也为加快改进而移除它。有些报告没有明确说明,因此前沿实践并不统一。
大约一百万条监督提示的预算如何随模型大小变化?较大的模型通常需要更少的示例:它们可能从中期训练中获益更多,也能更高效地从指令数据和强化学习中学习。应该测试每个数据来源是否真的提高性能,否则就是浪费算力。
这里有重要的混杂因素。中期训练与监督微调越来越多地共同承担推理基础的建立,而智能体回答包含更多 token。一百万提示的经验法则来自较早的时代;我们需要更好的公开数据,了解提示和回答的总 token 数,不能假定这一数量可以原样沿用。
强化学习与监督学习
损失函数形式相近,并不消除经验生成和梯度上的区别。
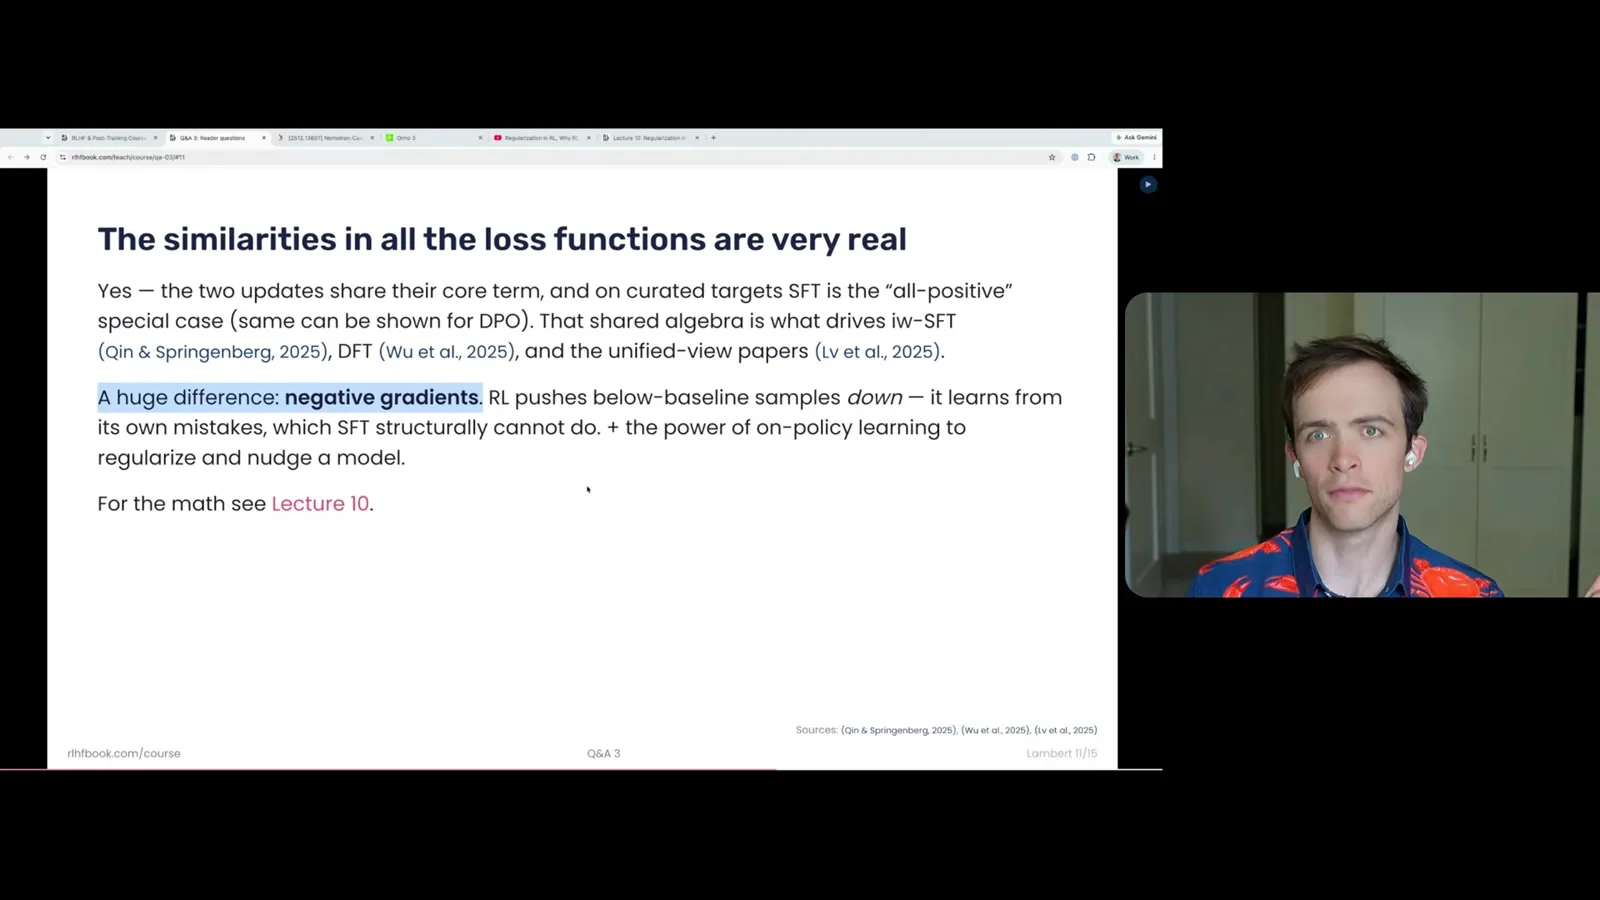
强化学习只是带正则化项的监督微调吗?它们的损失函数在数学形式上可能非常相近,但强化学习还会从当前模型生成经验,并依据这些经验更新模型。不一定能预先准备好所有这些数据,再仅靠监督学习得到同样结果。
监督学习足以满足的应用可能比人们想象的更多,尤其是小模型。但强化学习可以帮助模型适应更困难的问题。它的更新还可以包含负梯度,压低低于基线的行为;普通监督微调则主要强化示范的目标。
实际数据决策
任务评估、业务价值和数据质量决定训练是否值得。
机构什么时候应该把内部知识训练进权重,而不是在推理时提供上下文?首先为实际任务建立评估,并判断性能提升值多少钱。再把收益与训练成本比较;有意义的前沿规模训练任务可能非常昂贵。
成本可能会下降,尤其是小模型。如果任务足够狭窄,使用内部数据训练的小模型可能在该任务上胜过前沿模型,或者大幅节省服务成本。决定取决于业务情况,以及当前上下文学习方案与目标性能之间的差距。
只用蒸馏数据继续预训练,是否可能让模型变差?会。合成或蒸馏数据并非天然好或坏:教师可能不适合学生模型,数据流程也可能存在问题。设计良好的流程可以带来收益,但仅仅把数据称为合成数据并不会带来免费的性能提升。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。